Язык программирования Rust
Стив Клабник, Кэрол Николс и Крис Криччо при участии сообщества Rust
Эта версия текста предполагает использование Rust 1.97.0 (выпущен 2026-07-09)
или более поздней версии с edition = "2024" в файле Cargo.toml всех проектов,
чтобы настроить их на использование идиом редакции Rust 2024. См. раздел «Установка»
главы 1 для инструкций по установке или
обновлению Rust, а также Приложение E для информации
о редакциях.
HTML-версия доступна онлайн по адресу
https://doc.rust-lang.org/stable/book/
и офлайн при установке Rust с помощью rustup; выполните rustup doc --book, чтобы открыть её.
Также доступны несколько переводов сообщества.
Этот текст доступен в бумажной и электронной форме от No Starch Press.
🚨 Хотите более интерактивный опыт обучения? Попробуйте другую версию книги Rust, включающую: викторины, выделение, визуализации и многое другое: https://rust-book.cs.brown.edu
Предисловие
Предисловие
Язык программирования Rust прошёл долгий путь за несколько коротких лет — от создания и инкубации небольшой зарождающейся группой энтузиастов до превращения в один из самых любимых и востребованных языков программирования в мире. Оглядываясь назад, было неизбежно, что сила и перспективы Rust привлекут внимание и закрепятся в системном программировании. Неизбежным было и глобальное распространение интереса и инноваций, которое проникло в сообщества открытого исходного кода и катализировало широкомасштабное принятие в промышленности.
На данный момент легко указать на замечательные возможности, которые предлагает Rust, чтобы объяснить этот взрыв интереса и принятия. Кто не хочет безопасности памяти и высокой производительности, и дружелюбного компилятора, и отличного инструментария — среди множества других замечательных возможностей? Язык Rust, который вы видите сегодня, сочетает в себе годы исследований в области системного программирования с практической мудростью яркого и страстного сообщества. Этот язык был спроектирован с целью и создан с заботой, предлагая разработчикам инструмент, который делает написание безопасного, быстрого и надёжного кода проще.
Но что делает Rust по-настоящему особенным, так это его корни в расширении ваших возможностей, пользователя, для достижения ваших целей. Это язык, который хочет, чтобы вы добились успеха, и принцип расширения возможностей проходит через ядро сообщества, которое создаёт, поддерживает и продвигает этот язык. С момента предыдущего издания этого основополагающего текста Rust превратился в по-настоящему глобальный и надёжный язык. Проект Rust теперь надёжно поддерживается Фондом Rust, который также инвестирует в ключевые инициативы, чтобы обеспечить безопасность, стабильность и устойчивость Rust.
Это издание Языка программирования Rust представляет собой всестороннее обновление, отражающее эволюцию языка за эти годы и предоставляющее ценную новую информацию. Но это не просто руководство по синтаксису и библиотекам — это приглашение присоединиться к сообществу, которое ценит качество, производительность и продуманный дизайн. Независимо от того, являетесь ли вы опытным разработчиком, впервые изучающим Rust, или опытным Rustacean, стремящимся отточить свои навыки, это издание предлагает что-то для каждого.
Путь Rust был путём сотрудничества, обучения и итераций. Рост языка и его экосистемы является прямым отражением яркого, разнообразного сообщества, стоящего за ним. Вклад тысяч разработчиков, от основных дизайнеров языка до случайных участников, — это то, что делает Rust таким уникальным и мощным инструментом. Взяв в руки эту книгу, вы не просто изучаете новый язык программирования — вы присоединяетесь к движению за то, чтобы сделать программное обеспечение лучше, безопаснее и приятнее в работе.
Добро пожаловать в сообщество Rust!
- Бек Рамбул (Bec Rumbul), исполнительный директор Фонда Rust
Введение
Введение
Примечание: Это издание книги совпадает с The Rust Programming Language, доступной в печатном и электронном формате от No Starch Press.
Добро пожаловать в The Rust Programming Language — вводную книгу о Rust. Язык программирования Rust помогает писать более быстрый и надёжный код. Удобство высокоуровневых языков и низкоуровневый контроль часто противоречат друг другу в дизайне языков программирования; Rust бросает вызов этому противоречию. Балансируя между мощными техническими возможностями и отличным опытом разработчика, Rust даёт возможность контролировать низкоуровневые детали (такие как использование памяти) без всех тех сложностей, которые традиционно ассоциируются с таким контролем.
Для кого предназначен Rust
Rust идеально подходит для многих людей по самым разным причинам. Рассмотрим несколько наиболее важных групп.
Команды разработчиков
Rust доказывает свою эффективность как продуктивный инструмент для сотрудничества в больших командах разработчиков с разным уровнем знаний системного программирования. Низкоуровневый код подвержен различным тонким ошибкам, которые в большинстве других языков можно поймать только с помощью обширного тестирования и тщательного обзора кода опытными разработчиками. В Rust компилятор играет роль привратника, отказываясь компилировать код с этими трудноуловимыми ошибками, включая ошибки конкурентности. Работая вместе с компилятором, команда может тратить своё время на логику программы, а не на поиск ошибок.
Rust также привносит современные инструменты разработчика в мир системного программирования:
- Cargo, встроенный менеджер зависимостей и инструмент сборки, делает добавление, компиляцию и управление зависимостями простым и единообразным во всей экосистеме Rust.
- Инструмент форматирования
rustfmtобеспечивает единый стиль кодирования среди разработчиков. - Rust Language Server обеспечивает интеграцию с интегрированной средой разработки (IDE) для автодополнения кода и встроенных сообщений об ошибках.
Используя эти и другие инструменты экосистемы Rust, разработчики могут быть продуктивными, работая с системным кодом.
Студенты
Rust предназначен для студентов и тех, кто заинтересован в изучении системных концепций. С помощью Rust многие люди изучили такие темы, как разработка операционных систем. Сообщество очень приветливое и радо помочь ответить на вопросы студентов. Через усилия, подобные этой книге, команды Rust хотят сделать системные концепции более доступными для большего числа людей, особенно для тех, кто новичок в программировании.
Компании
Сотни компаний, больших и малых, используют Rust в производстве для разнообразных задач, включая инструменты командной строки, веб-сервисы, инструменты DevOps, встроенные устройства, анализ и транскодирование аудио и видео, криптовалюты, биоинформатику, поисковые системы, приложения Интернета вещей, машинное обучение и даже значительные части веб-браузера Firefox.
Разработчики open source
Rust предназначен для людей, которые хотят развивать сам язык программирования Rust, сообщество, инструменты разработчика и библиотеки. Мы будем рады вашему вкладу в язык Rust.
Люди, ценящие скорость и стабильность
Rust предназначен для людей, которые жаждут скорости и стабильности в языке. Под скоростью мы понимаем как то, насколько быстро может выполняться код на Rust, так и скорость, с которой Rust позволяет писать программы. Проверки компилятора Rust обеспечивают стабильность при добавлении функций и рефакторинге. Это контрастирует с хрупким унаследованным кодом в языках без таких проверок, который разработчики часто боятся модифицировать. Стремясь к абстракциям с нулевой стоимостью — высокоуровневым функциям, которые компилируются в низкоуровневый код так же быстро, как код, написанный вручную — Rust стремится сделать безопасный код также и быстрым кодом.
Язык Rust надеется поддержать многих других пользователей; упомянутые здесь являются лишь некоторыми из крупнейших заинтересованных сторон. В целом, величайшая амбиция Rust — устранить компромиссы, которые программисты принимали на протяжении десятилетий, обеспечив безопасность и производительность, скорость и эргономичность. Попробуйте Rust и посмотрите, подходят ли вам его решения.
Для кого предназначена эта книга
Эта книга предполагает, что вы писали код на другом языке программирования, но не делает никаких предположений о том, на каком именно. Мы постарались сделать материал широко доступным для людей с самым разным опытом программирования. Мы не тратим много времени на рассказ о том, что такое программирование есть или как о нём думать. Если вы совершенно новичок в программировании, вам будет полезнее прочитать книгу, которая специально представляет введение в программирование.
Как использовать эту книгу
В целом, эта книга предполагает, что вы читаете её последовательно от начала до конца. Последующие главы строятся на концепциях из предыдущих глав, а предыдущие главы могут не углубляться в детали конкретной темы, но вернутся к ней в более поздней главе.
В этой книге вы найдёте два вида глав: концептуальные главы и главы с проектами. В концептуальных главах вы узнаете об аспектах Rust. В главах с проектами мы будем вместе строить небольшие программы, применяя то, что вы узнали к этому моменту. Глава 2, глава 12 и глава 21 — это главы с проектами; остальные — концептуальные главы.
Глава 1 объясняет, как установить Rust, как написать программу «Hello, world!» и как использовать Cargo, менеджер пакетов и инструмент сборки Rust. Глава 2 — это практическое введение в написание программы на Rust, в котором вы создадите игру по угадыванию числа. Здесь мы рассматриваем концепции на высоком уровне, а последующие главы предоставят дополнительные детали. Если вы хотите сразу же приступить к делу, глава 2 — это место для этого. Если вы особо дотошный ученик, который предпочитает изучить каждую деталь, прежде чем перейти к следующей, вы можете пропустить главу 2 и перейти сразу к главе 3, которая охватывает возможности Rust, похожие на те, что есть в других языках программирования; затем вы можете вернуться к главе 2, когда захотите поработать над проектом, применяя изученные детали.
В главе 4 вы узнаете о системе владения Rust. Глава 5
обсуждает структуры и методы. Глава 6 охватывает перечисления,
выражения match и конструкции потока управления if let и
let...else. Вы будете использовать структуры и перечисления для создания
пользовательских типов.
В главе 7 вы узнаете о системе модулей Rust и о правилах видимости для организации кода и его публичного интерфейса прикладного программирования (API). Глава 8 обсуждает некоторые общие структуры данных-коллекций, которые предоставляет стандартная библиотека: векторы, строки и хеш-таблицы. Глава 9 исследует философию и методы обработки ошибок в Rust.
Глава 10 углубляется в обобщённые типы, трейты и времена жизни,
которые дают вам возможность определять код, применимый к нескольким типам.
Глава 11 полностью посвящена тестированию, которое даже с гарантиями
безопасности Rust необходимо для обеспечения правильности логики вашей
программы. В главе 12 мы создадим собственную реализацию подмножества
функциональности из инструмента командной строки grep, который ищет
текст в файлах. Для этого мы используем многие концепции, обсуждённые в
предыдущих главах.
Глава 13 исследует замыкания и итераторы: возможности Rust, пришедшие из функциональных языков программирования. В главе 14 мы более подробно рассмотрим Cargo и поговорим о лучших практиках обмена вашими библиотеками с другими. Глава 15 обсуждает умные указатели, которые предоставляет стандартная библиотека, и трейты, обеспечивающие их функциональность.
В главе 16 мы рассмотрим различные модели конкурентного программирования и поговорим о том, как Rust помогает вам программировать в нескольких потоках без страха. В главе 17 мы строим на этом, исследуя синтаксис async и await в Rust, а также задачи, фьючерсы и потоки, и лёгкую модель конкурентности, которую они обеспечивают.
Глава 18 рассматривает, как идиомы Rust соотносятся с принципами объектно-ориентированного программирования, которые вам могут быть знакомы. Глава 19 — это справочник по шаблонам и сопоставлению с образцом, которые являются мощными способами выражения идей во всех программах на Rust. Глава 20 содержит сборную солянку из продвинутых тем, представляющих интерес, включая небезопасный Rust, макросы и многое другое о временах жизни, трейтах, типах, функциях и замыканиях.
В главе 21 мы завершим проект, в котором реализуем низкоуровневый многопоточный веб-сервер!
Наконец, несколько приложений содержат полезную информацию о языке в более справочном формате. Приложение A охватывает ключевые слова Rust, Приложение B охватывает операторы и символы Rust, Приложение C охватывает выводимые трейты, предоставляемые стандартной библиотекой, Приложение D охватывает некоторые полезные инструменты разработки, а Приложение E объясняет издания Rust. В Приложении F вы можете найти переводы книги, а в Приложении G мы рассмотрим, как создаётся Rust и что такое nightly Rust.
Нет неправильного способа читать эту книгу: если вы хотите перескочить вперёд, дерзайте! Возможно, вам придётся вернуться к более ранним главам, если вы почувствуете путаницу. Но делайте то, что работает для вас.
Важной частью процесса изучения Rust является обучение чтению сообщений об ошибках, которые отображает компилятор: они направят вас к работающему коду. Поэтому мы предоставим множество примеров, которые не компилируются, вместе с сообщением об ошибке, которое компилятор покажет вам в каждой ситуации. Знайте, что если вы введёте и запустите случайный пример, он может не скомпилироваться! Убедитесь, что вы читаете окружающий текст, чтобы увидеть, должен ли пример, который вы пытаетесь запустить, выдавать ошибку. В большинстве ситуаций мы приведём вас к правильной версии любого кода, который не компилируется. Феррис также поможет вам отличить код, который не предназначен для работы:
| Феррис | Значение |
|---|---|
 | Этот код не компилируется! |
 | Этот код вызывает панику! |
 | Этот код не производит желаемого поведения. |
В большинстве ситуаций мы приведём вас к правильной версии любого кода, который не компилируется.
Исходный код
Исходные файлы, из которых генерируется эта книга, можно найти на GitHub.
Начало работы
Начало работы
Начнём путешествие в Rust! Предстоит многое узнать, но каждое путешествие с чего-то начинается. В этой главе мы обсудим:
- Установку Rust на Linux, macOS и Windows
- Написание программы, которая выводит
Hello, world! - Использование
cargo— менеджера пакетов и системы сборки Rust
Установка
Установка
Первым шагом является установка Rust. Мы загрузим Rust через rustup — инструмент командной строки для управления версиями Rust и связанными инструментами. Для загрузки потребуется подключение к интернету.
Примечание: если по какой-то причине вы предпочитаете не использовать rustup, обратитесь к странице других способов установки Rust для получения дополнительных вариантов.
Следующие шаги устанавливают последнюю стабильную версию компилятора Rust. Гарантии стабильности Rust обеспечивают, что все примеры в книге, которые компилируются, продолжат компилироваться с более новыми версиями Rust. Вывод может незначительно отличаться между версиями, поскольку Rust часто улучшает сообщения об ошибках и предупреждения. Иными словами, любая более новая стабильная версия Rust, установленная с помощью этих шагов, должна работать как ожидается с содержимым этой книги.
Обозначения командной строки
В этой главе и на протяжении всей книги мы будем показывать некоторые команды, используемые в терминале. Строки, которые следует вводить в терминале, все начинаются с $. Вам не нужно вводить символ $; это приглашение командной строки, показываемое для указания начала каждой команды. Строки, которые не начинаются с $, обычно показывают вывод предыдущей команды. Кроме того, примеры, специфичные для PowerShell, будут использовать > вместо $.
Установка rustup в Linux или macOS
Если вы используете Linux или macOS, откройте терминал и введите следующую команду:
$ curl --proto '=https' --tlsv1.2 https://sh.rustup.rs -sSf | sh
Команда загружает скрипт и запускает установку инструмента rustup, который устанавливает последнюю стабильную версию Rust. Возможно, будет запрошен ваш пароль. Если установка прошла успешно, появится следующая строка:
Rust is installed now. Great!
Вам также потребуется компоновщик (linker) — программа, которую Rust использует для объединения своих скомпилированных результатов в один файл. Скорее всего, он у вас уже есть. Если вы получаете ошибки компоновщика, следует установить компилятор C, который обычно включает компоновщик. Компилятор C также полезен, потому что некоторые распространённые пакеты Rust зависят от кода на C и нуждаются в компиляторе C.
В macOS компилятор C можно получить, выполнив:
$ xcode-select --install
Пользователям Linux следует обычно устанавливать GCC или Clang в соответствии с документацией их дистрибутива. Например, если вы используете Ubuntu, можно установить пакет build-essential.
Установка rustup в Windows
В Windows перейдите на https://www.rust-lang.org/tools/install и следуйте инструкциям по установке Rust. На каком-то этапе установки вам будет предложено установить Visual Studio. Это предоставляет компоновщик и нативные библиотеки, необходимые для компиляции программ. Если вам нужна дополнительная помощь с этим шагом, см. https://rust-lang.github.io/rustup/installation/windows-msvc.html.
Остальная часть этой книги использует команды, которые работают как в cmd.exe, так и в PowerShell. Если есть конкретные различия, мы объясним, что использовать.
Устранение неполадок
Чтобы проверить, правильно ли установлен Rust, откройте оболочку и введите эту строку:
$ rustc --version
Вы должны увидеть номер версии, хеш коммита и дату коммита для последней стабильной версии, которая была выпущена, в следующем формате:
rustc x.y.z (abcabcabc yyyy-mm-dd)
Если вы видите эту информацию, вы успешно установили Rust! Если вы не видите эту информацию, проверьте, что Rust находится в вашей системной переменной %PATH%, следующим образом.
В Windows CMD используйте:
> echo %PATH%
В PowerShell используйте:
> echo $env:Path
В Linux и macOS используйте:
$ echo $PATH
Если всё правильно и Rust всё ещё не работает, есть ряд мест, где можно получить помощь. Узнайте, как связаться с другими Rustaceans (глупое прозвище, которое мы себе дали), на странице сообщества.
Обновление и удаление
После установки Rust через rustup обновление до только что выпущенной версии выполняется легко. Из вашей оболочки запустите следующий скрипт обновления:
$ rustup update
Чтобы удалить Rust и rustup, запустите следующий скрипт удаления из вашей оболочки:
$ rustup self uninstall
Чтение локальной документации
Установка Rust также включает локальную копию документации, чтобы вы могли читать её офлайн. Запустите rustup doc, чтобы открыть локальную документацию в браузере.
Всякий раз, когда какой-либо тип или функция предоставляется стандартной библиотекой и вы не уверены, что он делает или как его использовать, обратитесь к документации по интерфейсу программирования приложений (API), чтобы узнать!
Использование текстовых редакторов и IDE
Эта книга не делает предположений о том, какие инструменты вы используете для написания кода на Rust. Подойдёт практически любой текстовый редактор! Однако многие текстовые редакторы и интегрированные среды разработки (IDE) имеют встроенную поддержку Rust. Вы всегда можете найти довольно актуальный список многих редакторов и IDE на странице инструментов на сайте Rust.
Работа с этой книгой офлайн
В нескольких примерах мы будем использовать пакеты Rust за пределами стандартной библиотеки. Чтобы проработать эти примеры, вам потребуется либо подключение к интернету, либо заранее загруженные эти зависимости. Чтобы загрузить зависимости заранее, можно выполнить следующие команды. (Мы подробно объясним, что такое cargo и что делает каждая из этих команд, позже.)
$ cargo new get-dependencies
$ cd get-dependencies
$ cargo add rand@0.10.1 trpl@0.2.0
Это закеширует загрузки для этих пакетов, так что вам не потребуется загружать их позже. После выполнения этой команды вам не нужно сохранять папку get-dependencies. Если вы выполнили эту команду, вы можете использовать флаг --offline со всеми командами cargo в остальной части книги, чтобы использовать эти закешированные версии вместо попытки использования сети.
Hello, World!
Hello, World!
Теперь, когда Rust установлен, пришло время написать первую программу на Rust.
При изучении нового языка традиционно пишут небольшую программу, которая
выводит на экран текст Hello, world!, так что сделаем то же самое и здесь!
Примечание: эта книга предполагает базовое знакомство с командной строкой. Rust
не предъявляет конкретных требований к редактору, инструментам или расположению кода,
поэтому если предпочтительнее использовать IDE вместо командной строки, можно
пользоваться любимой IDE. Многие IDE сейчас имеют ту или иную поддержку Rust;
подробности смотрите в документации IDE. Команда Rust сосредоточена на обеспечении
отличной поддержки IDE через rust-analyzer. См. Приложение D
для подробностей.
Настройка каталога проекта
Начнём с создания каталога для хранения кода на Rust. Для Rust не имеет значения, где находится код, но для упражнений и проектов в этой книге предлагается создать каталог projects в домашнем каталоге и хранить все проекты там.
Откройте терминал и введите следующие команды, чтобы создать каталог projects и каталог для проекта «Hello, world!» внутри каталога projects.
Для Linux, macOS и PowerShell в Windows введите:
$ mkdir ~/projects
$ cd ~/projects
$ mkdir hello_world
$ cd hello_world
Для Windows CMD введите:
> mkdir "%USERPROFILE%\projects"
> cd /d "%USERPROFILE%\projects"
> mkdir hello_world
> cd hello_world
Основы программы на Rust
Далее создайте новый исходный файл и назовите его main.rs. Файлы Rust всегда заканчиваются расширением .rs. Если в имени файла больше одного слова, принято разделять их подчёркиванием. Например, используйте hello_world.rs, а не helloworld.rs.
Теперь откройте только что созданный файл main.rs и введите код из листинга 1-1.
fn main() {
    println!("Hello, world!");
}Hello, world!Сохраните файл и вернитесь в окно терминала в каталоге ~/projects/hello_world. В Linux или macOS введите следующие команды, чтобы скомпилировать и запустить файл:
$ rustc main.rs
$ ./main
Hello, world!
В Windows введите команду .\main вместо ./main:
> rustc main.rs
> .\main
Hello, world!
Независимо от операционной системы в терминале должна вывестись строка Hello, world!. Если этот вывод не появился, вернитесь к
разделу «Устранение неполадок» в разделе
об установке, чтобы узнать, как получить помощь.
Если Hello, world! действительно вывелось, поздравляем! Вы официально написали
программу на Rust. Это делает вас программистом на Rust — добро пожаловать!
Анатомия программы на Rust
Давайте подробно рассмотрим эту программу «Hello, world!». Вот первая часть головоломки:
fn main() {

}
Эти строки определяют функцию с именем main. Функция main особенная:
это всегда первый код, который выполняется в любой исполняемой программе на Rust. Здесь
первая строка объявляет функцию с именем main, которая не имеет параметров и ничего
не возвращает. Если бы параметры были, они находились бы внутри круглых скобок (()).
Тело функции заключено в {}. Rust требует фигурные скобки вокруг всех
тел функций. Хорошим стилем считается размещать открывающую фигурную скобку на той же
строке, что и объявление функции, добавляя один пробел между ними.
Примечание: если нужно придерживаться единого стиля во всех проектах на Rust, можно
использовать автоматический форматтер под названием rustfmt, чтобы форматировать код в
определённом стиле (подробнее о rustfmt в
Приложении D). Команда Rust включила этот инструмент
в стандартную поставку Rust, как и rustc, поэтому он, скорее всего, уже
установлен на компьютере!
Тело функции main содержит следующий код:
#![allow(unused)]
fn main() {
println!("Hello, world!");
}
Эта строка выполняет всю работу в этой небольшой программе: она выводит текст на экран. Здесь следует заметить три важные детали.
Во-первых, println! вызывает макрос Rust. Если бы он вызывал функцию,
он был бы записан как println (без !). Макросы Rust — это способ писать
код, который генерирует код для расширения синтаксиса Rust, и мы обсудим их более
подробно в главе 20. Пока достаточно
знать, что использование ! означает вызов макроса, а не обычной
функции, и что макросы не всегда следуют тем же правилам, что и функции.
Во-вторых, видна строка "Hello, world!". Мы передаём эту строку как аргумент
в println!, и строка выводится на экран.
В-третьих, строка заканчивается точкой с запятой (;), которая указывает, что это
выражение завершено и следующее готово начаться. Большинство строк кода на Rust
заканчиваются точкой с запятой.
Компиляция и выполнение
Только что была запущена только что созданная программа, поэтому давайте рассмотрим каждый шаг процесса.
Перед запуском программы на Rust её необходимо скомпилировать с помощью компилятора Rust,
введя команду rustc и передав ей имя исходного файла, вот так:
$ rustc main.rs
Если есть опыт работы с C или C++, можно заметить, что это похоже на gcc
или clang. После успешной компиляции Rust выводит бинарный исполняемый файл.
В Linux, macOS и PowerShell в Windows можно увидеть исполняемый файл, введя
команду ls в оболочке:
$ ls
main  main.rs
В Linux и macOS будет видно два файла. В PowerShell в Windows будет видно те же три файла, что и при использовании CMD. В CMD в Windows нужно ввести следующее:
> dir /B %= the /B option says to only show the file names =%
main.exe
main.pdb
main.rs
Здесь показан файл исходного кода с расширением .rs, исполняемый файл (main.exe в Windows, но main на всех остальных платформах) и, при использовании Windows, файл с отладочной информацией с расширением .pdb. Отсюда запускается файл main или main.exe, вот так:
$ ./main # или .\main в Windows
Если main.rs — это программа «Hello, world!», эта строка выведет Hello, world! в
терминал.
Если больше знаком динамический язык, такой как Ruby, Python или JavaScript, возможно, непривычно компилировать и запускать программу в отдельных шагах. Rust — это язык с предварительной компиляцией, то есть можно скомпилировать программу и передать исполняемый файл кому-то другому, и они смогут запустить его даже без установленного Rust. Если передать кому-то файл .rb, .py или .js, им потребуется установленная реализация Ruby, Python или JavaScript (соответственно). Но в этих языках нужна только одна команда, чтобы скомпилировать и запустить программу. В дизайне языков всё — компромисс.
Простой компиляции с помощью rustc достаточно для простых программ, но по мере роста проекта
захочется управлять всеми опциями и легко делиться
кодом. Далее мы познакомимся с инструментом Cargo, который поможет писать
настоящие программы на Rust.
Hello, Cargo!
Hello, Cargo!
Cargo — это система сборки и менеджер пакетов Rust. Большинство Rustaceans используют этот инструмент для управления своими проектами на Rust, поскольку Cargo выполняет за вас множество задач, таких как сборка кода, загрузка библиотек, от которых зависит ваш код, и сборка этих библиотек. (Библиотеки, которые нужны вашему коду, мы называем зависимостями.)
Простейшие программы на Rust, как та, что мы написали до сих пор, не имеют зависимостей. Если бы мы собрали проект «Hello, world!» с помощью Cargo, он использовал бы только ту часть Cargo, которая отвечает за сборку кода. По мере написания более сложных программ на Rust вы будете добавлять зависимости, и если начать проект с использованием Cargo, добавлять зависимости будет гораздо проще.
Поскольку подавляющее большинство проектов на Rust используют Cargo, остальная часть этой книги предполагает, что вы тоже используете Cargo. Cargo устанавливается вместе с Rust, если использовались официальные установщики, описанные в разделе «Установка». Если Rust был установлен каким-либо другим способом, проверьте, установлен ли Cargo, введя в терминале следующую команду:
$ cargo --version
Если отображается номер версии — Cargo установлен! Если появляется ошибка, например command not found, обратитесь к документации для вашего способа установки, чтобы
определить, как установить Cargo отдельно.
Создание проекта с помощью Cargo
Создадим новый проект с помощью Cargo и посмотрим, чем он отличается от исходного проекта «Hello, world!». Вернитесь в каталог projects (или туда, где вы решили хранить код). Затем в любой операционной системе выполните следующее:
$ cargo new hello_cargo
$ cd hello_cargo
Первая команда создаёт новый каталог и проект с именем hello_cargo. Мы назвали проект hello_cargo, и Cargo создаёт свои файлы в каталоге с тем же именем.
Перейдите в каталог hello_cargo и выведите список файлов. Вы увидите, что Cargo сгенерировал для нас два файла и один каталог: файл Cargo.toml и каталог src с файлом main.rs внутри.
Он также инициализировал новый репозиторий Git вместе с файлом .gitignore.
Файлы Git не будут созданы, если запустить cargo new внутри существующего репозитория
Git; это поведение можно переопределить с помощью cargo new --vcs=git.
Примечание: Git — распространённая система контроля версий. Можно изменить cargo new, чтобы
использовать другую систему контроля версий или не использовать её вовсе, с помощью
флага --vcs. Запустите cargo new --help, чтобы увидеть доступные параметры.
Откройте Cargo.toml в любом удобном текстовом редакторе. Он должен выглядеть примерно так, как код в листинге 1-2.
[package]
name = "hello_cargo"
version = "0.1.0"
edition = "2024"

[dependencies]
cargo newЭтот файл имеет формат TOML (Tom’s Obvious, Minimal Language), который является форматом конфигурации Cargo.
Первая строка, [package], — это заголовок раздела, указывающий, что
следующие операторы настраивают пакет. По мере добавления информации в
этот файл мы будем добавлять другие разделы.
Следующие три строки задают информацию о конфигурации, необходимую Cargo для компиляции
программы: имя, версию и используемую редакцию Rust. Мы поговорим
о ключе edition в Приложении E.
Последняя строка, [dependencies], — это начало раздела для перечисления
зависимостей проекта. В Rust пакеты кода называются
крейтами. Для этого проекта нам не понадобятся другие крейты, но они понадобятся в
первом проекте главы 2, поэтому мы воспользуемся этим разделом зависимостей тогда.
Теперь откройте src/main.rs и взгляните на него:
Имя файла: src/main.rs
fn main() {
    println!("Hello, world!");
}
Cargo сгенерировал для вас программу «Hello, world!», такую же, как та, что мы написали в листинге 1-1! Пока что различия между нашим проектом и проектом, созданным Cargo, заключаются в том, что Cargo поместил код в каталог src, и у нас есть файл конфигурации Cargo.toml в корневом каталоге.
Cargo ожидает, что исходные файлы будут находиться внутри каталога src. Каталог проекта верхнего уровня предназначен только для файлов README, информации о лицензии, файлов конфигурации и всего остального, что не связано с кодом. Использование Cargo помогает организовать проекты. Для всего есть своё место, и всё находится на своём месте.
Если проект был начат без использования Cargo, как мы сделали с проектом «Hello,
world!», его можно преобразовать в проект, использующий Cargo. Переместите
код проекта в каталог src и создайте соответствующий файл Cargo.toml.
Простой способ получить этот файл Cargo.toml — запустить cargo init, который
создаст его автоматически.
Сборка и запуск проекта Cargo
Теперь посмотрим, что изменится при сборке и запуске программы «Hello, world!» с помощью Cargo! Находясь в каталоге hello_cargo, соберите проект, введя следующую команду:
$ cargo build
   Compiling hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 2.85 secs
Эта команда создаёт исполняемый файл в target/debug/hello_cargo (или target\debug\hello_cargo.exe в Windows), а не в текущем каталоге. Поскольку сборка по умолчанию является отладочной, Cargo помещает бинарный файл в каталог с именем debug. Запустить исполняемый файл можно командой:
$ ./target/debug/hello_cargo # or .\target\debug\hello_cargo.exe on Windows
Hello, world!
Если всё прошло хорошо, в терминал должно вывестись Hello, world!. Запуск cargo build в первый раз также заставляет Cargo создать новый файл в корневом
каталоге: Cargo.lock. Этот файл отслеживает точные версии
зависимостей в проекте. В этом проекте нет зависимостей, поэтому
файл довольно скудный. Никогда не придётся изменять этот файл вручную; Cargo
управляет его содержимым за вас.
Мы только что собрали проект с помощью cargo build и запустили его с
помощью ./target/debug/hello_cargo, но можно также использовать cargo run, чтобы скомпилировать
код и затем запустить полученный исполняемый файл одной командой:
$ cargo run
    Finished dev [unoptimized + debuginfo] target(s) in 0.0 secs
     Running `target/debug/hello_cargo`
Hello, world!
Использовать cargo run удобнее, чем запоминать, что нужно запустить cargo build, а затем использовать полный путь к бинарному файлу, поэтому большинство разработчиков используют cargo run.
Обратите внимание, что на этот раз мы не увидели вывода о том, что Cargo компилирует
hello_cargo. Cargo определил, что файлы не изменились, поэтому он не
пересобирал проект, а просто запустил бинарный файл. Если бы исходный код был изменён, Cargo
пересобрал бы проект перед запуском, и вы увидели бы такой
вывод:
$ cargo run
   Compiling hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 0.33 secs
     Running `target/debug/hello_cargo`
Hello, world!
Cargo также предоставляет команду cargo check. Эта команда быстро проверяет
код на то, что он компилируется, но не создаёт исполняемый файл:
$ cargo check
   Checking hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 0.32 secs
Почему может не понадобиться исполняемый файл? Часто cargo check работает намного быстрее, чем
cargo build, потому что пропускает этап создания исполняемого файла. Если
постоянно проверять работу по мере написания кода, использование cargo check
ускорит процесс получения информации о том, компилируется ли ещё проект! Поэтому
многие Rustaceans периодически запускают cargo check по мере написания
программы, чтобы убедиться, что она компилируется. Затем они запускают cargo build, когда
готовы использовать исполняемый файл.
Подведём итог тому, что мы узнали о Cargo:
- Можно создать проект с помощью
cargo new. - Можно собрать проект с помощью
cargo build. - Можно собрать и запустить проект за один шаг с помощью
cargo run. - Можно собрать проект без создания бинарного файла для проверки ошибок с помощью
cargo check. - Вместо сохранения результата сборки в том же каталоге, что и код, Cargo сохраняет его в каталоге target/debug.
Дополнительное преимущество использования Cargo заключается в том, что команды одинаковы независимо от операционной системы. Поэтому с этого момента мы больше не будем приводить отдельные инструкции для Linux и macOS и для Windows.
Сборка для релиза
Когда проект наконец готов к выпуску, можно использовать cargo build --release, чтобы скомпилировать его с оптимизациями. Эта команда создаст
исполняемый файл в target/release вместо target/debug. Оптимизации
заставляют код на Rust работать быстрее, но их включение увеличивает время
компиляции программы. Именно поэтому существуют два разных профиля: один
для разработки, когда нужно быстро и часто пересобирать проект, и другой для
сборки финальной программы, которую вы передадите пользователю, которая не будет пересобираться
многократно и будет работать как можно быстрее. Если проводится бенчмаркинг
времени выполнения кода, обязательно запустите cargo build --release и выполняйте бенчмарк с
исполняемым файлом в target/release.
Использование соглашений Cargo
В простых проектах Cargo не даёт большого преимущества по сравнению с простым использованием
rustc, но он докажет свою ценность по мере усложнения программ.
Как только программы вырастают до нескольких файлов или нуждаются в зависимости, гораздо проще
позволить Cargo координировать сборку.
Хотя проект hello_cargo прост, он теперь использует большую часть реального
инструментария, который будет использоваться на протяжении всей карьеры в Rust. Фактически, для работы с любыми
существующими проектами можно использовать следующие команды, чтобы получить код
с помощью Git, перейти в каталог проекта и собрать его:
$ git clone example.org/someproject
$ cd someproject
$ cargo build
Дополнительную информацию о Cargo см. в его документации.
Итоги
Вы уже отлично начали свой путь в Rust! В этой главе вы узнали, как:
- Установить последнюю стабильную версию Rust с помощью
rustup. - Обновиться до более новой версии Rust.
- Открыть локально установленную документацию.
- Написать и запустить программу «Hello, world!» напрямую с помощью
rustc. - Создать и запустить новый проект, используя соглашения Cargo.
Это отличное время, чтобы создать более существенную программу и привыкнуть читать и писать код на Rust. Поэтому в главе 2 мы создадим программу-угадайку. Если же вы предпочитаете начать с изучения того, как работают распространённые концепции программирования в Rust, см. Главу 3, а затем вернитесь к главе 2.
Программирование игры «Угадай число»
Программирование игры «Угадай число»
Давайте окунёмся в Rust, вместе проработав практический проект! Эта глава
познакомит вас с несколькими общими концепциями Rust, показав, как
использовать их в реальной программе. Вы узнаете о let, match, методах,
ассоциированных функциях, внешних крейтах и многом другом! В последующих
главах мы рассмотрим эти идеи более подробно. В этой главе вы просто
попрактикуетесь в основах.
Мы реализуем классическую учебную задачу по программированию: игру по угадыванию числа. Вот как она работает: программа генерирует случайное целое число от 1 до 100. Затем она предлагает игроку ввести догадку. После ввода догадки программа сообщает, слишком ли она мала или слишком велика. Если догадка верна, игра выводит поздравление и завершается.
Настройка нового проекта
Чтобы настроить новый проект, перейдите в каталог projects, который вы создали в главе 1, и создайте новый проект с помощью Cargo, вот так:
$ cargo new guessing_game
$ cd guessing_game
Первая команда, cargo new, принимает имя проекта (guessing_game) в
качестве первого аргумента. Вторая команда переходит в каталог нового
проекта.
Взгляните на сгенерированный файл Cargo.toml:
Имя файла: Cargo.toml
[package]
name = "guessing_game"
version = "0.1.0"
edition = "2024"

[dependencies]
Как вы видели в главе 1, cargo new генерирует для вас программу
«Hello, world!». Взгляните на файл src/main.rs:
Имя файла: src/main.rs
fn main() {
    println!("Hello, world!");
}
Теперь скомпилируем эту программу «Hello, world!» и запустим её за один шаг
с помощью команды cargo run:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.08s
     Running `target/debug/guessing_game`
Hello, world!
Команда run удобна, когда нужно быстро итерировать по проекту, как мы
будем делать в этой игре, быстро проверяя каждую итерацию перед переходом к
следующей.
Снова откройте файл src/main.rs. Весь код в этой главе вы будете писать в этом файле.
Обработка догадки
Первая часть программы игры по угадыванию будет запрашивать ввод пользователя, обрабатывать этот ввод и проверять, что ввод имеет ожидаемую форму. Для начала мы позволим игроку ввести догадку. Введите код из листинга 2-1 в src/main.rs.
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}Этот код содержит много информации, поэтому давайте разберём его строка за
строкой. Чтобы получить пользовательский ввод и затем вывести результат,
нам нужно подключить библиотеку ввода-вывода io. Библиотека io
происходит из стандартной библиотеки, известной как std:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
По умолчанию Rust имеет набор элементов, определённых в стандартной библиотеке, которые он подключает в область видимости каждой программы. Этот набор называется прелюдией, и вы можете увидеть всё в нём в документации стандартной библиотеки.
Если тип, который вы хотите использовать, не входит в прелюдию, вам нужно
явно подключить этот тип в область видимости с помощью инструкции use.
Использование библиотеки std::io предоставляет вам ряд полезных
возможностей, включая возможность принимать пользовательский ввод.
Как вы видели в главе 1, функция main является точкой входа в программу:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Синтаксис fn объявляет новую функцию; круглые скобки () указывают, что
параметров нет; а фигурная скобка { открывает тело функции.
Как вы также узнали в главе 1, println! — это макрос, который выводит
строку на экран:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Этот код выводит приглашение, сообщающее, что это за игра, и запрашивает ввод от пользователя.
Хранение значений с помощью переменных
Далее мы создадим переменную для хранения пользовательского ввода, вот так:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Теперь программа становится интересной! В этой маленькой строке много
всего происходит. Мы используем инструкцию let для создания переменной.
Вот ещё пример:
let apples = 5;Эта строка создаёт новую переменную с именем apples и привязывает её к
значению 5. В Rust переменные по умолчанию неизменяемы, что означает, что
после присвоения переменной значения оно не изменится. Мы подробно обсудим
эту концепцию в разделе
«Переменные и изменяемость»
главы 3. Чтобы сделать переменную изменяемой, мы добавляем mut перед
именем переменной:
let apples = 5; // неизменяемая
let mut bananas = 5; // изменяемая
Примечание: Синтаксис // начинает комментарий, который продолжается до
конца строки. Rust игнорирует всё в комментариях. Мы обсудим комментарии
более подробно в главе 3.
Возвращаясь к программе игры по угадыванию, вы теперь знаете, что
let mut guess введёт изменяемую переменную с именем guess. Знак
равенства (=) сообщает Rust, что мы хотим привязать что-то к переменной
сейчас. Справа от знака равенства находится значение, к которому привязана
guess, — это результат вызова String::new, функции, которая возвращает
новый экземпляр String. String — это строковый тип,
предоставляемый стандартной библиотекой, который является расширяемым
фрагментом текста в кодировке UTF-8.
Синтаксис :: в строке ::new указывает, что new — это
ассоциированная функция типа String. Ассоциированная функция — это
функция, реализованная для типа, в данном случае для String. Эта функция
new создаёт новую пустую строку. Вы найдёте функцию new у многих
типов, потому что это распространённое имя для функции, создающей новое
значение какого-либо рода.
Полностью строка let mut guess = String::new(); создала изменяемую
переменную, которая в настоящее время привязана к новому, пустому экземпляру
String. Ух!
Получение пользовательского ввода
Вспомните, что мы подключили функциональность ввода-вывода из стандартной
библиотеки с помощью use std::io; в первой строке программы. Теперь мы
вызовем функцию stdin из модуля io, которая позволит нам обрабатывать
пользовательский ввод:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Если бы мы не импортировали модуль io с помощью use std::io; в начале
программы, мы всё равно могли бы использовать функцию, записав этот вызов
как std::io::stdin. Функция stdin возвращает экземпляр
std::io::Stdin, который является типом,
представляющим дескриптор стандартного ввода для вашего терминала.
Далее, строка .read_line(&mut guess) вызывает метод
read_line у дескриптора стандартного ввода, чтобы получить ввод от
пользователя. Мы также передаём &mut guess в качестве аргумента в
read_line, чтобы сообщить ей, в какую строку сохранить ввод пользователя.
Полная задача read_line — принять всё, что пользователь вводит в
стандартный ввод, и добавить это в строку (без перезаписи её содержимого),
поэтому мы передаём эту строку в качестве аргумента. Строковый аргумент
должен быть изменяемым, чтобы метод мог изменить содержимое строки.
Символ & указывает, что этот аргумент является ссылкой, которая даёт
вам способ позволить нескольким частям вашего кода обращаться к одному
фрагменту данных без необходимости копировать эти данные в память несколько
раз. Ссылки — сложная функция, и одно из главных преимуществ Rust — это то,
насколько безопасно и просто использовать ссылки. Вам не нужно знать много
этих деталей, чтобы закончить эту программу. Пока всё, что вам нужно знать,
— это то, что, как и переменные, ссылки по умолчанию неизменяемы. Следова
тельно, вам нужно написать &mut guess, а не &guess, чтобы сделать её
изменяемой. (глава 4 более подробно объяснит ссылки.)
Обработка потенциальной ошибки с помощью Result
Мы всё ещё работаем над этой строкой кода. Сейчас мы обсуждаем третью строку текста, но обратите внимание, что это всё ещё часть одной логической строки кода. Следующая часть — это метод:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Мы могли бы написать этот код так:
io::stdin().read_line(&mut guess).expect("Failed to read line");Однако одну длинную строку трудно читать, поэтому лучше разделить её. Часто
разумно вводить перевод строки и другие пробельные символы, чтобы разбить
длинные строки, когда вы вызываете метод с синтаксисом .method_name().
Теперь давайте обсудим, что делает эта строка.
Как упоминалось ранее, read_line помещает всё, что вводит пользователь, в
строку, которую мы ей передаём, но она также возвращает значение Result.
Result — это перечисление, часто
называемое enum, то есть тип, который может находиться в одном из
нескольких возможных состояний. Мы называем каждое возможное состояние
вариантом.
Глава 6 более подробно рассмотрит
перечисления. Назначение этих типов Result — кодировать информацию об
обработке ошибок.
Варианты Result — это Ok и Err. Вариант Ok указывает, что операция
успешна, и содержит успешно сгенерированное значение. Вариант Err
означает, что операция не удалась, и содержит информацию о том, как или
почему операция не удалась.
Значения типа Result, как и значения любого типа, имеют определённые на
них методы. Экземпляр Result имеет метод expect,
который вы можете вызвать. Если этот экземпляр Result является значением
Err, expect вызовет сбой программы и отобразит сообщение, которое вы
передали в качестве аргумента в expect. Если метод read_line возвращает
Err, это, вероятно, будет результатом ошибки, исходящей от базовой
операционной системы. Если этот экземпляр Result является значением
Ok, expect возьмёт возвращаемое значение, которое хранит Ok, и
вернёт вам только это значение, чтобы вы могли его использовать. В данном
случае это значение — количество байтов во вводе пользователя.
Если вы не вызовете expect, программа скомпилируется, но вы получите
предупреждение:
$ cargo build
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
warning: unused `Result` that must be used
  --> src/main.rs:10:5
   |
10 |     io::stdin().read_line(&mut guess);
   |     ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
   |
   = note: this `Result` may be an `Err` variant, which should be handled
   = note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
   |
10 |     let _ = io::stdin().read_line(&mut guess);
   |     +++++++

warning: `guessing_game` (bin "guessing_game") generated 1 warning
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.59s
Rust предупреждает, что вы не использовали значение Result, возвращённое
из read_line, указывая, что программа не обработала возможную ошибку.
Правильный способ подавить предупреждение — действительно написать код
обработки ошибок, но в нашем случае мы просто хотим, чтобы программа
завершилась при возникновении проблемы, поэтому мы можем использовать
expect. Вы узнаете о восстановлении после ошибок в
главе 9.
Вывод значений с помощью заполнителей println!
Помимо закрывающей фигурной скобки, в коде на данный момент осталась только одна строка для обсуждения:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Эта строка выводит строку, которая теперь содержит пользовательский ввод.
Набор фигурных скобок {} — это заполнитель: думайте о {} как о
маленьких клешнях краба, которые удерживают значение на месте. При выводе
значения переменной имя переменной может находиться внутри фигурных скобок.
При выводе результата вычисления выражения поместите пустые фигурные скобки
в строку формата, а затем следуйте за строкой формата списком выражений,
разделённых запятыми, для вывода в каждый пустой заполнитель фигурных
скобок в том же порядке. Вывод переменной и результата выражения в одном
вызове println! выглядел бы так:
#![allow(unused)]
fn main() {
let x = 5;
let y = 10;

println!("x = {x} and y + 2 = {}", y + 2);
}
Этот код вывел бы x = 5 and y + 2 = 12.
Тестирование первой части
Давайте протестируем первую часть игры по угадыванию. Запустите её с помощью
cargo run:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 6.44s
     Running `target/debug/guessing_game`
Guess the number!
Please input your guess.
6
You guessed: 6
На этом первая часть игры завершена: мы получаем ввод с клавиатуры и затем выводим его.
Генерация секретного числа
Далее нам нужно сгенерировать секретное число, которое пользователь будет
пытаться угадать. Секретное число должно быть разным каждый раз, чтобы в
игру было интересно играть больше одного раза. Мы будем использовать
случайное число от 1 до 100, чтобы игра не была слишком сложной. Rust пока
не включает функциональность случайных чисел в свою стандартную библиотеку.
Однако команда Rust предоставляет крейт rand с
этой функциональностью.
Расширение функциональности с помощью крейта
Помните, что крейт — это набор файлов исходного кода Rust. Проект, который
мы строим, — это бинарный крейт, то есть исполняемый файл. Крейт rand —
это библиотечный крейт, который содержит код, предназначенный для
использования в других программах и не может выполняться сам по себе.
Координация внешних крейтов в Cargo — вот где Cargo действительно блистает.
Прежде чем мы сможем написать код, использующий rand, нам нужно
изменить файл Cargo.toml, чтобы включить крейт rand в качестве
зависимости. Откройте этот файл сейчас и добавьте следующую строку внизу,
под заголовком раздела [dependencies], который Cargo создал для вас.
Обязательно укажите rand точно так, как мы здесь, с этим номером версии,
иначе примеры кода в этом руководстве могут не работать:
Имя файла: Cargo.toml
[dependencies]
rand = "0.10.1"
В файле Cargo.toml всё, что следует за заголовком, является частью этого
раздела, который продолжается до начала другого раздела. В [dependencies]
вы сообщаете Cargo, от каких внешних крейтов зависит ваш проект и какие
версии этих крейтов вам нужны. В данном случае мы указываем крейт rand с
описателем семантической версии 0.10.1. Cargo понимает
семантическое версионирование (иногда
называемое SemVer), которое является стандартом для записи номеров
версий. Описатель 0.10.1 на самом деле является сокращением для
^0.10.1, что означает любую версию не ниже 0.10.1, но ниже 0.11.0.
Cargo считает эти версии имеющими публичные API, совместимые с версией 0.10.1, и эта спецификация гарантирует, что вы получите последний патч-релиз, который всё ещё будет компилироваться с кодом в этой главе. Любая версия 0.11.0 или выше не гарантирует тот же API, что используют следующие примеры.
Теперь, не меняя никакого кода, давайте соберём проект, как показано в листинге 2-2.
$ cargo build
    Updating crates.io index
     Locking 8 packages to latest Rust 1.96.0 compatible versions
  Downloaded rand_core v0.10.1
  Downloaded chacha20 v0.10.1
  Downloaded rand v0.10.1
  Downloaded 3 crates (162.9KiB) in 0.59s
   Compiling libc v0.2.186
   Compiling rand_core v0.10.1
   Compiling getrandom v0.4.3
   Compiling cfg-if v1.0.4
   Compiling chacha20 v0.10.1
   Compiling rand v0.10.1
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 2.03s
cargo build после добавления крейта rand в качестве зависимостиВы можете увидеть другие номера версий (но все они будут совместимы с кодом, благодаря SemVer!) и другие строки (в зависимости от операционной системы), и строки могут быть в другом порядке.
Когда мы включаем внешнюю зависимость, Cargo извлекает последние версии всего, что нужно этой зависимости, из реестра, который является копией данных с Crates.io. Crates.io — это место, где люди в экосистеме Rust публикуют свои проекты с открытым исходным кодом на Rust, чтобы другие могли их использовать.
После обновления реестра Cargo проверяет раздел [dependencies] и
загружает любые перечисленные крейты, которые ещё не были загружены. В этом
случае, хотя мы указали только rand в качестве зависимости, Cargo также
захватил другие крейты, от которых зависит rand для работы. После
загрузки крейтов Rust компилирует их, а затем компилирует проект с
доступными зависимостями.
Если вы сразу запустите cargo build снова, не внося никаких изменений,
вы не получите никакого вывода, кроме строки Finished. Cargo знает, что
он уже загрузил и скомпилировал зависимости, и вы ничего не меняли в них в
вашем файле Cargo.toml. Cargo также знает, что вы ничего не меняли в
вашем коде, поэтому он не перекомпилирует и его. Когда делать нечего, он
просто выходит.
Если вы откроете файл src/main.rs, внесёте незначительное изменение, а затем сохраните его и снова соберёте, вы увидите только две строки вывода:
$ cargo build
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.13s
Эти строки показывают, что Cargo обновляет сборку только с вашим небольшим изменением в файле src/main.rs. Ваши зависимости не изменились, поэтому Cargo знает, что может повторно использовать то, что он уже загрузил и скомпилировал для них.
Обеспечение воспроизводимых сборок
Cargo имеет механизм, который гарантирует, что вы можете пересобрать тот же
артефакт каждый раз, когда вы или кто-либо другой собирает ваш код: Cargo
будет использовать только те версии зависимостей, которые вы указали, пока
вы не укажете иное. Например, предположим, что на следующей неделе выйдет
версия 0.10.2 крейта rand, и эта версия содержит важное исправление
ошибки, но она также содержит регрессию, которая сломает ваш код. Чтобы
справиться с этим, Rust создаёт файл Cargo.lock при первом запуске
cargo build, поэтому теперь у нас есть этот файл в каталоге
guessing_game.
Когда вы собираете проект впервые, Cargo выясняет все версии зависимостей, которые соответствуют критериям, а затем записывает их в файл Cargo.lock. Когда вы соберёте свой проект в будущем, Cargo увидит, что файл Cargo.lock существует, и будет использовать указанные там версии вместо того, чтобы проделывать всю работу по определению версий заново. Это позволяет вам автоматически получать воспроизводимую сборку. Другими словами, ваш проект останется на версии 0.10.1, пока вы явно не обновите её, благодаря файлу Cargo.lock. Поскольку файл Cargo.lock важен для воспроизводимых сборок, его часто добавляют в систему контроля версий вместе с остальным кодом вашего проекта.
Обновление крейта для получения новой версии
Когда вы действительно хотите обновить крейт, Cargo предоставляет команду
update, которая проигнорирует файл Cargo.lock и выяснит все последние
версии, которые соответствуют вашим спецификациям в Cargo.toml. Затем
Cargo запишет эти версии в файл Cargo.lock. В противном случае по
умолчанию Cargo будет искать только версии больше 0.10.1 и меньше 0.11.0.
Если крейт rand выпустил две новые версии 0.10.2 и 0.999.0, вы увидели
бы следующее, если бы запустили cargo update:
$ cargo update
    Updating crates.io index
     Locking 1 package to latest Rust 1.96.0 compatible version
    Updating rand v0.10.1 -> v0.10.2 (available: v0.999.0)
Cargo игнорирует релиз 0.999.0. В этот момент вы также заметите изменение в
вашем файле Cargo.lock, отмечающее, что версия крейта rand, которую вы
теперь используете, — 0.10.2. Чтобы использовать rand версии 0.999.0 или
любую версию в серии 0.999.x, вам нужно было бы изменить файл
Cargo.toml, чтобы он выглядел так (не делайте это изменение на самом
деле, потому что следующие примеры предполагают, что вы используете
rand 0.10):
[dependencies]
rand = "0.999.0"
В следующий раз, когда вы запустите cargo build, Cargo обновит реестр
доступных крейтов и переоценит ваши требования к rand в соответствии с
новой версией, которую вы указали.
Можно многое сказать о Cargo и его экосистеме, что мы обсудим в главе 14, но пока это всё, что вам нужно знать. Cargo делает повторное использование библиотек очень простым, поэтому растацеане могут писать меньшие проекты, собираемые из ряда пакетов.
Генерация случайного числа
Давайте начнём использовать rand для генерации числа, которое нужно
угадать. Следующий шаг — обновить src/main.rs, как показано в листинге
2-3.
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}Сначала мы добавляем строку use rand::prelude::*;. Модуль prelude
содержит наиболее часто используемые части крейта rand, и use делает
эти элементы доступными в области видимости нашей программы.
Далее мы добавляем две строки посередине. В первой строке мы вызываем
функцию rand::rng, которая даёт нам конкретный генератор случайных
чисел, который мы будем использовать: локальный для текущего потока
выполнения и инициализируемый операционной системой. Затем мы вызываем метод
random_range у генератора случайных чисел. Этот метод определяется
трейтом RngExt, который является частью модуля rand::prelude, который мы
подключили в область видимости с помощью инструкции use rand::prelude::*;.
Метод random_range принимает выражение диапазона в качестве аргумента и
генерирует случайное число в диапазоне. Вид выражения диапазона, который мы
здесь используем, имеет форму start..=end и является включающим как для
нижней, так и для верхней границы, поэтому нам нужно указать 1..=100,
чтобы запросить число от 1 до 100.
Примечание: Вы не просто узнаете, что подключить в область видимости и какие
методы и функции вызывать из крейта, поэтому каждый крейт имеет документацию
с инструкциями по его использованию. Ещё одна замечательная особенность
Cargo заключается в том, что запуск команды cargo doc --open создаст
документацию, предоставленную всеми вашими зависимостями локально, и
откроет её в вашем браузере. Если вас интересует другая функциональность в
крейте rand, например, запустите cargo doc --open и щёлкните rand на
боковой панели слева.
Вторая новая строка выводит секретное число. Это полезно, пока мы разрабатываем программу, чтобы иметь возможность её тестировать, но мы удалим её из окончательной версии. Это не очень-то игра, если программа выводит ответ, как только начинается!
Попробуйте запустить программу несколько раз:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.02s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 7
Please input your guess.
4
You guessed: 4

$ cargo run
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.02s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 83
Please input your guess.
5
You guessed: 5
Вы должны получать разные случайные числа, и все они должны быть числами от
1 до 100. Если вы получаете предупреждения, их можно безопасно игнорировать.
Если вы получаете ошибки, пожалуйста, проверьте, что у вас в Cargo.toml
указано rand = "0.10.1", так как будущие версии rand могут иметь другой
API, но любая версия в серии 0.10 должна работать с кодом в этой главе.
Сравнение догадки с секретным числом
Теперь, когда у нас есть пользовательский ввод и случайное число, мы можем их сравнить. Этот шаг показан в листинге 2-4. Обратите внимание, что этот код пока не скомпилируется, как мы объясним.
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    // --snip--
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("Too small!"),
        Ordering::Greater => println!("Too big!"),
        Ordering::Equal => println!("You win!"),
    }
}Сначала мы добавляем ещё одну инструкцию use, подключая тип под названием
std::cmp::Ordering в область видимости из стандартной библиотеки. Тип
Ordering — это ещё одно перечисление, имеющее варианты Less, Greater
и Equal. Это три возможных исхода при сравнении двух значений.
Затем мы добавляем пять новых строк внизу, которые используют тип
Ordering. Метод cmp сравнивает два значения и может быть вызван для
чего угодно, что можно сравнивать. Он принимает ссылку на то, с чем вы
хотите сравнить: здесь он сравнивает guess с secret_number. Затем он
возвращает вариант перечисления Ordering, которое мы подключили в область
видимости с помощью инструкции use. Мы используем выражение
match, чтобы решить, что делать дальше,
основываясь на том, какой вариант Ordering был возвращён из вызова cmp
со значениями guess и secret_number.
Выражение match состоит из ветвей. Ветвь состоит из шаблона, с
которым нужно сопоставить, и кода, который должен быть выполнен, если
значение, переданное в match, соответствует шаблону этой ветви. Rust берёт
значение, переданное в match, и по очереди просматривает шаблон каждой
ветви. Шаблоны и конструкция match — мощные возможности Rust: они
позволяют вам выражать различные ситуации, с которыми может столкнуться ваш
код, и гарантируют, что вы их все обработаете. Эти возможности будут
подробно рассмотрены в главе 6 и главе 19 соответственно.
Давайте пройдёмся по примеру с выражением match, которое мы здесь
используем. Скажем, пользователь угадал 50, а случайно сгенерированное
секретное число в этот раз — 38.
Когда код сравнивает 50 с 38, метод cmp вернёт Ordering::Greater,
потому что 50 больше 38. Выражение match получает значение
Ordering::Greater и начинает проверять шаблон каждой ветви. Оно смотрит на
шаблон первой ветви, Ordering::Less, и видит, что значение
Ordering::Greater не соответствует Ordering::Less, поэтому игнорирует код
в этой ветви и переходит к следующей. Шаблон следующей ветви —
Ordering::Greater, который соответствует Ordering::Greater!
Связанный код в этой ветви выполнится и выведет Too big! на экран.
Выражение match завершается после первого успешного сопоставления,
поэтому оно не будет смотреть на последнюю ветвь в этом сценарии.
Однако код в листинге 2-4 пока не скомпилируется. Давайте попробуем:
$ cargo build
   Compiling libc v0.2.186
   Compiling rand_core v0.10.1
   Compiling getrandom v0.4.3
   Compiling cfg-if v1.0.0
   Compiling chacha20 v0.10.1
   Compiling rand v0.10.1
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
error[E0308]: mismatched types
  --> src/main.rs:23:21
   |
23 |     match guess.cmp(&secret_number) {
   |                 --- ^^^^^^^^^^^^^^ expected `&String`, found `&{integer}`
   |                 |
   |                 arguments to this method are incorrect
   |
   = note: expected reference `&String`
              found reference `&{integer}`
note: method defined here
  --> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/cmp.rs:1000:7

For more information about this error, try `rustc --explain E0308`.
error: could not compile `guessing_game` (bin "guessing_game") due to 1 previous error
Суть ошибки в том, что есть несовпадающие типы. Rust имеет сильную,
статическую систему типов. Однако у него также есть вывод типов. Когда мы
написали let mut guess = String::new(), Rust смог вывести, что guess
должен быть String, и не заставил нас писать тип. secret_number, с
другой стороны, имеет числовой тип. Несколько числовых типов Rust могут
иметь значение от 1 до 100: i32, 32-битное число; u32, беззнаковое
32-битное число; i64, 64-битное число; а также другие. Если не указано
иное, Rust по умолчанию использует i32, который является типом
secret_number, если вы не добавите информацию о типе где-либо ещё, что
заставило бы Rust вывести другой числовой тип. Причина ошибки в том, что
Rust не может сравнивать строку и числовой тип.
В конечном счёте, мы хотим преобразовать String, которую программа читает
как ввод, в числовой тип, чтобы можно было сравнить её численно с секретным
числом. Мы делаем это, добавляя эту строку в тело функции main:
Имя файла: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    // --snip--

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    let guess: u32 = guess.trim().parse().expect("Please type a number!");

    println!("You guessed: {guess}");

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("Too small!"),
        Ordering::Greater => println!("Too big!"),
        Ordering::Equal => println!("You win!"),
    }
}
Строка такая:
let guess: u32 = guess.trim().parse().expect("Please type a number!");Мы создаём переменную с именем guess. Но подождите, разве у программы уже
нет переменной с именем guess? Да, но, что полезно, Rust позволяет нам
затенять предыдущее значение guess новым. Затенение позволяет нам
повторно использовать имя переменной guess, а не заставлять нас создавать
две уникальные переменные, такие как guess_str и guess, например. Мы
рассмотрим это более подробно в главе 3,
но пока знайте, что эта возможность часто используется, когда вы хотите
преобразовать значение из одного типа в другой.
Мы привязываем эту новую переменную к выражению guess.trim().parse().
guess в выражении относится к исходной переменной guess, которая
содержала ввод в виде строки. Метод trim у экземпляра String удалит
любые пробельные символы в начале и конце, что мы должны сделать, прежде
чем преобразовать строку в u32, который может содержать только числовые
данные. Пользователь должен нажать enter, чтобы удовлетворить
read_line и ввести свою догадку, что добавляет символ новой строки в
строку. Например, если пользователь вводит 5 и нажимает
enter, guess выглядит так: 5\n. Символ \n представляет
«новую строку». (В Windows нажатие enter приводит к возврату
каретки и новой строке, \r\n.) Метод trim удаляет \n или \r\n,
оставляя только 5.
Метод parse у строк
преобразует строку в другой тип. Здесь мы используем его для преобразования
из строки в число. Нам нужно сообщить Rust точный числовой тип, который мы
хотим, используя let guess: u32. Двоеточие (:) после guess сообщает
Rust, что мы будем аннотировать тип переменной. Rust имеет несколько
встроенных числовых типов; u32, видимый здесь, — это беззнаковое
32-битное целое число. Это хороший выбор по умолчанию для небольшого
положительного числа. Вы узнаете о других числовых типах в
главе 3.
Кроме того, аннотация u32 в этом примере программы и сравнение с
secret_number означает, что Rust выведет, что secret_number также
должен быть u32. Итак, теперь сравнение будет между двумя значениями
одного типа!
Метод parse будет работать только с символами, которые можно логически
преобразовать в числа, и поэтому может легко вызывать ошибки. Если,
например, строка содержала A👍%, не было бы способа преобразовать её в
число. Поскольку это может не удаться, метод parse возвращает тип
Result, так же как и метод read_line (обсуждавшийся ранее в разделе
«Обработка потенциальной ошибки с помощью Result»).
Мы будем обрабатывать этот Result так же, снова используя метод expect.
Если parse возвращает вариант Err Result, потому что он не смог
создать число из строки, вызов expect завершит игру и выведет сообщение,
которое мы ему дали. Если parse успешно преобразует строку в число, он
вернёт вариант Ok Result, и expect вернёт число, которое мы хотим, из
значения Ok.
Давайте запустим программу сейчас:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.26s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 58
Please input your guess.
  76
You guessed: 76
Too big!
Отлично! Даже несмотря на то, что перед догадкой были добавлены пробелы, программа всё равно поняла, что пользователь угадал 76. Запустите программу несколько раз, чтобы проверить различное поведение с разными видами ввода: угадайте число правильно, угадайте число, которое слишком велико, и угадайте число, которое слишком мало.
Теперь у нас работает большая часть игры, но пользователь может сделать только одну догадку. Давайте изменим это, добавив цикл!
Разрешение нескольких догадок с помощью цикла
Ключевое слово loop создаёт бесконечный цикл. Мы добавим цикл, чтобы дать
пользователям больше шансов угадать число:
Имя файла: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    // --snip--

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        // --snip--


        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = guess.trim().parse().expect("Please type a number!");

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => println!("You win!"),
        }
    }
}
Как видите, мы переместили всё, начиная с приглашения ввода догадки, в цикл. Обязательно сделайте отступ в строках внутри цикла ещё на четыре пробела и снова запустите программу. Теперь программа будет запрашивать ещё одну догадку вечно, что на самом деле создаёт новую проблему. Похоже, что пользователь не может выйти!
Пользователь всегда может прервать программу, используя сочетание клавиш
ctrl-C. Но есть другой способ сбежать от этого
ненасытного монстра, как упоминалось в обсуждении parse в разделе
«Сравнение догадки с секретным числом»:
если пользователь введёт нечисловой ответ, программа завершится. Мы можем
воспользоваться этим, чтобы позволить пользователю выйти, как показано
здесь:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.23s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 59
Please input your guess.
45
You guessed: 45
Too small!
Please input your guess.
60
You guessed: 60
Too big!
Please input your guess.
59
You guessed: 59
You win!
Please input your guess.
quit

thread 'main' (6694925) panicked at src/main.rs:28:47:
Please type a number!: ParseIntError { kind: InvalidDigit }
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Ввод quit завершит игру, но, как вы заметите, ввод любого другого
нечислового ввода тоже. Это, мягко говоря, неоптимально; мы хотим, чтобы
игра также останавливалась, когда угадано правильное число.
Выход после правильной догадки
Давайте запрограммируем игру так, чтобы она завершалась, когда пользователь
выигрывает, добавив инструкцию break:
Имя файла: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = guess.trim().parse().expect("Please type a number!");

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}
Добавление строки break после println!("You win!"); заставляет
программу выйти из цикла, когда пользователь правильно угадывает секретное
число. Выход из цикла также означает выход из программы, потому что цикл
является последней частью main.
Обработка неверного ввода
Чтобы ещё больше улучшить игру, вместо того чтобы завершать программу при
вводе пользователем нечислового значения, давайте заставим игру игнорировать
нечисловое значение, чтобы пользователь мог продолжать угадывать. Мы можем
сделать это, изменив строку, где guess преобразуется из String в u32,
как показано в листинге 2-5.
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}Мы переходим от вызова expect к выражению match, чтобы перейти от аварийного завершения при ошибке к её обработке. Помните, что parse возвращает тип Result, а Result — это перечисление с вариантами Ok и Err. Здесь мы используем выражение match, как и с результатом Ordering метода cmp.
Если parse удаётся успешно превратить строку в число, он вернёт значение Ok, содержащее полученное число. Это значение Ok совпадёт с шаблоном первой ветви, и выражение match просто вернёт значение num, которое parse произвёл и поместил внутрь Ok. Это число окажется именно там, где нам нужно, — в новой переменной guess, которую мы создаём.
Если же parse не удаётся превратить строку в число, он вернёт значение Err, содержащее более подробную информацию об ошибке. Значение Err не совпадает с шаблоном Ok(num) в первой ветви match, но совпадает с шаблоном Err(_) во второй ветви. Подчёркивание _ — это универсальный шаблон; в этом примере мы говорим, что хотим сопоставить все значения Err, независимо от того, какая информация находится внутри них. Поэтому программа выполнит код второй ветви, continue, который говорит программе перейти к следующей итерации цикла и запросить ещё одну догадку. Таким образом, программа фактически игнорирует все ошибки, с которыми может столкнуться parse!
Теперь всё в программе должно работать как задумано. Давайте попробуем:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.13s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 61
Please input your guess.
10
You guessed: 10
Too small!
Please input your guess.
99
You guessed: 99
Too big!
Please input your guess.
foo
Please input your guess.
61
You guessed: 61
You win!
Отлично! С одной небольшой доработкой игра по угадыванию завершена. Вспомните, что программа всё ещё выводит секретное число. Это было полезно для тестирования, но портит игру. Удалите строку, которая выводит секретное число. В листинге 2-6 показан окончательный код.
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}Итоги
На этом этапе вы успешно построили игру по угадыванию. Поздравляем!
Этот проект был практическим способом познакомить вас со многими новыми
концепциями Rust: let, match, функции, использование внешних крейтов,
и многое другое. В следующих нескольких главах вы узнаете об этих концепциях
более подробно. Глава 3 охватывает концепции, которые есть в большинстве
языков программирования, такие как переменные, типы данных и функции, и
показывает, как их использовать в Rust. Глава 4 исследует владение — функцию,
которая отличает Rust от других языков. Глава 5 обсуждает структуры и
методы, а глава 6 объясняет, как работают перечисления.
Общие концепции программирования
Общие концепции программирования
В этой главе рассматриваются концепции, которые встречаются почти в каждом языке программирования, и то, как они работают в Rust. Многие языки программирования имеют много общего в своей основе. Ни одна из концепций, представленных в этой главе, не уникальна для Rust, но мы обсудим их в контексте Rust и объясним соглашения по их использованию.
В частности, вы узнаете о переменных, базовых типах, функциях, комментариях и потоке управления. Эти основы будут в каждой программе на Rust, и изучение их на раннем этапе даст прочную базу для начала.
Ключевые слова
В языке Rust есть набор ключевых слов, зарезервированных для использования только языком, как и в других языках. Имейте в виду, что эти слова нельзя использовать в качестве имён переменных или функций. Большинство ключевых слов имеют особое значение, и вы будете использовать их для выполнения различных задач в своих программах на Rust; несколько из них не имеют связанной с ними текущей функциональности, но были зарезервированы для функциональности, которая может быть добавлена в Rust в будущем. Вы можете найти список ключевых слов в Приложении A.
Переменные и изменяемость
Переменные и изменяемость
Как упоминалось в разделе «Хранение значений с помощью переменных», по умолчанию переменные неизменяемы. Это один из многих приёмов, которыми Rust подталкивает писать код так, чтобы использовать преимущества безопасности и простой конкурентности, которые предлагает Rust. Однако по-прежнему есть возможность сделать переменные изменяемыми. Далее рассматривается, как и почему Rust поощряет предпочтение неизменяемости и почему иногда может возникнуть желание от неё отказаться.
Когда переменная неизменяема, после привязки значения к имени это значение нельзя изменить.
Чтобы проиллюстрировать это, создайте новый проект с именем variables в
каталоге projects, выполнив команду cargo new variables.
Затем в новом каталоге variables откройте src/main.rs и замените его код следующим кодом, который пока не будет компилироваться:
Имя файла: src/main.rs
fn main() {
    let x = 5;
    println!("The value of x is: {x}");
    x = 6;
    println!("The value of x is: {x}");
}
Сохраните и запустите программу с помощью cargo run. Должно появиться сообщение об ошибке,
связанное с неизменяемостью, как показано в этом выводе:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
error[E0384]: cannot assign twice to immutable variable `x`
 --> src/main.rs:4:5
  |
2 |     let x = 5;
  |         - first assignment to `x`
3 |     println!("The value of x is: {x}");
4 |     x = 6;
  |     ^^^^^ cannot assign twice to immutable variable
  |
help: consider making this binding mutable
  |
2 |     let mut x = 5;
  |         +++

For more information about this error, try `rustc --explain E0384`.
error: could not compile `variables` (bin "variables") due to 1 previous error
Этот пример показывает, как компилятор помогает находить ошибки в программах. Ошибки компилятора могут расстраивать, но на самом деле они означают лишь то, что программа ещё не делает безопасно то, что должно делать; они не означают, что вы плохой программист! Опытные Rustaceans по-прежнему получают ошибки компилятора.
Получено сообщение об ошибке cannot assign twice to immutable variable `x`, потому что была предпринята попытка присвоить второе значение неизменяемой переменной x.
Важно получать ошибки времени компиляции при попытке изменить значение, обозначенное как неизменяемое, потому что именно эта ситуация может привести к ошибкам. Если одна часть кода исходит из предположения, что значение никогда не изменится, а другая часть кода изменяет это значение, возможно, что первая часть кода не сделает того, для чего она была предназначена. Причину такой ошибки может быть трудно отследить постфактум, особенно когда второй фрагмент кода изменяет значение лишь иногда. Компилятор Rust гарантирует, что если указано, что значение не изменится, оно действительно не изменится, поэтому не нужно отслеживать это самостоятельно. Таким образом, код проще анализировать.
Но изменяемость может быть очень полезной и делать код удобнее для написания.
Хотя переменные по умолчанию неизменяемы, их можно сделать изменяемыми,
добавив mut перед именем переменной, как это было сделано в главе
2. Добавление mut также передаёт
намерение будущим читателям кода, указывая, что другие части кода
будут изменять значение этой переменной.
Например, изменим src/main.rs на следующий код:
Имя файла: src/main.rs
fn main() {
    let mut x = 5;
    println!("The value of x is: {x}");
    x = 6;
    println!("The value of x is: {x}");
}
При запуске программы теперь получаем:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/variables`
The value of x is: 5
The value of x is: 6
При использовании mut разрешено изменять значение, привязанное к x, с 5 на 6.
В конечном счёте решение об использовании изменяемости или нет зависит от вас и
от того, что, по вашему мнению, яснее в конкретной ситуации.
Объявление констант
Как и неизменяемые переменные, константы — это значения, привязанные к имени, которые не разрешено изменять, но между константами и переменными есть несколько различий.
Во-первых, с константами нельзя использовать mut. Константы не просто
неизменяемы по умолчанию — они всегда неизменяемы. Константы объявляются с помощью
ключевого слова const вместо ключевого слова let, и тип значения обязательно
должен быть аннотирован. Типы и аннотации типов рассматриваются в следующем разделе,
«Типы данных», поэтому не стоит беспокоиться о деталях
сейчас. Достаточно знать, что тип нужно указывать всегда.
Константы можно объявлять в любой области видимости, включая глобальную, что делает их полезными для значений, которые должны быть известны многим частям кода.
Последнее различие состоит в том, что константам можно присваивать только константное выражение, а не результат значения, которое могло бы быть вычислено только во время выполнения.
Вот пример объявления константы:
#![allow(unused)]
fn main() {
const THREE_HOURS_IN_SECONDS: u32 = 60 * 60 * 3;
}
Имя константы — THREE_HOURS_IN_SECONDS, а её значение установлено равным
результату умножения 60 (количество секунд в минуте) на 60 (количество
минут в часе) на 3 (количество часов, которые нужно посчитать в этой
программе). Соглашение об именовании констант в Rust — использовать только заглавные буквы с
подчёркиваниями между словами. Компилятор способен вычислить ограниченный набор
операций во время компиляции, что позволяет записать это значение так,
чтобы его было проще понять и проверить, вместо того чтобы задавать эту константу
равной значению 10 800. См. раздел справочника Rust о константных
вычислениях для получения дополнительной информации о том, какие операции можно использовать
при объявлении констант.
Константы действительны всё время выполнения программы в пределах области видимости, в которой они были объявлены. Это свойство делает константы полезными для значений в предметной области приложения, о которых могут нуждаться знать разные части программы, например, максимальное количество очков, которое разрешено набрать любому игроку в игре, или скорость света.
Именование жёстко закодированных значений, используемых во всей программе, константами полезно для передачи смысла этого значения будущим сопровождающим кода. Это также помогает иметь только одно место в коде, которое нужно было бы изменить, если бы жёстко закодированное значение потребовалось обновить в будущем.
Затенение
Как было показано в руководстве по игре в угадайку в главе
2, можно объявить
новую переменную с тем же именем, что и предыдущая переменная. Rustaceans говорят, что
первая переменная затенена второй, что означает, что компилятор будет видеть вторую
переменную при использовании имени переменной.
Фактически вторая переменная заслоняет первую, забирая себе все использования
имени переменной до тех пор, пока она сама не будет затенена или пока не закончится область видимости.
Затенить переменную можно, используя то же имя переменной и повторив
использование ключевого слова let следующим образом:
Имя файла: src/main.rs
fn main() {
    let x = 5;

    let x = x + 1;

    {
        let x = x * 2;
        println!("The value of x in the inner scope is: {x}");
    }

    println!("The value of x is: {x}");
}
Эта программа сначала привязывает x к значению 5. Затем она создаёт новую переменную
x, повторяя let x =, беря исходное значение и добавляя 1, так что
значение x становится 6. Затем во внутренней области видимости, созданной с помощью фигурных
скобок, третья инструкция let также затеняет x и создаёт новую
переменную, умножая предыдущее значение на 2, так что x получает значение 12.
Когда эта область видимости заканчивается, внутреннее затенение заканчивается, и x снова становится 6.
При запуске этой программы будет выведено следующее:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/variables`
The value of x in the inner scope is: 12
The value of x is: 6
Затенение отличается от пометки переменной как mut, потому что при случайной попытке
переприсвоить этой переменной значение без использования ключевого слова let будет
получена ошибка времени компиляции. Используя let, можно выполнить несколько преобразований
над значением, но после завершения этих преобразований переменная будет неизменяемой.
Другое различие между mut и затенением состоит в том, что, поскольку
при повторном использовании ключевого слова let фактически создаётся новая переменная, можно
изменить тип значения, сохранив то же имя. Например, пусть программа
просит пользователя показать, сколько пробелов он хочет между некоторым текстом,
введя пробельные символы, а затем требуется сохранить этот ввод как число:
fn main() {
    let spaces = "   ";
    let spaces = spaces.len();
}
Первая переменная spaces имеет строковый тип, а вторая переменная spaces
имеет числовой тип. Таким образом, затенение избавляет от необходимости придумывать
другие имена, такие как spaces_str и spaces_num; вместо этого можно повторно использовать
более простое имя spaces. Однако при попытке использовать mut для этого, как показано
здесь, будет получена ошибка времени компиляции:
fn main() {
    let mut spaces = "   ";
    spaces = spaces.len();
}
В ошибке говорится, что изменять тип переменной не разрешено:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
error[E0308]: mismatched types
 --> src/main.rs:3:14
  |
2 |     let mut spaces = "   ";
  |                      ----- expected due to this value
3 |     spaces = spaces.len();
  |              ^^^^^^^^^^^^ expected `&str`, found `usize`

For more information about this error, try `rustc --explain E0308`.
error: could not compile `variables` (bin "variables") due to 1 previous error
Теперь, когда рассмотрено, как работают переменные, можно перейти к другим типам данных, которые они могут иметь.
Типы данных
Типы данных
Каждое значение в Rust имеет определённый тип данных, который сообщает Rust, какого рода данные указаны, чтобы он знал, как с этими данными работать. Мы рассмотрим два подмножества типов данных: скалярные и составные.
Следует помнить, что Rust — это язык со статической типизацией, что означает, что он должен знать типы всех переменных во время компиляции. Компилятор обычно может вывести, какой тип мы хотим использовать, на основе значения и того, как мы его используем. В случаях, когда возможно множество типов, например, когда мы преобразовали String в числовой тип с помощью parse в разделе «Сравнение догадки с секретным числом» во второй главе, мы должны добавить аннотацию типа, вот так:
#![allow(unused)]
fn main() {
let guess: u32 = "42".parse().expect("Not a number!");
}
Если мы не добавим аннотацию типа : u32, показанную в предыдущем коде, Rust отобразит следующую ошибку, которая означает, что компилятору нужно больше информации от нас, чтобы знать, какой тип мы хотим использовать:
$ cargo build
   Compiling no_type_annotations v0.1.0 (file:///projects/no_type_annotations)
error[E0284]: type annotations needed
 --> src/main.rs:2:9
  |
2 |     let guess = "42".parse().expect("Not a number!");
  |         ^^^^^        ----- type must be known at this point
  |
  = note: cannot satisfy `<_ as FromStr>::Err == _`
help: consider giving `guess` an explicit type
  |
2 |     let guess: /* Type */ = "42".parse().expect("Not a number!");
  |              ++++++++++++

For more information about this error, try `rustc --explain E0284`.
error: could not compile `no_type_annotations` (bin "no_type_annotations") due to 1 previous error
Для других типов данных вы увидите другие аннотации типов.
Скалярные типы
Скалярный тип представляет одно значение. В Rust есть четыре основных скалярных типа: целые числа, числа с плавающей точкой, логические значения и символы. Возможно, вы узнаете их из других языков программирования. Давайте рассмотрим, как они работают в Rust.
Целочисленные типы
Целое число — это число без дробной части. Во второй главе мы использовали один целочисленный тип — u32. Это объявление типа указывает, что значение, с которым он связан, должно быть беззнаковым целым числом (знаковые целочисленные типы начинаются с i, а не с u), занимающим 32 бита пространства. В таблице 3-1 показаны встроенные целочисленные типы в Rust. Мы можем использовать любой из этих вариантов для объявления типа целочисленного значения.
Таблица 3-1: Целочисленные типы в Rust
| Длина | Знаковый | Беззнаковый |
|---|---|---|
| 8-бит | i8 | u8 |
| 16-бит | i16 | u16 |
| 32-бит | i32 | u32 |
| 64-бит | i64 | u64 |
| 128-бит | i128 | u128 |
| Зависит от архитектуры | isize | usize |
Каждый вариант может быть знаковым или беззнаковым и имеет явный размер. Знаковый и беззнаковый относятся к тому, возможно ли для числа быть отрицательным — другими словами, нужно ли числу иметь знак (знаковый) или оно всегда будет только положительным и поэтому может быть представлено без знака (беззнаковый). Это как записывать числа на бумаге: когда знак имеет значение, число показывается со знаком плюс или минус; однако когда можно с уверенностью предположить, что число положительное, оно показывается без знака. Знаковые числа хранятся с использованием представления дополнительного кода.
Каждый знаковый вариант может хранить числа от −(2n − 1) до 2n −
1 − 1 включительно, где n — количество битов, которое использует этот вариант. Так, i8 может хранить числа от −(27) до 27 − 1, что равно
−128 до 127. Беззнаковые варианты могут хранить числа от 0 до 2n − 1,
так что u8 может хранить числа от 0 до 28 − 1, что равно 0 до 255.
Кроме того, типы isize и usize зависят от архитектуры компьютера, на котором выполняется программа: 64 бита, если вы на 64-битной архитектуре, и 32 бита, если вы на 32-битной архитектуре.
Целочисленные литералы можно записывать в любой из форм, показанных в таблице 3-2. Обратите внимание, что числовые литералы, которые могут быть нескольких числовых типов, допускают суффикс типа, например 57u8, для обозначения типа. Числовые литералы также могут использовать _ в качестве визуального разделителя, чтобы число было легче читать, например 1_000, что будет иметь то же значение, как если бы вы указали 1000.
Таблица 3-2: Целочисленные литералы в Rust
| Числовые литералы | Пример |
|---|---|
| Десятичный | 98_222 |
| Шестнадцатеричный | 0xff |
| Восьмеричный | 0o77 |
| Двоичный | 0b1111_0000 |
Байт (только u8) | b'A' |
Так как же узнать, какой тип целого числа использовать? Если вы не уверены, значения по умолчанию в Rust, как правило, являются хорошей отправной точкой: целочисленные типы по умолчанию — i32. Основная ситуация, в которой вы бы использовали isize или usize, — это индексация некоторой коллекции.
Целочисленное переполнение
Допустим, у вас есть переменная типа u8, которая может хранить значения от 0 до
255. Если вы попытаетесь изменить переменную на значение вне этого диапазона, например
256, произойдёт целочисленное переполнение, которое может привести к одному из двух вариантов поведения.
При компиляции в режиме отладки Rust включает проверки целочисленного переполнения,
которые вызывают панику программы во время выполнения, если такое поведение происходит. Rust
использует термин паника, когда программа завершается с ошибкой; мы обсудим
паники более подробно в разделе «Невосстановимые ошибки с panic!» в девятой главе.
При компиляции в режиме релиза с флагом --release Rust не
включает проверки целочисленного переполнения, которые вызывают паники. Вместо этого, если
происходит переполнение, Rust выполняет переполнение дополнительного кода. Короче говоря, значения,
большие максимального значения, которое может хранить тип, «заворачиваются» к минимуму
значений, которые может хранить тип. В случае u8 значение 256 становится
0, значение 257 становится 1 и так далее. Программа не запаникует, но
переменная будет иметь значение, которое, вероятно, не то, что вы ожидали
получить. Полагаться на поведение заворачивания при целочисленном переполнении считается ошибкой.
Чтобы явно обработать возможность переполнения, вы можете использовать эти семейства методов, предоставляемых стандартной библиотекой для примитивных числовых типов:
- Заворачивать во всех режимах компиляции с помощью методов
wrapping_*, таких какwrapping_add. - Возвращать значение
None, если есть переполнение, с помощью методовchecked_*. - Возвращать значение и логическое значение, указывающее, было ли переполнение, с помощью
методов
overflowing_*. - Насыщаться на минимальном или максимальном значении значения с помощью методов
saturating_*.
Типы с плавающей точкой
В Rust также есть два примитивных типа для чисел с плавающей точкой, которые являются
числами с десятичной точкой. Типы с плавающей точкой в Rust — это f32 и f64,
размер которых составляет 32 бита и 64 бита соответственно. По умолчанию используется тип f64,
потому что на современных процессорах он примерно такой же по скорости, как f32, но способен
обеспечить большую точность. Все типы с плавающей точкой являются знаковыми.
Вот пример, демонстрирующий числа с плавающей точкой в действии:
Имя файла: src/main.rs
fn main() {
    let x = 2.0; // f64

    let y: f32 = 3.0; // f32
}
Числа с плавающей точкой представлены в соответствии со стандартом IEEE-754.
Числовые операции
Rust поддерживает базовые математические операции, которые вы ожидаете для всех числовых
типов: сложение, вычитание, умножение, деление и остаток. Целочисленное
деление усекает в сторону нуля до ближайшего целого числа. Следующий код показывает,
как использовать каждую числовую операцию в операторе let:
Имя файла: src/main.rs
fn main() {
    // сложение
    let sum = 5 + 10;

    // вычитание
    let difference = 95.5 - 4.3;

    // умножение
    let product = 4 * 30;

    // деление
    let quotient = 56.7 / 32.2;
    let truncated = -5 / 3; // Результат: -1

    // остаток от деления
    let remainder = 43 % 5;
}
Каждое выражение в этих операторах использует математический оператор и вычисляется в одно значение, которое затем привязывается к переменной. Приложение B содержит список всех операторов, которые предоставляет Rust.
Логический тип
Как и в большинстве других языков программирования, логический тип в Rust имеет два возможных
значения: true и false. Логические значения занимают один байт. Логический тип в
Rust указывается с помощью bool. Например:
Имя файла: src/main.rs
fn main() {
    let t = true;

    let f: bool = false; // с явной аннотацией типа
}
Основной способ использования логических значений — через условные конструкции, такие как
выражение if. Мы рассмотрим, как работают выражения if в Rust, в разделе «Поток
управления».
Символьный тип
Тип char в Rust — это самый примитивный буквенный тип языка. Вот
несколько примеров объявления значений char:
Имя файла: src/main.rs
fn main() {
    let c = 'z';
    let z: char = 'ℤ'; // с явной аннотацией типа
    let heart_eyed_cat = '😻';
}
Обратите внимание, что мы указываем литералы char с одинарными кавычками, в отличие от
строковых литералов, которые используют двойные кавычки. Тип char в Rust занимает 4
байта и представляет скалярное значение Unicode, что означает, что он может
представлять гораздо больше, чем просто ASCII. Буквы с диакритическими знаками; китайские, японские и
корейские символы; эмодзи; и символы нулевой ширины — все это допустимые значения char в
Rust. Скалярные значения Unicode находятся в диапазоне от U+0000 до U+D7FF и от U+E000 до
U+10FFFF включительно. Однако «символ» на самом деле не является концепцией в Unicode,
поэтому ваша человеческая интуиция о том, что такое «символ», может не совпадать с тем, что
char в Rust. Мы подробно обсудим эту тему в разделе «Хранение текста в кодировке UTF-8 с помощью строк» в восьмой главе.
Составные типы
Составные типы могут группировать несколько значений в один тип. В Rust есть два примитивных составных типа: кортежи и массивы.
Тип кортеж
Кортеж — это общий способ группировки нескольких значений различных типов в один составной тип. Кортежи имеют фиксированную длину: после объявления они не могут увеличиваться или уменьшаться в размере.
Мы создаём кортеж, записывая разделённый запятыми список значений в круглых скобках. Каждая позиция в кортеже имеет тип, и типы различных значений в кортеже не обязательно должны быть одинаковыми. Мы добавили необязательные аннотации типов в этом примере:
Имя файла: src/main.rs
fn main() {
    let tup: (i32, f64, u8) = (500, 6.4, 1);
}
Переменная tup связывается со всем кортежем, потому что кортеж считается
единым составным элементом. Чтобы извлечь отдельные значения из кортежа, мы можем
использовать сопоставление с шаблоном для деструктуризации значения кортежа, вот так:
Имя файла: src/main.rs
fn main() {
    let tup = (500, 6.4, 1);

    let (x, y, z) = tup;

    println!("The value of y is: {y}");
}
Эта программа сначала создаёт кортеж и привязывает его к переменной tup. Затем она
использует шаблон с let, чтобы взять tup и превратить его в три отдельные
переменные x, y и z. Это называется деструктуризацией, потому что она разбивает
один кортеж на три части. Наконец, программа печатает значение
y, которое равно 6.4.
Мы также можем получить доступ к элементу кортежа напрямую, используя точку (.), за которой следует
индекс значения, к которому мы хотим получить доступ. Например:
Имя файла: src/main.rs
fn main() {
    let x: (i32, f64, u8) = (500, 6.4, 1);

    let five_hundred = x.0;

    let six_point_four = x.1;

    let one = x.2;
}
Эта программа создаёт кортеж x, а затем обращается к каждому элементу кортежа
с помощью соответствующих индексов. Как и в большинстве языков программирования, первый
индекс в кортеже равен 0.
Кортеж без каких-либо значений имеет особое название — единица. Это значение и его
соответствующий тип записываются как () и представляют пустое значение или
пустой возвращаемый тип. Выражения неявно возвращают значение единицы, если они не
возвращают никакого другого значения.
Тип массив
Другой способ иметь коллекцию из нескольких значений — использовать массив. В отличие от кортежа, каждый элемент массива должен иметь одинаковый тип. В отличие от массивов в некоторых других языках, массивы в Rust имеют фиксированную длину.
Мы записываем значения в массиве как разделённый запятыми список в квадратных скобках:
Имя файла: src/main.rs
fn main() {
    let a = [1, 2, 3, 4, 5];
}
Массивы полезны, когда вы хотите, чтобы ваши данные были размещены в стеке, так же как и другие типы, которые мы видели до сих пор, а не в куче (мы обсудим стек и кучу подробнее в четвёртой главе), или когда вы хотите гарантировать, что у вас всегда фиксированное количество элементов. Массив не так гибок, как тип вектор, однако. Вектор — это похожий тип коллекции, предоставляемый стандартной библиотекой, которому разрешено расти или уменьшаться в размере, потому что его содержимое живёт в куче. Если вы не уверены, использовать ли массив или вектор, скорее всего, вам следует использовать вектор. Восьмая глава обсуждает векторы более подробно.
Однако массивы более полезны, когда вы знаете, что количество элементов не должно меняться. Например, если вы использовали названия месяцев в программе, вы, вероятно, использовали бы массив, а не вектор, потому что вы знаете, что он всегда будет содержать 12 элементов:
#![allow(unused)]
fn main() {
let months = ["January", "February", "March", "April", "May", "June", "July",
              "August", "September", "October", "November", "December"];
}
Вы записываете тип массива, используя квадратные скобки с типом каждого элемента, точкой с запятой и затем количеством элементов в массиве, вот так:
#![allow(unused)]
fn main() {
let a: [i32; 5] = [1, 2, 3, 4, 5];
}
Здесь i32 — это тип каждого элемента. После точки с запятой число 5
указывает, что массив содержит пять элементов.
Вы также можете инициализировать массив, содержащий одинаковое значение для каждого элемента, указав начальное значение, затем точку с запятой и затем длину массива в квадратных скобках, как показано здесь:
#![allow(unused)]
fn main() {
let a = [3; 5];
}
Массив с именем a будет содержать 5 элементов, все из которых изначально установлены в значение
3. Это то же самое, что написать let a = [3, 3, 3, 3, 3];, но более
кратко.
Доступ к элементам массива
Массив — это единый блок памяти известного фиксированного размера, который может быть размещён в стеке. Вы можете получить доступ к элементам массива с помощью индексации, вот так:
Имя файла: src/main.rs
fn main() {
    let a = [1, 2, 3, 4, 5];

    let first = a[0];
    let second = a[1];
}
В этом примере переменная с именем first получит значение 1, потому что это
значение с индексом [0] в массиве. Переменная с именем second получит
значение 2 из индекса [1] в массиве.
Недопустимый доступ к элементу массива
Давайте посмотрим, что произойдёт, если вы попытаетесь получить доступ к элементу массива, который находится за пределами массива. Допустим, вы запускаете этот код, аналогичный игре в угадывание из второй главы, чтобы получить индекс массива от пользователя:
Имя файла: src/main.rs
use std::io;

fn main() {
    let a = [1, 2, 3, 4, 5];

    println!("Please enter an array index.");

    let mut index = String::new();

    io::stdin()
        .read_line(&mut index)
        .expect("Failed to read line");

    let index: usize = index
        .trim()
        .parse()
        .expect("Index entered was not a number");

    let element = a[index];

    println!("The value of the element at index {index} is: {element}");
}
Этот код успешно компилируется. Если вы запустите этот код с помощью cargo run и
введёте 0, 1, 2, 3 или 4, программа выведет соответствующее
значение по этому индексу в массиве. Если вы вместо этого введёте число за пределами
массива, например 10, вы увидите примерно такой вывод:
thread 'main' panicked at src/main.rs:19:19:
index out of bounds: the len is 5 but the index is 10
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Программа привела к ошибке времени выполнения в точке использования недопустимого
значения в операции индексации. Программа завершилась с сообщением об ошибке и
не выполнила финальный оператор println!. Когда вы пытаетесь получить доступ к
элементу с помощью индексации, Rust проверит, что указанный вами индекс меньше
длины массива. Если индекс больше или равен длине,
Rust запаникует. Эта проверка должна происходить во время выполнения, особенно в этом случае,
потому что компилятор не может знать, какое значение введёт пользователь, когда он
запустит код позже.
Это пример принципов безопасности памяти Rust в действии. Во многих низкоуровневых языках такая проверка не выполняется, и когда вы предоставляете неправильный индекс, может быть осуществлён доступ к недопустимой памяти. Rust защищает вас от такого рода ошибки, немедленно завершая работу вместо того, чтобы разрешить доступ к памяти и продолжить. Глава 9 обсуждает больше об обработке ошибок в Rust и о том, как вы можете писать читаемый, безопасный код, который не паникует и не допускает недопустимого доступа к памяти.
Функции
Функции
Функции повсеместно встречаются в коде на Rust. Уже была показана одна из наиболее
важных функций в языке: функция main, которая является точкой входа многих программ. Также
было показано ключевое слово fn, которое позволяет
объявлять новые функции.
В коде на Rust используется змеиный регистр как общепринятый стиль для имён функций и переменных, в котором все буквы строчные, а слова разделяются подчёркиваниями. Вот программа, содержащая пример определения функции:
Имя файла: src/main.rs
fn main() {
    println!("Hello, world!");

    another_function();
}

fn another_function() {
    println!("Another function.");
}
Функция в Rust определяется путём ввода fn, за которым следует имя функции и
набор круглых скобок. Фигурные скобки сообщают компилятору, где начинается и заканчивается тело функции.
Любую определённую функцию можно вызвать, введя её имя, за которым следует
набор круглых скобок. Поскольку another_function определена в программе, её можно
вызвать изнутри функции main. Заметим, что another_function определена
после функции main в исходном коде; её можно было определить и до.
Rust не важно, где определяются функции, важно лишь, что они
определены где-то в области видимости, доступной вызывающему коду.
Начнём новый бинарный проект с именем functions, чтобы изучить функции
подробнее. Поместите пример с another_function в src/main.rs и запустите его. Должен
появиться следующий вывод:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.28s
     Running `target/debug/functions`
Hello, world!
Another function.
Строки выполняются в том порядке, в котором они появляются в функции main.
Сначала выводится сообщение «Hello, world!», а затем вызывается another_function
и выводится её сообщение.
Параметры
Функции можно определять с параметрами, которые являются специальными переменными, входящими в сигнатуру функции. Когда у функции есть параметры, можно передать ей конкретные значения для этих параметров. Технически конкретные значения называются аргументами, но в неформальном общении люди обычно используют слова параметр и аргумент взаимозаменяемо для обозначения как переменных в определении функции, так и конкретных значений, передаваемых при вызове функции.
В этой версии another_function добавлен параметр:
Имя файла: src/main.rs
fn main() {
    another_function(5);
}

fn another_function(x: i32) {
    println!("The value of x is: {x}");
}
Попробуйте запустить эту программу; должен получиться следующий вывод:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 1.21s
     Running `target/debug/functions`
The value of x is: 5
Объявление another_function имеет один параметр с именем x. Тип
x указан как i32. Когда в another_function передаётся 5, макрос
println! помещает 5 туда, где в строке формата находилась пара фигурных скобок с x.
В сигнатурах функций обязательно объявлять тип каждого параметра. Это осознанное решение в дизайне Rust: требование аннотаций типов в определениях функций означает, что компилятору почти никогда не нужно, чтобы их использовали в другом месте кода для выяснения подразумеваемого типа. Компилятор также способен давать более полезные сообщения об ошибках, если знает, какие типы ожидает функция.
При определении нескольких параметров объявления параметров разделяются запятыми, вот так:
Имя файла: src/main.rs
fn main() {
    print_labeled_measurement(5, 'h');
}

fn print_labeled_measurement(value: i32, unit_label: char) {
    println!("The measurement is: {value}{unit_label}");
}
Этот пример создаёт функцию с именем print_labeled_measurement с двумя
параметрами. Первый параметр называется value и имеет тип i32. Второй
называется unit_label и имеет тип char. Затем функция выводит текст, содержащий
как value, так и unit_label.
Попробуем запустить этот код. Замените программу, находящуюся сейчас в файле src/main.rs
проекта functions, на предыдущий пример и запустите её с помощью cargo run:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/functions`
The measurement is: 5h
Поскольку функция была вызвана со значением 5 для value и 'h' в качестве
значения для unit_label, вывод программы содержит эти значения.
Операторы и выражения
Тела функций состоят из последовательности операторов, необязательно заканчивающейся выражением. До сих пор рассматриваемые функции не включали завершающее выражение, но выражение как часть оператора уже встречалось. Поскольку Rust — это язык, основанный на выражениях, важно понимать это различие. В других языках нет таких же различий, поэтому рассмотрим, что такое операторы и выражения и как их различия влияют на тела функций.
- Операторы — это инструкции, которые выполняют некоторое действие и не возвращают значение.
- Выражения вычисляются в результирующее значение.
Рассмотрим несколько примеров.
Операторы и выражения уже фактически использовались. Создание переменной и
присваивание ей значения с помощью ключевого слова let — это оператор. В листинге 3-1
let y = 6; — это оператор.
fn main() {
    let y = 6;
}main, содержащее один операторОпределения функций также являются операторами; весь предыдущий пример — это оператор сам по себе. (Как вскоре будет показано, вызов функции не является оператором.)
Операторы не возвращают значений. Поэтому нельзя присвоить оператор let
другой переменной, как пытается сделать следующий код; будет получена ошибка:
Имя файла: src/main.rs
fn main() {
    let x = (let y = 6);
}
При запуске этой программы ошибка будет выглядеть так:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
error: expected expression, found `let` statement
 --> src/main.rs:2:14
  |
2 |     let x = (let y = 6);
  |              ^^^
  |
  = note: only supported directly in conditions of `if` and `while` expressions

warning: unnecessary parentheses around assigned value
 --> src/main.rs:2:13
  |
2 |     let x = (let y = 6);
  |             ^         ^
  |
  = note: `#[warn(unused_parens)]` (part of `#[warn(unused)]`) on by default
help: remove these parentheses
  |
2 -     let x = (let y = 6);
2 +     let x = let y = 6 ;
  |

warning: `functions` (bin "functions") generated 1 warning
error: could not compile `functions` (bin "functions") due to 1 previous error; 1 warning emitted
Оператор let y = 6 не возвращает значение, поэтому нечего
привязать к x. Это отличается от того, что происходит в других языках, таких как
C и Ruby, где присваивание возвращает значение присваивания. В этих
языках можно написать x = y = 6, и обе переменные x и y будут иметь значение
6; в Rust это не так.
Выражения вычисляются в значение и составляют большую часть остального кода, который
будет написан на Rust. Рассмотрим математическую операцию, такую как 5 + 6, которая является
выражением, вычисляющимся в значение 11. Выражения могут быть частью
операторов: в листинге 3-1 6 в операторе let y = 6; — это
выражение, вычисляющееся в значение 6. Вызов функции — это
выражение. Вызов макроса — это выражение. Блок новой области видимости, созданный с помощью
фигурных скобок, — это выражение, например:
Имя файла: src/main.rs
fn main() {
    let y = {
        let x = 3;
        x + 1
    };

    println!("The value of y is: {y}");
}
Это выражение:
{
    let x = 3;
    x + 1
}
— это блок, который в данном случае вычисляется в 4. Это значение привязывается к y
в рамках оператора let. Обратите внимание на строку x + 1 без точки с запятой в
конце, что отличается от большинства строк, виденных до сих пор. Выражения
не включают завершающую точку с запятой. Если добавить точку с запятой в конец
выражения, оно превратится в оператор и перестанет возвращать значение.
Помните об этом при дальнейшем изучении возвращаемых значений функций и выражений.
Функции с возвращаемыми значениями
Функции могут возвращать значения коду, который их вызывает. Возвращаемые значения не
именуются, но их тип нужно объявить после стрелки (->). В Rust
возвращаемое значение функции равнозначно значению последнего
выражения в блоке тела функции. Можно выполнить ранний возврат из
функции с помощью ключевого слова return и указания значения, но большинство
функций неявно возвращают последнее выражение. Вот пример
функции, возвращающей значение:
Имя файла: src/main.rs
fn five() -> i32 {
    5
}

fn main() {
    let x = five();

    println!("The value of x is: {x}");
}
В функции five нет ни вызовов функций, ни макросов, ни даже операторов let
— только число 5 само по себе. Это совершенно допустимая функция в
Rust. Обратите внимание, что тип возвращаемого значения функции также указан, как -> i32. Попробуйте
запустить этот код; вывод должен выглядеть так:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/functions`
The value of x is: 5
5 в функции five является возвращаемым значением функции, поэтому тип возвращаемого значения
— i32. Рассмотрим это подробнее. Есть два важных момента:
Во-первых, строка let x = five(); показывает, что возвращаемое значение
функции используется для инициализации переменной. Поскольку функция five возвращает 5,
эта строка эквивалентна следующей:
#![allow(unused)]
fn main() {
let x = 5;
}
Во-вторых, функция five не имеет параметров и определяет тип
возвращаемого значения, но тело функции состоит из одинокого 5 без точки с запятой,
потому что это выражение, значение которого требуется вернуть.
Рассмотрим ещё один пример:
Имя файла: src/main.rs
fn main() {
    let x = plus_one(5);

    println!("The value of x is: {x}");
}

fn plus_one(x: i32) -> i32 {
    x + 1
}
Запуск этого кода выведет The value of x is: 6. Но что произойдёт, если
поставить точку с запятой в конце строки, содержащей x + 1, превратив её из
выражения в оператор?
Имя файла: src/main.rs
fn main() {
    let x = plus_one(5);

    println!("The value of x is: {x}");
}

fn plus_one(x: i32) -> i32 {
    x + 1;
}
Компиляция этого кода приведёт к ошибке, как показано ниже:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
error[E0308]: mismatched types
 --> src/main.rs:7:24
  |
7 | fn plus_one(x: i32) -> i32 {
  |    --------            ^^^ expected `i32`, found `()`
  |    |
  |    implicitly returns `()` as its body has no tail or `return` expression
8 |     x + 1;
  |          - help: remove this semicolon to return this value

For more information about this error, try `rustc --explain E0308`.
error: could not compile `functions` (bin "functions") due to 1 previous error
Основное сообщение об ошибке mismatched types раскрывает суть проблемы с этим
кодом. Определение функции plus_one говорит, что она вернёт
i32, но операторы не вычисляются в значение, что выражается как (),
единичный тип. Следовательно, ничего не возвращается, что противоречит определению
функции и приводит к ошибке. В этом выводе Rust предоставляет сообщение, которое
может помочь исправить эту проблему: предлагается удалить точку с запятой, что
исправило бы ошибку.
Комментарии
Комментарии
Все программисты стремятся сделать свой код лёгким для понимания, но иногда требуются дополнительные пояснения. В таких случаях программисты оставляют комментарии в исходном коде, которые компилятор игнорирует, но которые люди, читающие исходный код, могут найти полезными.
Вот простой комментарий:
#![allow(unused)]
fn main() {
// hello, world
}
В Rust идиоматический стиль комментариев начинается с двух косых черт, и
комментарий продолжается до конца строки. Для комментариев, выходящих за пределы
одной строки, нужно включать // на каждой строке, вот так:
#![allow(unused)]
fn main() {
// Здесь мы делаем что-то сложное, настолько длинное, что нам нужно
// несколько строк комментариев, чтобы это объяснить! Уф! Надеюсь, этот комментарий
// объяснит, что здесь происходит.
}
Комментарии также можно размещать в конце строк, содержащих код:
Имя файла: src/main.rs
fn main() {
    let lucky_number = 7; // Сегодня мне везёт
}
Но чаще вы увидите их в таком формате, с комментарием на отдельной строке над кодом, который он аннотирует:
Имя файла: src/main.rs
fn main() {
    // Сегодня мне везёт
    let lucky_number = 7;
}
В Rust также есть другой вид комментариев — документационные комментарии, которые мы обсудим в разделе «Публикация крейта на Crates.io» главы 14.
Поток управления
Поток управления
Возможность выполнять некоторый код в зависимости от того, истинно ли условие (true), и возможность повторять выполнение кода, пока условие истинно, — это базовые строительные блоки в большинстве языков программирования. Наиболее распространённые конструкции, позволяющие управлять потоком выполнения кода в Rust, — это выражения if и циклы.
Выражения if
Выражение if позволяет ветвить код в зависимости от условий. Вы задаёте условие и затем указываете: «Если это условие выполняется, выполнить этот блок кода. Если условие не выполняется, не выполнять этот блок кода».
Создайте новый проект под названием branches в вашем каталоге projects, чтобы исследовать выражение if. В файл src/main.rs введите следующее:
Имя файла: src/main.rs
fn main() {
    let number = 3;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
Все выражения if начинаются с ключевого слова if, за которым следует условие. В данном случае условие проверяет, имеет ли переменная number значение меньше 5. Блок кода, который нужно выполнить, если условие истинно, мы размещаем сразу после условия внутри фигурных скобок. Блоки кода, связанные с условиями в выражениях if, иногда называют ветвями, точно так же, как ветви в выражениях match, которые мы обсуждали в разделе «Сравнение догадки с секретным числом» главы 2.
При желании мы также можем включить выражение else, что мы и решили сделать здесь, чтобы дать программе альтернативный блок кода для выполнения в случае, если условие вычислится как false. Если вы не предоставите выражение else и условие окажется false, программа просто пропустит блок if и перейдёт к следующему фрагменту кода.
Попробуйте запустить этот код; вы должны увидеть следующий вывод:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
condition was true
Давайте попробуем изменить значение number на такое, при котором условие станет false, чтобы увидеть, что произойдёт:
fn main() {
    let number = 7;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
Запустите программу снова и посмотрите на вывод:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
condition was false
Также стоит отметить, что условие в этом коде должно иметь тип bool. Если условие не является bool, мы получим ошибку. Например, попробуйте запустить следующий код:
Имя файла: src/main.rs
fn main() {
    let number = 3;

    if number {
        println!("number was three");
    }
}
Условие if в этот раз вычисляется в значение 3, и Rust выдаёт ошибку:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
error[E0308]: mismatched types
 --> src/main.rs:4:8
  |
4 |     if number {
  |        ^^^^^^ expected `bool`, found integer

For more information about this error, try `rustc --explain E0308`.
error: could not compile `branches` (bin "branches") due to 1 previous error
Ошибка указывает на то, что Rust ожидал bool, но получил целое число. В отличие от таких языков, как Ruby и JavaScript, Rust не будет автоматически пытаться преобразовать небулевы типы в булевы. Вы должны быть явными и всегда предоставлять if условие типа Boolean. Если мы хотим, чтобы блок кода if выполнялся только тогда, когда число не равно 0, например, мы можем изменить выражение if на следующее:
Имя файла: src/main.rs
fn main() {
    let number = 3;

    if number != 0 {
        println!("number was something other than zero");
    }
}
Выполнение этого кода выведет number was something other than zero.
Обработка нескольких условий с помощью else if
Вы можете использовать несколько условий, комбинируя if и else в выражении else if. Например:
Имя файла: src/main.rs
fn main() {
    let number = 6;

    if number % 4 == 0 {
        println!("number is divisible by 4");
    } else if number % 3 == 0 {
        println!("number is divisible by 3");
    } else if number % 2 == 0 {
        println!("number is divisible by 2");
    } else {
        println!("number is not divisible by 4, 3, or 2");
    }
}
У этой программы есть четыре возможных пути выполнения. После её запуска вы должны увидеть следующий вывод:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
number is divisible by 3
Когда эта программа выполняется, она по очереди проверяет каждое выражение if и выполняет первое тело, для которого условие вычисляется как true. Обратите внимание, что хотя 6 делится на 2, мы не видим вывод number is divisible by 2, как не видим и текст number is not divisible by 4, 3, or 2 из блока else. Это потому, что Rust выполняет блок только для первого истинного условия, и как только он его находит, он даже не проверяет остальные.
Использование слишком большого количества выражений else if может загромоздить ваш код, поэтому если у вас их больше одного, возможно, стоит провести рефакторинг. В главе 6 описана мощная конструкция ветвления Rust под названием match для таких случаев.
Использование if в инструкции let
Поскольку if является выражением, мы можем использовать его в правой части инструкции let, чтобы присвоить результат переменной, как в листинге 3-2.
fn main() {
    let condition = true;
    let number = if condition { 5 } else { 6 };

    println!("The value of number is: {number}");
}if переменнойПеременная number будет привязана к значению на основе результата выражения if. Запустите этот код, чтобы увидеть, что произойдёт:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/branches`
The value of number is: 5
Помните, что блоки кода вычисляются в последнее выражение в них, а числа сами по себе также являются выражениями. В данном случае значение всего выражения if зависит от того, какой блок кода выполняется. Это означает, что значения, которые могут быть результатами каждой ветви if, должны быть одного типа; в листинге 3-2 результаты и ветви if, и ветви else были целыми числами i32. Если типы не совпадают, как в следующем примере, мы получим ошибку:
Имя файла: src/main.rs
fn main() {
    let condition = true;

    let number = if condition { 5 } else { "six" };

    println!("The value of number is: {number}");
}
Когда мы попытаемся скомпилировать этот код, мы получим ошибку. Ветви if и else имеют несовместимые типы значений, и Rust точно указывает, где искать проблему в программе:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
error[E0308]: `if` and `else` have incompatible types
 --> src/main.rs:4:44
  |
4 |     let number = if condition { 5 } else { "six" };
  |                                 -          ^^^^^ expected integer, found `&str`
  |                                 |
  |                                 expected because of this

For more information about this error, try `rustc --explain E0308`.
error: could not compile `branches` (bin "branches") due to 1 previous error
Выражение в блоке if вычисляется как целое число, а выражение в блоке else вычисляется как строка. Это не сработает, потому что переменные должны иметь один тип, а Rust должен точно знать во время компиляции, какой тип у переменной number. Знание типа number позволяет компилятору проверить, что тип действителен везде, где мы используем number. Rust не смог бы этого сделать, если бы тип number определялся только во время выполнения; компилятор был бы сложнее и давал бы меньше гарантий о коде, если бы ему приходилось отслеживать несколько гипотетических типов для любой переменной.
Повторение с помощью циклов
Часто бывает полезно выполнять блок кода более одного раза. Для этой задачи Rust предоставляет несколько циклов, которые будут выполнять код внутри тела цикла до конца, а затем немедленно начинать снова с начала. Чтобы поэкспериментировать с циклами, давайте создадим новый проект под названием loops.
В Rust есть три вида циклов: loop, while и for. Давайте попробуем каждый из них.
Повторение кода с помощью loop
Ключевое слово loop указывает Rust выполнять блок кода снова и снова либо бесконечно, либо до тех пор, пока вы явно не скажете ему остановиться.
В качестве примера измените файл src/main.rs в вашем каталоге loops так, чтобы он выглядел следующим образом:
Имя файла: src/main.rs
fn main() {
    loop {
        println!("again!");
    }
}
Когда мы запустим эту программу, мы увидим, как again! выводится снова и снова, непрерывно, пока мы не остановим программу вручную. Большинство терминалов поддерживают сочетание клавиш ctrl-C, чтобы прервать программу, застрявшую в бесконечном цикле. Попробуйте:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.08s
     Running `target/debug/loops`
again!
again!
again!
again!
^Cagain!
Символ ^C обозначает место, где вы нажали ctrl-C.
Вы можете увидеть или не увидеть слово again!, напечатанное после ^C, в зависимости от того, где находился код в цикле, когда он получил сигнал прерывания.
К счастью, Rust также предоставляет способ выйти из цикла с помощью кода. Вы можете поместить ключевое слово break внутрь цикла, чтобы указать программе, когда прекратить выполнение цикла. Вспомните, что мы делали это в игре «Угадай число» в разделе «Выход после правильной догадки» главы 2, чтобы выйти из программы, когда пользователь выиграл игру, угадав правильное число.
Мы также использовали continue в игре «Угадай число», который в цикле говорит программе пропустить оставшийся код в этой итерации цикла и перейти к следующей итерации.
Возврат значений из циклов
Одно из применений loop — повторение операции, которая, как вы знаете, может завершиться неудачей, например, проверка того, завершил ли поток свою работу. Возможно, вам также потребуется передать результат этой операции из цикла остальной части вашего кода. Для этого вы можете добавить значение, которое хотите вернуть, после выражения break, используемого для остановки цикла; это значение будет возвращено из цикла, чтобы вы могли его использовать, как показано здесь:
fn main() {
    let mut counter = 0;

    let result = loop {
        counter += 1;

        if counter == 10 {
            break counter * 2;
        }
    };

    println!("The result is {result}");
}
Перед циклом мы объявляем переменную с именем counter и инициализируем её значением 0. Затем мы объявляем переменную с именем result, чтобы сохранить значение, возвращаемое из цикла. На каждой итерации цикла мы добавляем 1 к переменной counter, а затем проверяем, равна ли counter 10. Когда она равна, мы используем ключевое слово break со значением counter * 2. После цикла мы используем точку с запятой, чтобы завершить инструкцию, присваивающую значение result. Наконец, мы печатаем значение в result, которое в данном случае равно 20.
Вы также можете использовать return изнутри цикла. В то время как break выходит только из текущего цикла, return всегда выходит из текущей функции.
Устранение неоднозначности с помощью меток циклов
Если у вас есть циклы внутри циклов, break и continue применяются к самому внутреннему циклу в этой точке. При желании вы можете указать метку цикла на цикле, которую затем можно использовать с break или continue, чтобы указать, что эти ключевые слова применяются к помеченному циклу, а не к самому внутреннему. Метки циклов должны начинаться с одинарной кавычки. Вот пример с двумя вложенными циклами:
fn main() {
    let mut count = 0;
    'counting_up: loop {
        println!("count = {count}");
        let mut remaining = 10;

        loop {
            println!("remaining = {remaining}");
            if remaining == 9 {
                break;
            }
            if count == 2 {
                break 'counting_up;
            }
            remaining -= 1;
        }

        count += 1;
    }
    println!("End count = {count}");
}
Внешний цикл имеет метку 'counting_up, и он будет считать от 0 до 2. Внутренний цикл без метки считает вниз от 10 до 9. Первый break, не указывающий метку, выйдет только из внутреннего цикла. Инструкция break 'counting_up; выйдет из внешнего цикла. Этот код печатает:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.58s
     Running `target/debug/loops`
count = 0
remaining = 10
remaining = 9
count = 1
remaining = 10
remaining = 9
count = 2
remaining = 10
End count = 2
Упрощение условных циклов с помощью while
Программе часто требуется вычислять условие внутри цикла. Пока условие истинно (true), цикл выполняется. Когда условие перестаёт быть истинным (true), программа вызывает break, останавливая цикл. Можно реализовать такое поведение, используя комбинацию loop, if, else и break; вы можете попробовать это сейчас в программе, если хотите. Однако этот шаблон настолько распространён, что в Rust есть встроенная языковая конструкция для него, называемая циклом while. В листинге 3-3 мы используем while, чтобы зациклить программу три раза, каждый раз выполняя обратный отсчёт, а затем, после цикла, напечатать сообщение и выйти.
fn main() {
    let mut number = 3;

    while number != 0 {
        println!("{number}!");

        number -= 1;
    }

    println!("LIFTOFF!!!");
}while для выполнения кода, пока условие вычисляется как trueЭта конструкция устраняет большую часть вложенности, которая была бы необходима при использовании loop, if, else и break, и она понятнее. Пока условие вычисляется как true, код выполняется; в противном случае он выходит из цикла.
Цикл по коллекции с помощью for
Вы можете использовать конструкцию while для перебора элементов коллекции, такой как массив. Например, цикл в листинге 3-4 печатает каждый элемент массива a.
fn main() {
    let a = [10, 20, 30, 40, 50];
    let mut index = 0;

    while index < 5 {
        println!("the value is: {}", a[index]);

        index += 1;
    }
}whileЗдесь код проходит по элементам массива. Он начинается с индекса 0, а затем зацикливается, пока не достигнет последнего индекса в массиве (то есть пока index < 5 не перестанет быть true). Выполнение этого кода напечатает каждый элемент массива:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.32s
     Running `target/debug/loops`
the value is: 10
the value is: 20
the value is: 30
the value is: 40
the value is: 50
Все пять значений массива появляются в терминале, как и ожидалось. Несмотря на то, что index в какой-то момент достигнет значения 5, цикл прекращает выполнение, прежде чем попытаться получить шестое значение из массива.
Однако этот подход подвержен ошибкам; мы могли бы вызвать панику программы, если значение индекса или условие проверки неверны. Например, если вы измените определение массива a на четыре элемента, но забудете обновить условие до while index < 4, код запаникует. Это также медленно, потому что компилятор добавляет код времени выполнения для выполнения условной проверки того, находится ли индекс в границах массива на каждой итерации цикла.
В качестве более краткой альтернативы вы можете использовать цикл for и выполнять некоторый код для каждого элемента в коллекции. Цикл for выглядит как код в листинге 3-5.
fn main() {
    let a = [10, 20, 30, 40, 50];

    for element in a {
        println!("the value is: {element}");
    }
}forКогда мы запустим этот код, мы увидим тот же вывод, что и в листинге 3-4. Что ещё важнее, теперь мы повысили безопасность кода и устранили возможность ошибок, которые могут возникнуть из-за выхода за пределы массива или недостаточного продвижения и пропуска некоторых элементов. Машинный код, генерируемый из циклов for, также может быть более эффективным, потому что индекс не нужно сравнивать с длиной массива на каждой итерации.
Используя цикл for, вам не нужно было бы помнить об изменении любого другого кода, если бы вы изменили количество значений в массиве, как это было бы с методом, использованным в листинге 3-4.
Безопасность и краткость циклов for делают их наиболее часто используемой конструкцией цикла в Rust. Даже в ситуациях, когда вы хотите выполнить некоторый код определённое количество раз, как в примере с обратным отсчётом, в котором использовался цикл while в листинге 3-3, большинство Rustaceans использовали бы цикл for. Способ сделать это — использовать Range, предоставляемый стандартной библиотекой, который генерирует все числа в последовательности, начиная с одного числа и заканчивая перед другим числом.
Вот как выглядел бы обратный отсчёт с использованием цикла for и другого метода, о котором мы ещё не говорили, rev, для обращения диапазона:
Имя файла: src/main.rs
fn main() {
    for number in (1..4).rev() {
        println!("{number}!");
    }
    println!("LIFTOFF!!!");
}
Этот код немного приятнее, не так ли?
Резюме
Вы справились! Это была довольно объёмная глава: вы узнали о переменных, скалярных и составных типах данных, функциях, комментариях, выражениях if и циклах! Чтобы попрактиковаться в концепциях, обсуждавшихся в этой главе, попробуйте построить программы, которые делают следующее:
- Преобразование температур между Фаренгейтом и Цельсием.
- Генерация n-го числа Фибоначчи.
- Печать текста рождественской песни «Двенадцать дней Рождества», используя повторение в песне.
Когда будете готовы двигаться дальше, мы поговорим о концепции в Rust, которая не часто встречается в других языках программирования: владение.
Понимание владения
Понимание владения
Владение — самая уникальная особенность Rust, и оно имеет глубокие последствия для всего остального языка. Оно позволяет Rust давать гарантии безопасности памяти без необходимости в сборщике мусора, поэтому важно понять, как работает владение. В этой главе речь пойдёт о владении, а также о нескольких связанных возможностях: заимствовании, срезах и о том, как Rust располагает данные в памяти.
Что такое владение?
Что такое владение?
Владение — это набор правил, которые управляют тем, как программа на Rust управляет памятью. Все программы должны управлять тем, как они используют память компьютера во время работы. В некоторых языках есть сборка мусора, которая регулярно ищет неиспользуемую память во время работы программы; в других языках программист должен явно выделять и освобождать память. Rust использует третий подход: память управляется через систему владения с набором правил, которые проверяет компилятор. Если какое-либо из правил нарушается, программа не скомпилируется. Ни одна из возможностей владения не замедлит работу программы во время её выполнения.
Поскольку владение является новой концепцией для многих программистов, требуется некоторое время, чтобы к нему привыкнуть. Хорошая новость в том, что чем больше опыта вы приобретаете с Rust и правилами системы владения, тем легче вам будет естественным образом разрабатывать код, который безопасен и эффективен. Продолжайте в том же духе!
Когда вы поймёте владение, у вас будет прочная основа для понимания особенностей, которые делают Rust уникальным. В этой главе вы изучите владение, работая с некоторыми примерами, которые фокусируются на очень распространённой структуре данных: строках.
Стек и куча
Многие языки программирования не требуют, чтобы вы часто думали о стеке и куче. Но в системном языке программирования, таком как Rust, то, находится ли значение в стеке или в куче, влияет на то, как ведёт себя язык и почему вам приходится принимать определённые решения. Части владения будут описаны в связи со стеком и кучей позже в этой главе, поэтому вот краткое объяснение в качестве подготовки.
И стек, и куча являются частями памяти, доступными вашему коду для использования во время выполнения, но они структурированы по-разному. Стек хранит значения в том порядке, в котором он их получает, и удаляет значения в обратном порядке. Это называется последним пришёл — первым вышел (LIFO). Представьте стопку тарелок: когда вы добавляете тарелки, вы кладёте их наверх стопки, а когда вам нужна тарелка, вы берёте её сверху. Добавление или удаление тарелок из середины или снизу не сработало бы так хорошо! Добавление данных называется заталкиванием в стек, а удаление данных — выталкиванием из стека. Все данные, хранящиеся в стеке, должны иметь известный, фиксированный размер. Данные с неизвестным во время компиляции размером или размером, который может измениться, должны храниться в куче.
Куча менее организована: когда вы помещаете данные в кучу, вы запрашиваете определённое количество места. Распределитель памяти находит пустое место в куче, достаточно большое, помечает его как используемое и возвращает указатель, который является адресом этого места. Этот процесс называется выделением в куче и иногда сокращается просто как выделение (заталкивание значений в стек не считается выделением). Поскольку указатель на кучу имеет известный, фиксированный размер, вы можете хранить указатель в стеке, но когда вам нужны фактические данные, вы должны проследовать по указателю. Представьте, что вас усаживают в ресторане. Когда вы входите, вы называете количество человек в вашей группе, и хостес находит пустой столик, подходящий для всех, и провожает вас туда. Если кто-то из вашей группы приходит поздно, они могут спросить, где вас посадили, чтобы найти вас.
Заталкивание в стек быстрее, чем выделение в куче, потому что распределителю никогда не нужно искать место для хранения новых данных; это место всегда на вершине стека. Для сравнения, выделение места в куче требует больше работы, потому что распределитель должен сначала найти достаточно большое пространство для хранения данных, а затем выполнить учёт, чтобы подготовиться к следующему выделению.
Доступ к данным в куче обычно медленнее, чем доступ к данным в стеке, потому что вам нужно проследовать по указателю, чтобы добраться до них. Современные процессоры работают быстрее, если они меньше прыгают по памяти. Продолжая аналогию, рассмотрим официанта в ресторане, принимающего заказы от многих столиков. Наиболее эффективно принять все заказы за одним столиком, прежде чем переходить к следующему. Принятие заказа от столика A, затем заказа от столика B, затем снова от A и затем снова от B было бы гораздо более медленным процессом. По той же причине процессор обычно может выполнять свою работу лучше, если он работает с данными, которые близки к другим данным (как в стеке), а не дальше (как может быть в куче).
Когда ваш код вызывает функцию, значения, переданные в функцию (включая, возможно, указатели на данные в куче), и локальные переменные функции заталкиваются в стек. Когда функция завершается, эти значения выталкиваются из стека.
Отслеживание того, какие части кода используют какие данные в куче, минимизация объёма дублирующихся данных в куче и очистка неиспользуемых данных в куче, чтобы не закончилось место — всё это проблемы, которые решает владение. Как только вы поймёте владение, вам не нужно будет часто думать о стеке и куче. Но знание того, что основная цель владения — управление данными в куче, может помочь объяснить, почему оно работает так, как работает.
Правила владения
Сначала давайте посмотрим на правила владения. Держите эти правила в уме, пока мы работаем с примерами, которые их иллюстрируют:
- Каждое значение в Rust имеет владельца.
- В каждый момент времени может быть только один владелец.
- Когда владелец выходит из области видимости, значение будет удалено.
Область видимости переменной
Теперь, когда мы прошли базовый синтаксис Rust, мы не будем включать весь код fn main() { в примеры, поэтому, если вы следите за книгой, убедитесь, что вы вручную помещаете следующие примеры внутрь функции main. В результате наши примеры будут немного более краткими, что позволит нам сосредоточиться на фактических деталях, а не на шаблонном коде.
В качестве первого примера владения мы рассмотрим область видимости некоторых переменных. Область видимости — это диапазон в программе, для которого элемент является действительным. Возьмём следующую переменную:
#![allow(unused)]
fn main() {
let s = "hello";
}
Переменная s ссылается на строковый литерал, где значение строки жёстко закодировано в тексте нашей программы. Переменная действительна с момента её объявления до конца текущей области видимости. В листинге 4-1 показана программа с комментариями, аннотирующими, где переменная s была бы действительной.
fn main() {
    {                      // s не действительна здесь, так как она ещё не объявлена
        let s = "hello";   // s действительна с этого момента

        // делаем что-то с s
    }                      // эта область видимости теперь закончилась, и s больше не действительна
}Другими словами, здесь есть два важных момента времени:
- Когда
sвходит в область видимости, она действительна. - Она остаётся действительной, пока не выйдет из области видимости.
На данный момент связь между областями видимости и тем, когда переменные действительны, аналогична той, что в других языках программирования. Теперь мы будем строить на основе этого понимания, вводя тип String.
Тип String
Чтобы проиллюстрировать правила владения, нам нужен тип данных, который сложнее тех, что мы рассмотрели в разделе «Типы данных» главы 3. Рассмотренные ранее типы имеют известный размер, могут храниться в стеке и выталкиваться из стека, когда их область видимости заканчивается, и могут быстро и тривиально копироваться для создания нового независимого экземпляра, если другой части кода нужно использовать то же значение в другой области видимости. Но мы хотим рассмотреть данные, которые хранятся в куче, и изучить, как Rust узнаёт, когда очищать эти данные, и тип String — отличный пример.
Мы сосредоточимся на частях String, которые связаны с владением. Эти аспекты также применимы к другим сложным типам данных, будь то предоставленные стандартной библиотекой или созданные вами. Мы обсудим аспекты String, не связанные с владением, в главе 8.
Мы уже видели строковые литералы, где строковое значение жёстко закодировано в нашей программе. Строковые литералы удобны, но они не подходят для каждой ситуации, в которой мы можем захотеть использовать текст. Одна из причин — они неизменяемы. Другая — не каждое строковое значение может быть известно при написании кода: например, что если мы хотим взять пользовательский ввод и сохранить его? Именно для таких ситуаций в Rust есть тип String. Этот тип управляет данными, размещёнными в куче, и, таким образом, может хранить объём текста, неизвестный нам во время компиляции. Вы можете создать String из строкового литерала, используя функцию from, вот так:
#![allow(unused)]
fn main() {
let s = String::from("hello");
}
Оператор двойного двоеточия :: позволяет нам поместить эту конкретную функцию from в пространство имён под типом String, а не использовать какое-то имя вроде string_from. Мы обсудим этот синтаксис подробнее в разделе «Методы» главы 5 и когда будем говорить о пространствах имён с модулями в разделе «Пути для ссылки на элемент в дереве модулей» главы 7.
Этот вид строки можно изменять:
fn main() {
    let mut s = String::from("hello");

    s.push_str(", world!"); // push_str() добавляет литерал к String

    println!("{s}"); // это напечатает `hello, world!`
}
Итак, в чём разница? Почему String можно изменять, а литералы — нет? Разница в том, как эти два типа работают с памятью.
Память и выделение
В случае строкового литерала мы знаем содержимое во время компиляции, поэтому текст жёстко закодирован непосредственно в конечный исполняемый файл. Вот почему строковые литералы быстры и эффективны. Но эти свойства происходят только из неизменяемости строкового литерала. К сожалению, мы не можем поместить блок памяти в бинарный файл для каждого фрагмента текста, размер которого неизвестен во время компиляции и может меняться во время работы программы.
С типом String, чтобы поддерживать изменяемый, расширяемый фрагмент текста, нам нужно выделить в куче количество памяти, неизвестное во время компиляции, для хранения содержимого. Это означает:
- Память должна быть запрошена у распределителя памяти во время выполнения.
- Нам нужен способ вернуть эту память распределителю, когда мы закончим с нашей
String.
Первую часть выполняем мы: когда мы вызываем String::from, его реализация запрашивает необходимую память. Это практически универсально в языках программирования.
Однако вторая часть отличается. В языках со сборщиком мусора (GC) сборщик мусора отслеживает и очищает память, которая больше не используется, и нам не нужно об этом думать. В большинстве языков без сборщика мусора наша ответственность — определить, когда память больше не используется, и вызвать код для её явного освобождения, точно так же, как мы это делали для её запроса. Правильно делать это исторически было сложной задачей программирования. Если мы забудем, мы будем тратить память впустую. Если мы сделаем это слишком рано, у нас будет недействительная переменная. Если мы сделаем это дважды, это тоже ошибка. Нам нужно соединить ровно один allocate ровно с одним free.
Rust выбирает другой путь: память автоматически возвращается, как только переменная, которая ею владеет, выходит из области видимости. Вот версия нашего примера области видимости из листинга 4-1, использующая String вместо строкового литерала:
fn main() {
    {
        let s = String::from("hello"); // s действительна с этого момента

        // делаем что-то с s
    }                                  // эта область видимости теперь закончилась, и s больше не
                                       // действительна
}
Есть естественный момент, когда мы можем вернуть память, необходимую нашей String, распределителю: когда s выходит из области видимости. Когда переменная выходит из области видимости, Rust вызывает для нас специальную функцию. Эта функция называется drop, и именно в ней автор String может разместить код для возврата памяти. Rust вызывает drop автоматически на закрывающей фигурной скобке.
Примечание: В C++ этот шаблон освобождения ресурсов в конце времени жизни элемента иногда называют Получение ресурса есть инициализация (Resource Acquisition Is Initialization, RAII). Функция drop в Rust будет знакома вам, если вы использовали шаблоны RAII.
Этот шаблон оказывает глубокое влияние на то, как пишется код на Rust. Сейчас это может показаться простым, но поведение кода может быть неожиданным в более сложных ситуациях, когда мы хотим, чтобы несколько переменных использовали данные, которые мы выделили в куче. Давайте рассмотрим некоторые из этих ситуаций прямо сейчас.
Взаимодействие переменных и данных при перемещении
Несколько переменных могут взаимодействовать с одними и теми же данными в Rust по-разному. В листинге 4-2 показан пример с целым числом.
fn main() {
    let x = 5;
    let y = x;
}x переменной yМы, вероятно, можем догадаться, что здесь происходит: «Связать значение 5 с x; затем сделать копию значения в x и связать её с y». Теперь у нас есть две переменные, x и y, и обе равны 5. Это действительно то, что происходит, потому что целые числа — это простые значения с известным, фиксированным размером, и эти два значения 5 заталкиваются в стек.
Теперь давайте посмотрим на версию со String:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;
}
Это выглядит очень похоже, поэтому мы могли бы предположить, что способ работы будет таким же: то есть вторая строка сделает копию значения в s1 и свяжет её с s2. Но это не совсем то, что происходит.
Взгляните на рисунок 4-1, чтобы увидеть, что происходит со String под капотом. String состоит из трёх частей, показанных слева: указатель на память, которая содержит содержимое строки, длина и ёмкость. Эта группа данных хранится в стеке. Справа — память в куче, которая содержит содержимое.
Рисунок 4-1: Представление в памяти String
содержащей значение "hello", связанной с s1
Длина — это сколько памяти в байтах содержимое String в настоящее время использует. Ёмкость — это общий объём памяти в байтах, который String получил от распределителя. Разница между длиной и ёмкостью важна, но не в этом контексте, поэтому пока можно игнорировать ёмкость.
Когда мы присваиваем s1 к s2, данные String копируются, что означает, что мы копируем указатель, длину и ёмкость, которые находятся в стеке. Мы не копируем данные в куче, на которые указывает указатель. Другими словами, представление данных в памяти выглядит как на рисунке 4-2.
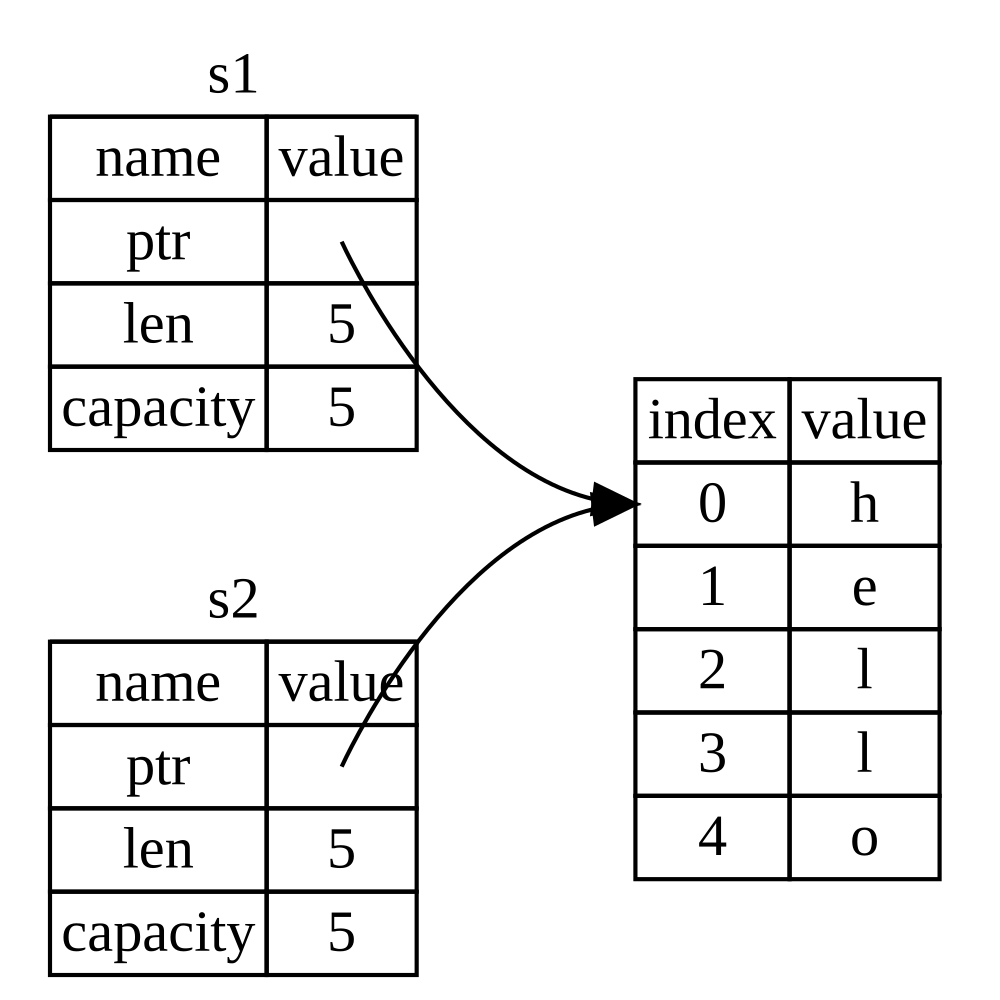
Рисунок 4-2: Представление в памяти переменной
s2, которая имеет копию указателя, длины и ёмкости s1
Представление не выглядит как на рисунке 4-3, который показывает, как выглядела бы память, если бы Rust вместо этого скопировал и данные в куче. Если бы Rust сделал это, операция s2 = s1 могла бы быть очень дорогой с точки зрения производительности во время выполнения, если бы данные в куче были большими.
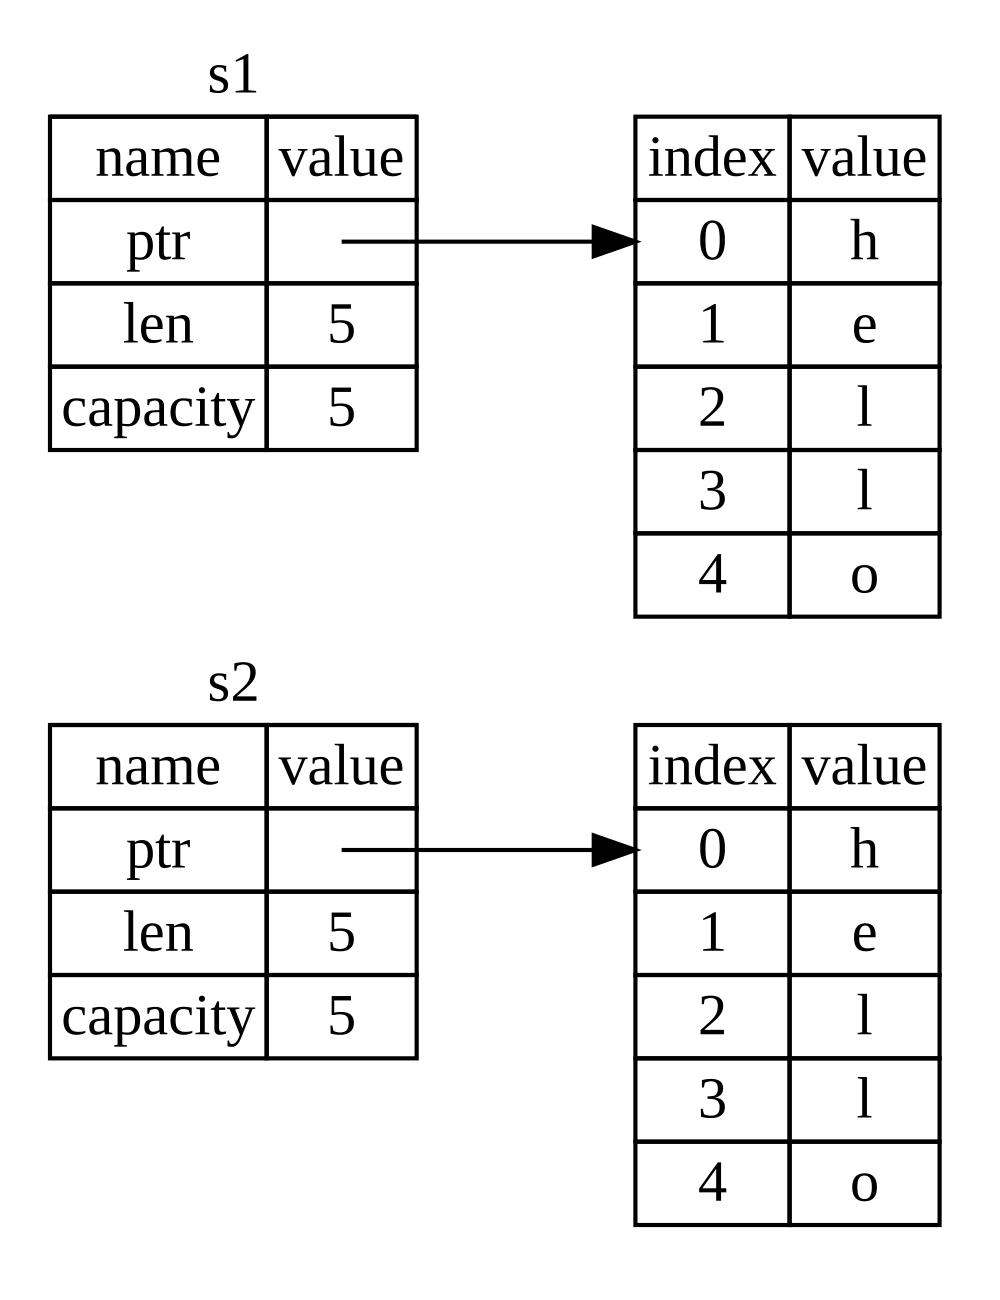
Рисунок 4-3: Другая возможность для того, что s2 = s1
мог бы сделать, если бы Rust также скопировал данные в куче
Ранее мы говорили, что когда переменная выходит из области видимости, Rust автоматически вызывает функцию drop и очищает память в куче для этой переменной. Но рисунок 4-2 показывает, что оба указателя на данные указывают на одно и то же место. Это проблема: когда s2 и s1 выйдут из области видимости, они обе попытаются освободить одну и ту же память. Это известно как ошибка двойного освобождения и является одной из ошибок безопасности памяти, которые мы упоминали ранее. Освобождение памяти дважды может привести к повреждению памяти, что потенциально может привести к уязвимостям безопасности.
Чтобы обеспечить безопасность памяти, после строки let s2 = s1; Rust считает s1 больше не действительной. Поэтому Rust не нужно ничего освобождать, когда s1 выходит из области видимости. Посмотрите, что происходит, когда вы пытаетесь использовать s1 после создания s2; это не сработает:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;

    println!("{s1}, world!");
}
Вы получите ошибку, подобную этой, потому что Rust предотвращает использование недействительной ссылки:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0382]: borrow of moved value: `s1`
 --> src/main.rs:5:16
  |
2 |     let s1 = String::from("hello");
  |         -- move occurs because `s1` has type `String`, which does not implement the `Copy` trait
3 |     let s2 = s1;
  |              -- value moved here
4 |
5 |     println!("{s1}, world!");
  |                ^^ value borrowed here after move
  |
help: consider cloning the value if the performance cost is acceptable
  |
3 |     let s2 = s1.clone();
  |                ++++++++

For more information about this error, try `rustc --explain E0382`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Если вы слышали термины поверхностное копирование и глубокое копирование при работе с другими языками, концепция копирования указателя, длины и ёмкости без копирования данных, вероятно, звучит как поверхностное копирование. Но поскольку Rust также делает первую переменную недействительной, вместо того чтобы называться поверхностным копированием, это известно как перемещение. В этом примере мы бы сказали, что s1 была перемещена в s2. Итак, что на самом деле происходит, показано на рисунке 4-4.
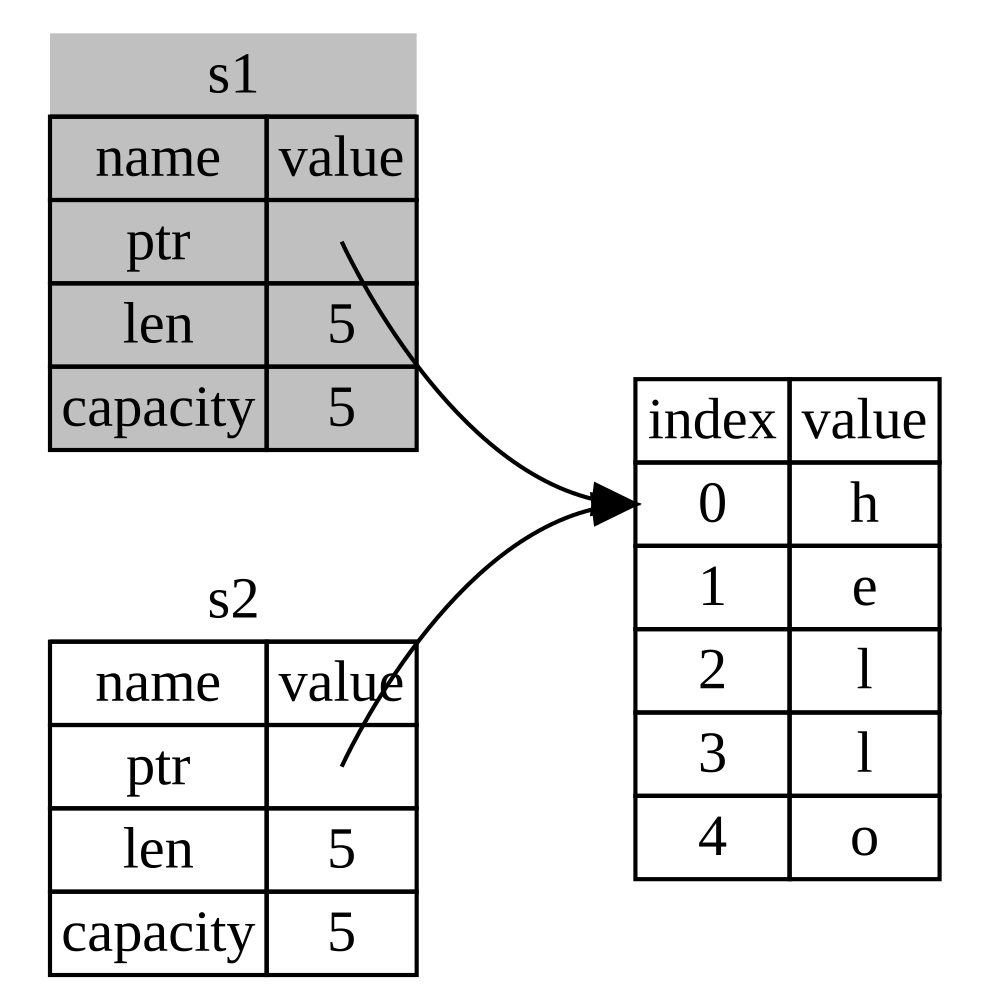
Рисунок 4-4: Представление в памяти после того, как s1
была сделана недействительной
Это решает нашу проблему! Когда действительна только s2, когда она выходит из области видимости, только она освободит память, и мы закончили.
Кроме того, есть выбор дизайна, который подразумевается этим: Rust никогда не будет автоматически создавать «глубокие» копии ваших данных. Следовательно, любое автоматическое копирование можно считать недорогим с точки зрения производительности во время выполнения.
Область видимости и присваивание
Обратное верно для отношения между областью видимости, владением и освобождением памяти через функцию drop. Когда вы присваиваете совершенно новое значение существующей переменной, Rust вызовет drop и немедленно освободит память исходного значения. Рассмотрим этот код, например:
fn main() {
    let mut s = String::from("hello");
    s = String::from("ahoy");

    println!("{s}, world!");
}
Сначала мы объявляем переменную s и связываем её с String со значением "hello". Затем мы сразу создаём новую String со значением "ahoy" и присваиваем её s. В этот момент на исходное значение в куче вообще ничего не ссылается. Рисунок 4-5 иллюстрирует данные стека и кучи теперь:
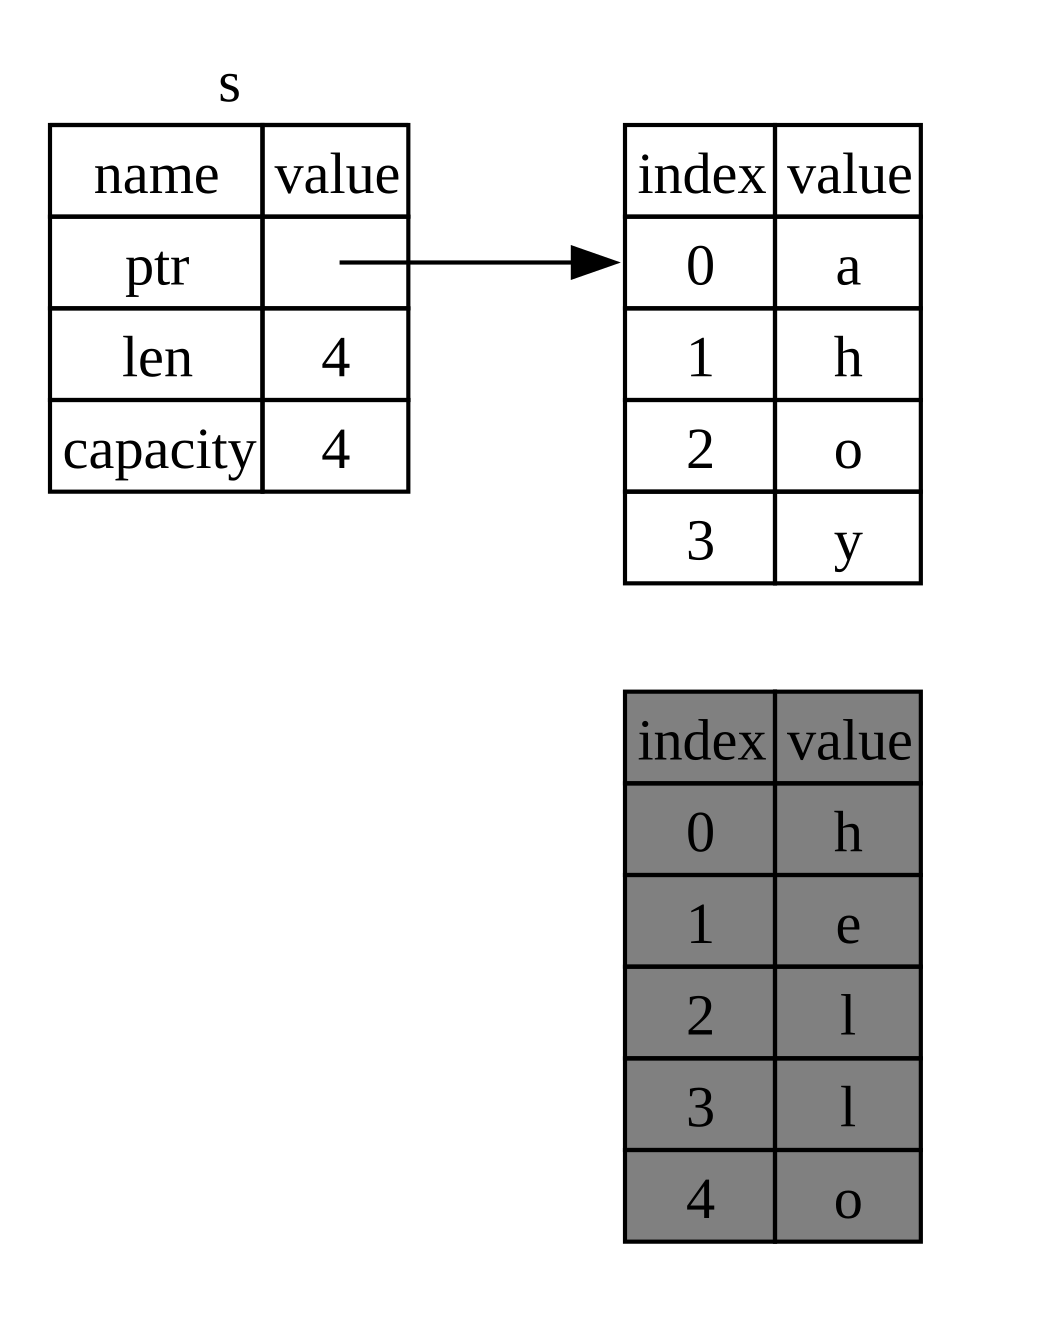
Рисунок 4-5: Представление в памяти после того, как исходное значение было полностью заменено
Таким образом, исходная строка сразу выходит из области видимости. Rust запустит функцию drop для неё, и её память будет немедленно освобождена. Когда мы печатаем значение в конце, это будет "ahoy, world!".
Взаимодействие переменных и данных при клонировании
Если мы действительно хотим глубоко скопировать данные String в куче, а не только данные стека, мы можем использовать распространённый метод, называемый clone. Мы обсудим синтаксис методов в главе 5, но поскольку методы являются распространённой особенностью многих языков программирования, вы, вероятно, видели их раньше.
Вот пример метода clone в действии:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1.clone();

    println!("s1 = {s1}, s2 = {s2}");
}
Это работает просто отлично и явно производит поведение, показанное на рисунке 4-3, где данные в куче действительно копируются.
Когда вы видите вызов clone, вы знаете, что выполняется какой-то произвольный код, и этот код может быть дорогим. Это визуальный индикатор того, что происходит что-то другое.
Данные только в стеке: Copy
Есть ещё одна морщина, о которой мы ещё не говорили. Этот код, использующий целые числа — часть которого была показана в листинге 4-2 — работает и является допустимым:
fn main() {
    let x = 5;
    let y = x;

    println!("x = {x}, y = {y}");
}
Но этот код, кажется, противоречит тому, что мы только что узнали: у нас нет вызова clone, но x всё ещё действительна и не была перемещена в y.
Причина в том, что типы, такие как целые числа, которые имеют известный размер во время компиляции, хранятся полностью в стеке, поэтому копии фактических значений создаются быстро. Это означает, что нет причин, по которым мы хотели бы предотвратить x от того, чтобы быть действительной после создания переменной y. Другими словами, здесь нет разницы между глубоким и поверхностным копированием, поэтому вызов clone не сделал бы ничего отличного от обычного поверхностного копирования, и мы можем его опустить.
В Rust есть специальная аннотация, называемая трейтом Copy, которую мы можем разместить на типах, которые хранятся в стеке, как целые числа (мы поговорим больше о трейтах в главе 10). Если тип реализует трейт Copy, переменные, которые его используют, не перемещаются, а тривиально копируются, что делает их всё ещё действительными после присваивания другой переменной.
Rust не позволит нам аннотировать тип с помощью Copy, если тип или любая из его частей реализовала трейт Drop. Если типу нужно что-то особенное, чтобы произойти, когда значение выходит из области видимости, и мы добавляем аннотацию Copy к этому типу, мы получим ошибку времени компиляции. Чтобы узнать, как добавить аннотацию Copy к вашему типу для реализации трейта, см. «Выводимые трейты» в Приложении C.
Итак, какие типы реализуют трейт Copy? Вы можете проверить документацию для данного типа, чтобы убедиться, но как общее правило, любая группа простых скалярных значений может реализовать Copy, и ничего, что требует выделения памяти или является какой-либо формой ресурса, не может реализовать Copy. Вот некоторые из типов, которые реализуют Copy:
- Все целочисленные типы, такие как
u32. - Логический тип
boolсо значениямиtrueиfalse. - Все типы с плавающей запятой, такие как
f64. - Символьный тип
char. - Кортежи, если они содержат только типы, которые также реализуют
Copy. Например,(i32, i32)реализуетCopy, а(i32, String)— нет.
Владение и функции
Механика передачи значения в функцию аналогична механике присваивания значения переменной. Передача переменной в функцию будет перемещать или копировать, как и присваивание. В листинге 4-3 приведён пример с некоторыми аннотациями, показывающими, где переменные входят в область видимости и выходят из неё.
fn main() {
    let s = String::from("hello");  // s входит в область видимости

    takes_ownership(s);             // значение s перемещается в функцию...
                                    // ... и поэтому здесь больше не действительно

    let x = 5;                      // x входит в область видимости

    makes_copy(x);                  // Поскольку i32 реализует трейт Copy,
                                    // x НЕ перемещается в функцию,
                                    // поэтому x можно использовать позже.

} // Здесь x выходит из области видимости, затем s. Однако, поскольку значение s было перемещено,
  // ничего особенного не происходит.

fn takes_ownership(some_string: String) { // some_string входит в область видимости
    println!("{some_string}");
} // Здесь some_string выходит из области видимости и вызывается `drop`. Память
  // освобождается.

fn makes_copy(some_integer: i32) { // some_integer входит в область видимости
    println!("{some_integer}");
} // Здесь some_integer выходит из области видимости. Ничего особенного не происходит.Если бы мы попытались использовать s после вызова takes_ownership, Rust выдал бы ошибку времени компиляции. Эти статические проверки защищают нас от ошибок. Попробуйте добавить код в main, который использует s и x, чтобы увидеть, где вы можете их использовать, а где правила владения мешают вам это делать.
Возвращаемые значения и область видимости
Возврат значений также может передавать владение. В листинге 4-4 показан пример функции, которая возвращает некоторое значение, с аннотациями, подобными тем, что в листинге 4-3.
fn main() {
    let s1 = gives_ownership();        // gives_ownership перемещает своё возвращаемое
                                       // значение в s1

    let s2 = String::from("hello");    // s2 входит в область видимости

    let s3 = takes_and_gives_back(s2); // s2 перемещается в
                                       // takes_and_gives_back, которая также
                                       // перемещает своё возвращаемое значение в s3
} // Здесь s3 выходит из области видимости и удаляется. s2 была перемещена, поэтому ничего
  // не происходит. s1 выходит из области видимости и удаляется.

fn gives_ownership() -> String {       // gives_ownership переместит своё
                                       // возвращаемое значение в функцию,
                                       // которая её вызывает

    let some_string = String::from("yours"); // some_string входит в область видимости

    some_string                        // some_string возвращается и
                                       // перемещается в вызывающую
                                       // функцию
}

// Эта функция принимает String и возвращает String.
fn takes_and_gives_back(a_string: String) -> String {
    // a_string входит в
    // область видимости

    a_string  // a_string возвращается и перемещается в вызывающую функцию
}Владение переменной следует одному и тому же шаблону каждый раз: присваивание значения другой переменной перемещает его. Когда переменная, которая включает данные в куче, выходит из области видимости, значение будет очищено с помощью drop, если владение данными не было перемещено в другую переменную.
Хотя это работает, брать на себя владение, а затем возвращать владение с каждой функцией немного утомительно. Что если мы хотим позволить функции использовать значение, но не брать на себя владение? Довольно раздражает, что всё, что мы передаём, также нужно передавать обратно, если мы хотим использовать это снова, в дополнение к любым данным, полученным в результате работы тела функции, которые мы, возможно, также хотим вернуть.
Rust действительно позволяет нам возвращать несколько значений, используя кортеж, как показано в листинге 4-5.
fn main() {
    let s1 = String::from("hello");

    let (s2, len) = calculate_length(s1);

    println!("The length of '{s2}' is {len}.");
}

fn calculate_length(s: String) -> (String, usize) {
    let length = s.len(); // len() возвращает длину String

    (s, length)
}Но это слишком много церемоний и много работы для концепции, которая должна быть обычной. К счастью для нас, в Rust есть функция для использования значения без передачи владения: ссылки.
Ссылки и заимствование
Ссылки и заимствование
Проблема с кодом кортежа в листинге 4-5 заключается в том, что нам приходится возвращать
String вызывающей функции, чтобы мы могли по-прежнему использовать String после
вызова calculate_length, потому что String была перемещена в
calculate_length. Вместо этого мы можем передать ссылку на значение String.
Ссылка подобна указателю в том смысле, что это адрес, по которому мы можем перейти для доступа
к данным, хранящимся по этому адресу; эти данные принадлежат какой-то другой переменной.
В отличие от указателя, ссылка гарантированно указывает на допустимое значение
определённого типа в течение времени жизни этой ссылки.
Вот как можно определить и использовать функцию calculate_length, которая имеет
ссылку на объект в качестве параметра вместо того, чтобы принимать владение значением:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize {
    s.len()
}
Во-первых, обратите внимание, что весь код кортежа в объявлении переменной и
возвращаемом значении функции исчез. Во-вторых, обратите внимание, что мы передаём &s1 в
calculate_length и в её определении принимаем &String, а не
String. Эти амперсанды представляют ссылки, и они позволяют вам ссылаться на
некоторое значение, не принимая владение им. На рисунке 4-6 изображена эта концепция.
Рисунок 4-6: Диаграмма &String s, указывающей на
String s1
Примечание: Противоположностью создания ссылки с помощью & является разыменование, которое
выполняется с помощью оператора разыменования *. Мы увидим некоторые применения
оператора разыменования в восьмой главе и обсудим детали разыменования в
пятнадцатой главе.
Давайте подробнее рассмотрим вызов функции здесь:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize {
    s.len()
}
Синтаксис &s1 позволяет нам создать ссылку, которая ссылается на значение s1,
но не владеет им. Поскольку ссылка не владеет им, значение, на которое она указывает,
не будет освобождено, когда ссылка перестанет использоваться.
Аналогично, сигнатура функции использует &, чтобы указать, что тип
параметра s является ссылкой. Давайте добавим некоторые поясняющие аннотации:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize { // s — это ссылка на String
    s.len()
} // Здесь s выходит из области видимости. Но поскольку s не владеет тем,
  // на что указывает, String не удаляется.
Область видимости, в которой переменная s действительна, такая же, как у любого параметра
функции, но значение, на которое указывает ссылка, не освобождается,
когда s перестаёт использоваться, потому что s не владеет им. Когда функции
имеют ссылки в качестве параметров вместо фактических значений, нам не нужно
возвращать значения, чтобы вернуть владение, потому что мы никогда им не владели.
Мы называем действие создания ссылки заимствованием. Как и в реальной жизни, если человек владеет чем-то, вы можете занять это у него. Когда вы закончите, вы должны вернуть это. Вы не владеете этим.
Итак, что произойдёт, если мы попытаемся изменить то, что мы заимствуем? Попробуйте код в листинге 4-6. Спойлер: это не сработает!
fn main() {
    let s = String::from("hello");

    change(&s);
}

fn change(some_string: &String) {
    some_string.push_str(", world");
}Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0596]: cannot borrow `*some_string` as mutable, as it is behind a `&` reference
 --> src/main.rs:8:5
  |
8 |     some_string.push_str(", world");
  |     ^^^^^^^^^^^ `some_string` is a `&` reference, so it cannot be borrowed as mutable
  |
help: consider changing this to be a mutable reference
  |
7 | fn change(some_string: &mut String) {
  |                         +++

For more information about this error, try `rustc --explain E0596`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Подобно тому, как переменные по умолчанию неизменяемы, ссылки тоже. Нам не разрешено изменять то, на что у нас есть ссылка.
Изменяемые ссылки
Мы можем исправить код из листинга 4-6, чтобы разрешить нам изменять заимствованное значение, всего с несколькими небольшими изменениями, которые используют вместо этого изменяемую ссылку:
fn main() {
    let mut s = String::from("hello");

    change(&mut s);
}

fn change(some_string: &mut String) {
    some_string.push_str(", world");
}
Сначала мы меняем s на mut. Затем мы создаём изменяемую ссылку с помощью
&mut s там, где вызываем функцию change, и обновляем сигнатуру функции,
чтобы она принимала изменяемую ссылку с помощью some_string: &mut String. Это делает
очень ясным, что функция change будет изменять значение, которое она заимствует.
Изменяемые ссылки имеют одно большое ограничение: если у вас есть изменяемая ссылка на
значение, у вас не может быть никаких других ссылок на это значение. Этот код, который
пытается создать две изменяемые ссылки на s, не сработает:
fn main() {
    let mut s = String::from("hello");

    let r1 = &mut s;
    let r2 = &mut s;

    println!("{r1}, {r2}");
}
Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0499]: cannot borrow `s` as mutable more than once at a time
 --> src/main.rs:5:14
  |
4 |     let r1 = &mut s;
  |              ------ first mutable borrow occurs here
5 |     let r2 = &mut s;
  |              ^^^^^^ second mutable borrow occurs here
6 |
7 |     println!("{r1}, {r2}");
  |                -- first borrow later used here

For more information about this error, try `rustc --explain E0499`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Эта ошибка говорит, что этот код недопустим, потому что мы не можем заимствовать s как
изменяемую более одного раза одновременно. Первое изменяемое заимствование находится в r1 и должно
длиться до тех пор, пока оно используется в println!, но между созданием этой
изменяемой ссылки и её использованием мы попытались создать другую изменяемую ссылку
в r2, которая заимствует те же данные, что и r1.
Ограничение, предотвращающее множественные изменяемые ссылки на одни и те же данные в одно и то же время, позволяет изменять, но очень контролируемым образом. Это то, с чем новички в Rust борются, потому что большинство языков позволяют изменять когда угодно. Преимущество этого ограничения в том, что Rust может предотвращать гонки данных во время компиляции. Гонка данных похожа на состояние гонки и происходит, когда имеют место эти три поведения:
- Два или более указателя обращаются к одним и тем же данным одновременно.
- По крайней мере один из указателей используется для записи в данные.
- Не используется никакого механизма для синхронизации доступа к данным.
Гонки данных вызывают неопределённое поведение и могут быть трудными для диагностики и исправления, когда вы пытаетесь отследить их во время выполнения; Rust предотвращает эту проблему, отказываясь компилировать код с гонками данных!
Как всегда, мы можем использовать фигурные скобки для создания новой области видимости, что позволяет использовать несколько изменяемых ссылок, но не одновременных:
fn main() {
    let mut s = String::from("hello");

    {
        let r1 = &mut s;
    } // r1 здесь выходит из области видимости, поэтому мы можем без проблем создать новую ссылку.

    let r2 = &mut s;
}
Rust применяет аналогичное правило для комбинирования изменяемых и неизменяемых ссылок. Этот код приводит к ошибке:
fn main() {
    let mut s = String::from("hello");

    let r1 = &s; // никаких проблем
    let r2 = &s; // никаких проблем
    let r3 = &mut s; // БОЛЬШАЯ ПРОБЛЕМА

    println!("{r1}, {r2}, and {r3}");
}
Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
 --> src/main.rs:6:14
  |
4 |     let r1 = &s; // no problem
  |              -- immutable borrow occurs here
5 |     let r2 = &s; // no problem
6 |     let r3 = &mut s; // BIG PROBLEM
  |              ^^^^^^ mutable borrow occurs here
7 |
8 |     println!("{r1}, {r2}, and {r3}");
  |                -- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Ух! Мы также не можем иметь изменяемую ссылку, пока у нас есть неизменяемая на то же значение.
Пользователи неизменяемой ссылки не ожидают, что значение внезапно изменится у них на глазах! Однако множественные неизменяемые ссылки разрешены, потому что никто, кто просто читает данные, не имеет возможности повлиять на чужое чтение данных.
Обратите внимание, что область видимости ссылки начинается с того места, где она введена, и продолжается
до последнего момента, когда эта ссылка используется. Например, этот код
скомпилируется, потому что последнее использование неизменяемых ссылок находится в println!,
до введения изменяемой ссылки:
fn main() {
    let mut s = String::from("hello");

    let r1 = &s; // никаких проблем
    let r2 = &s; // никаких проблем
    println!("{r1} and {r2}");
    // Переменные r1 и r2 не будут использоваться после этого места.

    let r3 = &mut s; // никаких проблем
    println!("{r3}");
}
Области видимости неизменяемых ссылок r1 и r2 заканчиваются после println!,
где они используются в последний раз, что происходит до создания изменяемой ссылки r3.
Эти области видимости не перекрываются, поэтому этот код разрешён: компилятор может
определить, что ссылка больше не используется в точке до конца
области видимости.
Хотя ошибки заимствования иногда могут раздражать, помните, что это компилятор Rust указывает на потенциальную ошибку заранее (во время компиляции, а не во время выполнения) и показывает вам точно, где проблема. Тогда вам не нужно отслеживать, почему ваши данные не такие, как вы думали.
Висячие ссылки
В языках с указателями легко ошибочно создать висячий указатель — указатель, который ссылается на местоположение в памяти, которое могло быть отдано кому-то другому, — освободив некоторую память, сохраняя указатель на эту память. В Rust, напротив, компилятор гарантирует, что ссылки никогда не будут висячими: если у вас есть ссылка на некоторые данные, компилятор обеспечит, что данные не выйдут из области видимости до того, как это сделает ссылка на данные.
Давайте попробуем создать висячую ссылку, чтобы увидеть, как Rust предотвращает их с помощью ошибки времени компиляции:
fn main() {
    let reference_to_nothing = dangle();
}

fn dangle() -> &String {
    let s = String::from("hello");

    &s
}
Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0106]: missing lifetime specifier
 --> src/main.rs:5:16
  |
5 | fn dangle() -> &String {
  |                ^ expected named lifetime parameter
  |
  = help: this function's return type contains a borrowed value, but there is no value for it to be borrowed from
help: consider using the `'static` lifetime, but this is uncommon unless you're returning a borrowed value from a `const` or a `static`
  |
5 | fn dangle() -> &'static String {
  |                 +++++++
help: instead, you are more likely to want to return an owned value
  |
5 - fn dangle() -> &String {
5 + fn dangle() -> String {
  |

For more information about this error, try `rustc --explain E0106`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Это сообщение об ошибке ссылается на функцию, которую мы ещё не рассматривали: времена жизни. Мы подробно обсудим времена жизни в десятой главе. Но если вы проигнорируете части о временах жизни, сообщение содержит ключ к тому, почему этот код является проблемой:
this function's return type contains a borrowed value, but there is no value
for it to be borrowed from
Давайте более внимательно рассмотрим, что именно происходит на каждом этапе нашего
кода dangle:
fn main() {
    let reference_to_nothing = dangle();
}

fn dangle() -> &String { // dangle возвращает ссылку на String

    let s = String::from("hello"); // s — новая строка String

    &s // мы возвращаем ссылку на String, s
} // Здесь s выходит из области видимости и удаляется, поэтому её память освобождается.
  // Опасность!
Поскольку s создаётся внутри dangle, когда код dangle завершается,
s будет освобождён. Но мы попытались вернуть ссылку на него. Это означает,
что эта ссылка указывала бы на недопустимую String. Это никуда не годится! Rust
не позволит нам это сделать.
Решение здесь — вернуть String напрямую:
fn main() {
    let string = no_dangle();
}

fn no_dangle() -> String {
    let s = String::from("hello");

    s
}
Это работает без каких-либо проблем. Владение перемещается наружу, и ничего не освобождается.
Правила ссылок
Давайте подведём итог тому, что мы обсудили о ссылках:
- В любой момент времени у вас может быть либо одна изменяемая ссылка, либо любое количество неизменяемых ссылок.
- Ссылки всегда должны быть действительными.
Далее мы рассмотрим другой вид ссылки: срезы.
Тип срез
Тип срез
Срезы позволяют ссылаться на непрерывную последовательность элементов в коллекции. Срез — это разновидность ссылки, поэтому он не владеет данными.
Вот небольшая задача по программированию: написать функцию, которая принимает строку слов, разделённых пробелами, и возвращает первое слово, найденное в этой строке. Если функция не находит пробел в строке, вся строка должна быть одним словом, поэтому вся строка должна быть возвращена.
Примечание: для целей знакомства со срезами предполагается, что в этом разделе используется только ASCII; более подробное обсуждение обработки UTF-8 находится в разделе «Хранение текста в кодировке UTF-8 с помощью строк» главы 8.
Рассмотрим, как написать сигнатуру этой функции без использования срезов, чтобы понять проблему, которую решают срезы:
fn first_word(s: &String) -> ?Функция first_word имеет параметр типа &String. Владение не нужно,
так что это нормально. (В идиоматичном Rust функции не забирают владение
своими аргументами, если в этом нет необходимости, и причины этого станут
ясны по ходу изложения.) Но что следует возвращать? В действительности нет способа
описать часть строки. Однако можно вернуть индекс конца
слова, обозначенный пробелом. Попробуем это, как показано в листинге 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}first_word, возвращающая значение байтового индекса в параметр StringПоскольку требуется пройти по String поэлементно и проверить, является ли
значение пробелом, String преобразуется в массив байтов с помощью метода
as_bytes.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Далее создаётся итератор по массиву байтов с помощью метода iter:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Итераторы подробнее рассматриваются в главе 13.
Пока достаточно знать, что iter — это метод, возвращающий каждый элемент коллекции,
а enumerate обёртывает результат iter и возвращает каждый элемент как
часть кортежа. Первый элемент кортежа, возвращаемого
enumerate, — это индекс, а второй элемент — ссылка на элемент.
Это немного удобнее, чем вычислять индекс самостоятельно.
Поскольку метод enumerate возвращает кортеж, можно использовать шаблоны для
деструктуризации этого кортежа. Шаблоны подробнее рассматриваются в главе
6. В цикле for указан шаблон, в котором i
обозначает индекс в кортеже, а &item — отдельный байт в кортеже.
Поскольку из .iter().enumerate() получена ссылка на элемент, в
шаблоне используется &.
Внутри цикла for выполняется поиск байта, представляющего пробел, с помощью
синтаксиса байтового литерала. Если найден пробел, возвращается позиция.
В противном случае возвращается длина строки с помощью s.len().
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Теперь есть способ найти индекс конца первого слова в
строке, но есть проблема. Возвращается usize сам по себе, но это
осмысленное число только в контексте &String. Другими словами,
поскольку это отдельное значение от String, нет гарантии, что оно
останется действительным в будущем. Рассмотрим программу в листинге 4-8, которая
использует функцию first_word из листинга 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s); // word получит значение 5

    s.clear(); // это очищает String, делая её равной ""

    // здесь word всё ещё имеет значение 5, но s больше не содержит содержимого, которое
    // можно было бы осмысленно использовать со значением 5, поэтому word теперь полностью недействителен!
}first_word с последующим изменением содержимого StringЭта программа компилируется без ошибок, и это было бы так же, если бы word
использовалась после вызова s.clear(). Поскольку word вообще не связана с состоянием
s, word по-прежнему содержит значение 5. Можно было бы использовать это значение 5 с
переменной s, чтобы попытаться извлечь первое слово, но это было бы ошибкой,
потому что содержимое s изменилось с момента сохранения 5 в word.
Необходимость беспокоиться о том, что индекс в word рассинхронизируется с данными в
s, утомительна и подвержена ошибкам! Управление этими индексами становится ещё более хрупким, если
написать функцию second_word. Её сигнатура должна была бы выглядеть так:
fn second_word(s: &String) -> (usize, usize) {Теперь приходится отслеживать начальный и конечный индекс, и появляется ещё больше значений, которые были вычислены из данных в определённом состоянии, но вообще не привязаны к этому состоянию. Вокруг летают три несвязанные переменные, которые нужно поддерживать в синхронизации.
К счастью, в Rust есть решение этой проблемы: строковые срезы.
Строковые срезы
Строковый срез — это ссылка на непрерывную последовательность элементов
String, и он выглядит так:
fn main() {
    let s = String::from("hello world");

    let hello = &s[0..5];
    let world = &s[6..11];
}
Вместо ссылки на всю String, hello — это ссылка на
часть String, указанную в дополнительной части [0..5]. Срезы создаются
с помощью диапазона в квадратных скобках, указывая
[starting_index..ending_index], где starting_index — первая
позиция в срезе, а ending_index — на единицу больше последней позиции
в срезе. Внутри структура данных среза хранит начальную позицию
и длину среза, что соответствует ending_index минус
starting_index. Таким образом, в случае let world = &s[6..11]; переменная world была бы
срезом, содержащим указатель на байт с индексом 6 в s и значение длины
5.
На рисунке 4-7 это показано на диаграмме.
Рисунок 4-7: Строковый срез, ссылающийся на часть
String
С синтаксисом диапазонов .. в Rust, если нужно начать с индекса 0, можно опустить
значение перед двумя точками. Иными словами, эти строки эквивалентны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let slice = &s[0..2];
let slice = &s[..2];
}
Таким же образом, если срез включает последний байт String,
можно опустить завершающее число. Это означает, что эти строки эквивалентны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[3..len];
let slice = &s[3..];
}
Можно также опустить оба значения, чтобы взять срез всей строки. Итак, эти строки эквивалентны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[0..len];
let slice = &s[..];
}
Примечание: индексы диапазона строкового среза должны попадать на границы допустимых символов UTF-8. При попытке создать строковый срез в середине многобайтового символа программа завершится с ошибкой.
Учитывая всю эту информацию, перепишем first_word так, чтобы она возвращала
срез. Тип, обозначающий «строковый срез», записывается как &str:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {}
Индекс конца слова получается так же, как в листинге 4-7, путём поиска первого вхождения пробела. Когда найден пробел, возвращается строковый срез, использующий начало строки и индекс пробела в качестве начального и конечного индексов.
Теперь при вызове first_word возвращается одно значение, привязанное к
базовым данным. Значение состоит из ссылки на начальную точку
среза и количества элементов в срезе.
Возврат среза также сработал бы для функции second_word:
fn second_word(s: &String) -> &str {Теперь есть простой в использовании API, который гораздо сложнее испортить, потому что
компилятор гарантирует, что ссылки на String останутся действительными.
Вспомним ошибку в программе из листинга 4-8, когда был получен индекс
конца первого слова, но затем строка была очищена, и индекс стал недействительным.
Тот код был логически некорректен, но не показывал немедленных ошибок. Проблемы
проявились бы позже, если бы продолжались попытки использовать индекс первого слова с
опустошённой строкой. Срезы делают эту ошибку невозможной и позволяют гораздо раньше узнать,
что в коде есть проблема. Использование версии first_word со срезом
вызовет ошибку времени компиляции:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s);

    s.clear(); // ошибка!

    println!("the first word is: {word}");
}
Вот ошибка компилятора:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
  --> src/main.rs:18:5
   |
16 |     let word = first_word(&s);
   |                           -- immutable borrow occurs here
17 |
18 |     s.clear(); // ошибка!
   |     ^^^^^^^^^ mutable borrow occurs here
19 |
20 |     println!("the first word is: {word}");
   |                                   ---- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Вспомним из правил заимствования, что если есть неизменяемая ссылка на
что-либо, нельзя также взять изменяемую ссылку. Поскольку clear нужно
обрезать String, требуется получить изменяемую ссылку. println!
после вызова clear использует ссылку в word, поэтому неизменяемая
ссылка должна оставаться активной в этой точке. Rust запрещает изменяемой
ссылке в clear и неизменяемой ссылке в word существовать одновременно, и компиляция
не удаётся. Rust не только сделал API проще в использовании,
но и устранил целый класс ошибок на этапе компиляции!
Строковые литералы как срезы
Вспомним, что строковые литералы хранятся внутри бинарного файла. Теперь, когда известно о срезах, можно правильно понять строковые литералы:
#![allow(unused)]
fn main() {
let s = "Hello, world!";
}
Тип s здесь — &str: это срез, указывающий на конкретную точку
бинарного файла. Именно поэтому строковые литералы неизменяемы; &str —
неизменяемая ссылка.
Строковые срезы как параметры
Знание того, что можно брать срезы от литералов и значений String, приводит к
ещё одному улучшению first_word, а именно к её сигнатуре:
fn first_word(s: &String) -> &str {Более опытный Rustacean написал бы сигнатуру, показанную в листинге 4-9,
потому что она позволяет использовать одну и ту же функцию как со значениями &String,
так и со значениями &str.
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` работает со срезами `String`, как частичными, так и целыми.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` также работает со ссылками на `String`, которые эквивалентны
    // целым срезам `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` работает со срезами строковых литералов, как частичными, так и
    // целыми.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Поскольку строковые литералы *являются* строковыми срезами,
    // это тоже работает, без синтаксиса среза!
    let word = first_word(my_string_literal);
}first_word путём использования строкового среза для типа параметра sЕсли есть строковый срез, его можно передать напрямую. Если есть String,
можно передать срез String или ссылку на String. Такая
гибкость использует преимущества разыменовывающего приведения типов — возможности, которая будет рассмотрена
в разделе «Использование разыменовывающего приведения типов в функциях и методах» главы 15.
Определение функции, принимающей строковый срез вместо ссылки на String,
делает API более общим и полезным без потери какой-либо функциональности:
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` работает со срезами `String`, как частичными, так и целыми.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` также работает со ссылками на `String`, которые эквивалентны
    // целым срезам `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` работает со срезами строковых литералов, как частичными, так и
    // целыми.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Поскольку строковые литералы *являются* строковыми срезами,
    // это тоже работает, без синтаксиса среза!
    let word = first_word(my_string_literal);
}
Другие срезы
Строковые срезы, как можно догадаться, специфичны для строк. Но есть и более общий тип среза. Рассмотрим этот массив:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];
}
Точно так же, как может потребоваться ссылаться на часть строки, может потребоваться ссылаться на часть массива. Это делается так:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];

let slice = &a[1..3];

assert_eq!(slice, &[2, 3]);
}
Этот срез имеет тип &[i32]. Он работает так же, как строковые срезы,
сохраняя ссылку на первый элемент и длину. Такой вид
среза используется для всевозможных других коллекций. Эти коллекции
подробно рассматриваются при обсуждении векторов в главе 8.
Итоги
Концепции владения, заимствования и срезов обеспечивают безопасность памяти в программах на Rust на этапе компиляции. Язык Rust даёт контроль над использованием памяти таким же образом, как и другие языки системного программирования. Но наличие автоматической очистки данных владельцем, когда владелец выходит из области видимости, означает, что не нужно писать и отлаживать дополнительный код для получения этого контроля.
Владение влияет на то, как работают многие другие части Rust, поэтому эти концепции
будут обсуждаться и далее на протяжении всей книги. Перейдём к
главе 5 и рассмотрим группировку фрагментов данных вместе в struct.
Использование структур для организации связанных данных
Использование структур для организации связанных данных
Структура (struct, или structure) — это пользовательский тип данных, который позволяет объединить и поименовать несколько связанных значений, составляющих значимую группу. Если вы знакомы с объектно-ориентированным языком, структура похожа на атрибуты данных объекта. В этой главе мы сравним кортежи со структурами, чтобы опереться на то, что вы уже знаете, и продемонстрировать, когда структуры — лучший способ группировки данных.
Мы продемонстрируем, как определять и создавать экземпляры структур. Мы обсудим, как определять ассоциированные функции, особенно тот их вид, который называется методами, чтобы задать поведение, связанное с типом структуры. Структуры и перечисления (обсуждаемые в главе 6) — это строительные блоки для создания новых типов в предметной области вашей программы, позволяющие в полной мере воспользоваться проверкой типов во время компиляции в Rust.
Определение и создание экземпляров структур
Определение и создание экземпляров структур
Структуры похожи на кортежи, обсуждавшиеся в разделе «Тип кортеж», тем, что обе содержат несколько связанных значений. Как и кортежи, части структуры могут иметь разные типы. В отличие от кортежей, в структуре вы даёте имя каждой части данных, чтобы было понятно, что означают значения. Добавление этих имён означает, что структуры более гибкие, чем кортежи: вам не нужно полагаться на порядок данных, чтобы указать или получить доступ к значениям экземпляра.
Чтобы определить структуру, мы вводим ключевое слово struct и даём имя всей структуре. Имя структуры должно описывать значение частей данных, которые группируются вместе. Затем внутри фигурных скобок мы определяем имена и типы частей данных, которые мы называем полями. Например, листинг 5-1 показывает структуру, которая хранит информацию об учётной записи пользователя.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {}UserЧтобы использовать структуру после того, как мы её определили, мы создаём экземпляр этой структуры, указывая конкретные значения для каждого из полей. Мы создаём экземпляр, указывая имя структуры и затем добавляя фигурные скобки, содержащие пары ключ: значение, где ключи — это имена полей, а значения — это данные, которые мы хотим сохранить в этих полях. Нам не нужно указывать поля в том же порядке, в котором мы их объявили в структуре. Другими словами, определение структуры — это как общий шаблон для типа, а экземпляры заполняют этот шаблон конкретными данными, создавая значения этого типа. Например, мы можем объявить конкретного пользователя, как показано в листинге 5-2.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    let user1 = User {
        active: true,
        username: String::from("someusername123"),
        email: String::from("someone@example.com"),
        sign_in_count: 1,
    };
}UserЧтобы получить конкретное значение из структуры, мы используем точечную нотацию. Например, чтобы получить доступ к адресу электронной почты этого пользователя, мы используем user1.email. Если экземпляр изменяемый, мы можем изменить значение, используя точечную нотацию и присваивая значение конкретному полю. Листинг 5-3 показывает, как изменить значение в поле email изменяемого экземпляра User.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    let mut user1 = User {
        active: true,
        username: String::from("someusername123"),
        email: String::from("someone@example.com"),
        sign_in_count: 1,
    };

    user1.email = String::from("anotheremail@example.com");
}email экземпляра UserОбратите внимание, что весь экземпляр должен быть изменяемым; Rust не позволяет нам помечать как изменяемые только определённые поля. Как и любое выражение, мы можем создать новый экземпляр структуры как последнее выражение в теле функции, чтобы неявно вернуть этот новый экземпляр.
Листинг 5-4 показывает функцию build_user, которая возвращает экземпляр User с заданными электронной почтой и именем пользователя. Поле active получает значение true, а sign_in_count получает значение 1.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn build_user(email: String, username: String) -> User {
    User {
        active: true,
        username: username,
        email: email,
        sign_in_count: 1,
    }
}

fn main() {
    let user1 = build_user(
        String::from("someone@example.com"),
        String::from("someusername123"),
    );
}build_user, которая принимает электронную почту и имя пользователя и возвращает экземпляр UserИмеет смысл называть параметры функции так же, как поля структуры, но повторять имена полей email и username и переменные немного утомительно. Если бы у структуры было больше полей, повторение каждого имени стало бы ещё более раздражающим. К счастью, есть удобное сокращение!
Использование сокращения инициализации полей
Поскольку имена параметров и имена полей структуры в листинге 5-4 в точности совпадают, мы можем использовать синтаксис сокращения инициализации полей, чтобы переписать build_user так, чтобы он вёл себя точно так же, но без повторения username и email, как показано в листинге 5-5.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn build_user(email: String, username: String) -> User {
    User {
        active: true,
        username,
        email,
        sign_in_count: 1,
    }
}

fn main() {
    let user1 = build_user(
        String::from("someone@example.com"),
        String::from("someusername123"),
    );
}build_user, использующая сокращение инициализации полей, поскольку параметры username и email имеют те же имена, что и поля структурыЗдесь мы создаём новый экземпляр структуры User, у которой есть поле с именем email. Мы хотим установить значение поля email в значение параметра email функции build_user. Поскольку поле email и параметр email имеют одинаковое имя, нам нужно написать только email, а не email: email.
Создание экземпляров с помощью синтаксиса обновления структуры
Часто бывает полезно создать новый экземпляр структуры, который включает большинство значений из другого экземпляра того же типа, но изменяет некоторые из них. Вы можете сделать это с помощью синтаксиса обновления структуры.
Сначала в листинге 5-6 мы показываем, как создать новый экземпляр User в user2 обычным способом, без синтаксиса обновления. Мы устанавливаем новое значение для email, но в остальном используем те же значения из user1, которые мы создали в листинге 5-2.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    // --snip--

    let user1 = User {
        email: String::from("someone@example.com"),
        username: String::from("someusername123"),
        active: true,
        sign_in_count: 1,
    };

    let user2 = User {
        active: user1.active,
        username: user1.username,
        email: String::from("another@example.com"),
        sign_in_count: user1.sign_in_count,
    };
}User с использованием всех, кроме одного, значений из user1Используя синтаксис обновления структуры, мы можем достичь того же эффекта с меньшим количеством кода, как показано в листинге 5-7. Синтаксис .. указывает, что оставшиеся поля, которые не заданы явно, должны иметь те же значения, что и поля в данном экземпляре.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    // --snip--

    let user1 = User {
        email: String::from("someone@example.com"),
        username: String::from("someusername123"),
        active: true,
        sign_in_count: 1,
    };

    let user2 = User {
        email: String::from("another@example.com"),
        ..user1
    };
}email для экземпляра User, но с использованием остальных значений из user1Код в листинге 5-7 также создаёт экземпляр в user2, который имеет другое значение для email, но те же значения для полей username, active и sign_in_count из user1. ..user1 должно идти последним, чтобы указать, что любые оставшиеся поля должны получить свои значения из соответствующих полей в user1, но мы можем указать значения для любого количества полей в любом порядке, независимо от порядка полей в определении структуры.
Обратите внимание, что синтаксис обновления структуры использует = как присваивание; это потому, что он перемещает данные, как мы видели в разделе «Взаимодействие переменных и данных при перемещении». В этом примере мы больше не можем использовать user1 после создания user2, потому что String в поле username из user1 был перемещён в user2. Если бы мы дали user2 новые значения String как для email, так и для username, и таким образом использовали бы только значения active и sign_in_count из user1, то user1 всё ещё был бы действителен после создания user2. И active, и sign_in_count — это типы, реализующие трейт Copy, поэтому применялось бы поведение, которое мы обсуждали в разделе «Данные только в стеке: Copy». В этом примере мы также всё ещё можем использовать user1.email, потому что его значение не было перемещено из user1.
Создание разных типов с помощью кортежных структур
Rust также поддерживает структуры, которые выглядят похоже на кортежи, называемые кортежными структурами. Кортежные структуры имеют дополнительное значение, которое обеспечивает имя структуры, но не имеют имён, связанных с их полями; вместо этого у них есть только типы полей. Кортежные структуры полезны, когда вы хотите дать всему кортежу имя и сделать кортеж типом, отличным от других кортежей, и когда именование каждого поля, как в обычной структуре, было бы многословным или избыточным.
Чтобы определить кортежную структуру, начните с ключевого слова struct и имени структуры, за которым следуют типы в кортеже. Например, здесь мы определяем и используем две кортежные структуры с именами Color и Point:
struct Color(i32, i32, i32);
struct Point(i32, i32, i32);

fn main() {
    let black = Color(0, 0, 0);
    let origin = Point(0, 0, 0);
}
Обратите внимание, что значения black и origin имеют разные типы, потому что они являются экземплярами разных кортежных структур. Каждая структура, которую вы определяете, является своим собственным типом, даже если поля внутри структуры могут иметь одинаковые типы. Например, функция, которая принимает параметр типа Color, не может принять Point в качестве аргумента, даже если оба типа состоят из трёх значений i32. В остальном экземпляры кортежных структур похожи на кортежи тем, что вы можете деструктурировать их на отдельные части, и вы можете использовать ., за которым следует индекс, для доступа к отдельному значению. В отличие от кортежей, кортежные структуры требуют, чтобы вы указали тип структуры при их деструктурировании. Например, мы бы написали let Point(x, y, z) = origin;, чтобы деструктурировать значения в origin в переменные с именами x, y и z.
Определение unit-подобных структур
Вы также можете определять структуры, у которых вообще нет полей! Они называются unit-подобными структурами, потому что ведут себя подобно (), unit-типу, который мы упоминали в разделе «Тип кортеж». Unit-подобные структуры могут быть полезны, когда вам нужно реализовать трейт для некоторого типа, но у вас нет данных, которые вы хотите хранить в самом типе. Мы обсудим трейты в главе 10. Вот пример объявления и создания экземпляра unit-структуры с именем AlwaysEqual:
struct AlwaysEqual;

fn main() {
    let subject = AlwaysEqual;
}
Чтобы определить AlwaysEqual, мы используем ключевое слово struct, нужное нам имя, а затем точку с запятой. Не нужны ни фигурные скобки, ни круглые скобки! Затем мы можем получить экземпляр AlwaysEqual в переменной subject аналогичным образом: используя определённое нами имя, без каких-либо фигурных скобок или круглых скобок. Представьте, что позже мы реализуем поведение для этого типа так, чтобы каждый экземпляр AlwaysEqual всегда был равен любому экземпляру любого другого типа, возможно, чтобы иметь известный результат для целей тестирования. Нам не понадобились бы никакие данные для реализации этого поведения! В главе 10 вы увидите, как определять трейты и реализовывать их для любого типа, включая unit-подобные структуры.
Владение данными структуры
В определении структуры User в листинге 5-1 мы использовали владеющий тип String, а не тип среза строки &str. Это осознанный выбор, потому что мы хотим, чтобы каждый экземпляр этой структуры владел всеми своими данными и чтобы эти данные были действительны до тех пор, пока действительна вся структура.
Также возможно, чтобы структуры хранили ссылки на данные, принадлежащие чему-то другому, но для этого требуется использование времён жизни, функции Rust, которую мы обсудим в главе 10. Времена жизни гарантируют, что данные, на которые ссылается структура, действительны до тех пор, пока действительна структура. Допустим, вы пытаетесь сохранить ссылку в структуре, не указывая времена жизни, как в следующем примере в src/main.rs; это не сработает:
struct User {
    active: bool,
    username: &str,
    email: &str,
    sign_in_count: u64,
}

fn main() {
    let user1 = User {
        active: true,
        username: "someusername123",
        email: "someone@example.com",
        sign_in_count: 1,
    };
}
Компилятор пожалуется, что ему нужны спецификаторы времени жизни:
$ cargo run
   Compiling structs v0.1.0 (file:///projects/structs)
error[E0106]: missing lifetime specifier
 --> src/main.rs:3:15
  |
3 |     username: &str,
  |               ^ expected named lifetime parameter
  |
help: consider introducing a named lifetime parameter
  |
1 ~ struct User<'a> {
2 |     active: bool,
3 ~     username: &'a str,
  |

error[E0106]: missing lifetime specifier
 --> src/main.rs:4:12
  |
4 |     email: &str,
  |            ^ expected named lifetime parameter
  |
help: consider introducing a named lifetime parameter
  |
1 ~ struct User<'a> {
2 |     active: bool,
3 |     username: &str,
4 ~     email: &'a str,
  |

For more information about this error, try `rustc --explain E0106`.
error: could not compile `structs` (bin "structs") due to 2 previous errors
В главе 10 мы обсудим, как исправить эти ошибки, чтобы вы могли хранить ссылки в структурах, но пока мы будем исправлять подобные ошибки, используя владеющие типы, такие как String, вместо ссылок, таких как &str.
Пример программы, использующей структуры
Пример программы, использующей структуры
Чтобы понять, когда может понадобиться использовать структуры, напишем программу, которая вычисляет площадь прямоугольника. Мы начнём с использования отдельных переменных, а затем будем рефакторить программу до тех пор, пока не начнём использовать структуры.
Создадим новый бинарный проект с помощью Cargo под названием rectangles, который будет принимать ширину и высоту прямоугольника, заданные в пикселях, и вычислять площадь прямоугольника. Листинг 5-8 показывает короткую программу с одним из способов сделать это в файле src/main.rs нашего проекта.
fn main() {
    let width1 = 30;
    let height1 = 50;

    println!(
        "The area of the rectangle is {} square pixels.",
        area(width1, height1)
    );
}

fn area(width: u32, height: u32) -> u32 {
    width * height
}Теперь запустим эту программу с помощью cargo run:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.42s
     Running `target/debug/rectangles`
The area of the rectangle is 1500 square pixels.
Этот код успешно вычисляет площадь прямоугольника, вызывая функцию area с каждым измерением, но можно сделать больше, чтобы сделать код ясным и читаемым.
Проблема этого кода очевидна в сигнатуре area:
fn main() {
    let width1 = 30;
    let height1 = 50;

    println!(
        "The area of the rectangle is {} square pixels.",
        area(width1, height1)
    );
}

fn area(width: u32, height: u32) -> u32 {
    width * height
}
Функция area должна вычислять площадь одного прямоугольника, но написанная нами функция имеет два параметра, и нигде в нашей программе не ясно, что параметры связаны. Было бы более читаемым и управляемым объединить ширину и высоту вместе. Мы уже обсуждали один способ сделать это в разделе «Тип кортеж» главы 3: используя кортежи.
Рефакторинг с помощью кортежей
Листинг 5-9 показывает другую версию нашей программы, использующую кортежи.
fn main() {
    let rect1 = (30, 50);

    println!(
        "The area of the rectangle is {} square pixels.",
        area(rect1)
    );
}

fn area(dimensions: (u32, u32)) -> u32 {
    dimensions.0 * dimensions.1
}В одном смысле эта программа лучше. Кортежи позволяют добавить немного структуры, и теперь мы передаём только один аргумент. Но в другом смысле эта версия менее ясна: кортежи не именуют свои элементы, поэтому приходится индексировать части кортежа, что делает вычисление менее очевидным.
Перепутать ширину и высоту не имело бы значения для вычисления площади, но если мы хотим нарисовать прямоугольник на экране, это было бы важно! Нам пришлось бы помнить, что width — это индекс кортежа 0, а height — индекс кортежа 1. Это было бы ещё сложнее для кого-то другого, кто попытался бы разобраться и запомнить, если бы он использовал наш код. Поскольку мы не передали смысл наших данных в коде, теперь легче внести ошибки.
Рефакторинг с помощью структур
Мы используем структуры, чтобы добавить смысл, помечая данные. Мы можем преобразовать кортеж, который используем, в структуру с именем для целого, а также с именами для частей, как показано в листинге 5-10.
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!(
        "The area of the rectangle is {} square pixels.",
        area(&rect1)
    );
}

fn area(rectangle: &Rectangle) -> u32 {
    rectangle.width * rectangle.height
}RectangleЗдесь мы определили структуру и назвали её Rectangle. Внутри фигурных скобок мы определили поля как width и height, оба типа u32. Затем в main мы создали конкретный экземпляр Rectangle с шириной 30 и высотой 50.
Наша функция area теперь определена с одним параметром, который мы назвали rectangle, тип которого — неизменяемое заимствование экземпляра структуры Rectangle. Как упоминалось в главе 4, мы хотим заимствовать структуру, а не брать её во владение. Таким образом, main сохраняет своё владение и может продолжать использовать rect1, и именно поэтому мы используем & в сигнатуре функции и в месте вызова функции.
Функция area обращается к полям width и height экземпляра Rectangle (обратите внимание, что доступ к полям заимствованного экземпляра структуры не перемещает значения полей, поэтому вы часто видите заимствования структур). Наша сигнатура функции для area теперь говорит именно то, что мы имеем в виду: вычислить площадь Rectangle, используя его поля width и height. Это передаёт, что ширина и высота связаны друг с другом, и даёт описательные имена значениям вместо использования значений индексов кортежа 0 и 1. Это победа в ясности.
Добавление функциональности с помощью производных трейтов
Было бы полезно иметь возможность печатать экземпляр Rectangle во время отладки нашей программы и видеть значения всех его полей. Листинг 5-11 пытается использовать макрос println!, как мы использовали в предыдущих главах. Однако это не сработает.
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!("rect1 is {rect1}");
}RectangleКогда мы компилируем этот код, мы получаем ошибку с основным сообщением:
error[E0277]: `Rectangle` doesn't implement `std::fmt::Display`
Макрос println! может выполнять много видов форматирования, и по умолчанию фигурные скобки говорят println! использовать форматирование, известное как Display: вывод, предназначенный для непосредственного потребления конечным пользователем. Примитивные типы, которые мы видели до сих пор, реализуют Display по умолчанию, потому что есть только один способ, которым вы хотели бы показать 1 или любой другой примитивный тип пользователю. Но со структурами способ, которым println! должен форматировать вывод, менее ясен, потому что есть больше возможностей отображения: нужны ли запятые или нет? Хотите ли вы напечатать фигурные скобки? Должны ли быть показаны все поля? Из-за этой неоднозначности Rust не пытается угадать, что мы хотим, и структуры не имеют предоставленной реализации Display для использования с println! и заполнителем {}.
Если мы продолжим читать ошибки, мы найдём эту полезную заметку:
help: the trait `std::fmt::Display` is not implemented for `Rectangle`
  --> src/main.rs:1:1
Давайте попробуем! Вызов макроса println! теперь будет выглядеть так: println!("rect1 is {rect1:?}");. Размещение спецификатора :? внутри фигурных скобок говорит println!, что мы хотим использовать формат вывода под названием Debug. Трейт Debug позволяет нам печатать нашу структуру способом, полезным для разработчиков, чтобы мы могли видеть её значение во время отладки нашего кода.
Скомпилируйте код с этим изменением. Чёрт! Мы всё ещё получаем ошибку:
error[E0277]: `Rectangle` doesn't implement `Debug`
Но опять же, компилятор даёт нам полезную заметку:
   |                        required by this formatting parameter
   |
Rust действительно включает функциональность для печати отладочной информации, но мы должны явно включить её, чтобы сделать эту функциональность доступной для нашей структуры. Для этого мы добавляем внешний атрибут #[derive(Debug)] непосредственно перед определением структуры, как показано в листинге 5-12.
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!("rect1 is {rect1:?}");
}Debug и печать экземпляра Rectangle с использованием отладочного форматированияТеперь, когда мы запускаем программу, мы не получим никаких ошибок, и мы увидим следующий вывод:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
     Running `target/debug/rectangles`
rect1 is Rectangle { width: 30, height: 50 }
Отлично! Это не самый красивый вывод, но он показывает значения всех полей для этого экземпляра, что определённо помогло бы при отладке. Когда у нас есть более крупные структуры, полезно иметь вывод, который немного легче читать; в таких случаях мы можем использовать {:#?} вместо {:?} в строке println!. В этом примере использование стиля {:#?} выведет следующее:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
     Running `target/debug/rectangles`
rect1 is Rectangle {
    width: 30,
    height: 50,
}
Другой способ напечатать значение с использованием формата Debug — использовать макрос dbg!, который принимает владение выражением (в отличие от println!, который принимает ссылку), печатает имя файла и номер строки, где происходит вызов макроса dbg! в вашем коде, вместе с результирующим значением этого выражения, и возвращает владение значением.
Примечание: Вызов макроса dbg! печатает в стандартный поток консоли ошибок (stderr), в отличие от println!, который печатает в стандартный поток консоли вывода (stdout). Мы поговорим больше о stderr и stdout в разделе «Перенаправление ошибок в стандартный поток ошибок» главы 12.
Вот пример, где нас интересует значение, которое присваивается полю width, а также значение всей структуры в rect1:
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let scale = 2;
    let rect1 = Rectangle {
        width: dbg!(30 * scale),
        height: 50,
    };

    dbg!(&rect1);
}
Мы можем поместить dbg! вокруг выражения 30 * scale и, поскольку dbg! возвращает владение значением выражения, поле width получит то же значение, как если бы у нас не было вызова dbg! там. Мы не хотим, чтобы dbg! брал владение rect1, поэтому мы используем ссылку на rect1 в следующем вызове. Вот как выглядит вывод этого примера:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.61s
     Running `target/debug/rectangles`
[src/main.rs:10:16] 30 * scale = 60
[src/main.rs:14:5] &rect1 = Rectangle {
    width: 60,
    height: 50,
}
Мы видим, что первый фрагмент вывода пришёл из src/main.rs, строка 10, где мы отлаживаем выражение 30 * scale, и его результирующее значение равно 60 (форматирование Debug, реализованное для целых чисел, заключается в печати только их значения). Вызов dbg! в строке 14 файла src/main.rs выводит значение &rect1, которое является структурой Rectangle. Этот вывод использует красивое форматирование Debug типа Rectangle. Макрос dbg! может быть действительно полезен, когда вы пытаетесь понять, что делает ваш код!
В дополнение к трейту Debug, Rust предоставил ряд трейтов для использования с атрибутом derive, которые могут добавить полезное поведение нашим пользовательским типам. Эти трейты и их поведение перечислены в Приложении C. Мы рассмотрим, как реализовать эти трейты с пользовательским поведением, а также как создавать свои собственные трейты в главе 10. Существует также много атрибутов, помимо derive; для получения дополнительной информации см. раздел «Атрибуты» справочника Rust.
Наша функция area очень специфична: она вычисляет только площадь прямоугольников. Было бы полезно связать это поведение более тесно с нашей структурой Rectangle, потому что оно не будет работать с любым другим типом. Давайте посмотрим, как мы можем продолжить рефакторинг этого кода, превратив функцию area в метод area, определённый для нашего типа Rectangle.
Методы
Методы
Методы похожи на функции: они объявляются с помощью ключевого слова fn и
имени, могут иметь параметры и возвращаемое значение, и содержат код,
который выполняется, когда метод вызывается откуда-либо. В отличие от функций,
методы определяются в контексте структуры (или перечисления, или трейт-объекта,
которые рассматриваются в главе 6 и главе
18 соответственно), и их первый параметр
всегда — self, который представляет экземпляр структуры, для которого
вызывается метод.
Синтаксис методов
Изменим функцию area, которая принимает экземпляр Rectangle в качестве параметра,
и вместо неё сделаем метод area, определённый на структуре Rectangle, как показано
в листинге 5-13.
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

impl Rectangle {
    fn area(&self) -> u32 {
        self.width * self.height
    }
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!(
        "The area of the rectangle is {} square pixels.",
        rect1.area()
    );
}area на структуре RectangleЧтобы определить функцию в контексте Rectangle, мы начинаем блок impl
(реализации) для Rectangle. Всё внутри этого блока impl
будет связано с типом Rectangle. Затем мы перемещаем функцию area
внутрь фигурных скобок impl и меняем первый (в данном случае единственный)
параметр на self в сигнатуре и везде в теле. В
main, где мы вызывали функцию area и передавали rect1 в качестве аргумента,
мы можем вместо этого использовать синтаксис методов, чтобы вызвать метод area на экземпляре Rectangle.
Синтаксис методов ставится после экземпляра: мы добавляем точку, за которой следует
имя метода, круглые скобки и любые аргументы.
В сигнатуре area мы используем &self вместо rectangle: &Rectangle.
&self на самом деле сокращение для self: &Self. Внутри блока impl
тип Self является псевдонимом для типа, к которому относится блок impl. Методы должны
иметь параметр с именем self типа Self в качестве первого параметра, поэтому Rust
позволяет сократить это, указав только имя self на месте первого параметра.
Обратите внимание, что по-прежнему нужно использовать & перед сокращением self, чтобы
указать, что этот метод заимствует экземпляр Self, так же как мы делали в
rectangle: &Rectangle. Методы могут брать владение self, заимствовать self
неизменяемо, как мы сделали здесь, или заимствовать self изменяемо, как и любой
другой параметр.
Мы выбрали &self здесь по той же причине, по которой использовали &Rectangle в функциональной
версии: мы не хотим брать владение и просто хотим прочитать данные в
структуре, а не записывать в них. Если бы мы хотели изменить экземпляр, на котором
вызван метод, как часть того, что делает метод, мы бы использовали &mut self в
качестве первого параметра. Метод, который берёт владение экземпляром,
используя просто self в качестве первого параметра, встречается редко; этот приём обычно
применяется, когда метод преобразует self во что-то другое, и нужно
запретить вызывающей стороне использовать исходный экземпляр после преобразования.
Основная причина использовать методы вместо функций, помимо
предоставления синтаксиса методов и отсутствия необходимости повторять тип self в каждой
сигнатуре метода, — это организация. Мы поместили всё, что можно сделать
с экземпляром типа, в один блок impl, а не заставляем будущих пользователей
нашего кода искать возможности Rectangle в разных местах
предоставляемой нами библиотеки.
Обратите внимание, что можно дать методу то же имя, что и одному из полей структуры.
Например, можно определить на Rectangle метод, который также называется
width:
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

impl Rectangle {
    fn width(&self) -> bool {
        self.width > 0
    }
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    if rect1.width() {
        println!("The rectangle has a nonzero width; it is {}", rect1.width);
    }
}
Здесь мы решили сделать так, чтобы метод width возвращал true, если значение в
поле width экземпляра больше 0, и false, если значение равно
0: мы можем использовать поле внутри метода с тем же именем для любых целей. В
main, когда мы ставим круглые скобки после rect1.width, Rust понимает, что имеется в виду
метод width. Когда мы не используем круглые скобки, Rust понимает, что имеется в виду поле
width.
Часто, но не всегда, когда мы даём методу то же имя, что и полю, мы хотим, чтобы он только возвращал значение поля и ничего больше не делал. Такие методы называются геттерами, и Rust не реализует их автоматически для полей структур, как это делают некоторые другие языки. Геттеры полезны тем, что можно сделать поле приватным, а метод публичным и таким образом обеспечить доступ только для чтения к этому полю как часть публичного API типа. Мы обсудим, что такое публичное и приватное и как обозначить поле или метод как публичный или приватный, в главе 7.
Где оператор ->?
В C и C++ для вызова методов используются два разных оператора: .
используется, если метод вызывается непосредственно на объекте, а -> —
если метод вызывается на указателе на объект и нужно сначала разыменовать
указатель. Другими словами, если object — указатель,
object->something() аналогично (*object).something().
В Rust нет эквивалента оператора ->; вместо этого в Rust есть
возможность, называемая автоматическим заимствованием и разыменованием. Вызов методов —
одно из немногих мест в Rust с таким поведением.
Вот как это работает: когда метод вызывается с помощью object.something(), Rust
автоматически добавляет &, &mut или *, чтобы object соответствовал
сигнатуре метода. Другими словами, следующие вызовы эквивалентны:
#![allow(unused)]
fn main() {
#[derive(Debug,Copy,Clone)]
struct Point {
    x: f64,
    y: f64,
}

impl Point {
   fn distance(&self, other: &Point) -> f64 {
       let x_squared = f64::powi(other.x - self.x, 2);
       let y_squared = f64::powi(other.y - self.y, 2);

       f64::sqrt(x_squared + y_squared)
   }
}
let p1 = Point { x: 0.0, y: 0.0 };
let p2 = Point { x: 5.0, y: 6.5 };
p1.distance(&p2);
(&p1).distance(&p2);
}
Первый вариант выглядит намного чище. Это поведение автоматического заимствования работает
потому, что методы имеют явного получателя — тип self. Зная
получателя и имя метода, Rust может точно определить, читает ли метод
(&self), изменяет (&mut self) или потребляет (self). Тот факт,
что Rust делает заимствование для получателей методов неявным, — важная часть
того, что делает владение эргономичным на практике.
Методы с несколькими параметрами
Попрактикуемся в использовании методов, реализовав второй метод на структуре Rectangle.
На этот раз мы хотим, чтобы экземпляр Rectangle принимал другой экземпляр
Rectangle и возвращал true, если второй Rectangle может полностью поместиться
внутри self (первого Rectangle); в противном случае он должен вернуть false.
То есть, после того как мы определим метод can_hold, мы хотим иметь возможность написать
программу, показанную в листинге 5-14.
fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };
    let rect2 = Rectangle {
        width: 10,
        height: 40,
    };
    let rect3 = Rectangle {
        width: 60,
        height: 45,
    };

    println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
    println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}can_holdОжидаемый вывод будет выглядеть следующим образом, поскольку оба размера
rect2 меньше размеров rect1, но rect3 шире, чем
rect1:
Can rect1 hold rect2? true
Can rect1 hold rect3? false
Мы знаем, что хотим определить метод, поэтому он будет внутри блока impl Rectangle.
Имя метода будет can_hold, и он будет принимать неизменяемое заимствование
другого Rectangle в качестве параметра. Мы можем определить тип
параметра, посмотрев на код, который вызывает метод:
rect1.can_hold(&rect2) передаёт &rect2, что является неизменяемым заимствованием
rect2, экземпляра Rectangle. Это имеет смысл, потому что нам нужно только
читать rect2 (а не записывать, что означало бы необходимость изменяемого заимствования),
и мы хотим, чтобы main сохранял владение rect2, чтобы можно было использовать его снова
после вызова метода can_hold. Возвращаемое значение can_hold будет
логическим, а реализация проверит, больше ли ширина и высота
self, чем ширина и высота другого Rectangle,
соответственно. Добавим новый метод can_hold в блок impl из
листинга 5-13, как показано в листинге 5-15.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn area(&self) -> u32 {
self.width * self.height
}
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
fn main() {
let rect1 = Rectangle {
width: 30,
height: 50,
};
let rect2 = Rectangle {
width: 10,
height: 40,
};
let rect3 = Rectangle {
width: 60,
height: 45,
};
println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}can_hold на Rectangle, принимающего другой экземпляр Rectangle в качестве параметраКогда мы запустим этот код с функцией main из листинга 5-14, мы получим
желаемый вывод. Методы могут принимать несколько параметров, которые добавляются в
сигнатуру после параметра self, и эти параметры работают так же, как
параметры в функциях.
Ассоциированные функции
Все функции, определённые внутри блока impl, называются ассоциированными функциями,
потому что они связаны с типом, указанным после impl. Можно определять
ассоциированные функции, у которых нет self в качестве первого параметра (и которые, таким образом,
не являются методами), потому что им не нужен экземпляр типа для работы.
Мы уже использовали одну такую функцию: функцию String::from, которая
определена на типе String.
Ассоциированные функции, которые не являются методами, часто используются для конструкторов, которые
возвращают новый экземпляр структуры. Их часто называют new, но
new не является специальным именем и не встроено в язык. Например, мы
могли бы предоставить ассоциированную функцию с именем square, которая имела бы
один параметр размера и использовала бы его как ширину и высоту, что делает
создание квадратного Rectangle проще, чем указание одного и того же
значения дважды:
Имя файла: src/main.rs
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn square(size: u32) -> Self {
Self {
width: size,
height: size,
}
}
}
fn main() {
let sq = Rectangle::square(3);
}Ключевые слова Self в возвращаемом типе и в теле функции являются
псевдонимами для типа, который указан после ключевого слова impl, в данном случае
это Rectangle.
Чтобы вызвать эту ассоциированную функцию, мы используем синтаксис :: с именем структуры;
let sq = Rectangle::square(3); — пример. Эта функция находится в пространстве имён
структуры: синтаксис :: используется как для ассоциированных функций, так и для
пространств имён, создаваемых модулями. Мы обсудим модули в главе
7.
Несколько блоков impl
Каждая структура может иметь несколько блоков impl. Например, листинг
5-15 эквивалентен коду, показанному в листинге 5-16, в котором каждый метод находится в
своём собственном блоке impl.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn area(&self) -> u32 {
self.width * self.height
}
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
fn main() {
let rect1 = Rectangle {
width: 30,
height: 50,
};
let rect2 = Rectangle {
width: 10,
height: 40,
};
let rect3 = Rectangle {
width: 60,
height: 45,
};
println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}implЗдесь нет причины разделять эти методы на несколько блоков impl,
но это допустимый синтаксис. Мы увидим случай, в котором несколько блоков impl
полезны, в главе 10, где обсуждаются обобщённые типы и трейты.
Итоги
Структуры позволяют создавать пользовательские типы, которые имеют смысл для вашей предметной области.
Используя структуры, можно держать связанные части данных соединёнными друг с другом
и давать имя каждой части, чтобы сделать код понятным. В блоках impl можно определять
функции, связанные с вашим типом, а методы — это разновидность
ассоциированных функций, которые позволяют задать поведение, присущее экземплярам ваших
структур.
Но структуры — не единственный способ создавать пользовательские типы: обратимся к возможности перечислений в Rust, чтобы добавить ещё один инструмент в ваш арсенал.
Перечисления и сопоставление с образцом
Перечисления и сопоставление с образцом
В этой главе мы рассмотрим перечисления, также называемые enum (от англ. enumeration). Перечисления позволяют определить тип, перечисляя его возможные варианты. Сначала мы определим и используем перечисление, чтобы показать, как перечисление может кодировать смысл вместе с данными. Затем мы исследуем особенно полезное перечисление под названием Option, которое выражает, что значение может быть либо чем-то, либо ничем. После этого мы рассмотрим, как сопоставление с образцом в выражении match упрощает выполнение различного кода для разных значений перечисления. Наконец, мы рассмотрим, как конструкция if let является ещё одной удобной и лаконичной идиомой, доступной для работы с перечислениями в вашем коде.
Определение перечисления
Определение перечисления
Если структуры дают вам способ группировать связанные поля и данные вместе, например, Rectangle с его width и height, то перечисления дают вам способ сказать, что значение является одним из возможного набора значений. Например, мы можем захотеть сказать, что Rectangle — это одна из возможных фигур, которая также включает Circle и Triangle. Для этого Rust позволяет нам закодировать эти возможности в виде перечисления.
Давайте рассмотрим ситуацию, которую мы могли бы захотеть выразить в коде, и посмотрим, почему перечисления полезны и более уместны, чем структуры, в этом случае. Допустим, нам нужно работать с IP-адресами. В настоящее время используются два основных стандарта для IP-адресов: версия четыре и версия шесть. Поскольку это единственные возможности для IP-адреса, с которыми столкнётся наша программа, мы можем перечислить все возможные варианты, откуда и происходит название «перечисление».
Любой IP-адрес может быть либо адресом версии четыре, либо адресом версии шесть, но не обоими одновременно. Это свойство IP-адресов делает структуру данных перечисления подходящей, потому что значение перечисления может быть только одним из его вариантов. И адреса версии четыре, и версии шесть по-прежнему принципиально являются IP-адресами, поэтому они должны рассматриваться как один и тот же тип, когда код имеет дело с ситуациями, применимыми к любому виду IP-адреса.
Мы можем выразить эту концепцию в коде, определив перечисление IpAddrKind и перечислив возможные виды, которые может иметь IP-адрес: V4 и V6. Это варианты перечисления:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}Теперь IpAddrKind — это пользовательский тип данных, который мы можем использовать в другом месте нашего кода.
Значения перечисления
Мы можем создать экземпляры каждого из двух вариантов IpAddrKind следующим образом:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}Обратите внимание, что варианты перечисления находятся в пространстве имён под его идентификатором, и мы используем двойное двоеточие для разделения двух. Это полезно, потому что теперь оба значения IpAddrKind::V4 и IpAddrKind::V6 имеют один и тот же тип: IpAddrKind. Затем мы можем, например, определить функцию, которая принимает любой IpAddrKind:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}И мы можем вызвать эту функцию с любым вариантом:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}Использование перечислений имеет ещё больше преимуществ. Подумав подробнее о нашем типе IP-адреса, в настоящее время у нас нет способа хранить фактические данные IP-адреса; мы знаем только, какого вида он. Учитывая, что вы только что узнали о структурах в главе 5, вас может соблазнить решить эту проблему с помощью структур, как показано в листинге 6-1.
fn main() {
enum IpAddrKind {
V4,
V6,
}
struct IpAddr {
kind: IpAddrKind,
address: String,
}
let home = IpAddr {
kind: IpAddrKind::V4,
address: String::from("127.0.0.1"),
};
let loopback = IpAddr {
kind: IpAddrKind::V6,
address: String::from("::1"),
};
}IpAddrKind IP-адреса с использованием structЗдесь мы определили структуру IpAddr, которая имеет два поля: поле kind типа IpAddrKind (перечисление, которое мы определили ранее) и поле address типа String. У нас есть два экземпляра этой структуры. Первый — home, и он имеет значение IpAddrKind::V4 в качестве своего kind со связанными данными адреса 127.0.0.1. Второй экземпляр — loopback. Он имеет другой вариант IpAddrKind в качестве своего значения kind, V6, и имеет адрес ::1, связанный с ним. Мы использовали структуру, чтобы объединить значения kind и address вместе, так что теперь вариант связан со значением.
Однако представление той же концепции с использованием только перечисления более кратко: вместо перечисления внутри структуры мы можем поместить данные непосредственно в каждый вариант перечисления. Это новое определение перечисления IpAddr говорит, что оба варианта, V4 и V6, будут иметь связанные значения String:
fn main() {
enum IpAddr {
V4(String),
V6(String),
}
let home = IpAddr::V4(String::from("127.0.0.1"));
let loopback = IpAddr::V6(String::from("::1"));
}Мы прикрепляем данные к каждому варианту перечисления напрямую, так что нет необходимости в дополнительной структуре. Здесь также легче увидеть другую деталь того, как работают перечисления: имя каждого варианта перечисления, которое мы определяем, также становится функцией, которая создаёт экземпляр перечисления. То есть IpAddr::V4() — это вызов функции, который принимает аргумент String и возвращает экземпляр типа IpAddr. Мы автоматически получаем эту функцию-конструктор, определённую в результате определения перечисления.
Есть ещё одно преимущество использования перечисления вместо структуры: каждый вариант может иметь разные типы и объёмы связанных данных. IP-адреса версии четыре всегда будут иметь четыре числовых компонента со значениями от 0 до 255. Если бы мы хотели хранить адреса V4 как четыре значения u8, но по-прежнему выражать адреса V6 как одно значение String, мы не смогли бы сделать это со структурой. Перечисления легко справляются с этим случаем:
fn main() {
enum IpAddr {
V4(u8, u8, u8, u8),
V6(String),
}
let home = IpAddr::V4(127, 0, 0, 1);
let loopback = IpAddr::V6(String::from("::1"));
}Мы показали несколько различных способов определения структур данных для хранения IP-адресов версии четыре и версии шесть. Однако, как оказалось, желание хранить IP-адреса и кодировать, какого они вида, настолько распространено, что стандартная библиотека имеет определение, которое мы можем использовать! Давайте посмотрим, как стандартная библиотека определяет IpAddr. У неё есть точно такое же перечисление и варианты, которые мы определили и использовали, но она встраивает данные адреса внутрь вариантов в форме двух разных структур, которые определяются по-разному для каждого варианта:
#![allow(unused)]
fn main() {
struct Ipv4Addr {
// --snip--
}
struct Ipv6Addr {
// --snip--
}
enum IpAddr {
V4(Ipv4Addr),
V6(Ipv6Addr),
}
}Этот код иллюстрирует, что вы можете поместить любой вид данных внутрь варианта перечисления: строки, числовые типы или структуры, например. Вы даже можете включить другое перечисление! Кроме того, типы стандартной библиотеки часто не намного сложнее того, что вы могли бы придумать сами.
Обратите внимание, что даже несмотря на то, что стандартная библиотека содержит определение для IpAddr, мы всё ещё можем создавать и использовать наше собственное определение без конфликта, потому что мы не привнесли определение стандартной библиотеки в нашу область видимости. Мы поговорим подробнее о привнесении типов в область видимости в главе 7.
Давайте рассмотрим другой пример перечисления в листинге 6-2: у этого есть большое разнообразие типов, встроенных в его варианты.
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {}Message, варианты которого хранят различные объёмы и типы значенийЭто перечисление имеет четыре варианта с разными типами:
Quit: не имеет связанных данных вообщеMove: имеет именованные поля, как структураWrite: включает однуStringChangeColor: включает три значенияi32
Определение перечисления с вариантами, подобными тем, что в листинге 6-2, похоже на определение различных видов определений структур, за исключением того, что перечисление не использует ключевое слово struct, и все варианты группируются вместе под типом Message. Следующие структуры могли бы содержать те же данные, что и предшествующие варианты перечисления:
struct QuitMessage; // единичная структура
struct MoveMessage {
x: i32,
y: i32,
}
struct WriteMessage(String); // кортежная структура
struct ChangeColorMessage(i32, i32, i32); // кортежная структура
fn main() {}Но если бы мы использовали разные структуры, каждая из которых имеет свой собственный тип, мы не смогли бы так же легко определить функцию, которая принимает любой из этих видов сообщений, как мы могли бы с перечислением Message, определённым в листинге 6-2, которое является единым типом.
Есть ещё одно сходство между перечислениями и структурами: точно так же, как мы можем определять методы для структур с помощью impl, мы также можем определять методы для перечислений. Вот метод с именем call, который мы могли бы определить для нашего перечисления Message:
fn main() {
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
impl Message {
fn call(&self) {
// здесь было бы определено тело метода
}
}
let m = Message::Write(String::from("hello"));
m.call();
}Тело метода использовало бы self, чтобы получить значение, для которого мы вызвали метод. В этом примере мы создали переменную m, которая имеет значение Message::Write(String::from("hello")), и именно это self будет в теле метода call, когда выполняется m.call().
Давайте рассмотрим другое перечисление в стандартной библиотеке, которое очень распространено и полезно: Option.
Перечисление Option
В этом разделе исследуется пример Option, которое является ещё одним перечислением, определённым стандартной библиотекой. Тип Option кодирует очень распространённый сценарий, в котором значение может быть чем-то или может быть ничем.
Например, если вы запрашиваете первый элемент в непустом списке, вы получите значение. Если вы запрашиваете первый элемент в пустом списке, вы получите ничего. Выражение этой концепции в терминах системы типов означает, что компилятор может проверить, обработали ли вы все случаи, которые должны обрабатываться; эта функциональность может предотвратить ошибки, которые чрезвычайно распространены в других языках программирования.
Дизайн языка программирования часто рассматривается в терминах того, какие функции вы включаете, но функции, которые вы исключаете, тоже важны. В Rust нет функции null, которая есть во многих других языках. Null — это значение, которое означает, что там нет значения. В языках с null переменные всегда могут находиться в одном из двух состояний: null или не-null.
В своей презентации 2009 года «Null References: The Billion Dollar Mistake» Тони Хоар, изобретатель null, сказал следующее:
Я называю это своей ошибкой на миллиард долларов. В то время я проектировал первую всеобъемлющую систему типов для ссылок в объектно-ориентированном языке. Моей целью было обеспечить абсолютную безопасность всех использований ссылок, с проверкой, выполняемой автоматически компилятором. Но я не смог устоять перед искушением добавить нулевую ссылку, просто потому, что это было так легко реализовать. Это привело к бесчисленным ошибкам, уязвимостям и системным сбоям, которые, вероятно, причинили миллиард долларов боли и ущерба за последние сорок лет.
Проблема с нулевыми значениями заключается в том, что если вы попытаетесь использовать нулевое значение как ненулевое, вы получите ошибку того или иного рода. Поскольку это свойство null или не-null повсеместно, очень легко допустить такого рода ошибку.
Однако концепция, которую пытается выразить null, всё ещё полезна: null — это значение, которое в настоящее время недействительно или отсутствует по какой-то причине.
Проблема на самом деле не в концепции, а в конкретной реализации. Как таковая, Rust не имеет null, но у него есть перечисление, которое может кодировать концепцию присутствия или отсутствия значения. Это перечисление — Option<T>, и оно определено стандартной библиотекой следующим образом:
#![allow(unused)]
fn main() {
enum Option<T> {
None,
Some(T),
}
}Перечисление Option<T> настолько полезно, что оно даже включено в prelude; вам не нужно явно привносить его в область видимости. Его варианты также включены в prelude: вы можете использовать Some и None напрямую без префикса Option::. Перечисление Option<T> по-прежнему является обычным перечислением, а Some(T) и None по-прежнему являются вариантами типа Option<T>.
Синтаксис <T> — это функция Rust, о которой мы ещё не говорили. Это параметр обобщённого типа, и мы рассмотрим обобщения более подробно в главе 10. Пока всё, что вам нужно знать, это то, что <T> означает, что вариант Some перечисления Option может содержать один фрагмент данных любого типа, и что каждый конкретный тип, используемый вместо T, делает общий тип Option<T> другим типом. Вот несколько примеров использования значений Option для хранения числовых типов и типов char:
fn main() {
let some_number = Some(5);
let some_char = Some('e');
let absent_number: Option<i32> = None;
}Тип some_number — Option<i32>. Тип some_char — Option<char>, что является другим типом. Rust может вывести эти типы, потому что мы указали значение внутри варианта Some. Для absent_number Rust требует, чтобы мы аннотировали общий тип Option: компилятор не может вывести тип, который будет содержать соответствующий вариант Some, только глядя на значение None. Здесь мы сообщаем Rust, что подразумеваем, что absent_number будет типа Option<i32>.
Когда у нас есть значение Some, мы знаем, что значение присутствует, и значение содержится внутри Some. Когда у нас есть значение None, в некотором смысле это означает то же самое, что null: у нас нет действительного значения. Так почему же наличие Option<T> лучше, чем наличие null?
Короче говоря, потому что Option<T> и T (где T может быть любым типом) — это разные типы, компилятор не позволит нам использовать значение Option<T> так, как если бы оно определенно было действительным значением. Например, этот код не скомпилируется, потому что пытается добавить i8 к Option<i8>:
fn main() {
let x: i8 = 5;
let y: Option<i8> = Some(5);
let sum = x + y;
}Если мы запустим этот код, мы получим сообщение об ошибке, подобное этому:
$ cargo run
Compiling enums v0.1.0 (file:///projects/enums)
error[E0277]: cannot add `Option<i8>` to `i8`
--> src/main.rs:5:17
|
5 | let sum = x + y;
| ^ no implementation for `i8 + Option<i8>`
|
= help: the trait `Add<Option<i8>>` is not implemented for `i8`
help: the following other types implement trait `Add<Rhs>`
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/ops/arith.rs:98:8
|
= note: `i8` implements `Add`
::: /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/ops/arith.rs:113:0
|
= note: in this macro invocation
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/internal_macros.rs:22:8
|
= note: `&i8` implements `Add<i8>`
::: /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/internal_macros.rs:33:8
|
= note: `i8` implements `Add<&i8>`
::: /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/internal_macros.rs:44:8
|
= note: `&i8` implements `Add`
= note: this error originates in the macro `add_impl` (in Nightly builds, run with -Z macro-backtrace for more info)
For more information about this error, try `rustc --explain E0277`.
error: could not compile `enums` (bin "enums") due to 1 previous error
Сурово! По сути, это сообщение об ошибке означает, что Rust не понимает, как сложить i8 и Option<i8>, потому что это разные типы. Когда у нас есть значение типа i8 в Rust, компилятор гарантирует, что у нас всегда есть действительное значение. Мы можем действовать уверенно, не проверяя на null перед использованием этого значения. Только когда у нас есть Option<i8> (или какой бы тип значения мы ни использовали), нам нужно беспокоиться о возможном отсутствии значения, и компилятор гарантирует, что мы обработаем этот случай, прежде чем использовать значение.
Другими словами, вы должны преобразовать Option<T> в T, прежде чем вы сможете выполнять с ним операции T. Как правило, это помогает поймать одну из самых распространённых проблем с null: предположение, что что-то не является null, когда на самом деле это так.
Устранение риска ошибочного предположения о ненулевом значении помогает вам быть более уверенным в своём коде. Чтобы получить значение, которое может быть null, вы должны явно согласиться, сделав тип этого значения Option<T>. Затем, когда вы используете это значение, вы обязаны явно обработать случай, когда значение равно null. Везде, где значение имеет тип, отличный от Option<T>, вы можете безопасно предположить, что значение не равно null. Это было осознанным дизайнерским решением Rust, чтобы ограничить распространённость null и повысить безопасность кода на Rust.
Итак, как вы получаете значение T из варианта Some, когда у вас есть значение типа Option<T>, чтобы вы могли использовать это значение? Перечисление Option<T> имеет большое количество методов, которые полезны в различных ситуациях; вы можете ознакомиться с ними в его документации. Знакомство с методами Option<T> будет чрезвычайно полезно в вашем путешествии по Rust.
В общем, чтобы использовать значение Option<T>, вам нужен код, который будет обрабатывать каждый вариант. Вам нужен некоторый код, который будет выполняться только тогда, когда у вас есть значение Some(T), и этому коду разрешено использовать внутреннее T. Вам нужен некоторый другой код, который будет выполняться только если у вас есть значение None, и у этого кода нет доступного значения T. Выражение match — это конструкция управления потоком, которая делает именно это при использовании с перечислениями: она будет выполнять разный код в зависимости от того, какой вариант перечисления у неё есть, и этот код может использовать данные внутри соответствующего значения.
Конструкция потока управления match
Конструкция потока управления match
В Rust есть чрезвычайно мощный конструкт управления потоком, называемый match, который позволяет сравнивать значение с рядом шаблонов и затем выполнять код в зависимости от того, какой шаблон совпал. Шаблоны могут состоять из литеральных значений, имён переменных, подстановочных знаков и многого другого; глава 19 охватывает все различные виды шаблонов и то, что они делают. Сила match происходит от выразительности шаблонов и того факта, что компилятор подтверждает, что все возможные случаи обработаны.
Думайте о выражении match как о машине для сортировки монет: монеты скользят по дорожке с отверстиями разного размера, и каждая монета проваливается в первое отверстие, в которое она помещается. Точно так же значения проходят через каждый шаблон в match, и в первом шаблоне, которому значение «подходит», значение попадает в связанный блок кода для использования во время выполнения.
Кстати о монетах, давайте используем их в качестве примера с match! Мы можем написать функцию, которая принимает неизвестную американскую монету и, подобно машине для подсчёта, определяет, какая это монета, и возвращает её стоимость в центах, как показано в листинге 6-3.
enum Coin {
Penny,
Nickel,
Dime,
Quarter,
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => 1,
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter => 25,
}
}
fn main() {}match, которое имеет варианты перечисления в качестве своих шаблоновДавайте разберём match в функции value_in_cents. Сначала мы указываем ключевое слово match, за которым следует выражение, в данном случае значение coin. Это очень похоже на условное выражение, используемое с if, но есть большое различие: с if условие должно вычисляться в логическое значение, но здесь оно может быть любого типа. Тип coin в этом примере — это перечисление Coin, которое мы определили в первой строке.
Далее идут ветви match. Ветвь состоит из двух частей: шаблона и некоторого кода. Первая ветвь здесь имеет шаблон, который является значением Coin::Penny, а затем оператор =>, который разделяет шаблон и код для выполнения. Код в этом случае — это просто значение 1. Каждая ветвь отделена от следующей запятой.
Когда выполняется выражение match, оно сравнивает результирующее значение с шаблоном каждой ветви по порядку. Если шаблон совпадает со значением, выполняется код, связанный с этим шаблоном. Если этот шаблон не совпадает со значением, выполнение продолжается со следующей ветвью, во многом как в машине для сортировки монет. У нас может быть столько ветвей, сколько нужно: в листинге 6-3 наш match имеет четыре ветви.
Код, связанный с каждой ветвью, является выражением, и результирующее значение выражения в совпавшей ветви — это значение, которое возвращается для всего выражения match.
Обычно мы не используем фигурные скобки, если код ветви match короткий, как в листинге 6-3, где каждая ветвь просто возвращает значение. Если вы хотите выполнить несколько строк кода в ветви match, вы должны использовать фигурные скобки, и тогда запятая после ветви необязательна. Например, следующий код печатает «Lucky penny!» каждый раз, когда метод вызывается с Coin::Penny, но всё равно возвращает последнее значение блока, 1:
enum Coin {
Penny,
Nickel,
Dime,
Quarter,
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => {
println!("Lucky penny!");
1
}
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter => 25,
}
}
fn main() {}Шаблоны, которые связываются со значениями
Ещё одна полезная особенность ветвей match заключается в том, что они могут связываться с частями значений, которые соответствуют шаблону. Именно так мы можем извлекать значения из вариантов перечисления.
В качестве примера давайте изменим один из наших вариантов перечисления, чтобы он содержал данные внутри себя. С 1999 по 2008 год США чеканили кварталы с разными рисунками для каждого из 50 штатов на одной стороне. Никакие другие монеты не получали рисунки штатов, поэтому только кварталы имеют это дополнительное значение. Мы можем добавить эту информацию в наше enum, изменив вариант Quarter, чтобы он включал значение UsState, хранящееся внутри него, что мы и сделали в листинге 6-4.
#[derive(Debug)] // чтобы мы могли исследовать состояние через минуту
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {}Coin, в котором вариант Quarter также содержит значение UsStateДавайте представим, что друг пытается собрать все 50 кварталов штатов. Пока мы сортируем нашу мелочь по типу монеты, мы также будем называть название штата, связанного с каждым кварталом, чтобы, если это тот, которого нет у нашего друга, он мог добавить его в свою коллекцию.
В выражении match для этого кода мы добавляем переменную, называемую state, к шаблону, который соответствует значениям варианта Coin::Quarter. Когда совпадает Coin::Quarter, переменная state будет связана со значением состояния этого квартала. Затем мы можем использовать state в коде для этой ветви, вот так:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => 1,
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter(state) => {
println!("State quarter from {state:?}!");
25
}
}
}
fn main() {
value_in_cents(Coin::Quarter(UsState::Alaska));
}Если бы мы вызвали value_in_cents(Coin::Quarter(UsState::Alaska)), coin было бы Coin::Quarter(UsState::Alaska). Когда мы сравниваем это значение с каждой из ветвей match, ни одна из них не совпадает, пока мы не достигнем Coin::Quarter(state). В этот момент привязка для state будет значением UsState::Alaska. Затем мы можем использовать эту привязку в выражении println!, таким образом получая внутреннее значение состояния из варианта перечисления Coin для Quarter.
Шаблон Option<T> в match
В предыдущем разделе мы хотели получить внутреннее значение T из случая Some при использовании Option<T>; мы также можем обрабатывать Option<T> с помощью match, как мы делали с перечислением Coin! Вместо сравнения монет мы будем сравнивать варианты Option<T>, но способ работы выражения match остаётся прежним.
Допустим, мы хотим написать функцию, которая принимает Option<i32> и, если внутри есть значение, добавляет 1 к этому значению. Если внутри нет значения, функция должна вернуть значение None и не пытаться выполнять никаких операций.
Эту функцию очень легко написать благодаря match, и она будет выглядеть как в листинге 6-5.
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}match для Option<i32>Давайте более подробно рассмотрим первое выполнение plus_one. Когда мы вызываем plus_one(five), переменная x в теле plus_one будет иметь значение Some(5). Затем мы сравниваем это с каждой ветвью match:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Значение Some(5) не соответствует шаблону None, поэтому мы переходим к следующей ветви:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Соответствует ли Some(5) шаблону Some(i)? Да! У нас одинаковый вариант. i связывается со значением, содержащимся в Some, поэтому i принимает значение 5. Затем выполняется код в ветви match, поэтому мы добавляем 1 к значению i и создаём новое значение Some с нашей суммой 6 внутри.
Теперь давайте рассмотрим второй вызов plus_one в листинге 6-5, где x равно None. Мы входим в match и сравниваем с первой ветвью:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Она совпадает! Нет значения, к которому можно добавить, поэтому программа останавливается и возвращает значение None справа от =>. Поскольку первая ветвь совпала, другие ветви не сравниваются.
Объединение match и перечислений полезно во многих ситуациях. Вы будете видеть этот паттерн очень часто в коде на Rust: match по перечислению, привязка переменной к данным внутри, а затем выполнение кода на основе этого. Сначала это немного сложно, но как только вы привыкнете, вы захотите, чтобы это было во всех языках. Это неизменно фаворит пользователей.
Сопоставления исчерпывающие
Есть ещё один аспект match, который нам нужно обсудить: шаблоны ветвей должны охватывать все возможности. Рассмотрим эту версию нашей функции plus_one, которая содержит ошибку и не скомпилируется:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Мы не обработали случай None, поэтому этот код вызовет ошибку. К счастью, это ошибка, которую Rust умеет ловить. Если мы попытаемся скомпилировать этот код, мы получим такую ошибку:
$ cargo run
Compiling enums v0.1.0 (file:///projects/enums)
error[E0004]: non-exhaustive patterns: `None` not covered
--> src/main.rs:3:15
|
3 | match x {
| ^ pattern `None` not covered
|
note: `Option<i32>` defined here
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/option.rs:597:0
::: /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/option.rs:601:4
|
= note: not covered
= note: the matched value is of type `Option<i32>`
help: ensure that all possible cases are being handled by adding a match arm with a wildcard pattern or an explicit pattern as shown
|
4 ~ Some(i) => Some(i + 1),
5 ~ None => todo!(),
|
For more information about this error, try `rustc --explain E0004`.
error: could not compile `enums` (bin "enums") due to 1 previous error
Rust знает, что мы не покрыли все возможные случаи, и даже знает, какой шаблон мы забыли! Сопоставления в Rust исчерпывающие: мы должны исчерпать все последние возможности, чтобы код был действительным. Особенно в случае Option<T>, когда Rust предотвращает наше забывание явно обработать случай None, он защищает нас от предположения, что у нас есть значение, когда у нас может быть null, делая тем самым ошибку на миллиард долларов, обсуждавшуюся ранее, невозможной.
Универсальные шаблоны и заполнитель _
Используя перечисления, мы также можем выполнять специальные действия для нескольких конкретных значений, но для всех других значений выполнять одно действие по умолчанию. Представьте, что мы реализуем игру, где, если вы выбрасываете 3 на кубике, ваш игрок не двигается, а вместо этого получает модную новую шляпу. Если вы выбрасываете 7, ваш игрок теряет модную шляпу. Для всех других значений ваш игрок перемещается на это количество клеток на игровом поле. Вот match, который реализует эту логику, с жёстко закодированным результатом броска кубика, а не случайным значением, и всей остальной логикой, представленной функциями без тел, потому что их фактическая реализация выходит за рамки этого примера:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
other => move_player(other),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
fn move_player(num_spaces: u8) {}
}Для первых двух ветвей шаблоны — это литеральные значения 3 и 7. Для последней ветви, которая покрывает все другие возможные значения, шаблон — это переменная, которую мы решили назвать other. Код, который выполняется для ветви other, использует переменную, передавая её в функцию move_player.
Этот код компилируется, хотя мы не перечислили все возможные значения, которые может иметь u8, потому что последний шаблон будет соответствовать всем значениям, не указанным конкретно. Этот универсальный шаблон удовлетворяет требованию, что match должен быть исчерпывающим. Обратите внимание, что мы должны поместить универсальную ветвь последней, потому что шаблоны оцениваются по порядку. Если бы мы поместили универсальную ветвь раньше, другие ветви никогда бы не выполнились, поэтому Rust предупредит нас, если мы добавим ветви после универсальной!
В Rust также есть шаблон, который мы можем использовать, когда хотим универсальный шаблон, но не хотим использовать значение в универсальном шаблоне: _ — это специальный шаблон, который соответствует любому значению и не связывается с этим значением. Это говорит Rust, что мы не собираемся использовать значение, поэтому Rust не будет предупреждать нас о неиспользуемой переменной.
Давайте изменим правила игры: теперь, если вы выбрасываете что-либо, кроме 3 или 7, вы должны бросать снова. Нам больше не нужно использовать универсальное значение, поэтому мы можем изменить наш код, чтобы использовать _ вместо переменной с именем other:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
_ => reroll(),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
fn reroll() {}
}Этот пример также удовлетворяет требованию исчерпывающего охвата, потому что мы явно игнорируем все другие значения в последней ветви; мы ничего не забыли.
Наконец, давайте изменим правила игры ещё раз, чтобы в ваш ход ничего не происходило, если вы выбрасываете что-либо, кроме 3 или 7. Мы можем выразить это, используя единичное значение (тип пустого кортежа, который мы упоминали в разделе «Тип кортеж») в качестве кода, который идёт с ветвью _:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
_ => (),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
}Здесь мы говорим Rust явно, что мы не собираемся использовать никакое другое значение, которое не соответствует шаблону в более ранней ветви, и мы не хотим выполнять никакой код в этом случае.
В главе 19 мы рассмотрим больше о шаблонах и сопоставлении. Сейчас мы перейдём к синтаксису if let, который может быть полезен в ситуациях, когда выражение match немного многословно.
Краткий поток управления с if let и let...else
Краткий поток управления с if let и let...else
Синтаксис if let позволяет объединить if и let в менее многословный способ
обработки значений, соответствующих одному шаблону, игнорируя остальные. Рассмотрим
программу в листинге 6-6, которая выполняет сопоставление с значением Option<u8> в
переменной config_max, но хочет выполнить код только если значение является вариантом Some.
fn main() {
let config_max = Some(3u8);
match config_max {
Some(max) => println!("The maximum is configured to be {max}"),
_ => (),
}
}match, который заботится только о выполнении кода, когда значение — SomeЕсли значение — Some, мы печатаем значение в варианте Some, привязывая
значение к переменной max в шаблоне. Мы не хотим ничего делать со
значением None. Чтобы удовлетворить выражение match, нам нужно добавить _ => ()
после обработки только одного варианта, что является раздражающим шаблонным кодом,
который нужно добавить.
Вместо этого мы могли бы написать это короче, используя if let. Следующий
код ведёт себя так же, как match в листинге 6-6:
fn main() {
let config_max = Some(3u8);
if let Some(max) = config_max {
println!("The maximum is configured to be {max}");
}
}Синтаксис if let принимает шаблон и выражение, разделённые знаком равенства.
Он работает так же, как match, где выражение передаётся
в match, а шаблон является его первой ветвью. В этом случае шаблон —
Some(max), и max привязывается к значению внутри Some. Затем мы можем
использовать max в теле блока if let так же, как мы использовали max в
соответствующей ветви match. Код в блоке if let выполняется только если
значение соответствует шаблону.
Использование if let означает меньше набора текста, меньше отступов и меньше шаблонного кода.
Однако вы теряете исчерпывающую проверку, которую обеспечивает match, гарантирующую, что
вы не забыли обработать какие-либо случаи. Выбор между match и if let
зависит от того, что вы делаете в конкретной ситуации, и от того, является ли
получение краткости подходящим компромиссом за потерю исчерпывающей проверки.
Иными словами, можно думать о if let как о синтаксическом сахаре для match, который
выполняет код, когда значение соответствует одному шаблону, а затем игнорирует все остальные значения.
Мы можем включить else в if let. Блок кода, который идёт с
else, совпадает с блоком кода, который шёл бы с случаем _ в
выражении match, эквивалентном if let и else. Вспомним
определение перечисления Coin в листинге 6-4, где вариант Quarter также содержал
значение UsState. Если бы мы хотели подсчитать все монеты не-кварталы, которые мы видим, а также
объявить штат кварталов, мы могли бы сделать это с помощью match
выражения, вот так:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {
let coin = Coin::Penny;
let mut count = 0;
match coin {
Coin::Quarter(state) => println!("State quarter from {state:?}!"),
_ => count += 1,
}
}Или мы могли бы использовать выражение if let и else, вот так:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {
let coin = Coin::Penny;
let mut count = 0;
if let Coin::Quarter(state) = coin {
println!("State quarter from {state:?}!");
} else {
count += 1;
}
}Оставаться на «счастливом пути» с let...else
Распространённый паттерн — выполнить некоторое вычисление, когда значение присутствует, и
вернуть значение по умолчанию в противном случае. Продолжая наш пример с монетами со
значением UsState, если бы мы хотели сказать что-то забавное в зависимости от того, насколько старый
штат на квартале, мы могли бы добавить метод в UsState для проверки
возраста штата, вот так:
#[derive(Debug)] // чтобы мы могли проверить состояние через минуту
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
if let Coin::Quarter(state) = coin {
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
} else {
None
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}Затем мы могли бы использовать if let для сопоставления с типом монеты, вводя переменную state
внутри тела условия, как в листинге 6-7.
#[derive(Debug)] // чтобы мы могли проверить состояние через минуту
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
if let Coin::Quarter(state) = coin {
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
} else {
None
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}if letЭто делает работу, но это переместило работу в тело оператора if let, и если работа,
которую нужно выполнить, более сложная, может быть
трудно проследить, как именно связаны ветви верхнего уровня. Мы могли бы также
воспользоваться тем, что выражения производят значение, чтобы либо произвести
state из if let, либо вернуться раньше, как в листинге 6-8. (Вы могли бы сделать
что-то подобное с match, тоже.)
#[derive(Debug)] // чтобы мы могли проверить состояние через минуту
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
let state = if let Coin::Quarter(state) = coin {
state
} else {
return None;
};
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}if let для создания значения или раннего возвратаЭто несколько раздражает и само по себе! Одна ветвь if let
создаёт значение, а другая полностью возвращается из функции.
Чтобы сделать этот распространённый паттерн проще для выражения, в Rust есть let...else. Синтаксис
let...else принимает шаблон слева и выражение справа,
очень похоже на if let, но у него нет ветви if, только
ветвь else. Если шаблон совпадает, он привяжет значение из шаблона
во внешней области видимости. Если шаблон не совпадает, программа перейдёт
в ветвь else, которая должна вернуться из функции.
В листинге 6-9 вы можете увидеть, как выглядит листинг 6-8 при использовании let...else
вместо if let.
#[derive(Debug)] // чтобы мы могли проверить состояние через минуту
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
let Coin::Quarter(state) = coin else {
return None;
};
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}let...else для прояснения потока через функциюОбратите внимание, что так остаётся на «счастливом пути» в теле функции,
без существенно различного потока управления для двух ветвей, как
было в if let.
Если у вас есть ситуация, в которой ваша программа имеет логику, слишком многословную для
выражения с помощью match, помните, что if let и let...else также есть в вашем
арсенале Rust.
Итог
Теперь мы рассмотрели, как использовать перечисления для создания пользовательских типов, которые могут быть одним из
набора перечисленных значений. Мы показали, как тип Option<T> из стандартной библиотеки
помогает использовать систему типов для предотвращения ошибок. Когда значения перечисления имеют
данные внутри, вы можете использовать match или if let для извлечения и использования этих
значений, в зависимости от того, сколько случаев вам нужно обработать.
Ваши программы на Rust теперь могут выражать концепции вашей предметной области с помощью структур и перечислений. Создание пользовательских типов для использования в вашем API обеспечивает безопасность типов: компилятор удостоверится, что ваши функции получают только значения типа, который каждая функция ожидает.
Чтобы предоставить вашим пользователям хорошо организованный API, который прост в использовании и раскрывает ровно то, что нужно вашим пользователям, давайте теперь обратимся к модулям Rust.
Управление растущими проектами: пакеты, крейты и модули
Управление растущими проектами: пакеты, крейты и модули
По мере написания больших программ организация кода становится всё более важной. Группируя связанную функциональность и разделяя код с различными возможностями, вы проясняете, где найти код, реализующий ту или иную функцию, и куда идти, чтобы изменить, как эта функция работает.
Программы, которые мы писали до сих пор, находились в одном модуле в одном файле. По мере роста проекта следует организовывать код, разделяя его на несколько модулей, а затем на несколько файлов. Пакет может содержать несколько бинарных крейтов и, опционально, один библиотечный крейт. По мере роста пакета вы можете выделять части в отдельные крейты, которые становятся внешними зависимостями. Эта глава охватывает все эти техники. Для очень больших проектов, состоящих из набора взаимосвязанных пакетов, которые развиваются вместе, Cargo предоставляет рабочие пространства, которые мы рассмотрим в «Рабочие пространства Cargo» в четырнадцатой главе.
Мы также обсудим инкапсуляцию деталей реализации, которая позволяет повторно использовать код на более высоком уровне: как только вы реализовали операцию, другой код может вызывать ваш код через его публичный интерфейс, не зная, как работает реализация. То, как вы пишете код, определяет, какие части являются публичными для использования другим кодом, а какие — частными деталями реализации, которые вы оставляете за собой право изменять. Это ещё один способ ограничить объём деталей, которые вам приходится держать в голове.
Связанная концепция — это область видимости: вложенный контекст, в котором написан код, имеет набор имён, определённых как «находящиеся в области видимости». При чтении, написании и компиляции кода программистам и компиляторам нужно знать, относится ли конкретное имя в конкретном месте к переменной, функции, структуре, перечислению, модулю, константе или другому элементу и что этот элемент означает. Вы можете создавать области видимости и изменять, какие имена находятся в области видимости или вне неё. У вас не может быть двух элементов с одинаковым именем в одной области видимости; доступны инструменты для разрешения конфликтов имён.
В Rust есть ряд возможностей, позволяющих управлять организацией кода, включая то, какие детали раскрываются, какие детали являются частными, и какие имена находятся в каждой области видимости в ваших программах. Эти возможности, иногда называемые в совокупности системой модулей, включают:
- Пакеты: Возможность Cargo, позволяющая собирать, тестировать и делиться крейтами
- Крейты: Дерево модулей, которое производит библиотеку или исполняемый файл
- Модули и use: Позволяют контролировать организацию, область видимости и приватность путей
- Пути: Способ именования элемента, такого как структура, функция или модуль
В этой главе мы рассмотрим все эти возможности, обсудим, как они взаимодействуют, и объясним, как использовать их для управления областью видимости. К концу у вас должно быть прочное понимание системы модулей и умение работать с областями видимости как профессионал!
Пакеты и крейты
Пакеты и крейты
Первые части системы модулей, которые мы рассмотрим, — это пакеты и крейты.
Крейт — это наименьший объём кода, который рассматривает компилятор Rust за один раз. Даже если вы запускаете rustc вместо cargo и передаёте один файл исходного кода (как мы делали в самом начале в «Основы программы на Rust» в главе 1), компилятор считает этот файл крейтом. Крейты могут содержать модули, а модули могут быть определены в других файлах, которые компилируются вместе с крейтом, как мы увидим в следующих разделах.
Крейт может быть одной из двух форм: бинарный крейт или библиотечный крейт. Бинарные крейты — это программы, которые вы можете скомпилировать в исполняемый файл, который вы можете запустить, например, программа командной строки или сервер. Каждый из них должен иметь функцию с именем main, которая определяет, что происходит при запуске исполняемого файла. Все крейты, которые мы создавали до сих пор, были бинарными крейтами.
Библиотечные крейты не имеют функции main и не компилируются в исполняемый файл. Вместо этого они определяют функциональность, предназначенную для совместного использования несколькими проектами. Например, крейт rand, который мы использовали в главе 2, предоставляет функциональность, которая генерирует случайные числа. В большинстве случаев, когда Rustaceans говорят «крейт», они имеют в виду библиотечный крейт и используют «крейт» взаимозаменяемо с общей концепцией программирования «библиотека».
Корень крейта — это исходный файл, с которого компилятор Rust начинает работу и который составляет корневой модуль вашего крейта (мы подробно объясним модули в разделе «Управление областью видимости и приватностью с помощью модулей»).
Пакет — это набор из одного или нескольких крейтов, который предоставляет набор функциональности. Пакет содержит файл Cargo.toml, в котором описывается, как собирать эти крейты. Cargo на самом деле является пакетом, который содержит бинарный крейт для инструмента командной строки, который вы использовали для сборки вашего кода. Пакет Cargo также содержит библиотечный крейт, от которого зависит бинарный крейт. Другие проекты могут зависеть от библиотечного крейта Cargo, чтобы использовать ту же логику, что и инструмент командной строки Cargo.
Пакет может содержать столько бинарных крейтов, сколько вы хотите, но не более одного библиотечного крейта. Пакет должен содержать как минимум один крейт, будь то библиотечный или бинарный.
Давайте пройдёмся по тому, что происходит, когда мы создаём пакет. Сначала мы вводим команду cargo new my-project:
$ cargo new my-project
Created binary (application) `my-project` package
$ ls my-project
Cargo.toml
src
$ ls my-project/src
main.rs
После того как мы запустили cargo new my-project, мы используем ls, чтобы увидеть, что создаёт Cargo. В каталоге my-project есть файл Cargo.toml, который даёт нам пакет. Там также есть каталог src, который содержит main.rs. Откройте Cargo.toml в вашем текстовом редакторе и обратите внимание, что там нет упоминания о src/main.rs. Cargo следует соглашению, что src/main.rs — это корень крейта бинарного крейта с тем же именем, что и пакет. Аналогично, Cargo знает, что если каталог пакета содержит src/lib.rs, пакет содержит библиотечный крейт с тем же именем, что и пакет, а src/lib.rs является его корнем крейта. Cargo передаёт файлы корня крейта в rustc для сборки библиотеки или бинарного файла.
Здесь у нас есть пакет, который содержит только src/main.rs, что означает, что он содержит только бинарный крейт с именем my-project. Если пакет содержит src/main.rs и src/lib.rs, у него есть два крейта: бинарный и библиотечный, оба с тем же именем, что и пакет. Пакет может иметь несколько бинарных крейтов, поместив файлы в каталог src/bin: каждый файл будет отдельным бинарным крейтом.
Управление областью видимости и приватностью с помощью модулей
Управление областью видимости и приватностью с помощью модулей
В этом разделе мы поговорим о модулях и других частях системы модулей, а именно о путях (paths), которые позволяют именовать элементы; ключевом слове use, которое вводит путь в область видимости; и ключевом слове pub, чтобы делать элементы публичными. Мы также обсудим ключевое слово as, внешние пакеты и оператор glob.
Шпаргалка по модулям
Прежде чем мы перейдём к деталям модулей и путей, здесь мы приводим краткую справку о том, как модули, пути, ключевое слово use и ключевое слово pub работают в компиляторе и как большинство разработчиков организуют свой код. На протяжении этой главы мы будем разбирать примеры каждого из этих правил, но это отличное место, к которому можно обращаться как к напоминанию о том, как работают модули.
- Начинайте с корня крейта: При компиляции крейта компилятор сначала ищет в файле корня крейта (обычно src/lib.rs для библиотечного крейта и src/main.rs для бинарного крейта) код для компиляции.
- Объявление модулей: В файле корня крейта можно объявлять новые модули; скажем, вы объявляете модуль «garden» с помощью
mod garden;. Компилятор будет искать код модуля в следующих местах:- Встроенно, внутри фигурных скобок, заменяющих точку с запятой после
mod garden - В файле src/garden.rs
- В файле src/garden/mod.rs
- Встроенно, внутри фигурных скобок, заменяющих точку с запятой после
- Объявление подмодулей: В любом файле, кроме корня крейта, можно объявлять подмодули. Например, вы можете объявить
mod vegetables;в src/garden.rs. Компилятор будет искать код подмодуля в директории, названной по имени родительского модуля, в следующих местах:- Встроенно, непосредственно после
mod vegetables, внутри фигурных скобок вместо точки с запятой - В файле src/garden/vegetables.rs
- В файле src/garden/vegetables/mod.rs
- Встроенно, непосредственно после
- Пути к коду в модулях: Как только модуль становится частью вашего крейта, вы можете обращаться к коду в этом модуле из любого другого места того же крейта, если это позволяют правила приватности, используя путь к коду. Например, тип
Asparagusв модуле garden vegetables будет найден по путиcrate::garden::vegetables::Asparagus. - Приватное против публичного: Код внутри модуля по умолчанию приватный по отношению к его родительским модулям. Чтобы сделать модуль публичным, объявите его с помощью
pub modвместоmod. Чтобы сделать элементы внутри публичного модуля также публичными, используйтеpubперед их объявлениями. - Ключевое слово
use: В пределах области видимости ключевое словоuseсоздаёт сокращения для элементов, чтобы уменьшить повторение длинных путей. В любой области видимости, которая может ссылаться наcrate::garden::vegetables::Asparagus, можно создать сокращение с помощьюuse crate::garden::vegetables::Asparagus;, и с этого момента вам нужно будет написать толькоAsparagus, чтобы использовать этот тип в области видимости.
Здесь мы создаём бинарный крейт под названием backyard, который иллюстрирует эти правила. Директория крейта, также называемая backyard, содержит следующие файлы и директории:
backyard
├── Cargo.lock
├── Cargo.toml
└── src
├── garden
│ └── vegetables.rs
├── garden.rs
└── main.rs
Файл корня крейта в этом случае — src/main.rs, и он содержит:
use crate::garden::vegetables::Asparagus;
pub mod garden;
fn main() {
let plant = Asparagus {};
println!("I'm growing {plant:?}!");
}Строка pub mod garden; сообщает компилятору включить код, который он находит в src/garden.rs, а именно:
pub mod vegetables;Здесь pub mod vegetables; означает, что код в src/garden/vegetables.rs также включён. Этот код:
#[derive(Debug)]
pub struct Asparagus {}Теперь давайте углубимся в детали этих правил и продемонстрируем их в действии!
Группировка связанного кода в модулях
Модули позволяют организовывать код внутри крейта для читаемости и лёгкого повторного использования. Модули также позволяют нам контролировать приватность элементов, поскольку код внутри модуля по умолчанию приватный. Приватные элементы — это внутренние детали реализации, недоступные для внешнего использования. Мы можем по своему выбору делать модули и элементы внутри них публичными, что делает их доступными, позволяя внешнему коду использовать их и зависеть от них.
В качестве примера напишем библиотечный крейт, который предоставляет функциональность ресторана. Мы определим сигнатуры функций, но оставим их тела пустыми, чтобы сосредоточиться на организации кода, а не на реализации ресторана.
В ресторанной индустрии некоторые части ресторана называются «передней частью дома» (front of house), а другие — «задней частью дома» (back of house). Передняя часть дома — это место, где находятся клиенты; она включает места, где хостес рассаживают клиентов, официанты принимают заказы и оплату, а бармены готовят напитки. Задняя часть дома — это место, где повара и кулинары работают на кухне, посудомойщики убирают, а менеджеры выполняют административную работу.
Чтобы структурировать наш крейт таким образом, мы можем организовать его функции во вложенные модули. Создайте новую библиотеку под названием restaurant, выполнив cargo new restaurant --lib. Затем введите код из листинга 7-1 в src/lib.rs, чтобы определить некоторые модули и сигнатуры функций; этот код — часть передней части дома.
mod front_of_house {
mod hosting {
fn add_to_waitlist() {}
fn seat_at_table() {}
}
mod serving {
fn take_order() {}
fn serve_order() {}
fn take_payment() {}
}
}front_of_house, содержащий другие модули, которые затем содержат функцииМы определяем модуль ключевым словом mod, за которым следует имя модуля (в данном случае front_of_house). Тело модуля затем помещается внутри фигурных скобок. Внутри модулей можно размещать другие модули, как в этом случае с модулями hosting и serving. Модули также могут содержать определения других элементов, таких как структуры, перечисления, константы, трейты и, как в листинге 7-1, функции.
Используя модули, мы можем группировать связанные определения вместе и давать имена тому, почему они связаны. Программисты, использующие этот код, могут перемещаться по коду на основе групп, а не читать все определения, что упрощает поиск определений, относящихся к ним. Программисты, добавляющие новую функциональность в этот код, знали бы, куда поместить код, чтобы поддерживать организованность программы.
Ранее мы упоминали, что src/main.rs и src/lib.rs называются корнями крейта. Причина их названия в том, что содержимое любого из этих двух файлов образует модуль под названием crate в корне структуры модулей крейта, известной как дерево модулей.
Листинг 7-2 показывает дерево модулей для структуры из листинга 7-1.
crate
└── front_of_house
├── hosting
│ ├── add_to_waitlist
│ └── seat_at_table
└── serving
├── take_order
├── serve_order
└── take_payment
Это дерево показывает, как некоторые модули вложены в другие модули; например, hosting вложен в front_of_house. Дерево также показывает, что некоторые модули являются соседями (siblings), то есть они определены в одном модуле; hosting и serving — соседи, определённые внутри front_of_house. Если модуль A содержится внутри модуля B, мы говорим, что модуль A — потомок модуля B, а модуль B — родитель модуля A. Обратите внимание, что всё дерево модулей имеет корень под неявным модулем под названием crate.
Дерево модулей может напомнить вам дерево директорий файловой системы на вашем компьютере; это очень уместное сравнение! Точно так же, как директории в файловой системе, вы используете модули для организации кода. И точно так же, как файлы в директории, нам нужен способ находить наши модули.
Пути для ссылки на элемент в дереве модулей
Пути для ссылки на элемент в дереве модулей
Чтобы показать Rust, где найти элемент в дереве модулей, мы используем путь так же, как мы используем путь при навигации по файловой системе. Чтобы вызвать функцию, нам нужно знать её путь.
Путь может принимать две формы:
- Абсолютный путь — это полный путь, начинающийся с корня крейта; для
кода из внешнего крейта абсолютный путь начинается с имени крейта, а для
кода из текущего крейта он начинается с литерала
crate. - Относительный путь начинается с текущего модуля и использует
self,superили идентификатор в текущем модуле.
За как абсолютными, так и относительными путями следуют один или несколько
идентификаторов, разделённых двойными двоеточиями (::).
Возвращаясь к листингу 7-1, предположим, что мы хотим вызвать функцию
add_to_waitlist. Это то же самое, что спросить: каков путь функции
add_to_waitlist? Листинг 7-3 содержит листинг 7-1 с удалёнными
некоторыми модулями и функциями.
Мы покажем два способа вызвать функцию add_to_waitlist из новой функции
eat_at_restaurant, определённой в корне крейта. Эти пути корректны, но
остаётся ещё одна проблема, которая не даст этому примеру скомпилироваться
как есть. Мы объясним почему чуть позже.
Функция eat_at_restaurant является частью публичного API нашего
библиотечного крейта, поэтому мы помечаем её ключевым словом pub. В
разделе «Раскрытие путей с помощью ключевого слова pub»
мы рассмотрим pub более подробно.
mod front_of_house {
mod hosting {
fn add_to_waitlist() {}
}
}
pub fn eat_at_restaurant() {
// Абсолютный путь
crate::front_of_house::hosting::add_to_waitlist();
// Относительный путь
front_of_house::hosting::add_to_waitlist();
}add_to_waitlist с использованием абсолютного и относительного путейВ первый раз, когда мы вызываем функцию add_to_waitlist в
eat_at_restaurant, мы используем абсолютный путь. Функция add_to_waitlist
определена в том же крейте, что и eat_at_restaurant, что означает, что
мы можем использовать ключевое слово crate для начала абсолютного пути.
Затем мы включаем каждый из последовательных модулей, пока не доберёмся до
add_to_waitlist. Вы можете представить файловую систему с той же
структурой: мы бы указали путь /front_of_house/hosting/add_to_waitlist,
чтобы запустить программу add_to_waitlist; использование имени crate
для начала от корня крейта похоже на использование / для начала от корня
файловой системы в вашей оболочке.
Во второй раз, когда мы вызываем add_to_waitlist в eat_at_restaurant, мы
используем относительный путь. Путь начинается с front_of_house, имени
модуля, определённого на том же уровне дерева модулей, что и
eat_at_restaurant. Здесь эквивалент файловой системы — это использование
пути front_of_house/hosting/add_to_waitlist. Начало с имени модуля
означает, что путь относительный.
Выбор между относительным и абсолютным путём — это решение, которое вы
принимаете в зависимости от вашего проекта, и оно зависит от того, более ли
вероятно, что вы будете перемещать код определения элемента отдельно от
кода, использующего элемент, или вместе с ним. Например, если бы мы
переместили модуль front_of_house и функцию eat_at_restaurant в модуль с
именем customer_experience, нам нужно было бы обновить абсолютный путь к
add_to_waitlist, но относительный путь остался бы действительным. Однако,
если бы мы переместили функцию eat_at_restaurant отдельно в модуль с
именем dining, абсолютный путь к вызову add_to_waitlist остался бы
прежним, а относительный путь нужно было бы обновить. В целом мы
предпочитаем указывать абсолютные пути, потому что более вероятно, что мы
захотим перемещать определения кода и вызовы элементов независимо друг от
друга.
Давайте попробуем скомпилировать листинг 7-3 и выяснить, почему он ещё не компилируется! Полученные ошибки показаны в листинге 7-4.
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0603]: module `hosting` is private
--> src/lib.rs:9:28
|
9 | crate::front_of_house::hosting::add_to_waitlist();
| ^^^^^^^ --------------- function `add_to_waitlist` is not publicly re-exported
| |
| private module
|
note: the module `hosting` is defined here
--> src/lib.rs:2:5
|
2 | mod hosting {
| ^^^^^^^^^^^
error[E0603]: module `hosting` is private
--> src/lib.rs:12:21
|
12 | front_of_house::hosting::add_to_waitlist();
| ^^^^^^^ --------------- function `add_to_waitlist` is not publicly re-exported
| |
| private module
|
note: the module `hosting` is defined here
--> src/lib.rs:2:5
|
2 | mod hosting {
| ^^^^^^^^^^^
For more information about this error, try `rustc --explain E0603`.
error: could not compile `restaurant` (lib) due to 2 previous errors
Сообщения об ошибках говорят, что модуль hosting является приватным.
Другими словами, у нас есть правильные пути к модулю hosting и функции
add_to_waitlist, но Rust не позволяет нам их использовать, потому что у
него нет доступа к приватным разделам. В Rust все элементы (функции,
методы, структуры, перечисления, модули и константы) по умолчанию
приватны для родительских модулей. Если вы хотите сделать элемент, такой
как функция или структура, приватным, вы помещаете его в модуль.
Элементы в родительском модуле не могут использовать приватные элементы внутри дочерних модулей, но элементы в дочерних модулях могут использовать элементы в своих родительских модулях. Это потому, что дочерние модули оборачивают и скрывают детали своей реализации, но дочерние модули могут видеть контекст, в котором они определены. Продолжая нашу метафору, подумайте о правилах приватности как о служебных помещениях ресторана: то, что там происходит, приватно для клиентов ресторана, но менеджеры офиса могут видеть и делать всё в ресторане, которым они управляют.
Rust выбрал такую работу системы модулей, чтобы сокрытие внутренних
деталей реализации было поведением по умолчанию. Таким образом, вы знаете,
какие части внутреннего кода вы можете изменить, не ломая внешний код.
Однако Rust даёт вам возможность раскрыть внутренние части кода дочерних
модулей внешним родительским модулям, используя ключевое слово pub,
чтобы сделать элемент публичным.
Раскрытие путей с помощью ключевого слова pub
Вернёмся к ошибке в листинге 7-4, которая сообщила нам, что модуль
hosting является приватным. Мы хотим, чтобы функция eat_at_restaurant в
родительском модуле имела доступ к функции add_to_waitlist в дочернем
модуле, поэтому мы помечаем модуль hosting ключевым словом pub, как
показано в листинге 7-5.
mod front_of_house {
pub mod hosting {
fn add_to_waitlist() {}
}
}
// -- snip --
pub fn eat_at_restaurant() {
// Абсолютный путь
crate::front_of_house::hosting::add_to_waitlist();
// Относительный путь
front_of_house::hosting::add_to_waitlist();
}hosting как pub, чтобы использовать его из eat_at_restaurantК сожалению, код в листинге 7-5 всё ещё приводит к ошибкам компилятора, как показано в листинге 7-6.
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0603]: function `add_to_waitlist` is private
--> src/lib.rs:10:37
|
10 | crate::front_of_house::hosting::add_to_waitlist();
| ^^^^^^^^^^^^^^^ private function
|
note: the function `add_to_waitlist` is defined here
--> src/lib.rs:3:9
|
3 | fn add_to_waitlist() {}
| ^^^^^^^^^^^^^^^^^^^^
error[E0603]: function `add_to_waitlist` is private
--> src/lib.rs:13:30
|
13 | front_of_house::hosting::add_to_waitlist();
| ^^^^^^^^^^^^^^^ private function
|
note: the function `add_to_waitlist` is defined here
--> src/lib.rs:3:9
|
3 | fn add_to_waitlist() {}
| ^^^^^^^^^^^^^^^^^^^^
For more information about this error, try `rustc --explain E0603`.
error: could not compile `restaurant` (lib) due to 2 previous errors
Что произошло? Добавление ключевого слова pub перед mod hosting делает
модуль публичным. С этим изменением, если мы можем получить доступ к
front_of_house, мы можем получить доступ к hosting. Но содержимое
hosting всё ещё приватно; сделать модуль публичным не значит сделать его
содержимое публичным. Ключевое слово pub у модуля позволяет только коду
в его родительских модулях ссылаться на него, но не получать доступ к его
внутреннему коду. Поскольку модули — это контейнеры, мы не можем многого
добиться, сделав публичным только модуль; нам нужно пойти дальше и сделать
публичным один или несколько элементов внутри модуля.
Ошибки в листинге 7-6 говорят, что функция add_to_waitlist является
приватной. Правила приватности применяются к структурам, перечислениям,
функциям и методам так же, как и к модулям.
Давайте также сделаем функцию add_to_waitlist публичной, добавив ключевое
слово pub перед её определением, как в листинге 7-7.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
// -- snip --
pub fn eat_at_restaurant() {
// Абсолютный путь
crate::front_of_house::hosting::add_to_waitlist();
// Относительный путь
front_of_house::hosting::add_to_waitlist();
}pub к mod hosting и fn add_to_waitlist позволяет нам вызвать функцию из eat_at_restaurant.Теперь код скомпилируется! Чтобы понять, почему добавление ключевого слова
pub позволяет нам использовать эти пути в eat_at_restaurant в
соответствии с правилами приватности, давайте посмотрим на абсолютный и
относительный пути.
В абсолютном пути мы начинаем с crate, корня дерева модулей нашего
крейта. Модуль front_of_house определён в корне крейта. Хотя
front_of_house не является публичным, потому что функция eat_at_restaurant
определена в том же модуле, что и front_of_house (то есть
eat_at_restaurant и front_of_house — соседи), мы можем ссылаться на
front_of_house из eat_at_restaurant. Далее идёт модуль hosting,
помеченный pub. Мы можем получить доступ к родительскому модулю
hosting, поэтому мы можем получить доступ к hosting. Наконец, функция
add_to_waitlist помечена pub, и мы можем получить доступ к её
родительскому модулю, поэтому этот вызов функции работает!
В относительном пути логика та же, что и в абсолютном, за исключением
первого шага: вместо того чтобы начинать от корня крейта, путь начинается
от front_of_house. Модуль front_of_house определён в том же модуле, что и
eat_at_restaurant, поэтому относительный путь, начинающийся от модуля, в
котором определён eat_at_restaurant, работает. Затем, поскольку hosting и
add_to_waitlist помечены pub, остальная часть пути работает, и этот
вызов функции допустим!
Если вы планируете распространять ваш библиотечный крейт, чтобы другие проекты могли использовать ваш код, ваш публичный API — это ваш контракт с пользователями вашего крейта, который определяет, как они могут взаимодействовать с вашим кодом. Есть много соображений по управлению изменениями в вашем публичном API, чтобы людям было проще зависеть от вашего крейта. Эти соображения выходят за рамки этой книги; если вам интересна эта тема, см. Rust API Guidelines.
Лучшие практики для пакетов с бинарным крейтом и библиотекой
Мы упоминали, что пакет может содержать как корень бинарного крейта src/main.rs, так и корень библиотечного крейта src/lib.rs, и оба крейта по умолчанию будут иметь имя пакета. Как правило, пакеты с таким шаблоном, содержащие и библиотеку, и бинарный крейт, будут иметь ровно столько кода в бинарном крейте, сколько нужно для запуска исполняемого файла, который вызывает код, определённый в библиотечном крейте. Это позволяет другим проектам извлекать выгоду из большей части функциональности, которую предоставляет пакет, потому что код библиотечного крейта можно разделять.
Дерево модулей должно быть определено в src/lib.rs. Затем любые публичные элементы могут использоваться в бинарном крейте путём начала путей с имени пакета. Бинарный крейт становится пользователем библиотечного крейта так же, как совершенно внешний крейт использовал бы библиотечный крейт: он может использовать только публичный API. Это помогает вам разрабатывать хороший API; вы не только автор, но и клиент!
В главе 12 мы продемонстрируем эту организационную практику с программой командной строки, которая будет содержать как бинарный, так и библиотечный крейт.
Начало относительных путей с super
Мы можем строить относительные пути, которые начинаются в родительском
модуле, а не в текущем модуле или корне крейта, используя super в начале
пути. Это похоже на начало пути файловой системы с синтаксиса .., который
означает переход в родительский каталог. Использование super позволяет
нам ссылаться на элемент, который, как мы знаем, находится в родительском
модуле, что может облегчить перестройку дерева модулей, когда модуль тесно
связан с родителем, но родитель может когда-нибудь быть перемещён в другое
место дерева модулей.
Рассмотрим код в листинге 7-8, который моделирует ситуацию, когда шеф-повар
исправляет неправильный заказ и лично приносит его клиенту. Функция
fix_incorrect_order, определённая в модуле back_of_house, вызывает
функцию deliver_order, определённую в родительском модуле, указывая путь к
deliver_order, начиная с super.
fn deliver_order() {}
mod back_of_house {
fn fix_incorrect_order() {
cook_order();
super::deliver_order();
}
fn cook_order() {}
}superФункция fix_incorrect_order находится в модуле back_of_house, поэтому мы
можем использовать super, чтобы перейти к родительскому модулю
back_of_house, который в данном случае — crate, корень. Оттуда мы ищем
deliver_order и находим его. Успех! Мы думаем, что модуль
back_of_house и функция deliver_order, вероятно, останутся в том же
отношении друг к другу и будут перемещаться вместе, если мы решим
реорганизовать дерево модулей крейта. Поэтому мы использовали super,
чтобы у нас было меньше мест для обновления кода в будущем, если этот код
будет перемещён в другой модуль.
Делаем структуры и перечисления публичными
Мы также можем использовать pub, чтобы обозначить структуры и
перечисления как публичные, но есть несколько дополнительных деталей в
использовании pub со структурами и перечислениями. Если мы используем
pub перед определением структуры, мы делаем структуру публичной, но поля
структуры всё ещё будут приватными. Мы можем сделать каждое поле публичным
или нет на индивидуальной основе. В листинге 7-9 мы определили публичную
структуру back_of_house::Breakfast с публичным полем toast, но
приватным полем seasonal_fruit. Это моделирует случай в ресторане, когда
клиент может выбрать тип хлеба, который идёт с блюдом, но шеф-повар решает,
какой фрукт сопровождает блюдо, основываясь на том, что в сезоне и в
наличии. Доступные фрукты быстро меняются, поэтому клиенты не могут
выбрать фрукт или даже увидеть, какой фрукт они получат.
mod back_of_house {
pub struct Breakfast {
pub toast: String,
seasonal_fruit: String,
}
impl Breakfast {
pub fn summer(toast: &str) -> Breakfast {
Breakfast {
toast: String::from(toast),
seasonal_fruit: String::from("peaches"),
}
}
}
}
pub fn eat_at_restaurant() {
// Заказываем завтрак летом с ржаным тостом.
let mut meal = back_of_house::Breakfast::summer("Rye");
// Передумали насчёт того, какой хлеб хотим.
meal.toast = String::from("Wheat");
println!("I'd like {} toast please", meal.toast);
// Следующая строка не скомпилируется, если её раскомментировать; нам не разрешено
// видеть или изменять сезонные фрукты, которые идут вместе с блюдом.
// meal.seasonal_fruit = String::from("blueberries");
}Поскольку поле toast в структуре back_of_house::Breakfast является
публичным, в eat_at_restaurant мы можем писать и читать поле toast,
используя точечную нотацию. Обратите внимание, что мы не можем
использовать поле seasonal_fruit в eat_at_restaurant, потому что
seasonal_fruit является приватным. Попробуйте раскомментировать строку,
изменяющую значение поля seasonal_fruit, чтобы увидеть, какую ошибку вы
получите!
Также обратите внимание, что поскольку back_of_house::Breakfast имеет
приватное поле, структуре нужно предоставить публичную ассоциированную
функцию, которая создаёт экземпляр Breakfast (мы назвали её summer
здесь). Если бы у Breakfast не было такой функции, мы не могли бы создать
экземпляр Breakfast в eat_at_restaurant, потому что мы не могли бы
установить значение приватного поля seasonal_fruit в eat_at_restaurant.
В отличие от структур, если мы делаем перечисление публичным, все его
варианты тогда становятся публичными. Нам нужно только pub перед
ключевым словом enum, как показано в листинге 7-10.
mod back_of_house {
pub enum Appetizer {
Soup,
Salad,
}
}
pub fn eat_at_restaurant() {
let order1 = back_of_house::Appetizer::Soup;
let order2 = back_of_house::Appetizer::Salad;
}Поскольку мы сделали перечисление Appetizer публичным, мы можем
использовать варианты Soup и Salad в eat_at_restaurant.
Перечисления не очень полезны, если их варианты не публичны; было бы
утомительно аннотировать все варианты перечисления с pub в каждом случае,
поэтому по умолчанию варианты перечисления являются публичными. Структуры
часто полезны и без того, чтобы их поля были публичными, поэтому поля
структур следуют общему правилу: всё приватно по умолчанию, если не
аннотировано pub.
Есть ещё одна ситуация, связанная с pub, которую мы не рассмотрели, и
это наша последняя возможность системы модулей: ключевое слово use. Мы
сначала рассмотрим use само по себе, а затем покажем, как объединить
pub и use.
Введение путей в область видимости с помощью ключевого слова use
Введение путей в область видимости с помощью ключевого слова use
Необходимость выписывать пути для вызова функций может ощущаться неудобной и
повторяющейся. В листинге 7-7, независимо от того, выбрали ли мы абсолютный или относительный путь к
функции add_to_waitlist, каждый раз, когда мы хотели вызвать add_to_waitlist,
нам приходилось указывать также front_of_house и hosting. К счастью, есть
способ упростить этот процесс: мы можем создать сокращение для пути с помощью ключевого слова use
один раз, а затем использовать более короткое имя везде в этой области видимости.
В листинге 7-11 мы вводим crate::front_of_house::hosting в
область видимости функции eat_at_restaurant, так что нам нужно указывать только
hosting::add_to_waitlist, чтобы вызвать функцию add_to_waitlist в
eat_at_restaurant.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}useДобавление use и пути в область видимости аналогично созданию символической ссылки в
файловой системе. Добавив use crate::front_of_house::hosting в корень крейта,
hosting теперь является допустимым именем в этой области видимости, как если бы модуль hosting
был определён в корне крейта. Пути, введённые в область видимости с помощью use,
также проверяются на приватность, как и любые другие пути.
Обратите внимание, что use создаёт сокращение только для той конкретной области видимости, в которой
встречается use. Листинг 7-12 перемещает функцию eat_at_restaurant в новый
дочерний модуль с именем customer, который затем является другой областью видимости, чем
оператор use, поэтому тело функции не скомпилируется.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting;
mod customer {
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}
}use применяется только в той области видимости, в которой он находится.Ошибка компилятора показывает, что сокращение больше не действует внутри
модуля customer:
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0433]: cannot find module or crate `hosting` in this scope
--> src/lib.rs:11:9
|
11 | hosting::add_to_waitlist();
| ^^^^^^^ use of unresolved module or unlinked crate `hosting`
|
= help: if you wanted to use a crate named `hosting`, use `cargo add hosting` to add it to your `Cargo.toml`
help: consider importing this module through its public re-export
|
10 + use crate::hosting;
|
warning: unused import: `crate::front_of_house::hosting`
--> src/lib.rs:7:5
|
7 | use crate::front_of_house::hosting;
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
|
= note: `#[warn(unused_imports)]` (part of `#[warn(unused)]`) on by default
For more information about this error, try `rustc --explain E0433`.
warning: `restaurant` (lib) generated 1 warning
error: could not compile `restaurant` (lib) due to 1 previous error; 1 warning emitted
Обратите внимание, что также есть предупреждение о том, что use больше не используется в своей области видимости! Чтобы
исправить эту проблему, переместите use также внутрь модуля customer или обратитесь к
сокращению в родительском модуле через super::hosting внутри дочернего
модуля customer.
Создание идиоматичных путей use
В листинге 7-11 вы могли задаться вопросом, почему мы указали use crate::front_of_house::hosting, а затем вызвали hosting::add_to_waitlist в
eat_at_restaurant, вместо того чтобы указать путь use вплоть до
функции add_to_waitlist, чтобы достичь того же результата, как в листинге 7-13.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting::add_to_waitlist;
pub fn eat_at_restaurant() {
add_to_waitlist();
}add_to_waitlist в область видимости с помощью use, что неидиоматичноХотя листинг 7-11 и листинг 7-13 выполняют одну и ту же задачу, листинг
7-11 является идиоматичным способом введения функции в область видимости с помощью use. Введение
родительского модуля функции в область видимости с помощью use означает, что нам нужно указывать
родительский модуль при вызове функции. Указание родительского модуля при
вызове функции делает ясным, что функция не определена локально,
при этом минимизируя повторение полного пути. Код в листинге 7-13
неясен относительно того, где определена add_to_waitlist.
С другой стороны, при введении структур, перечислений и других элементов с помощью use
идиоматично указывать полный путь. Листинг 7-14 показывает идиоматичный способ
введения структуры HashMap из стандартной библиотеки в область видимости бинарного
крейта.
use std::collections::HashMap;
fn main() {
let mut map = HashMap::new();
map.insert(1, 2);
}HashMap в область видимости идиоматичным способомЗа этой идиомой нет веской причины: это просто соглашение, которое возникло, и люди привыкли читать и писать код на Rust таким образом.
Исключение из этой идиомы — если мы вводим два элемента с одинаковым именем
в область видимости с помощью операторов use, потому что Rust этого не позволяет. Листинг 7-15
показывает, как ввести два типа Result в область видимости, которые имеют одинаковое имя, но
разные родительские модули, и как ссылаться на них.
use std::fmt;
use std::io;
fn function1() -> fmt::Result {
// --snip--
Ok(())
}
fn function2() -> io::Result<()> {
// --snip--
Ok(())
}Как видите, использование родительских модулей различает два типа Result.
Если бы вместо этого мы указали use std::fmt::Result и use std::io::Result, у нас
было бы два типа Result в одной области видимости, и Rust не знал бы, какой из них мы
имели в виду, когда использовали Result.
Предоставление новых имён с помощью ключевого слова as
Есть ещё одно решение проблемы введения двух типов с одинаковым именем
в одну и ту же область видимости с помощью use: после пути мы можем указать as и новое
локальное имя, или псевдоним, для типа. Листинг 7-16 показывает другой способ написать
код из листинга 7-15, переименовав один из двух типов Result с помощью as.
use std::fmt::Result;
use std::io::Result as IoResult;
fn function1() -> Result {
// --snip--
Ok(())
}
fn function2() -> IoResult<()> {
// --snip--
Ok(())
}asВо втором операторе use мы выбрали новое имя IoResult для типа
std::io::Result, которое не будет конфликтовать с Result из std::fmt,
который мы также ввели в область видимости. Листинг 7-15 и листинг 7-16
считаются идиоматичными, так что выбор за вами!
Реэкспорт имён с помощью pub use
Когда мы вводим имя в область видимости с помощью ключевого слова use, имя является приватным для
той области видимости, в которую мы его импортировали. Чтобы позволить коду за пределами этой области видимости ссылаться
на это имя, как если бы оно было определено в этой области видимости, мы можем объединить pub и
use. Этот приём называется реэкспортом, потому что мы вводим элемент
в область видимости, но также делаем этот элемент доступным для других, чтобы они могли ввести его в свою
область видимости.
Листинг 7-17 показывает код из листинга 7-11 с use в корневом модуле,
изменённым на pub use.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
pub use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}pub useДо этого изменения внешнему коду пришлось бы вызывать функцию add_to_waitlist,
используя путь
restaurant::front_of_house::hosting::add_to_waitlist(), что также потребовало бы
пометить модуль front_of_house как pub. Теперь, когда этот pub use
реэкспортировал модуль hosting из корневого модуля, внешний код
может использовать путь restaurant::hosting::add_to_waitlist() вместо этого.
Реэкспорт полезен, когда внутренняя структура вашего кода отличается
от того, как программисты, вызывающие ваш код, думали бы о предметной области. Например,
в этой метафоре ресторана люди, управляющие рестораном, думают
о «входной зоне» и «задней зоне». Но посетители ресторана,
вероятно, не будут думать о частях ресторана в этих терминах. С помощью pub use
мы можем написать наш код с одной структурой, но предоставить другую структуру.
Это делает нашу библиотеку хорошо организованной как для программистов, работающих над библиотекой,
так и для программистов, вызывающих библиотеку. Мы рассмотрим другой пример pub use
и то, как он влияет на документацию вашего крейта, в «Экспорт удобного публичного
API» в главе 14.
Использование внешних пакетов
В главе 2 мы программировали проект игры в угадайку, который использовал внешний
пакет под названием rand для получения случайных чисел. Чтобы использовать rand в нашем проекте, мы
добавили эту строку в Cargo.toml:
rand = "0.10.1"
Добавление rand в качестве зависимости в Cargo.toml говорит Cargo загрузить
пакет rand и любые зависимости с crates.io и
сделать rand доступным для нашего проекта.
Затем, чтобы ввести определения rand в область видимости нашего пакета, мы добавили
строку use, начинающуюся с имени крейта rand, и перечислили элементы, которые
хотели ввести в область видимости. Вспомните, что в «Генерация случайного
числа» в главе 2 мы ввели элементы из
модуля rand::prelude в область видимости и вызвали функцию rand::rng:
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
println!("You guessed: {guess}");
}Члены сообщества Rust сделали множество пакетов доступными на
crates.io, и включение любого из них в ваш пакет
включает те же шаги: перечислить их в файле Cargo.toml вашего пакета и
использовать use для введения элементов из их крейтов в область видимости.
Обратите внимание, что стандартная библиотека std также является крейтом, внешним по отношению к нашему
пакету. Поскольку стандартная библиотека поставляется вместе с языком Rust, нам
не нужно изменять Cargo.toml, чтобы включить std. Но нам нужно ссылаться на
неё с помощью use, чтобы ввести элементы оттуда в область видимости нашего пакета. Например,
с HashMap мы бы использовали эту строку:
#![allow(unused)]
fn main() {
use std::collections::HashMap;
}Это абсолютный путь, начинающийся с std, имени крейта стандартной библиотеки.
Использование вложенных путей для очистки списков use
Если мы используем несколько элементов, определённых в одном и том же крейте или одном и том же модуле,
перечисление каждого элемента на отдельной строке может занимать много вертикального пространства в наших файлах. Например,
эти два оператора use, которые у нас были в игре в угадайку в листинге 2-4,
вводят элементы из std в область видимости:
// --snip--
use std::cmp::Ordering;
use std::io;
// --snip--
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
}Вместо этого мы можем использовать вложенные пути, чтобы ввести те же элементы в область видимости в одной строке. Мы делаем это, указывая общую часть пути, за которой следуют два двоеточия, а затем фигурные скобки вокруг списка различающихся частей путей, как показано в листинге 7-18.
use rand::prelude::*;
// --snip--
use std::{cmp::Ordering, io};
// --snip--
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = guess.trim().parse().expect("Please type a number!");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
}В больших программах введение множества элементов в область видимости из одного и того же крейта или
модуля с использованием вложенных путей может значительно сократить количество отдельных операторов use,
необходимых!
Мы можем использовать вложенный путь на любом уровне пути, что полезно при объединении
двух операторов use, которые имеют общий подпуть. Например, листинг 7-19 показывает два
оператора use: один вводит std::io в область видимости, а другой вводит
std::io::Write в область видимости.
use std::io;
use std::io::Write;use, где один является подпутём другогоОбщая часть этих двух путей — std::io, и это полный первый
путь. Чтобы объединить эти два пути в один оператор use, мы можем использовать self в
вложенном пути, как показано в листинге 7-20.
use std::io::{self, Write};useЭта строка вводит std::io и std::io::Write в область видимости.
Импорт элементов с помощью оператора глоб
Если мы хотим ввести все публичные элементы, определённые в пути, в область видимости, мы можем
указать этот путь, за которым следует оператор глоб *:
#![allow(unused)]
fn main() {
use std::collections::*;
}Этот оператор use вводит все публичные элементы, определённые в std::collections, в
текущую область видимости. Будьте осторожны при использовании оператора глоб! Глоб может
затруднить определение того, какие имена находятся в области видимости и где используется имя в вашей программе
было определено. Кроме того, если зависимость изменяет свои определения, то, что
вы импортировали, также изменится, что может привести к ошибкам компилятора при обновлении зависимости, если зависимость добавляет определение с тем же именем,
что и ваше определение в той же области видимости, например.
Оператор глоб часто используется при тестировании для введения всего тестируемого
в модуль tests; мы поговорим об этом в «Как писать
тесты» в главе 11. Оператор глоб также
иногда используется как часть шаблона prelude: см. документацию
стандартной библиотеки для получения дополнительной
информации об этом шаблоне.
Разделение модулей на разные файлы
Разделение модулей на разные файлы
До сих пор все примеры в этой главе определяли несколько модулей в одном файле. Когда модули становятся большими, может возникнуть желание переместить их определения в отдельный файл, чтобы код было проще навигировать.
Например, начнём с кода из листинга 7-17, в котором было несколько модулей ресторана. Мы извлечём модули в файлы вместо того, чтобы определять все модули в файле корня крейта. В этом случае файл корня крейта — src/lib.rs, но эта процедура также работает с бинарными крейтами, чей файл корня крейта — src/main.rs.
Сначала извлечём модуль front_of_house в его собственный файл. Удалим код внутри фигурных скобок модуля front_of_house, оставив только объявление mod front_of_house;, так что src/lib.rs содержит код, показанный в листинге 7-21. Обратите внимание, что это не скомпилируется, пока мы не создадим файл src/front_of_house.rs из листинга 7-22.
mod front_of_house;
pub use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}front_of_house, тело которого будет в src/front_of_house.rsЗатем поместим код, который был в фигурных скобках, в новый файл с именем src/front_of_house.rs, как показано в листинге 7-22. Компилятор знает, что нужно искать в этом файле, потому что он встретил объявление модуля в корне крейта с именем front_of_house.
pub mod hosting {
pub fn add_to_waitlist() {}
}front_of_house в src/front_of_house.rsОбратите внимание, что вам нужно загрузить файл с помощью объявления mod только один раз в вашем дереве модулей. Как только компилятор знает, что файл является частью проекта (и знает, где в дереве модулей находится код, потому что вы поместили туда оператор mod), другие файлы в вашем проекте должны ссылаться на код загруженного файла с помощью пути к тому месту, где он был объявлен, как описано в разделе «Пути для ссылки на элемент в дереве модулей». Иными словами, mod — это не операция «include», которую вы могли видеть в других языках программирования.
Затем мы извлечём модуль hosting в его собственный файл. Процесс немного отличается, потому что hosting — это дочерний модуль front_of_house, а не корневого модуля. Мы поместим файл для hosting в новую директорию, которая будет названа по его предкам в дереве модулей, в данном случае src/front_of_house.
Чтобы начать перемещение hosting, мы изменим src/front_of_house.rs, чтобы он содержал только объявление модуля hosting:
pub mod hosting;Затем мы создадим директорию src/front_of_house и файл hosting.rs, чтобы содержать определения, сделанные в модуле hosting:
pub fn add_to_waitlist() {}Если бы мы вместо этого поместили hosting.rs в директорию src, компилятор ожидал бы, что код hosting.rs будет в модуле hosting, объявленном в корне крейта, а не объявленном как потомок модуля front_of_house. Правила компилятора о том, в каких файлах искать код каких модулей, означают, что директории и файлы более точно соответствуют дереву модулей.
Альтернативные пути к файлам
До сих пор мы рассматривали наиболее идиоматичные пути к файлам, которые использует компилятор Rust, но Rust также поддерживает более старый стиль пути к файлам. Для модуля с именем front_of_house, объявленного в корне крейта, компилятор будет искать код модуля в:
- src/front_of_house.rs (то, что мы рассмотрели)
- src/front_of_house/mod.rs (старый стиль, всё ещё поддерживаемый путь)
Для модуля с именем hosting, который является подмодулем front_of_house, компилятор будет искать код модуля в:
- src/front_of_house/hosting.rs (то, что мы рассмотрели)
- src/front_of_house/hosting/mod.rs (старый стиль, всё ещё поддерживаемый путь)
Если вы используете оба стиля для одного и того же модуля, вы получите ошибку компиляции. Использование смеси обоих стилей для разных модулей в одном проекте разрешено, но может сбивать с толку людей, навигирующих по вашему проекту.
Главный недостаток стиля, использующего файлы с именем mod.rs, заключается в том, что в вашем проекте может оказаться много файлов с именем mod.rs, что может запутать, когда они открыты одновременно в вашем редакторе.
Мы переместили код каждого модуля в отдельный файл, и дерево модулей осталось тем же. Вызовы функций в eat_at_restaurant будут работать без каких-либо изменений, даже несмотря на то, что определения находятся в разных файлах. Этот приём позволяет перемещать модули в новые файлы по мере их роста в размере.
Обратите внимание, что оператор pub use crate::front_of_house::hosting в src/lib.rs также не изменился, и use не влияет на то, какие файлы компилируются как часть крейта. Ключевое слово mod объявляет модули, и Rust ищет в файле с тем же именем, что и модуль, код, который идёт в этот модуль.
Итоги
Rust позволяет разделить пакет на несколько крейтов, а крейт — на модули, чтобы вы могли ссылаться на элементы, определённые в одном модуле, из другого модуля. Вы можете делать это, указывая абсолютные или относительные пути. Эти пути можно ввести в область видимости с помощью оператора use, чтобы использовать более короткий путь для множественного использования элемента в этой области. Код модуля по умолчанию приватный, но вы можете сделать определения публичными, добавив ключевое слово pub.
В следующей главе мы рассмотрим некоторые структуры данных-коллекций в стандартной библиотеке, которые вы можете использовать в вашем аккуратно организованном коде.
Распространённые коллекции
Распространённые коллекции
Стандартная библиотека Rust включает ряд очень полезных структур данных, называемых коллекциями. Большинство других типов данных представляют одно конкретное значение, но коллекции могут содержать несколько значений. В отличие от встроенных типов массивов и кортежей, данные, на которые указывают эти коллекции, хранятся в куче, что означает, что объём данных не нужно знать во время компиляции, и он может расти или уменьшаться по мере выполнения программы. Каждый вид коллекции имеет разные возможности и издержки, и выбор подходящей для текущей ситуации — это навык, который вы разовьёте со временем. В этой главе мы обсудим три коллекции, которые очень часто используются в программах на Rust:
- Вектор позволяет хранить переменное количество значений рядом друг с другом.
- Строка — это коллекция символов. Мы упоминали тип
Stringранее, но в этой главе мы подробно поговорим о нём. - Хеш-таблица позволяет связать значение с определённым ключом. Это конкретная реализация более общей структуры данных, называемой отображением.
Чтобы узнать о других видах коллекций, предоставляемых стандартной библиотекой, см. документацию.
Мы обсудим, как создавать и обновлять векторы, строки и хеш-таблицы, а также что делает каждую из них особенной.
Хранение списков значений с помощью векторов
Хранение списков значений с помощью векторов
Первый тип коллекции, который мы рассмотрим, — это Vec<T>, также известный как вектор.
Векторы позволяют хранить более одного значения в единой структуре данных, размещая
все значения рядом друг с другом в памяти. Векторы могут хранить значения только
одного типа. Они полезны, когда есть список элементов, например строки
текста в файле или цены товаров в корзине покупок.
Создание нового вектора
Чтобы создать новый пустой вектор, вызывается функция Vec::new, как показано в
листинге 8-1.
fn main() {
let v: Vec<i32> = Vec::new();
}i32Обратите внимание, что здесь добавлена аннотация типа. Поскольку в этот вектор
не вставляются никакие значения, Rust не знает, элементы какого типа
предполагается хранить. Это важный момент. Векторы реализованы с использованием
обобщённых типов; как использовать обобщённые типы с собственными типами, мы
рассмотрим в главе 10. Пока достаточно знать, что тип Vec<T>, предоставляемый
стандартной библиотекой, может хранить любой тип. Когда создаётся вектор для
хранения конкретного типа, тип можно указать в угловых скобках. В листинге 8-1
мы сообщили Rust, что Vec<T> в v будет хранить элементы типа
i32.
Чаще создаётся Vec<T> с начальными значениями, и Rust выводит
тип значений, которые предполагается хранить, поэтому такая аннотация
типа требуется редко. Rust удобно предоставляет макрос vec!, который создаёт
новый вектор с указанными значениями. Листинг 8-2 создаёт новый
Vec<i32>, содержащий значения 1, 2 и 3. Тип целых чисел — i32,
потому что это тип целых чисел по умолчанию, как обсуждалось в разделе «Типы
данных» главы 3.
fn main() {
let v = vec![1, 2, 3];
}Поскольку заданы начальные значения i32, Rust может вывести, что тип v
— это Vec<i32>, и аннотация типа не нужна. Далее рассмотрим, как
изменять вектор.
Обновление вектора
Чтобы создать вектор, а затем добавить в него элементы, можно использовать метод push,
как показано в листинге 8-3.
fn main() {
let mut v = Vec::new();
v.push(5);
v.push(6);
v.push(7);
v.push(8);
}push для добавления значений в векторКак и для любой переменной, если требуется иметь возможность изменять её значение,
её нужно сделать изменяемой с помощью ключевого слова mut, как обсуждалось в главе 3. Числа,
которые мы помещаем внутрь, все имеют тип i32, и Rust выводит это из данных, поэтому
аннотация Vec<i32> не нужна.
Чтение элементов векторов
Есть два способа сослаться на значение, хранящееся в векторе: с помощью индексации или
метода get. В следующих примерах мы аннотировали типы
значений, возвращаемых этими функциями, для дополнительной ясности.
Листинг 8-4 показывает оба способа доступа к значению в векторе: синтаксис индексации
и метод get.
fn main() {
let v = vec![1, 2, 3, 4, 5];
let third: &i32 = &v[2];
println!("The third element is {third}");
let third: Option<&i32> = v.get(2);
match third {
Some(third) => println!("The third element is {third}"),
None => println!("There is no third element."),
}
}get для доступа к элементу вектораОбратите внимание на несколько деталей. Мы используем индекс 2, чтобы получить третий элемент,
потому что векторы индексируются числами, начиная с нуля. Использование & и []
даёт нам ссылку на элемент по значению индекса. Когда мы используем метод get
с индексом, переданным в качестве аргумента, мы получаем Option<&T>, который можно
использовать с match.
Rust предоставляет эти два способа ссылки на элемент, чтобы можно было выбрать, как программа будет себя вести при попытке использовать значение индекса за пределами диапазона существующих элементов. В качестве примера посмотрим, что произойдёт, если у нас есть вектор из пяти элементов и мы попытаемся получить доступ к элементу с индексом 100 каждым из способов, как показано в листинге 8-5.
fn main() {
let v = vec![1, 2, 3, 4, 5];
let does_not_exist = &v[100];
let does_not_exist = v.get(100);
}Когда мы запускаем этот код, первый способ с [] вызовет панику программы,
потому что он ссылается на несуществующий элемент. Этот способ лучше использовать, когда
нужно, чтобы программа аварийно завершилась при попытке доступа к элементу за
пределами вектора.
Когда методу get передаётся индекс за пределами вектора, он возвращает
None без паники. Этот способ следует использовать, если доступ к элементу
за пределами диапазона вектора может происходить время от времени при нормальных
обстоятельствах. Затем в коде будет логика обработки как
Some(&element), так и None, как обсуждалось в главе 6. Например, индекс
может поступать от человека, вводящего число. Если он случайно введёт
слишком большое число и программа получит значение None, можно сообщить
пользователю, сколько элементов в текущем векторе, и дать ему ещё одну попытку
ввести корректное значение. Это было бы удобнее для пользователя, чем аварийное завершение программы
из-за опечатки!
Когда программа имеет корректную ссылку, проверка заимствований обеспечивает соблюдение правил владения и заимствования (рассмотренных в главе 4), чтобы гарантировать, что эта ссылка и любые другие ссылки на содержимое вектора остаются корректными. Вспомните правило, согласно которому нельзя иметь изменяемые и неизменяемые ссылки в одной области видимости. Это правило применимо в листинге 8-6, где мы держим неизменяемую ссылку на первый элемент вектора и пытаемся добавить элемент в конец. Эта программа не будет работать, если мы также попытаемся обратиться к этому элементу позже в функции.
fn main() {
let mut v = vec![1, 2, 3, 4, 5];
let first = &v[0];
v.push(6);
println!("The first element is: {first}");
}Компиляция этого кода приведёт к следующей ошибке:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
error[E0502]: cannot borrow `v` as mutable because it is also borrowed as immutable
--> src/main.rs:6:5
|
4 | let first = &v[0];
| - immutable borrow occurs here
5 |
6 | v.push(6);
| ^^^^^^^^^ mutable borrow occurs here
7 |
8 | println!("The first element is: {first}");
| ----- immutable borrow later used here
For more information about this error, try `rustc --explain E0502`.
error: could not compile `collections` (bin "collections") due to 1 previous error
Код в листинге 8-6 может показаться работающим: почему ссылка на первый элемент должна зависеть от изменений в конце вектора? Эта ошибка обусловлена тем, как работают векторы: поскольку векторы размещают значения рядом друг с другом в памяти, добавление нового элемента в конец вектора может потребовать выделения новой памяти и копирования старых элементов в новое пространство, если не хватает места, чтобы разместить все элементы рядом друг с другом там, где вектор сейчас хранится. В этом случае ссылка на первый элемент указывала бы на освобождённую память. Правила заимствования не позволяют программам оказаться в такой ситуации.
Примечание: Подробнее о деталях реализации типа Vec<T> см. «The
Rustonomicon».
Перебор значений в векторе
Чтобы поочерёдно получить доступ к каждому элементу вектора, нужно перебрать все
элементы, а не использовать индексы для доступа к ним по одному. Листинг 8-7 показывает, как
использовать цикл for для получения неизменяемых ссылок на каждый элемент вектора
значений i32 и их вывода.
fn main() {
let v = vec![100, 32, 57];
for i in &v {
println!("{i}");
}
}forМожно также перебирать изменяемые ссылки на каждый элемент изменяемого вектора,
чтобы вносить изменения во все элементы. Цикл for в листинге 8-8
добавит 50 к каждому элементу.
fn main() {
let mut v = vec![100, 32, 57];
for i in &mut v {
*i += 50;
}
}Чтобы изменить значение, на которое ссылается изменяемая ссылка, нужно использовать
оператор разыменования *, чтобы добраться до значения в i, прежде чем применять
оператор +=. Подробнее об операторе разыменования пойдёт речь в разделе «Следование
по ссылке к значению» главы 15.
Перебор вектора, как неизменяемый, так и изменяемый, безопасен благодаря
правилам проверки заимствований. Если бы мы попытались вставить или удалить элементы в теле цикла for
в листингах 8-7 и 8-8, мы получили бы ошибку компиляции,
аналогичную той, что была получена с кодом из листинга 8-6. Ссылка на
вектор, которую держит цикл for, предотвращает одновременное изменение
всего вектора.
Использование перечисления для хранения нескольких типов
Векторы могут хранить только значения одного и того же типа. Это может быть неудобно; определённо есть случаи, когда нужно хранить список элементов разных типов. К счастью, варианты перечисления определяются в рамках одного типа перечисления, поэтому, когда нужен один тип для представления элементов разных типов, можно определить и использовать перечисление!
Например, предположим, что мы хотим получить значения из строки электронной таблицы, в которой некоторые столбцы строки содержат целые числа, некоторые — числа с плавающей запятой, а некоторые — строки. Можно определить перечисление, варианты которого будут содержать разные типы значений, и все варианты перечисления будут считаться одним типом: типом перечисления. Затем можно создать вектор для хранения этого перечисления и, следовательно, хранить разные типы. Мы продемонстрировали это в листинге 8-9.
fn main() {
enum SpreadsheetCell {
Int(i32),
Float(f64),
Text(String),
}
let row = vec![
SpreadsheetCell::Int(3),
SpreadsheetCell::Text(String::from("blue")),
SpreadsheetCell::Float(10.12),
];
}Rust нужно знать, какие типы будут в векторе, во время компиляции, чтобы знать,
сколько памяти в куче потребуется для хранения каждого элемента.
Также нужно явно указать, какие типы разрешены в этом векторе. Если бы Rust
позволял вектору хранить любой тип, была бы вероятность, что один или несколько
типов вызовут ошибки при выполнении операций над элементами
вектора. Использование перечисления в сочетании с выражением match означает, что Rust гарантирует
во время компиляции обработку всех возможных случаев, как обсуждалось в главе 6.
Если неизвестен полный набор типов, которые программа получит во время выполнения для хранения в векторе, метод с перечислением не сработает. Вместо этого можно использовать трейт-объект, который мы рассмотрим в главе 18.
Теперь, когда мы обсудили некоторые из наиболее распространённых способов использования векторов, обязательно
ознакомьтесь с документацией по API для всех многих
полезных методов, определённых для Vec<T> стандартной библиотекой. Например, помимо
push, метод pop удаляет и возвращает последний элемент.
Удаление вектора удаляет его элементы
Как и любая другая struct, вектор освобождается, когда выходит из области видимости, как
отмечено в листинге 8-10.
fn main() {
{
let v = vec![1, 2, 3, 4];
// делаем что-то с v
} // <- v выходит из области видимости и освобождается здесь
}Когда вектор удаляется, всё его содержимое также удаляется, то есть хранящиеся в нём целые числа очищаются. Проверка заимствований гарантирует, что любые ссылки на содержимое вектора используются только пока сам вектор корректен.
Перейдём к следующему типу коллекции: String!
Хранение текста в кодировке UTF-8 с помощью строк
Хранение текста в кодировке UTF-8 с помощью строк
Мы говорили о строках в главе 4, но теперь рассмотрим их более подробно. Новички в Rust обычно застревают на строках из-за сочетания трёх причин: склонности Rust к раскрытию возможных ошибок, того, что строки являются более сложной структурой данных, чем многие программисты готовы признать, и UTF-8. Эти факторы сочетаются так, что это может показаться сложным, когда вы приходите из других языков программирования.
Мы обсуждаем строки в контексте коллекций, потому что строки реализованы как коллекция байтов, плюс некоторые методы для обеспечения полезной функциональности, когда эти байты интерпретируются как текст. В этом разделе мы поговорим об операциях над String, которые есть у каждого типа коллекции, таких как создание, обновление и чтение. Мы также обсудим способы, которыми String отличается от других коллекций, а именно то, как индексация в String усложняется различиями между тем, как люди и компьютеры интерпретируют данные String.
Определение строк
Сначала мы определим, что мы подразумеваем под термином строка. В Rust есть только один строковый тип в основном языке, и это срез строки str, который обычно встречается в его заимствованной форме &str. В главе 4 мы говорили о срезах строк, которые являются ссылками на некоторые данные строки в кодировке UTF-8, хранящиеся в другом месте. Строковые литералы, например, хранятся в двоичном файле программы и поэтому являются срезами строк.
Тип String, который предоставляется стандартной библиотекой Rust, а не встроен в основной язык, — это расширяемый, изменяемый, владеющий строковый тип в кодировке UTF-8. Когда Rustaceans говорят о «строках» в Rust, они могут иметь в виду либо тип String, либо тип среза строки &str, а не только один из этих типов. Хотя этот раздел в основном о String, оба типа широко используются в стандартной библиотеке Rust, и оба — String и срезы строк — закодированы в UTF-8.
Создание новой строки
Многие из тех же операций, доступных с Vec<T>, доступны и с String, потому что String на самом деле реализован как обёртка вокруг вектора байтов с некоторыми дополнительными гарантиями, ограничениями и возможностями. Пример функции, которая работает одинаково с Vec<T> и String, — это функция new для создания экземпляра, показанная в листинге 8-11.
fn main() {
let mut s = String::new();
}StringЭта строка создаёт новую пустую строку с именем s, в которую мы затем можем загрузить данные. Часто у нас есть некоторые начальные данные, с которых мы хотим начать строку. Для этого мы используем метод to_string, который доступен для любого типа, реализующего трейт Display, как и строковые литералы. Листинг 8-12 показывает два примера.
fn main() {
let data = "initial contents";
let s = data.to_string();
// Метод также работает непосредственно с литералом:
let s = "initial contents".to_string();
}to_string для создания String из строкового литералаЭтот код создаёт строку, содержащую initial contents.
Мы также можем использовать функцию String::from для создания String из строкового литерала. Код в листинге 8-13 эквивалентен коду в листинге 8-12, который использует to_string.
fn main() {
let s = String::from("initial contents");
}String::from для создания String из строкового литералаПоскольку строки используются для стольких вещей, мы можем использовать множество различных обобщённых API для строк, предоставляя нам много возможностей. Некоторые из них могут показаться избыточными, но у всех есть своё место! В этом случае String::from и to_string делают одно и то же, поэтому то, что вы выберете, — вопрос стиля и читаемости.
Помните, что строки закодированы в UTF-8, поэтому мы можем включать в них любые правильно закодированные данные, как показано в листинге 8-14.
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}Все они являются допустимыми значениями String.
Обновление строки
String может расти в размере, и её содержимое может меняться, так же как содержимое Vec<T>, если вы добавляете в неё больше данных. Кроме того, вы можете удобно использовать оператор + или макрос format! для конкатенации значений String.
Добавление с помощью push_str или push
Мы можем увеличить String, используя метод push_str для добавления среза строки, как показано в листинге 8-15.
fn main() {
let mut s = String::from("foo");
s.push_str("bar");
}String с помощью метода push_strПосле этих двух строк s будет содержать foobar. Метод push_str принимает срез строки, потому что мы не обязательно хотим брать на себя владение параметром. Например, в коде в листинге 8-16 мы хотим иметь возможность использовать s2 после добавления его содержимого к s1.
fn main() {
let mut s1 = String::from("foo");
let s2 = "bar";
s1.push_str(s2);
println!("s2 is {s2}");
}StringЕсли бы метод push_str брал на себя владение s2, мы не смогли бы напечатать его значение в последней строке. Однако этот код работает так, как мы и ожидали!
Метод push принимает один символ в качестве параметра и добавляет его к String. Листинг 8-17 добавляет букву l к String с помощью метода push.
fn main() {
let mut s = String::from("lo");
s.push('l');
}String с помощью pushВ результате s будет содержать lol.
Конкатенация с помощью + или format!
Часто вам нужно объединить две существующие строки. Один из способов сделать это — использовать оператор +, как показано в листинге 8-18.
fn main() {
let s1 = String::from("Hello, ");
let s2 = String::from("world!");
let s3 = s1 + &s2; // обратите внимание: s1 была перемещена сюда и больше не может использоваться
}+ для объединения двух значений String в новое значение StringСтрока s3 будет содержать Hello, world!. Причина, по которой s1 больше не действительна после сложения, и причина, по которой мы использовали ссылку на s2, связаны с сигнатурой метода, который вызывается при использовании оператора +. Оператор + использует метод add, сигнатура которого выглядит примерно так:
fn add(self, s: &str) -> String {В стандартной библиотеке вы увидите add, определённый с использованием обобщений и ассоциированных типов. Здесь мы подставили конкретные типы, что происходит, когда мы вызываем этот метод со значениями String. Мы обсудим обобщения в главе 10. Эта сигнатура даёт нам подсказки, необходимые для понимания хитрых моментов оператора +.
Во-первых, у s2 есть &, что означает, что мы добавляем ссылку на вторую строку к первой строке. Это связано с параметром s в функции add: мы можем добавлять срез строки только к String; мы не можем сложить два значения String вместе. Но подождите — тип &s2 — это &String, а не &str, как указано во втором параметре add. Так почему же листинг 8-18 компилируется?
Причина, по которой мы можем использовать &s2 в вызове add, заключается в том, что компилятор может привести аргумент &String к &str. Когда мы вызываем метод add, Rust использует разыменовывающее приведение (deref coercion), которое здесь превращает &s2 в &s2[..]. Мы обсудим разыменовывающее приведение более подробно в главе 15. Поскольку add не берёт на себя владение параметром s, s2 всё ещё будет действительной String после этой операции.
Во-вторых, мы можем видеть в сигнатуре, что add берёт на себя владение self, потому что у self нет &. Это означает, что s1 в листинге 8-18 будет перемещён в вызов add и больше не будет действителен после этого. Так что, хотя let s3 = s1 + &s2; выглядит так, как будто он скопирует обе строки и создаст новую, эта инструкция на самом деле берёт на себя владение s1, добавляет копию содержимого s2 и затем возвращает владение результатом. Другими словами, кажется, что он делает много копий, но это не так; реализация эффективнее копирования.
Если нам нужно объединить несколько строк, поведение оператора + становится громоздким:
fn main() {
let s1 = String::from("tic");
let s2 = String::from("tac");
let s3 = String::from("toe");
let s = s1 + "-" + &s2 + "-" + &s3;
}На этом этапе s будет tic-tac-toe. Со всеми этими символами + и " трудно понять, что происходит. Для более сложных способов объединения строк мы можем вместо этого использовать макрос format!:
fn main() {
let s1 = String::from("tic");
let s2 = String::from("tac");
let s3 = String::from("toe");
let s = format!("{s1}-{s2}-{s3}");
}Этот код также устанавливает s в tic-tac-toe. Макрос format! работает как println!, но вместо вывода на экран он возвращает String с содержимым. Версия кода с использованием format! гораздо легче читается, и код, генерируемый макросом format!, использует ссылки, так что этот вызов не берёт на себя владение ни одним из своих параметров.
Индексация строк
Во многих других языках программирования доступ к отдельным символам в строке по индексу является допустимой и распространённой операцией. Однако если вы попытаетесь получить доступ к частям String, используя синтаксис индексации в Rust, вы получите ошибку. Рассмотрим недопустимый код в листинге 8-19.
fn main() {
let s1 = String::from("hi");
let h = s1[0];
}StringЭтот код приведёт к следующей ошибке:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
error[E0277]: the type `str` cannot be indexed by `{integer}`
--> src/main.rs:3:16
|
3 | let h = s1[0];
| ^ string indices are ranges of `usize`
|
= help: the trait `SliceIndex<str>` is not implemented for `{integer}`
= note: you can use `.chars().nth()` or `.bytes().nth()`
for more information, see chapter 8 in The Book: <https://doc.rust-lang.org/book/ch08-02-strings.html#indexing-into-strings>
help: `usize` implements trait `SliceIndex<T>`
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/slice/index.rs:214:0
|
= note: `SliceIndex<[T]>`
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/core/src/bstr/traits.rs:197:0
|
= note: `SliceIndex<ByteStr>`
= note: required for `String` to implement `Index<{integer}>`
For more information about this error, try `rustc --explain E0277`.
error: could not compile `collections` (bin "collections") due to 1 previous error
Ошибка рассказывает всю историю: строки Rust не поддерживают индексацию. Но почему нет? Чтобы ответить на этот вопрос, нам нужно обсудить, как Rust хранит строки в памяти.
Внутреннее представление
String — это обёртка над Vec<u8>. Давайте посмотрим на некоторые из наших правильно закодированных примеров строк UTF-8 из листинга 8-14. Сначала на эту:
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}В этом случае len будет равно 4, что означает, что вектор, хранящий строку "Hola", имеет длину 4 байта. Каждая из этих букв занимает 1 байт в кодировке UTF-8. Следующая строка, однако, может вас удивить (обратите внимание, что эта строка начинается с заглавной кириллической буквы Зе, а не с цифры 3):
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}Если бы вас спросили, какой длины эта строка, вы могли бы сказать 12. На самом деле ответ Rust — 24: это количество байтов, необходимое для кодирования «Здравствуйте» в UTF-8, потому что каждое скалярное значение Unicode в этой строке занимает 2 байта памяти. Следовательно, индекс в байтах строки не всегда будет соответствовать допустимому скалярному значению Unicode. Чтобы продемонстрировать это, рассмотрим этот недопустимый код Rust:
let hello = "Здравствуйте";
let answer = &hello[0];Вы уже знаете, что answer не будет З, первой буквой. В кодировке UTF-8 первый байт З — это 208, а второй — 151, так что казалось бы, что answer должен на самом деле быть 208, но 208 сам по себе не является допустимым символом. Возврат 208, вероятно, не то, что хотел бы пользователь, если бы он попросил первую букву этой строки; однако это единственные данные, которые есть у Rust по байтовому индексу 0. Пользователи обычно не хотят получать байтовое значение, даже если строка содержит только латинские буквы: если бы &"hi"[0] был допустимым кодом, возвращающим байтовое значение, он вернул бы 104, а не h.
Ответ, таким образом, заключается в том, что чтобы избежать возврата неожиданного значения и вызвать ошибки, которые могут быть не обнаружены сразу, Rust вообще не компилирует этот код и предотвращает недоразумения на ранней стадии процесса разработки.
Байты, скалярные значения и кластеры графем
Ещё один момент о UTF-8 заключается в том, что на самом деле существует три значимых способа смотреть на строки с точки зрения Rust: как на байты, как на скалярные значения и как на кластеры графем (наиболее близкое к тому, что мы назвали бы буквами).
Если мы посмотрим на хинди слово «नमस्ते», написанное шрифтом деванагари, оно хранится как вектор значений u8, который выглядит так:
[224, 164, 168, 224, 164, 174, 224, 164, 184, 224, 165, 141, 224, 164, 164,
224, 165, 135]
Это 18 байтов, и именно так компьютеры в конечном итоге хранят эти данные. Если мы посмотрим на них как на скалярные значения Unicode, которыми является тип char в Rust, эти байты выглядят так:
['न', 'म', 'स', '्', 'त', 'े']
Здесь шесть значений char, но четвёртое и шестое не являются буквами: это диакритические знаки, которые не имеют смысла сами по себе. Наконец, если мы посмотрим на них как на кластеры графем, мы получим то, что человек назвал бы четырьмя буквами, составляющими слово на хинди:
["न", "म", "स्", "ते"]
Rust предоставляет различные способы интерпретации необработанных строковых данных, которые хранят компьютеры, чтобы каждая программа могла выбрать нужную ей интерпретацию, на каком бы человеческом языке ни были данные.
Последняя причина, по которой Rust не позволяет нам индексировать String для получения символа, заключается в том, что операции индексации, как ожидается, всегда занимают постоянное время (O(1)). Но невозможно гарантировать такую производительность с String, потому что Rust пришлось бы проходить по содержимому с начала до индекса, чтобы определить, сколько допустимых символов было.
Срезы строк
Индексация строки часто является плохой идеей, потому что неясно, каким должен быть возвращаемый тип операции индексации строки: байтовое значение, символ, кластер графем или срез строки. Поэтому, если вам действительно нужно использовать индексы для создания срезов строк, Rust просит вас быть более конкретным.
Вместо индексации с помощью [] с одним числом вы можете использовать [] с диапазоном, чтобы создать срез строки, содержащий определённые байты:
#![allow(unused)]
fn main() {
let hello = "Здравствуйте";
let s = &hello[0..4];
}Здесь s будет &str, содержащим первые 4 байта строки. Ранее мы упоминали, что каждый из этих символов занимает 2 байта, что означает, что s будет Зд.
Если бы мы попытались срезать только часть байтов символа с помощью чего-то вроде &hello[0..1], Rust запаниковал бы во время выполнения так же, как если бы был получен доступ к недопустимому индексу в векторе:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/collections`
thread 'main' (6017738) panicked at src/main.rs:4:19:
end byte index 1 is not a char boundary; it is inside 'З' (bytes 0..2 of string)
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Следует соблюдать осторожность при создании срезов строк с диапазонами, потому что это может привести к аварийному завершению программы.
Итерация по строкам
Лучший способ работать с частями строк — быть явным относительно того, хотите ли вы символы или байты. Для отдельных скалярных значений Unicode используйте метод chars. Вызов chars для «Зд» разделяет и возвращает два значения типа char, и вы можете итерировать по результату, чтобы получить доступ к каждому элементу:
#![allow(unused)]
fn main() {
for c in "Зд".chars() {
println!("{c}");
}
}Этот код напечатает следующее:
З
д
В качестве альтернативы метод bytes возвращает каждый необработанный байт, что может быть уместно для вашей предметной области:
#![allow(unused)]
fn main() {
for b in "Зд".bytes() {
println!("{b}");
}
}Этот код напечатает 4 байта, составляющие эту строку:
208
151
208
180
Но помните, что допустимые скалярные значения Unicode могут состоять более чем из 1 байта.
Получение кластеров графем из строк, как в случае с шрифтом деванагари, является сложной задачей, поэтому эта функциональность не предоставляется стандартной библиотекой. Крейты доступны на crates.io, если вам нужна такая функциональность.
Обработка сложностей строк
Подводя итог, строки сложны. Разные языки программирования делают разные выборы в том, как представить эту сложность программисту. Rust решил сделать правильную обработку данных String поведением по умолчанию для всех программ на Rust, что означает, что программисты должны больше думать об обработке данных UTF-8 заранее. Этот компромисс раскрывает больше сложности строк, чем очевидно в других языках программирования, но он предотвращает необходимость обрабатывать ошибки, связанные с не-ASCII символами, позже в жизненном цикле разработки.
Хорошая новость заключается в том, что стандартная библиотека предлагает много функциональности, построенной на типах String и &str, чтобы помочь правильно обрабатывать эти сложные ситуации. Обязательно ознакомьтесь с документацией для полезных методов, таких как contains для поиска в строке и replace для замены частей строки на другую строку.
Давайте переключимся на что-то немного менее сложное: хеш-таблицы!
Хранение ключей со связанными значениями в хеш-картах
Хранение ключей со связанными значениями в хеш-картах
Последняя из наших общих коллекций — это хеш-карта. Тип HashMap<K, V> хранит сопоставление ключей типа K со значениями типа V, используя хеш-функцию, которая определяет, как он размещает эти ключи и значения в памяти. Многие языки программирования поддерживают этот вид структуры данных, но часто используют другое название, например hash, map, object, hash table, dictionary или associative array, и это лишь некоторые из них.
Хеш-карты полезны, когда нужно искать данные не по индексу, как в векторах, а по ключу, который может быть любого типа. Например, в игре можно отслеживать счёт каждой команды в хеш-карте, где каждый ключ — это название команды, а значения — счёт каждой команды. По названию команды можно получить её счёт.
В этом разделе мы рассмотрим базовый API хеш-карт, но в функциях, определённых для HashMap<K, V> стандартной библиотекой, скрывается много других полезных возможностей. Как всегда, обратитесь к документации стандартной библиотеки для получения дополнительной информации.
Создание новой хеш-карты
Один из способов создать пустую хеш-карту — использовать new и добавлять элементы с помощью insert. В листинге 8-20 мы отслеживаем счёт двух команд, названных Blue и Yellow. Команда Blue начинает с 10 очков, а команда Yellow — с 50.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
}Обратите внимание, что сначала нужно использовать use для HashMap из части коллекций стандартной библиотеки. Из наших трёх общих коллекций эта используется реже всего, поэтому она не включена в функциональность, автоматически импортируемую в прелюдию. Хеш-карты также имеют меньшую поддержку со стороны стандартной библиотеки; например, для них нет встроенного макроса для конструирования.
Как и векторы, хеш-карты хранят свои данные в куче. Эта HashMap имеет ключи типа String и значения типа i32. Как и векторы, хеш-карты однородны: все ключи должны иметь один и тот же тип, и все значения должны иметь один и тот же тип.
Доступ к значениям в хеш-карте
Мы можем получить значение из хеш-карты, передав его ключ методу get, как показано в листинге 8-21.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
let team_name = String::from("Blue");
let score = scores.get(&team_name).copied().unwrap_or(0);
}Здесь score будет иметь значение, связанное с командой Blue, и результатом будет 10. Метод get возвращает Option<&V>; если для этого ключа в хеш-карте нет значения, get вернёт None. Эта программа обрабатывает Option, вызывая copied, чтобы получить Option<i32> вместо Option<&i32>, а затем unwrap_or, чтобы установить score в ноль, если scores не имеет записи для этого ключа.
Мы можем итерироваться по каждой паре ключ-значение в хеш-карте аналогично тому, как мы это делаем с векторами, используя цикл for:
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
for (key, value) in &scores {
println!("{key}: {value}");
}
}Этот код напечатает каждую пару в произвольном порядке:
Yellow: 50
Blue: 10
Управление владением в хеш-картах
Для типов, реализующих трейт Copy, таких как i32, значения копируются в хеш-карту. Для владеемых значений, таких как String, значения будут перемещены, и хеш-карта станет владельцем этих значений, как показано в листинге 8-22.
fn main() {
use std::collections::HashMap;
let field_name = String::from("Favorite color");
let field_value = String::from("Blue");
let mut map = HashMap::new();
map.insert(field_name, field_value);
// field_name и field_value здесь недействительны; попробуйте использовать их и
// посмотрите, какую ошибку компилятора вы получите!
}Мы не можем использовать переменные field_name и field_value после того, как они были перемещены в хеш-карту вызовом insert.
Если мы вставляем в хеш-карту ссылки на значения, значения не будут перемещены в хеш-карту. Значения, на которые указывают ссылки, должны быть действительны как минимум столько же, сколько действительна хеш-карта. Мы поговорим больше об этих вопросах в разделе «Проверка ссылок с помощью времён жизни» главы 10.
Обновление хеш-карты
Хотя количество пар ключ-значение может расти, каждый уникальный ключ может иметь только одно связанное с ним значение одновременно (но не наоборот: например, и команда Blue, и команда Yellow могли бы иметь значение 10, хранящееся в хеш-карте scores).
Когда вы хотите изменить данные в хеш-карте, вы должны решить, как обрабатывать случай, когда ключ уже имеет связанное значение. Вы можете заменить старое значение новым, полностью игнорируя старое значение. Вы можете сохранить старое значение и игнорировать новое, добавляя новое значение только если ключ не имеет значения. Или вы можете объединить старое значение и новое значение. Давайте посмотрим, как сделать каждое из этих действий!
Перезапись значения
Если мы вставляем ключ и значение в хеш-карту, а затем вставляем тот же ключ с другим значением, значение, связанное с этим ключом, будет заменено. Хотя код в листинге 8-23 вызывает insert дважды, хеш-карта будет содержать только одну пару ключ-значение, потому что мы вставляем значение для ключа команды Blue оба раза.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Blue"), 25);
println!("{scores:?}");
}Этот код напечатает {"Blue": 25}. Исходное значение 10 было перезаписано.
Добавление ключа и значения, только если ключ отсутствует
Часто нужно проверить, существует ли уже определённый ключ в хеш-карте со значением, и затем выполнить следующие действия: если ключ действительно существует в хеш-карте, существующее значение должно остаться таким, какое оно есть; если ключ не существует, вставить его и значение для него.
Хеш-карты имеют специальный API для этого, называемый entry, который принимает ключ, который вы хотите проверить, в качестве параметра. Возвращаемое значение метода entry — это перечисление, называемое Entry, которое представляет значение, которое может существовать или не существовать. Допустим, мы хотим проверить, имеет ли ключ для команды Yellow связанное с ним значение. Если нет, мы хотим вставить значение 50, и то же самое для команды Blue. Используя API entry, код выглядит как в листинге 8-24.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.entry(String::from("Yellow")).or_insert(50);
scores.entry(String::from("Blue")).or_insert(50);
println!("{scores:?}");
}entry для вставки, только если ключ ещё не имеет значенияМетод or_insert на Entry определён так, чтобы возвращать изменяемую ссылку на значение для соответствующего ключа Entry, если этот ключ существует, а если нет, он вставляет параметр как новое значение для этого ключа и возвращает изменяемую ссылку на новое значение. Этот приём намного чище, чем писать логику самостоятельно, и, кроме того, лучше работает с проверкой заимствований.
Запуск кода в листинге 8-24 напечатает {"Yellow": 50, "Blue": 10}. Первый вызов entry вставит ключ для команды Yellow со значением 50, потому что у команды Yellow ещё нет значения. Второй вызов entry не изменит хеш-карту, потому что у команды Blue уже есть значение 10.
Обновление значения на основе старого значения
Другой распространённый вариант использования хеш-карт — найти значение ключа, а затем обновить его на основе старого значения. Например, в листинге 8-25 показан код, который подсчитывает, сколько раз каждое слово встречается в некотором тексте. Мы используем хеш-карту со словами в качестве ключей и увеличиваем значение, чтобы отслеживать, сколько раз мы видели это слово. Если это первый раз, когда мы видим слово, мы сначала вставим значение 0.
fn main() {
use std::collections::HashMap;
let text = "hello world wonderful world";
let mut map = HashMap::new();
for word in text.split_whitespace() {
let count = map.entry(word).or_insert(0);
*count += 1;
}
println!("{map:?}");
}Этот код напечатает {"world": 2, "hello": 1, "wonderful": 1}. Вы можете увидеть те же пары ключ-значение, напечатанные в другом порядке: вспомните из раздела «Доступ к значениям в хеш-карте», что итерация по хеш-карте происходит в произвольном порядке.
Метод split_whitespace возвращает итератор по подрезам значения в text, разделённым пробельными символами. Метод or_insert возвращает изменяемую ссылку (&mut V) на значение для указанного ключа. Здесь мы сохраняем эту изменяемую ссылку в переменной count, поэтому для присваивания этому значению мы должны сначала разыменовать count с помощью звёздочки (*). Изменяемая ссылка выходит из области видимости в конце цикла for, поэтому все эти изменения безопасны и разрешены правилами заимствования.
Хеш-функции
По умолчанию HashMap использует хеш-функцию под названием SipHash, которая может обеспечить устойчивость к атакам типа «отказ в обслуживании» (DoS), связанным с хеш-таблицами1. Это не самый быстрый доступный алгоритм хеширования, но компромисс ради лучшей безопасности за счёт снижения производительности того стоит. Если вы профилируете свой код и обнаруживаете, что хеш-функция по умолчанию слишком медленна для ваших целей, вы можете переключиться на другую функцию, указав другой хешер. Хешер — это тип, реализующий трейт BuildHasher. Мы поговорим о трейтах и о том, как их реализовать, в главе 10. Вам не обязательно реализовывать свой собственный хешер с нуля; crates.io содержит библиотеки, которыми поделились другие пользователи Rust, предоставляющие хешеры, реализующие многие распространённые алгоритмы хеширования.
Итоги
Векторы, строки и хеш-карты обеспечат большой объём функциональности, необходимой в программах, когда нужно хранить, получать доступ и изменять данные. Вот несколько упражнений, которые вы теперь готовы решить:
- Дан список целых чисел. Используйте вектор, чтобы вернуть медиану (при сортировке значение в средней позиции) и моду (значение, которое встречается чаще всего; здесь будет полезна хеш-карта) списка.
- Преобразуйте строки в поросячью латынь. Первая согласная каждого слова перемещается в конец слова и добавляется ay, поэтому first становится irst-fay. Слова, начинающиеся с гласной, вместо этого получают hay, добавленное в конец (apple становится apple-hay). Помните о деталях кодировки UTF-8!
- Используя хеш-карту и векторы, создайте текстовый интерфейс, позволяющий пользователю добавлять имена сотрудников в отдел компании; например, «Добавить Салли в Инженерию» или «Добавить Амира в Продажи». Затем позвольте пользователю получить список всех людей в отделе или всех людей в компании по отделам, отсортированный по алфавиту.
Документация API стандартной библиотеки описывает методы, которые есть у векторов, строк и хеш-карт, и которые будут полезны для этих упражнений!
Мы переходим к более сложным программам, в которых операции могут завершаться неудачей, поэтому это идеальное время, чтобы обсудить обработку ошибок. Мы сделаем это далее!
Обработка ошибок
Обработка ошибок
Ошибки — это неотъемлемая часть программного обеспечения, поэтому в Rust есть ряд возможностей для обработки ситуаций, в которых что-то идёт не так. Во многих случаях Rust требует признать возможность ошибки и предпринять некоторые действия, прежде чем ваш код скомпилируется. Это требование делает вашу программу более надёжной, гарантируя, что вы обнаружите ошибки и обработаете их должным образом, прежде чем развернуть ваш код в производство!
Rust делит ошибки на две основные категории: исправимые и неисправимые ошибки. Для исправимой ошибки, такой как ошибка файл не найден, мы, скорее всего, просто хотим сообщить о проблеме пользователю и повторить операцию. Неисправимые ошибки всегда являются симптомами ошибок в коде, таких как попытка получить доступ к местоположению за концом массива, поэтому мы хотим немедленно остановить программу.
Большинство языков не различают эти два вида ошибок и обрабатывают
оба одинаково, используя такие механизмы, как исключения. В Rust нет
исключений. Вместо этого есть тип Result<T, E> для исправимых ошибок и
макрос panic!, который останавливает выполнение, когда программа сталкивается с
неисправимой ошибкой. В этой главе сначала рассматривается вызов panic!, а затем
обсуждается возврат значений Result<T, E>. Кроме того, мы рассмотрим
соображения при решении, пытаться ли восстановиться после ошибки или остановить
выполнение.
Невосстановимые ошибки с panic!
Невосстановимые ошибки с panic!
Иногда в коде случаются плохие вещи, и с этим ничего нельзя сделать.
В таких случаях в Rust есть макрос panic!. На практике вызвать
панику можно двумя способами: выполнив действие, вызывающее панику в коде (например,
обращение к массиву за пределами его границ), или явно вызвав макрос panic!.
В обоих случаях в программе возникает паника. По умолчанию такие паники
выводят сообщение о сбое, разворачивают, очищают стек и завершают программу.
С помощью переменной окружения можно также заставить Rust отображать стек вызовов при
возникновении паники, чтобы было проще отследить источник паники.
Развёртывание стека или аварийное завершение в ответ на панику
По умолчанию при возникновении паники программа начинает развёртывание, что означает, что Rust идёт обратно вверх по стеку и очищает данные из каждой встреченной функции. Однако ходить обратно и очищать — это большая работа. Поэтому Rust позволяет выбрать альтернативу — немедленное аварийное завершение, которое завершает программу без очистки.
Память, которую использовала программа, затем должна быть очищена
операционной системой. Если в проекте нужно сделать результирующий бинарный файл как можно
меньше, можно переключиться с развёртывания на аварийное завершение при панике, добавив
panic = 'abort' в соответствующие секции [profile] файла
Cargo.toml. Например, если требуется аварийно завершаться при панике в режиме release,
добавьте:
[profile.release]
panic = 'abort'
Попробуем вызвать panic! в простой программе:
fn main() {
panic!("crash and burn");
}При запуске программы будет выведено примерно следующее:
$ cargo run
Compiling panic v0.1.0 (file:///projects/panic)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.25s
Running `target/debug/panic`
thread 'main' (6018279) panicked at src/main.rs:2:5:
crash and burn
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Вызов panic! вызывает сообщение об ошибке, содержащееся в последних двух строках.
Первая строка показывает сообщение паники и место в исходном коде, где
произошла паника: src/main.rs:2:5 указывает, что это вторая строка,
пятый символ файла src/main.rs.
В этом случае указанная строка является частью нашего кода, и если перейти к этой
строке, можно увидеть вызов макроса panic!. В других случаях вызов panic! может
находиться в коде, который вызывает наш код, и имя файла и номер строки, сообщаемые
в сообщении об ошибке, будут относиться к чужому коду, где вызывается
макрос panic!, а не к строке нашего кода, которая в конечном итоге привела к
вызову panic!.
Можно использовать трассировку функций, из которых пришёл вызов panic!, чтобы выяснить,
какая часть кода вызывает проблему. Чтобы понять, как использовать
трассировку паники panic!, рассмотрим другой пример и посмотрим, как это происходит, когда
вызов panic! приходит из библиотеки из-за ошибки в нашем коде, а не
из нашего кода, напрямую вызывающего макрос. В листинге 9-1 приведён код, который
пытается обратиться к индексу вектора за пределами диапазона допустимых индексов.
fn main() {
let v = vec![1, 2, 3];
v[99];
}panic!Здесь выполняется попытка обратиться к 100-му элементу вектора (который находится по
индексу 99, поскольку индексация начинается с нуля), но вектор содержит только три
элемента. В этой ситуации Rust вызовет панику. Использование [] должно возвращать
элемент, но при передаче недопустимого индекса нет элемента, который Rust
мог бы здесь вернуть корректно.
В C попытка чтения за концом структуры данных — это неопределённое поведение. Можно получить то, что находится в памяти в том месте, которое соответствовало бы этому элементу в структуре данных, даже если эта память не принадлежит этой структуре. Это называется переполнением буфера при чтении и может привести к уязвимостям безопасности, если злоумышленник сможет манипулировать индексом таким образом, чтобы прочитать данные, которые ему не положено читать, хранящиеся после структуры данных.
Чтобы защитить программу от такого рода уязвимостей, при попытке прочитать элемент по индексу, которого не существует, Rust остановит выполнение и откажется продолжать. Попробуем и посмотрим:
$ cargo run
Compiling panic v0.1.0 (file:///projects/panic)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.27s
Running `target/debug/panic`
thread 'main' (6017887) panicked at src/main.rs:4:6:
index out of bounds: the len is 3 but the index is 99
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Эта ошибка указывает на строку 4 файла main.rs, где выполняется попытка обратиться к индексу
99 вектора в v.
Строка note: сообщает, что можно установить переменную окружения RUST_BACKTRACE,
чтобы получить трассировку того, что именно произошло и вызвало ошибку. Трассировка — это
список всех функций, которые были вызваны, чтобы дойти до этой
точки. Трассировки в Rust работают так же, как в других языках: ключ к
чтению трассировки — начать сверху и читать до тех пор, пока не встретятся файлы,
написанные вами. Это и есть место, где возникла проблема. Строки выше этого места
— это код, который вызвал ваш код; строки ниже — это код, который вызвал
ваш код. Эти строки до и после могут включать код ядра Rust, код стандартной
библиотеки или крейты, которые используются. Попробуем получить трассировку, установив
переменную окружения RUST_BACKTRACE в любое значение, кроме 0.
В листинге 9-2 показан вывод, похожий на тот, который будет получен.
$ RUST_BACKTRACE=1 cargo run
thread 'main' panicked at src/main.rs:4:6:
index out of bounds: the len is 3 but the index is 99
stack backtrace:
0: rust_begin_unwind
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/std/src/panicking.rs:692:5
1: core::panicking::panic_fmt
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/core/src/panicking.rs:75:14
2: core::panicking::panic_bounds_check
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/core/src/panicking.rs:273:5
3: <usize as core::slice::index::SliceIndex<[T]>>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/slice/index.rs:274:10
4: core::slice::index::<impl core::ops::index::Index<I> for [T]>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/slice/index.rs:16:9
5: <alloc::vec::Vec<T,A> as core::ops::index::Index<I>>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/alloc/src/vec/mod.rs:3361:9
6: panic::main
at ./src/main.rs:4:6
7: core::ops::function::FnOnce::call_once
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/ops/function.rs:250:5
note: Some details are omitted, run with `RUST_BACKTRACE=full` for a verbose backtrace.
panic!, отображаемая при установленной переменной окружения RUST_BACKTRACEЭто очень много вывода! Точный вывод может отличаться в зависимости
от операционной системы и версии Rust. Чтобы получить трассировки с этой
информацией, должны быть включены отладочные символы. Отладочные символы включены
по умолчанию при использовании cargo build или cargo run без флага --release,
как здесь.
В выводе листинга 9-2 строка 6 трассировки указывает на строку в проекте, которая вызывает проблему: строку 4 файла src/main.rs. Если не нужно, чтобы программа вызывала панику, следует начать расследование с места, на которое указывает первая строка, упоминающая написанный вами файл. В листинге 9-1, где код намеренно написан так, чтобы вызвать панику, способ исправить панику — не запрашивать элемент за пределами диапазона индексов вектора. Когда код вызовет панику в будущем, нужно будет выяснить, какое действие выполняет код с какими значениями, вызывая панику, и что код должен делать вместо этого.
Вернёмся к panic! и к тому, когда следует, а когда не следует использовать panic! для
обработки ошибочных условий, в разделе «Вызывать panic! или не вызывать panic!» далее в этой
главе. Далее рассмотрим, как восстановиться после ошибки с помощью Result.
Восстановимые ошибки с Result
Восстановимые ошибки с Result
Большинство ошибок не настолько серьёзны, чтобы требовать полной остановки программы. Иногда, когда функция завершается неудачей, это происходит по причине, которую легко интерпретировать и на которую можно отреагировать. Например, если вы пытаетесь открыть файл, и эта операция не удаётся, потому что файл не существует, вы могли бы создать файл вместо завершения процесса.
Вспомните из раздела «Обработка потенциальной ошибки с помощью Result» главы 2, что перечисление Result определено как имеющее два варианта, Ok и Err, следующим образом:
#![allow(unused)]
fn main() {
enum Result<T, E> {
Ok(T),
Err(E),
}
}T и E — это обобщённые параметры типа: мы обсудим обобщения более подробно в главе 10. То, что нужно знать сейчас, — это то, что T представляет тип значения, которое будет возвращено в случае успеха внутри варианта Ok, а E представляет тип ошибки, которая будет возвращена в случае неудачи внутри варианта Err. Поскольку Result имеет эти обобщённые параметры типа, мы можем использовать тип Result и определённые на нём функции во многих различных ситуациях, где значение успеха и значение ошибки, которые мы хотим вернуть, могут различаться.
Давайте вызовем функцию, которая возвращает значение Result, потому что функция может завершиться неудачей. В листинге 9-3 мы пытаемся открыть файл.
use std::fs::File;
fn main() {
let greeting_file_result = File::open("hello.txt");
}Возвращаемый тип File::open — это Result<T, E>. Обобщённый параметр T был заполнен реализацией File::open типом значения успеха, std::fs::File, который является дескриптором файла. Тип E, используемый в значении ошибки, — std::io::Error. Этот возвращаемый тип означает, что вызов File::open может завершиться успешно и вернуть дескриптор файла, из которого мы можем читать или в который можем писать. Вызов функции также может завершиться неудачей: например, файл может не существовать, или у нас может не быть разрешения на доступ к файлу. Функции File::open нужен способ сообщить нам, завершилась ли она успешно или неудачей, и одновременно дать нам либо дескриптор файла, либо информацию об ошибке. Эта информация — именно то, что передаёт перечисление Result.
В случае, когда File::open завершается успешно, значение в переменной greeting_file_result будет экземпляром Ok, содержащим дескриптор файла. В случае неудачи значение в greeting_file_result будет экземпляром Err, содержащим больше информации о виде произошедшей ошибки.
Нам нужно добавить к коду в листинге 9-3 действия, зависящие от значения, возвращаемого File::open. Листинг 9-4 показывает один из способов обработки Result с помощью базового инструмента — выражения match, которое мы обсуждали в главе 6.
use std::fs::File;
fn main() {
let greeting_file_result = File::open("hello.txt");
let greeting_file = match greeting_file_result {
Ok(file) => file,
Err(error) => panic!("Problem opening the file: {error:?}"),
};
}match для обработки вариантов Result, которые могут быть возвращеныОбратите внимание, что, как и перечисление Option, перечисление Result и его варианты были введены в область видимости прелюдией, поэтому нам не нужно указывать Result:: перед вариантами Ok и Err в ветках match.
Когда результат — Ok, этот код вернёт внутреннее значение file из варианта Ok, и затем мы присвоим это значение дескриптора файла переменной greeting_file. После match мы можем использовать дескриптор файла для чтения или записи.
Другая ветка match обрабатывает случай, когда мы получаем значение Err от File::open. В этом примере мы решили вызвать макрос panic!. Если в текущем каталоге нет файла с именем hello.txt и мы запускаем этот код, мы увидим следующий вывод от макроса panic!:
$ cargo run
Compiling error-handling v0.1.0 (file:///projects/error-handling)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.73s
Running `target/debug/error-handling`
thread 'main' (6018048) panicked at src/main.rs:8:23:
Problem opening the file: Os { code: 2, kind: NotFound, message: "No such file or directory" }
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Как обычно, этот вывод говорит нам точно, что пошло не так.
Сопоставление с различными ошибками
Код в листинге 9-4 вызовет panic! независимо от причины, по которой File::open завершился неудачей. Однако мы хотим предпринимать различные действия для разных причин неудачи. Если File::open завершился неудачей, потому что файл не существует, мы хотим создать файл и вернуть дескриптор нового файла. Если File::open завершился неудачей по любой другой причине — например, потому что у нас нет разрешения на открытие файла — мы всё ещё хотим, чтобы код вызвал panic! так же, как в листинге 9-4. Для этого мы добавляем внутреннее выражение match, показанное в листинге 9-5.
use std::fs::File;
use std::io::ErrorKind;
fn main() {
let greeting_file_result = File::open("hello.txt");
let greeting_file = match greeting_file_result {
Ok(file) => file,
Err(error) => match error.kind() {
ErrorKind::NotFound => match File::create("hello.txt") {
Ok(fc) => fc,
Err(e) => panic!("Problem creating the file: {e:?}"),
},
_ => {
panic!("Problem opening the file: {error:?}");
}
},
};
}Тип значения, которое File::open возвращает внутри варианта Err, — это io::Error, который является структурой, предоставляемой стандартной библиотекой. Эта структура имеет метод kind, который мы можем вызвать, чтобы получить значение io::ErrorKind. Перечисление io::ErrorKind предоставляется стандартной библиотекой и имеет варианты, представляющие различные виды ошибок, которые могут возникнуть в результате операции io. Вариант, который мы хотим использовать, — ErrorKind::NotFound, который указывает, что файл, который мы пытаемся открыть, ещё не существует. Итак, мы сопоставляем с greeting_file_result, но у нас также есть внутреннее сопоставление с error.kind().
Условие, которое мы хотим проверить во внутреннем сопоставлении, — является ли значение, возвращённое error.kind(), вариантом NotFound перечисления ErrorKind. Если это так, мы пытаемся создать файл с помощью File::create. Однако, поскольку File::create также может завершиться неудачей, нам нужна вторая ветка во внутреннем выражении match. Когда файл не может быть создан, печатается другое сообщение об ошибке. Вторая ветка внешнего match остаётся той же, поэтому программа вызывает панику при любой ошибке, кроме ошибки отсутствия файла.
Альтернативы использованию match с Result<T, E>
Это очень много match! Выражение match очень полезно, но также очень примитивно. В главе 13 вы узнаете о замыканиях, которые используются со многими методами, определёнными для Result<T, E>. Эти методы могут быть более краткими, чем использование match при обработке значений Result<T, E> в вашем коде.
Например, вот другой способ написать ту же логику, что показана в листинге 9-5, на этот раз с использованием замыканий и метода unwrap_or_else:
use std::fs::File;
use std::io::ErrorKind;
fn main() {
let greeting_file = File::open("hello.txt").unwrap_or_else(|error| {
if error.kind() == ErrorKind::NotFound {
File::create("hello.txt").unwrap_or_else(|error| {
panic!("Problem creating the file: {error:?}");
})
} else {
panic!("Problem opening the file: {error:?}");
}
});
}Хотя этот код имеет то же поведение, что и листинг 9-5, он не содержит никаких выражений match и его чище читать. Вернитесь к этому примеру после того, как прочитаете главу 13, и посмотрите метод unwrap_or_else в документации стандартной библиотеки. Многие другие из этих методов могут очистить огромные, вложенные выражения match, когда вы имеете дело с ошибками.
Сокращения для паники при ошибке
Использование match работает достаточно хорошо, но может быть немного многословным и не всегда хорошо передаёт намерение. Тип Result<T, E> имеет много определённых для него вспомогательных методов для выполнения различных, более конкретных задач. Метод unwrap — это сокращённый метод, реализованный так же, как выражение match, которое мы написали в листинге 9-4. Если значение Result — это вариант Ok, unwrap вернёт значение внутри Ok. Если Result — это вариант Err, unwrap вызовет для нас макрос panic!. Вот пример unwrap в действии:
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt").unwrap();
}Если мы запустим этот код без файла hello.txt, мы увидим сообщение об ошибке от вызова panic!, который делает метод unwrap:
thread 'main' panicked at src/main.rs:4:49:
called `Result::unwrap()` on an `Err` value: Os { code: 2, kind: NotFound, message: "No such file or directory" }
Аналогично, метод expect позволяет нам также выбрать сообщение об ошибке для panic!. Использование expect вместо unwrap и предоставление хороших сообщений об ошибках может передать ваше намерение и облегчить отслеживание источника паники. Синтаксис expect выглядит так:
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt")
.expect("hello.txt should be included in this project");
}Мы используем expect так же, как unwrap: чтобы вернуть дескриптор файла или вызвать макрос panic!. Сообщение об ошибке, используемое expect в его вызове panic!, будет параметром, который мы передаём expect, а не сообщением panic! по умолчанию, которое использует unwrap. Вот как это выглядит:
thread 'main' panicked at src/main.rs:5:10:
hello.txt should be included in this project: Os { code: 2, kind: NotFound, message: "No such file or directory" }
В коде производственного качества большинство растацев выбирают expect, а не unwrap, и дают больше контекста о том, почему операция, как ожидается, всегда будет успешной. Таким образом, если ваши предположения когда-либо окажутся ошибочными, у вас будет больше информации для использования при отладке.
Распространение ошибок
Когда реализация функции вызывает что-то, что может завершиться неудачей, вместо обработки ошибки внутри самой функции вы можете вернуть ошибку вызывающему коду, чтобы он мог решить, что делать. Это известно как распространение ошибки, и это даёт больше контроля вызывающему коду, где может быть больше информации или логики, определяющей, как следует обрабатывать ошибку, чем то, что доступно вам в контексте вашего кода.
Например, листинг 9-6 показывает функцию, которая читает имя пользователя из файла. Если файл не существует или не может быть прочитан, эта функция вернёт эти ошибки коду, который вызвал функцию.
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let username_file_result = File::open("hello.txt");
let mut username_file = match username_file_result {
Ok(file) => file,
Err(e) => return Err(e),
};
let mut username = String::new();
match username_file.read_to_string(&mut username) {
Ok(_) => Ok(username),
Err(e) => Err(e),
}
}
}matchЭту функцию можно написать намного короче, но мы начнём с того, что сделаем многое вручную, чтобы исследовать обработку ошибок; в конце мы покажем более короткий способ. Давайте сначала посмотрим на возвращаемый тип функции: Result<String, io::Error>. Это означает, что функция возвращает значение типа Result<T, E>, где обобщённый параметр T был заполнен конкретным типом String, а обобщённый тип E был заполнен конкретным типом io::Error.
Если эта функция завершается успешно без каких-либо проблем, код, который вызывает эту функцию, получит значение Ok, содержащее String — имя пользователя, которое эта функция прочитала из файла. Если эта функция столкнётся с какими-либо проблемами, вызывающий код получит значение Err, содержащее экземпляр io::Error, который содержит больше информации о том, в чём были проблемы. Мы выбрали io::Error в качестве возвращаемого типа этой функции, потому что это оказался тип значения ошибки, возвращаемого обеими операциями, которые мы вызываем в теле этой функции и которые могут завершиться неудачей: функцией File::open и методом read_to_string.
Тело функции начинается с вызова функции File::open. Затем мы обрабатываем значение Result с помощью match, аналогичного match в листинге 9-4. Если File::open завершается успешно, дескриптор файла в переменной шаблона file становится значением изменяемой переменной username_file, и функция продолжается. В случае Err вместо вызова panic! мы используем ключевое слово return, чтобы досрочно выйти из функции полностью и передать значение ошибки от File::open, теперь в переменной шаблона e, обратно вызывающему коду как значение ошибки этой функции.
Итак, если у нас есть дескриптор файла в username_file, функция затем создаёт новую String в переменной username и вызывает метод read_to_string для дескриптора файла в username_file, чтобы прочитать содержимое файла в username. Метод read_to_string также возвращает Result, потому что он может завершиться неудачей, даже если File::open завершился успешно. Итак, нам нужен ещё один match для обработки этого Result: если read_to_string завершается успешно, то наша функция завершилась успешно, и мы возвращаем имя пользователя из файла, которое теперь находится в username, обёрнутое в Ok. Если read_to_string завершается неудачей, мы возвращаем значение ошибки так же, как мы возвращали значение ошибки в match, который обрабатывал возвращаемое значение File::open. Однако нам не нужно явно указывать return, потому что это последнее выражение в функции.
Код, который вызывает этот код, затем обработает получение либо значения Ok, содержащего имя пользователя, либо значения Err, содержащего io::Error. Вызывающий код решает, что делать с этими значениями. Если вызывающий код получает значение Err, он может вызвать panic! и аварийно завершить программу, использовать имя пользователя по умолчанию или искать имя пользователя где-то ещё, кроме файла, например. У нас нет достаточно информации о том, что на самом деле пытается сделать вызывающий код, поэтому мы распространяем всю информацию об успехе или ошибке наверх, чтобы он мог обработать её соответствующим образом.
Эта схема распространения ошибок настолько распространена в Rust, что Rust предоставляет оператор вопросительного знака ?, чтобы сделать это проще.
Сокращение с помощью оператора ?
Листинг 9-7 показывает реализацию read_username_from_file, которая имеет ту же функциональность, что и в листинге 9-6, но эта реализация использует оператор ?.
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let mut username_file = File::open("hello.txt")?;
let mut username = String::new();
username_file.read_to_string(&mut username)?;
Ok(username)
}
}??, размещённый после значения Result, определён так, чтобы работать почти так же, как выражения match, которые мы определили для обработки значений Result в листинге 9-6. Если значение Result — это Ok, значение внутри Ok будет возвращено из этого выражения, и программа продолжится. Если значение — это Err, Err будет возвращён из всей функции, как если бы мы использовали ключевое слово return, так что значение ошибки распространяется на вызывающий код.
Есть разница между тем, что делает выражение match из листинга 9-6, и тем, что делает оператор ?: значения ошибок, для которых был вызван оператор ?, проходят через функцию from, определённую в трейте From в стандартной библиотеке, которая используется для преобразования значений из одного типа в другой. Когда оператор ? вызывает функцию from, полученный тип ошибки преобразуется в тип ошибки, определённый в возвращаемом типе текущей функции. Это полезно, когда функция возвращает один тип ошибки для представления всех способов, которыми функция может завершиться неудачей, даже если части могут завершиться неудачей по многим различным причинам.
Например, мы могли бы изменить функцию read_username_from_file в листинге 9-7, чтобы она возвращала пользовательский тип ошибки с именем OurError, который мы определяем. Если мы также определим impl From<io::Error> for OurError для создания экземпляра OurError из io::Error, то вызовы оператора ? в теле read_username_from_file вызовут from и преобразуют типы ошибок без необходимости добавлять какой-либо дополнительный код в функцию.
В контексте листинга 9-7 ? в конце вызова File::open вернёт значение внутри Ok в переменную username_file. Если возникает ошибка, оператор ? досрочно вернётся из всей функции и передаст любое значение Err вызывающему коду. То же самое относится к ? в конце вызова read_to_string.
Оператор ? устраняет много шаблонного кода и делает реализацию этой функции проще. Мы могли бы даже сократить этот код дальше, объединив вызовы методов сразу после ?, как показано в листинге 9-8.
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let mut username = String::new();
File::open("hello.txt")?.read_to_string(&mut username)?;
Ok(username)
}
}?Мы переместили создание новой String в username в начало функции; эта часть не изменилась. Вместо создания переменной username_file мы объединили вызов read_to_string непосредственно с результатом File::open("hello.txt")?. У нас всё ещё есть ? в конце вызова read_to_string, и мы всё ещё возвращаем значение Ok, содержащее username, когда и File::open, и read_to_string завершаются успешно, а не возвращаем ошибки. Функциональность снова та же, что в листинге 9-6 и листинге 9-7; это просто другой, более эргономичный способ её написания.
Листинг 9-9 показывает способ сделать это ещё короче с использованием fs::read_to_string.
#![allow(unused)]
fn main() {
use std::fs;
use std::io;
fn read_username_from_file() -> Result<String, io::Error> {
fs::read_to_string("hello.txt")
}
}fs::read_to_string вместо открытия и затем чтения файлаЧтение файла в строку — довольно распространённая операция, поэтому стандартная библиотека предоставляет удобную функцию fs::read_to_string, которая открывает файл, создаёт новую String, читает содержимое файла, помещает содержимое в эту String и возвращает её. Конечно, использование fs::read_to_string не даёт нам возможности объяснить всю обработку ошибок, поэтому мы сначала сделали это более длинным способом.
Где использовать оператор ?
Оператор ? можно использовать только в функциях, возвращаемый тип которых совместим со значением, к которому применяется ?. Это потому, что оператор ? определён для выполнения досрочного возврата значения из функции, таким же образом, как выражение match, которое мы определили в листинге 9-6. В листинге 9-6 match использовал значение Result, и ветка досрочного возврата возвращала значение Err(e). Возвращаемый тип функции должен быть Result, чтобы он был совместим с этим return.
В листинге 9-10 давайте посмотрим на ошибку, которую мы получим, если используем оператор ? в функции main с возвращаемым типом, несовместимым с типом значения, к которому мы применяем ?.
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt")?;
}? в функции main, которая возвращает (), не скомпилируется.Этот код открывает файл, что может завершиться неудачей. Оператор ? следует за значением Result, возвращённым File::open, но эта функция main имеет возвращаемый тип (), а не Result. Когда мы компилируем этот код, мы получаем следующее сообщение об ошибке:
$ cargo run
Compiling error-handling v0.1.0 (file:///projects/error-handling)
error[E0277]: the `?` operator can only be used in a function that returns `Result` or `Option` (or another type that implements `FromResidual`)
--> src/main.rs:4:48
|
3 | fn main() {
| --------- this function should return `Result` or `Option` to accept `?`
4 | let greeting_file = File::open("hello.txt")?;
| ^ cannot use the `?` operator in a function that returns `()`
|
help: consider adding return type
|
3 ~ fn main() -> Result<(), Box<dyn std::error::Error>> {
4 | let greeting_file = File::open("hello.txt")?;
5 + Ok(())
|
For more information about this error, try `rustc --explain E0277`.
error: could not compile `error-handling` (bin "error-handling") due to 1 previous error
Эта ошибка указывает на то, что нам разрешено использовать оператор ? только в функции, которая возвращает Result, Option или другой тип, реализующий FromResidual.
Чтобы исправить ошибку, у вас есть два варианта. Один из вариантов — изменить возвращаемый тип вашей функции, чтобы он был совместим со значением, к которому вы применяете оператор ?, если у вас нет ограничений, препятствующих этому. Другой вариант — использовать match или один из методов Result<T, E> для обработки Result<T, E> любым подходящим способом.
Сообщение об ошибке также упомянуло, что ? можно использовать со значениями Option<T>. Как и при использовании ? с Result, вы можете использовать ? с Option только в функции, которая возвращает Option. Поведение оператора ? при вызове с Option<T> аналогично его поведению при вызове с Result<T, E>: если значение — None, None будет досрочно возвращён из функции в этот момент. Если значение — Some, значение внутри Some является результирующим значением выражения, и функция продолжается. Листинг 9-11 содержит пример функции, которая находит последний символ первой строки в заданном тексте.
fn last_char_of_first_line(text: &str) -> Option<char> {
text.lines().next()?.chars().last()
}
fn main() {
assert_eq!(
last_char_of_first_line("Hello, world\nHow are you today?"),
Some('d')
);
assert_eq!(last_char_of_first_line(""), None);
assert_eq!(last_char_of_first_line("\nhi"), None);
}? со значением Option<T>Эта функция возвращает Option<char>, потому что возможно, что там есть символ, но также возможно, что его нет. Этот код принимает аргумент среза строки text и вызывает для него метод lines, который возвращает итератор по строкам в строке. Поскольку эта функция хочет исследовать первую строку, она вызывает next для итератора, чтобы получить первое значение из итератора. Если text — пустая строка, этот вызов next вернёт None, и в этом случае мы используем ?, чтобы остановиться и вернуть None из last_char_of_first_line. Если text не пустая строка, next вернёт значение Some, содержащее срез строки первой строки в text.
? извлекает срез строки, и мы можем вызвать chars для этого среза строки, чтобы получить итератор по его символам. Нас интересует последний символ в этой первой строке, поэтому мы вызываем last, чтобы вернуть последний элемент в итераторе. Это Option, потому что возможно, что первая строка — пустая строка; например, если text начинается с пустой строки, но имеет символы на других строках, как в "\nhi". Однако, если в первой строке есть последний символ, он будет возвращён в варианте Some. Оператор ? в середине даёт нам краткий способ выразить эту логику, позволяя нам реализовать функцию в одну строку. Если бы мы не могли использовать оператор ? с Option, нам пришлось бы реализовать эту логику с помощью большего количества вызовов методов или выражения match.
Обратите внимание, что вы можете использовать оператор ? с Result в функции, которая возвращает Result, и вы можете использовать оператор ? с Option в функции, которая возвращает Option, но вы не можете смешивать их. Оператор ? не будет автоматически преобразовывать Result в Option или наоборот; в таких случаях вы можете использовать такие методы, как метод ok для Result или метод ok_or для Option, чтобы выполнить преобразование явно.
До сих пор все функции main, которые мы использовали, возвращают (). Функция main особенная, потому что она является точкой входа и выхода исполняемой программы, и есть ограничения на то, каким может быть её возвращаемый тип, чтобы программа вела себя как ожидается.
К счастью, main также может возвращать Result<(), E>. В листинге 9-12 есть код из листинга 9-10, но мы изменили возвращаемый тип main на Result<(), Box<dyn Error>> и добавили возвращаемое значение Ok(()) в конец. Этот код теперь скомпилируется.
use std::error::Error;
use std::fs::File;
fn main() -> Result<(), Box<dyn Error>> {
let greeting_file = File::open("hello.txt")?;
Ok(())
}main для возврата Result<(), E> позволяет использовать оператор ? со значениями Result.Тип Box<dyn Error> — это трейт-объект, о котором мы поговорим в разделе «Использование трейт-объектов для абстрагирования над общим поведением» главы 18. Пока вы можете читать Box<dyn Error> как «любой вид ошибки». Использование ? со значением Result в функции main с типом ошибки Box<dyn Error> разрешено, потому что это позволяет досрочно вернуть любое значение Err. Хотя тело этой функции main будет возвращать только ошибки типа std::io::Error, указав Box<dyn Error>, эта сигнатура останется правильной, даже если в тело main будет добавлен код, возвращающий другие ошибки.
Когда функция main возвращает Result<(), E>, исполняемый файл завершится со значением 0, если main вернёт Ok(()), и завершится с ненулевым значением, если main вернёт значение Err. Исполняемые файлы, написанные на C, возвращают целые числа при выходе: программы, которые завершаются успешно, возвращают целое число 0, а программы, которые завершаются с ошибкой, возвращают какое-то целое число, отличное от 0. Rust также возвращает целые числа из исполняемых файлов, чтобы быть совместимым с этой конвенцией.
Функция main может возвращать любые типы, реализующие трейт std::process::Termination, который содержит функцию report, возвращающую ExitCode. Обратитесь к документации стандартной библиотеки для получения дополнительной информации о реализации трейта Termination для ваших собственных типов.
Теперь, когда мы обсудили детали вызова panic! или возврата Result, давайте вернёмся к теме того, как решить, какой из них уместно использовать в каких случаях.
Вызывать panic! или не вызывать panic!
Вызывать panic! или не вызывать panic!
Итак, как решить, когда следует вызывать panic!, а когда возвращать
Result? Когда код паникует, восстановиться невозможно. Можно вызывать panic!
для любой ошибочной ситуации, независимо от того, есть ли возможный способ восстановления, но
тогда вы принимаете решение о том, что ситуация невосстановима, от имени
вызывающего кода. Когда вы решаете вернуть значение Result, вы даёте
вызывающему коду варианты. Вызывающий код может решить попытаться восстановиться
способом, подходящим для его ситуации, или решить, что значение Err
в данном случае невосстановимо, поэтому он может вызвать panic! и превратить вашу
восстановимую ошибку в невосстановимую. Следовательно, возврат Result —
хороший выбор по умолчанию, когда вы определяете функцию, которая может завершиться неудачей.
В таких ситуациях, как примеры, прототипный код и тесты, уместнее
писать код, который паникует, вместо возврата Result. Давайте
разберёмся почему, а затем обсудим ситуации, в которых компилятор не может определить, что
сбой невозможен, но вы как человек можете. Глава завершится
некоторыми общими рекомендациями о том, как решить, стоит ли паниковать в библиотечном коде.
Примеры, прототипный код и тесты
Когда вы пишете пример для иллюстрации какой-либо концепции, включение также
надёжного кода обработки ошибок может сделать пример менее понятным. В примерах
подразумевается, что вызов такого метода, как unwrap, который может паниковать, является
заглушкой для того, как вы хотели бы, чтобы ваше приложение обрабатывало ошибки, что может
отличаться в зависимости от того, что делает остальной ваш код.
Аналогично, методы unwrap и expect очень удобны, когда вы
создаёте прототип и ещё не готовы решить, как обрабатывать ошибки. Они оставляют
чёткие маркеры в вашем коде для момента, когда вы будете готовы сделать программу более
надёжной.
Если вызов метода завершается неудачей в тесте, вы хотели бы, чтобы весь тест завершился неудачей, даже если
этот метод не является тестируемой функциональностью. Поскольку panic! — это способ пометить тест
как неудачный, вызов unwrap или expect — это именно то, что должно
происходить.
Когда у вас больше информации, чем у компилятора
Также было бы уместно вызывать expect, когда у вас есть какая-то другая логика,
которая гарантирует, что Result будет иметь значение Ok, но эта логика
не является чем-то, что понимает компилятор. У вас всё ещё будет значение Result, которое
нужно обработать: какая бы операция ни вызывалась, она всё ещё имеет возможность
завершиться неудачей в общем случае, даже если это логически невозможно в вашей конкретной
ситуации. Если вы можете убедиться, вручную проверив код, что у вас никогда
не будет варианта Err, вполне допустимо вызвать expect и задокументировать
причину, по которой вы считаете, что у вас никогда не будет варианта Err, в тексте аргумента.
Вот пример:
fn main() {
use std::net::IpAddr;
let home: IpAddr = "127.0.0.1"
.parse()
.expect("Hardcoded IP address should be valid");
}Мы создаём экземпляр IpAddr путём разбора жёстко заданной строки. Мы видим,
что 127.0.0.1 — это корректный IP-адрес, поэтому здесь допустимо использовать expect.
Однако наличие жёстко заданной корректной строки не меняет возвращаемый тип
метода parse: мы всё ещё получаем значение Result, и компилятор всё ещё
заставит нас обработать Result так, как будто вариант Err возможен,
потому что компилятор недостаточно умён, чтобы увидеть, что эта строка всегда является
корректным IP-адресом. Если бы строка IP-адреса происходила от пользователя, а не была
жёстко задана в программе, и, следовательно, имела возможность сбоя,
мы бы определённо хотели обработать Result более надёжным способом.
Упоминание предположения, что этот IP-адрес жёстко задан, подтолкнёт нас к тому, чтобы
заменить expect на лучший код обработки ошибок, если в будущем нам потребуется получить
IP-адрес из какого-либо другого источника.
Рекомендации по обработке ошибок
Желательно, чтобы код паниковал, когда есть вероятность, что код может оказаться в некорректном состоянии. В этом контексте некорректное состояние — это когда какое-то предположение, гарантия, контракт или инвариант нарушены, например, когда в код передаются недопустимые значения, противоречивые значения или отсутствующие значения, плюс одно или более из следующих условий:
- Некорректное состояние — это что-то неожиданное, в отличие от чего-то, что вероятно будет случаться время от времени, например, пользователь вводит данные в неверном формате.
- Ваш код после этой точки должен полагаться на то, что он не находится в этом некорректном состоянии, а не проверять наличие проблемы на каждом шаге.
- Нет хорошего способа закодировать эту информацию в используемых типах. Мы проработаем пример того, что мы имеем в виду, в разделе «Кодирование состояний и поведения как типов» в главе 18.
Если кто-то вызывает ваш код и передаёт значения, которые не имеют смысла, лучше всего
вернуть ошибку, если это возможно, чтобы пользователь библиотеки мог решить,
что делать в этом случае. Однако в случаях, когда продолжение может быть
небезопасным или вредоносным, лучшим выбором может быть вызов panic! и предупреждение
человека, использующего вашу библиотеку, об ошибке в его коде, чтобы он мог исправить её
во время разработки. Аналогично, panic! часто уместен, если вы вызываете
внешний код, который находится вне вашего контроля и возвращает недопустимое состояние, которое вы
не можете исправить.
Однако, когда сбой ожидаем, уместнее вернуть Result,
чем вызывать panic!. Примеры включают парсер, которому переданы некорректные
данные, или HTTP-запрос, возвращающий статус, указывающий на достижение лимита
запросов. В этих случаях возврат Result указывает на то, что сбой является
ожидаемой возможностью, которую вызывающий код должен решить, как обработать.
Когда ваш код выполняет операцию, которая может подвергнуть пользователя риску, если она
вызвана с недопустимыми значениями, ваш код должен сначала проверить, что значения допустимы,
и паниковать, если значения недопустимы. Это в основном по соображениям безопасности:
попытка работать с недопустимыми данными может сделать ваш код уязвимым.
Это основная причина, по которой стандартная библиотека вызовет panic!, если вы попытаетесь
выполнить доступ к памяти за пределами допустимого диапазона: попытка доступа к памяти, которая не принадлежит
текущей структуре данных, является распространённой проблемой безопасности. Функции часто имеют
контракты: их поведение гарантируется только в том случае, если входные данные соответствуют определённым
требованиям. Паника при нарушении контракта имеет смысл, потому что нарушение
контракта всегда указывает на ошибку на стороне вызывающего кода, и это не тот вид
ошибки, которую вызывающий код должен явно обрабатывать. На самом деле нет
разумного способа для вызывающего кода восстановиться; вызывающим программистам нужно
исправить код. Контракты функции, особенно когда нарушение
вызовет панику, должны быть объяснены в документации API функции.
Однако наличие множества проверок ошибок во всех функциях было бы многословно
и раздражающе. К счастью, можно использовать систему типов Rust (и, следовательно, проверку типов,
выполняемую компилятором), чтобы выполнить многие проверки за вас. Если ваша
функция имеет параметр определённого типа, можно продолжать логику вашего кода,
зная, что компилятор уже обеспечил наличие допустимого
значения. Например, если у вас есть тип, а не Option, ваша программа
ожидает что-то, а не ничего. Тогда ваш код не должен
обрабатывать два случая для вариантов Some и None: у него будет только один
случай, когда значение определённо есть. Код, пытающийся передать ничего в вашу
функцию, даже не скомпилируется, поэтому вашей функции не нужно проверять этот
случай во время выполнения. Другой пример — использование беззнакового целочисленного типа, такого как
u32, который гарантирует, что параметр никогда не будет отрицательным.
Пользовательские типы для проверки
Давайте разовьём идею использования системы типов Rust для обеспечения наличия допустимого значения на один шаг дальше и рассмотрим создание пользовательского типа для проверки. Вспомните игру-угадайку из главы 2, в которой наш код просил пользователя угадать число от 1 до 100. Мы никогда не проверяли, что догадка пользователя находится между этими числами, прежде чем сравнивать её с нашим секретным числом; мы только проверяли, что догадка положительна. В этом случае последствия были не очень серьёзными: наш вывод «Слишком много» или «Слишком мало» всё равно был бы правильным. Но было бы полезным улучшением направлять пользователя к допустимым догадкам и иметь различное поведение, когда пользователь угадывает число вне диапазона, по сравнению с ситуацией, когда пользователь вводит, например, буквы.
Одним из способов сделать это было бы разобрать догадку как i32 вместо только
u32, чтобы разрешить потенциально отрицательные числа, а затем добавить проверку на
нахождение числа в диапазоне, вот так:
use std::cmp::Ordering;
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
loop {
// --snip--
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: i32 = match guess.trim().parse() {
Ok(num) => num,
Err(_) => continue,
};
if guess < 1 || guess > 100 {
println!("The secret number will be between 1 and 100.");
continue;
}
match guess.cmp(&secret_number) {
// --snip--
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break;
}
}
}
}Выражение if проверяет, находится ли наше значение вне диапазона, сообщает пользователю
о проблеме и вызывает continue, чтобы начать следующую итерацию цикла
и запросить другую догадку. После выражения if можно продолжить
сравнения между guess и секретным числом, зная, что guess
находится между 1 и 100.
Однако это не идеальное решение: если было бы абсолютно критично, чтобы программа работала только со значениями от 1 до 100, и у неё было бы много функций с этим требованием, наличие такой проверки в каждой функции было бы утомительным (и могло бы повлиять на производительность).
Вместо этого можно создать новый тип в выделенном модуле и поместить проверки
в функцию для создания экземпляра типа вместо повторения
проверок повсюду. Таким образом, функциям безопасно использовать новый тип
в своих сигнатурах и уверенно использовать значения, которые они получают. Листинг 9-13
показывает один из способов определения типа Guess, который создаст экземпляр
Guess только в том случае, если функция new получит значение от 1 до 100.
#![allow(unused)]
fn main() {
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 || value > 100 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
pub fn value(&self) -> i32 {
self.value
}
}
}Guess, который продолжит работу только со значениями от 1 до 100Обратите внимание, что этот код в src/guessing_game.rs зависит от добавления объявления модуля
mod guessing_game; в src/lib.rs, которое мы здесь не показали.
Внутри файла этого нового модуля мы определяем структуру с именем Guess, у которой
есть поле с именем value, содержащее i32. Здесь будет
храниться число.
Затем мы реализуем связанную функцию с именем new для Guess, которая создаёт
экземпляры значений Guess. Функция new определена так, чтобы иметь один
параметр с именем value типа i32 и возвращать Guess. Код в
теле функции new проверяет value, чтобы убедиться, что оно находится между 1 и 100.
Если value не проходит эту проверку, мы вызываем panic!, что предупредит
программиста, пишущего вызывающий код, что у него есть ошибка, которую нужно
исправить, потому что создание Guess со значением value вне этого диапазона
нарушило бы контракт, на который опирается Guess::new. Условия, при которых
Guess::new может паниковать, должны быть обсуждены в его публичной
документации API; мы рассмотрим соглашения документирования, указывающие на возможность
panic!, в документации API, которую вы создаёте в главе 14. Если
value проходит проверку, мы создаём новый Guess с его полем value, установленным
в параметр value, и возвращаем Guess.
Затем мы реализуем метод с именем value, который заимствует self, не имеет никаких
других параметров и возвращает i32. Такой метод иногда называют
геттером, потому что его назначение — получить некоторые данные из полей и вернуть
их. Этот публичный метод необходим, потому что поле value структуры Guess
является приватным. Важно, чтобы поле value было приватным, чтобы
код, использующий структуру Guess, не мог напрямую устанавливать value: код
вне модуля guessing_game должен использовать функцию Guess::new, чтобы
создать экземпляр Guess, тем самым гарантируя, что не будет способа получить
Guess со значением value, не проверенным условиями в
функции Guess::new.
Функция, которая имеет параметр или возвращает только числа от 1 до 100, могла бы
затем объявить в своей сигнатуре, что она принимает или возвращает Guess, а не
i32, и не нуждалась бы в дополнительных проверках в своём теле.
Итоги
Возможности обработки ошибок Rust предназначены для того, чтобы помочь писать более надёжный код.
Макрос panic! сигнализирует, что программа находится в состоянии, которое она не может
обработать, и позволяет сказать процессу остановиться вместо попытки продолжить работу с недопустимыми или
некорректными значениями. Перечисление Result использует систему типов Rust, чтобы указать, что
операции могут завершиться неудачей способом, от которого ваш код может
восстановиться. Можно использовать Result, чтобы сообщить коду, который вызывает ваш код, что ему нужно
обрабатывать как потенциальный успех, так и сбой. Использование panic! и Result в подходящих
ситуациях сделает ваш код более надёжным перед лицом неизбежных проблем.
Теперь, когда вы увидели полезные способы использования стандартной библиотекой обобщённых типов с
перечислениями Option и Result, мы поговорим о том, как работают обобщённые типы и как вы
можете использовать их в своём коде.
Обобщённые типы, трейты и времена жизни
Обобщённые типы, трейты и времена жизни
В каждом языке программирования есть инструменты для эффективной обработки дублирования концепций. В Rust одним из таких инструментов являются обобщения: абстрактные заменители для конкретных типов или других свойств. Мы можем выразить поведение обобщений или то, как они связаны с другими обобщениями, не зная, что будет на их месте при компиляции и запуске кода.
Функции могут принимать параметры некоторого обобщённого типа вместо конкретного типа, такого как i32 или String, так же, как они принимают параметры с неизвестными значениями для выполнения одного и того же кода на нескольких конкретных значениях. Фактически, мы уже использовали обобщения в главе 6 с Option<T>, в главе 8 с Vec<T> и HashMap<K, V>, и в главе 9 с Result<T, E>. В этой главе вы узнаете, как определять собственные типы, функции и методы с обобщениями!
Сначала мы рассмотрим, как извлечь функцию для уменьшения дублирования кода. Затем мы используем ту же технику, чтобы создать обобщённую функцию из двух функций, которые различаются только типами своих параметров. Мы также объясним, как использовать обобщённые типы в определениях структур и перечислений.
Затем вы узнаете, как использовать трейты для определения поведения обобщённым способом. Вы можете комбинировать трейты с обобщёнными типами, чтобы ограничить обобщённый тип принятием только тех типов, которые имеют определённое поведение, в отличие от любого типа.
Наконец, мы обсудим времена жизни: разновидность обобщений, которая даёт компилятору информацию о том, как ссылки связаны друг с другом. Времена жизни позволяют нам дать компилятору достаточно информации о заимствованных значениях, чтобы он мог гарантировать, что ссылки будут действительны в большем числе ситуаций, чем он мог бы без нашей помощи.
Удаление дублирования путём извлечения функции
Обобщения позволяют нам заменить конкретные типы заполнителем, который представляет несколько типов, чтобы удалить дублирование кода. Прежде чем погрузиться в синтаксис обобщений, давайте сначала посмотрим, как удалить дублирование способом, не связанным с обобщёнными типами, путём извлечения функции, которая заменяет конкретные значения заполнителем, представляющим несколько значений. Затем мы применим ту же технику, чтобы извлечь обобщённую функцию! Глядя на то, как распознать дублированный код, который можно извлечь в функцию, вы начнёте распознавать дублированный код, который может использовать обобщения.
Мы начнём с короткой программы в листинге 10-1, которая находит наибольшее число в списке.
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
assert_eq!(*largest, 100);
}Мы храним список целых чисел в переменной number_list и помещаем ссылку на первое число в списке в переменную с именем largest. Затем мы итерируем по всем числам в списке, и если текущее число больше числа, хранящегося в largest, мы заменяем ссылку в этой переменной. Однако, если текущее число меньше или равно наибольшему числу, увиденному до сих пор, переменная не изменяется, и код переходит к следующему числу в списке. После рассмотрения всех чисел в списке largest должна ссылаться на наибольшее число, которое в данном случае равно 100.
Теперь перед нами стоит задача найти наибольшее число в двух разных списках чисел. Для этого мы можем выбрать дублирование кода из листинга 10-1 и использование той же логики в двух разных местах программы, как показано в листинге 10-2.
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
let number_list = vec![102, 34, 6000, 89, 54, 2, 43, 8];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
}Хотя этот код работает, дублирование кода утомительно и подвержено ошибкам. Нам также нужно помнить об обновлении кода в нескольких местах, когда мы хотим его изменить.
Чтобы устранить это дублирование, мы создадим абстракцию, определив функцию, которая работает с любым списком целых чисел, переданным в качестве параметра. Это решение делает наш код более понятным и позволяет нам абстрактно выразить концепцию поиска наибольшего числа в списке.
В листинге 10-3 мы извлекаем код, который находит наибольшее число, в функцию с именем largest. Затем мы вызываем функцию, чтобы найти наибольшее число в двух списках из листинга 10-2. Мы также могли бы использовать функцию на любом другом списке значений i32, который у нас может появиться в будущем.
fn largest(list: &[i32]) -> &i32 {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 100);
let number_list = vec![102, 34, 6000, 89, 54, 2, 43, 8];
let result = largest(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 6000);
}Функция largest имеет параметр с именем list, который представляет любой конкретный срез значений i32, который мы могли бы передать в функцию. В результате, когда мы вызываем функцию, код выполняется на конкретных значениях, которые мы передаём.
Подводя итог, вот шаги, которые мы предприняли, чтобы изменить код из листинга 10-2 в листинг 10-3:
- Определить дублированный код.
- Извлечь дублированный код в тело функции и указать входные и возвращаемые значения этого кода в сигнатуре функции.
- Обновить два экземпляра дублированного кода, чтобы вместо них вызывать функцию.
Далее мы будем использовать эти же шаги с обобщениями для уменьшения дублирования кода. Так же, как тело функции может работать с абстрактным list вместо конкретных значений, обобщения позволяют коду работать с абстрактными типами.
Например, предположим, у нас есть две функции: одна находит наибольший элемент в срезе значений i32, а другая находит наибольший элемент в срезе значений char. Как бы мы устранили это дублирование? Давайте выясним!
Обобщённые типы данных
Обобщённые типы данных
Мы используем обобщения для создания определений элементов, таких как сигнатуры функций или структуры, которые затем можно использовать с множеством различных конкретных типов данных. Давайте сначала рассмотрим, как определять функции, структуры, перечисления и методы с использованием обобщений. Затем мы обсудим, как обобщения влияют на производительность кода.
В определениях функций
При определении функции, использующей обобщения, мы помещаем обобщения в сигнатуру функции туда, где мы обычно указываем типы данных параметров и возвращаемого значения. Это делает наш код более гибким и предоставляет больше функциональности вызывающим нашу функцию, предотвращая дублирование кода.
Продолжая с нашей функцией largest, листинг 10-4 показывает две функции, которые
обе находят наибольшее значение в срезе. Затем мы объединим их в одну
функцию, использующую обобщения.
fn largest_i32(list: &[i32]) -> &i32 {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn largest_char(list: &[char]) -> &char {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest_i32(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 100);
let char_list = vec!['y', 'm', 'a', 'q'];
let result = largest_char(&char_list);
println!("The largest char is {result}");
assert_eq!(*result, 'y');
}Функция largest_i32 — та, которую мы извлекли в листинге 10-3, находящая
наибольший i32 в срезе. Функция largest_char находит наибольший
char в срезе. Тела функций содержат одинаковый код, поэтому давайте устраним
дублирование, введя параметр обобщённого типа в одну функцию.
Чтобы параметризовать типы в новой единой функции, нам нужно назвать параметр
типа, так же как мы это делаем для параметров-значений функции. Вы можете использовать
любой идентификатор в качестве имени параметра типа. Но мы будем использовать T, потому что
по соглашению имена параметров типов в Rust короткие, часто просто одна буква, и
соглашение об именовании типов в Rust — UpperCamelCase. Сокращение от type, T —
выбор по умолчанию большинства программистов на Rust.
Когда мы используем параметр в теле функции, мы должны объявить
имя параметра в сигнатуре, чтобы компилятор знал, что означает это имя.
Аналогично, когда мы используем имя параметра типа в сигнатуре функции, мы
должны объявить имя параметра типа перед его использованием. Чтобы определить обобщённую
функцию largest, мы помещаем объявления имён типов в угловые скобки,
<>, между именем функции и списком параметров, вот так:
fn largest<T>(list: &[T]) -> &T {Мы читаем это определение как «Функция largest является обобщённой по некоторому типу
T». Эта функция имеет один параметр с именем list, который является срезом значений
типа T. Функция largest вернёт ссылку на значение того же типа T.
Листинг 10-5 показывает объединённое определение функции largest, использующее обобщённый
тип данных в своей сигнатуре. В листинге также показано, как мы можем вызвать функцию
со срезом значений i32 или значений char. Обратите внимание, что этот код пока
не скомпилируется.
fn largest<T>(list: &[T]) -> &T {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest(&number_list);
println!("The largest number is {result}");
let char_list = vec!['y', 'm', 'a', 'q'];
let result = largest(&char_list);
println!("The largest char is {result}");
}largest, использующая параметры обобщённого типа; она пока не компилируетсяЕсли мы скомпилируем этот код прямо сейчас, мы получим эту ошибку:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0369]: binary operation `>` cannot be applied to type `&T`
--> src/main.rs:5:17
|
5 | if item > largest {
| ---- ^ ------- &T
| |
| &T
|
help: consider restricting type parameter `T` with trait `PartialOrd`
|
1 | fn largest<T: std::cmp::PartialOrd>(list: &[T]) -> &T {
| ++++++++++++++++++++++
For more information about this error, try `rustc --explain E0369`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
В тексте справки упоминается std::cmp::PartialOrd, который является трейтом, и мы
поговорим о трейтах в следующем разделе. Пока достаточно знать, что эта ошибка
говорит о том, что тело largest не будет работать для всех возможных типов, которыми может
быть T. Поскольку мы хотим сравнивать значения типа T в теле, мы можем
использовать только типы, значения которых можно упорядочить. Чтобы включить сравнения, стандартная
библиотека имеет трейт std::cmp::PartialOrd, который вы можете реализовать для типов
(см. приложение C для получения дополнительной информации об этом трейте). Чтобы исправить листинг 10-5, мы можем последовать
предложению из текста справки и ограничить типы, допустимые для T, только теми, которые
реализуют PartialOrd. Затем листинг скомпилируется, потому что стандартная
библиотека реализует PartialOrd как для i32, так и для char.
В определениях структур
Мы также можем определить структуры для использования параметра обобщённого типа в одном или нескольких
полях, используя синтаксис <>. Листинг 10-6 определяет структуру Point<T> для хранения
значений координат x и y любого типа.
struct Point<T> {
x: T,
y: T,
}
fn main() {
let integer = Point { x: 5, y: 10 };
let float = Point { x: 1.0, y: 4.0 };
}Point<T>, хранящая значения x и y типа TСинтаксис использования обобщений в определениях структур аналогичен тому, который используется в определениях функций. Сначала мы объявляем имя параметра типа внутри угловых скобок сразу после имени структуры. Затем мы используем обобщённый тип в определении структуры там, где мы иначе указали бы конкретные типы данных.
Обратите внимание, что поскольку мы использовали только один обобщённый тип для определения Point<T>, это
определение говорит, что структура Point<T> является обобщённой по некоторому типу T, и
поля x и y оба имеют тот же тип, каким бы этот тип ни был. Если
мы создадим экземпляр Point<T> со значениями разных типов, как в
листинге 10-7, наш код не скомпилируется.
struct Point<T> {
x: T,
y: T,
}
fn main() {
let wont_work = Point { x: 5, y: 4.0 };
}x и y должны быть одного типа, потому что оба имеют один и тот же обобщённый тип данных T.В этом примере, когда мы присваиваем целочисленное значение 5 переменной x, мы даём
компилятору знать, что обобщённый тип T будет целочисленным для этого экземпляра
Point<T>. Затем, когда мы указываем 4.0 для y, который мы определили как
имеющий тот же тип, что и x, мы получим ошибку несоответствия типов, вот такую:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0308]: mismatched types
--> src/main.rs:7:38
|
7 | let wont_work = Point { x: 5, y: 4.0 };
| ^^^ expected integer, found floating-point number
For more information about this error, try `rustc --explain E0308`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Чтобы определить структуру Point, где x и y оба являются обобщёнными, но могут иметь
разные типы, мы можем использовать несколько параметров обобщённого типа. Например, в
листинге 10-8 мы меняем определение Point, чтобы оно было обобщённым по типам T
и U, где x имеет тип T, а y имеет тип U.
struct Point<T, U> {
x: T,
y: U,
}
fn main() {
let both_integer = Point { x: 5, y: 10 };
let both_float = Point { x: 1.0, y: 4.0 };
let integer_and_float = Point { x: 5, y: 4.0 };
}Point<T, U>, обобщённая по двум типам, так что x и y могут быть значениями разных типовТеперь все показанные экземпляры Point разрешены! Вы можете использовать столько параметров обобщённого
типа в определении, сколько захотите, но использование более нескольких делает
ваш код трудным для чтения. Если вы обнаружите, что вам нужно много обобщённых типов в
вашем коде, это может указывать на то, что ваш код нуждается в реструктуризации на более мелкие
части.
В определениях перечислений
Как мы делали со структурами, мы можем определять перечисления для хранения обобщённых типов данных в их
вариантах. Давайте ещё раз взглянем на перечисление Option<T>, которое предоставляет стандартная
библиотека, и которое мы использовали в главе 6:
#![allow(unused)]
fn main() {
enum Option<T> {
Some(T),
None,
}
}Это определение теперь должно иметь для вас больше смысла. Как видите,
перечисление Option<T> является обобщённым по типу T и имеет два варианта: Some, который
содержит одно значение типа T, и вариант None, который не содержит никакого значения.
Используя перечисление Option<T>, мы можем выразить абстрактную концепцию
необязательного значения, и поскольку Option<T> является обобщённым, мы можем использовать эту абстракцию
независимо от типа необязательного значения.
Перечисления также могут использовать несколько обобщённых типов. Определение перечисления Result,
которое мы использовали в главе 9, является одним из примеров:
#![allow(unused)]
fn main() {
enum Result<T, E> {
Ok(T),
Err(E),
}
}Перечисление Result является обобщённым по двум типам, T и E, и имеет два варианта:
Ok, который содержит значение типа T, и Err, который содержит значение типа
E. Это определение делает удобным использование перечисления Result везде, где
у нас есть операция, которая может успешно завершиться (вернуть значение некоторого типа T) или потерпеть неудачу
(вернуть ошибку некоторого типа E). Фактически, это то, что мы использовали для открытия
файла в листинге 9-3, где T был заполнен типом std::fs::File, когда
файл был успешно открыт, а E был заполнен типом
std::io::Error, когда были проблемы с открытием файла.
Когда вы распознаёте в своём коде ситуации с несколькими определениями структур или перечислений, которые различаются только типами значений, которые они содержат, вы можете избежать дублирования, используя вместо этого обобщённые типы.
В определениях методов
Мы можем реализовывать методы для структур и перечислений (как мы делали в главе 5) и использовать
обобщённые типы в их определениях тоже. Листинг 10-9 показывает структуру Point<T>,
которую мы определили в листинге 10-6, с реализованным для неё методом с именем x.
struct Point<T> {
x: T,
y: T,
}
impl<T> Point<T> {
fn x(&self) -> &T {
&self.x
}
}
fn main() {
let p = Point { x: 5, y: 10 };
println!("p.x = {}", p.x());
}x для структуры Point<T>, который вернёт ссылку на поле x типа TЗдесь мы определили метод с именем x для Point<T>, который возвращает ссылку
на данные в поле x.
Обратите внимание, что мы должны объявить T сразу после impl, чтобы мы могли использовать T для
указания, что мы реализуем методы для типа Point<T>. Объявив
T как обобщённый тип после impl, Rust может идентифицировать, что тип в
угловых скобках в Point является обобщённым типом, а не конкретным типом. Мы
могли бы выбрать другое имя для этого обобщённого параметра, чем обобщённый
параметр, объявленный в определении структуры, но использование того же имени является
общепринятым. Если вы напишете метод внутри impl, который объявляет обобщённый
тип, этот метод будет определён для любого экземпляра типа, независимо от того, какой
конкретный тип в конечном итоге подставляется вместо обобщённого типа.
Мы также можем указать ограничения на обобщённые типы при определении методов для
типа. Мы могли бы, например, реализовать методы только для экземпляров Point<f32>,
а не для экземпляров Point<T> с любым обобщённым типом. В листинге 10-10 мы
используем конкретный тип f32, что означает, что мы не объявляем никаких типов после impl.
struct Point<T> {
x: T,
y: T,
}
impl<T> Point<T> {
fn x(&self) -> &T {
&self.x
}
}
impl Point<f32> {
fn distance_from_origin(&self) -> f32 {
(self.x.powi(2) + self.y.powi(2)).sqrt()
}
}
fn main() {
let p = Point { x: 5, y: 10 };
println!("p.x = {}", p.x());
}impl, который применяется только к структуре с определённым конкретным типом для параметра обобщённого типа TЭтот код означает, что тип Point<f32> будет иметь метод distance_from_origin;
другие экземпляры Point<T>, где T не является типом f32, не
будут иметь этот метод определённым. Метод измеряет, насколько наша точка удалена от
точки с координатами (0.0, 0.0), и использует математические операции, которые
доступны только для типов с плавающей точкой.
Параметры обобщённого типа в определении структуры не всегда совпадают с теми,
которые вы используете в сигнатурах методов той же структуры. Листинг 10-11 использует обобщённые
типы X1 и Y1 для структуры Point и X2 и Y2 для сигнатуры метода mixup,
чтобы сделать пример яснее. Метод создаёт новый экземпляр Point
со значением x из self Point (типа X1) и значением y
из переданного Point (типа Y2).
struct Point<X1, Y1> {
x: X1,
y: Y1,
}
impl<X1, Y1> Point<X1, Y1> {
fn mixup<X2, Y2>(self, other: Point<X2, Y2>) -> Point<X1, Y2> {
Point {
x: self.x,
y: other.y,
}
}
}
fn main() {
let p1 = Point { x: 5, y: 10.4 };
let p2 = Point { x: "Hello", y: 'c' };
let p3 = p1.mixup(p2);
println!("p3.x = {}, p3.y = {}", p3.x, p3.y);
}В main мы определили Point, который имеет i32 для x (со значением 5)
и f64 для y (со значением 10.4). Переменная p2 — это структура Point,
которая имеет строковый срез для x (со значением "Hello") и char для y
(со значением c). Вызов mixup для p1 с аргументом p2 даёт нам p3,
который будет иметь i32 для x, потому что x пришёл из p1. Переменная p3
будет иметь char для y, потому что y пришёл из p2. Вызов макроса println!
напечатает p3.x = 5, p3.y = c.
Цель этого примера — продемонстрировать ситуацию, в которой некоторые обобщённые
параметры объявлены с impl, а некоторые объявлены с определением метода.
Здесь обобщённые параметры X1 и Y1 объявлены после
impl, потому что они идут с определением структуры. Обобщённые параметры X2
и Y2 объявлены после fn mixup, потому что они относятся только к
методу.
Производительность кода, использующего обобщения
Возможно, вам интересно, есть ли накладные расходы во время выполнения при использовании параметров обобщённого типа. Хорошая новость в том, что использование обобщённых типов не заставит вашу программу работать медленнее, чем с конкретными типами.
Rust достигает этого путём мономорфизации кода, использующего обобщения, во время компиляции. Мономорфизация — это процесс превращения обобщённого кода в конкретный код путём подстановки конкретных типов, которые используются при компиляции. В этом процессе компилятор делает противоположное шагам, которые мы использовали для создания обобщённой функции в листинге 10-5: компилятор смотрит на все места, где вызывается обобщённый код, и генерирует код для конкретных типов, с которыми вызывается обобщённый код.
Давайте посмотрим, как это работает, используя обобщённое перечисление
Option<T> из стандартной библиотеки:
#![allow(unused)]
fn main() {
let integer = Some(5);
let float = Some(5.0);
}Когда Rust компилирует этот код, он выполняет мономорфизацию. В ходе этого
процесса компилятор читает значения, которые были использованы в экземплярах Option<T>,
и идентифицирует два вида Option<T>: один — i32, а другой —
f64. Таким образом, он разворачивает обобщённое определение Option<T> в два
определения, специализированных для i32 и f64, тем самым заменяя обобщённое
определение конкретными.
Мономорфизированная версия кода выглядит примерно так (компилятор использует другие имена, чем те, которые мы используем здесь для иллюстрации):
enum Option_i32 {
Some(i32),
None,
}
enum Option_f64 {
Some(f64),
None,
}
fn main() {
let integer = Option_i32::Some(5);
let float = Option_f64::Some(5.0);
}Обобщённое Option<T> заменяется конкретными определениями, созданными
компилятором. Поскольку Rust компилирует обобщённый код в код, который указывает
тип в каждом экземпляре, мы не платим накладных расходов во время выполнения за использование обобщений. Когда код
выполняется, он работает так же, как если бы мы вручную дублировали каждое определение.
Процесс мономорфизации делает обобщения Rust чрезвычайно эффективными
во время выполнения.
Определение общего поведения с помощью трейтов
Определение общего поведения с помощью трейтов
Трейт определяет функциональность, которой обладает определённый тип и которую он может разделять с другими типами. Мы можем использовать трейты для абстрактного определения общего поведения. Мы можем использовать ограничения трейтов, чтобы указать, что обобщённый тип может быть любым типом, обладающим определённым поведением.
Примечание: Трейты похожи на возможность, которую в других языках часто называют интерфейсами, хотя и с некоторыми различиями.
Определение трейта
Поведение типа состоит из методов, которые мы можем вызывать для этого типа. Различные типы разделяют одно и то же поведение, если мы можем вызывать одни и те же методы для всех этих типов. Определения трейтов — это способ сгруппировать сигнатуры методов вместе, чтобы определить набор поведений, необходимых для достижения некоторой цели.
Например, допустим, у нас есть несколько структур, которые содержат различные виды и
объёмы текста: структура NewsArticle, которая содержит новостную статью, поданную в
определённом месте, и SocialPost, которая может иметь не более 280 символов
вместе с метаданными, указывающими, была ли это новая публикация, репост или
ответ на другую публикацию.
Мы хотим создать библиотечный крейт медиа-агрегатора с именем aggregator, который может
отображать сводки данных, которые могут храниться в экземпляре NewsArticle или
SocialPost. Для этого нам нужна сводка от каждого типа, и мы
запросим эту сводку, вызвав метод summarize для экземпляра. Листинг
10-12 показывает определение публичного трейта Summary, который выражает это
поведение.
pub trait Summary {
fn summarize(&self) -> String;
}Summary, который состоит из поведения, предоставляемого методом summarizeЗдесь мы объявляем трейт с помощью ключевого слова trait, а затем имени трейта,
которое в данном случае — Summary. Мы также объявляем трейт как pub, чтобы
крейты, зависящие от этого крейта, тоже могли использовать этот трейт, как мы увидим в
нескольких примерах. Внутри фигурных скобок мы объявляем сигнатуры методов,
которые описывают поведения типов, реализующих этот трейт, что в
данном случае — fn summarize(&self) -> String.
После сигнатуры метода вместо предоставления реализации внутри фигурных
скобок мы используем точку с запятой. Каждый тип, реализующий этот трейт, должен предоставить
своё собственное поведение для тела метода. Компилятор обеспечит,
что любой тип, имеющий трейт Summary, будет иметь метод summarize,
определённый точно с этой сигнатурой.
Трейт может иметь несколько методов в своём теле: сигнатуры методов перечисляются по одной на строку, и каждая строка заканчивается точкой с запятой.
Реализация трейта для типа
Теперь, когда мы определили желаемые сигнатуры методов трейта Summary,
мы можем реализовать его для типов в нашем медиа-агрегаторе. Листинг 10-13 показывает
реализацию трейта Summary для структуры NewsArticle, которая использует
заголовок, автора и местоположение для создания возвращаемого значения
summarize. Для структуры SocialPost мы определяем summarize как имя пользователя,
за которым следует весь текст публикации, предполагая, что содержимое публикации
уже ограничено 280 символами.
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}Summary для типов NewsArticle и SocialPostРеализация трейта для типа похожа на реализацию обычных методов. Разница
в том, что после impl мы помещаем имя трейта, который хотим реализовать,
затем используем ключевое слово for, а затем указываем имя типа, для которого хотим
реализовать трейт. Внутри блока impl мы помещаем сигнатуры методов,
которые были определены в определении трейта. Вместо добавления точки с запятой после каждой
сигнатуры мы используем фигурные скобки и заполняем тело метода конкретным
поведением, которое мы хотим, чтобы методы трейта имели для конкретного типа.
Теперь, когда библиотека реализовала трейт Summary для NewsArticle и
SocialPost, пользователи крейта могут вызывать методы трейта для экземпляров
NewsArticle и SocialPost так же, как мы вызываем обычные методы. Единственное
различие в том, что пользователь должен ввести трейт в область видимости, а также
типы. Вот пример того, как бинарный крейт мог бы использовать наш библиотечный крейт aggregator:
use aggregator::{SocialPost, Summary};
fn main() {
let post = SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
};
println!("1 new post: {}", post.summarize());
}Этот код печатает 1 new post: horse_ebooks: of course, as you probably already know, people.
Другие крейты, которые зависят от крейта aggregator, также могут ввести трейт Summary
в область видимости, чтобы реализовать Summary для своих собственных типов. Одно ограничение, о котором следует
отметить, состоит в том, что мы можем реализовать трейт для типа, только если либо трейт, либо
тип, либо оба являются локальными для нашего крейта. Например, мы можем реализовать стандартные
библиотечные трейты, такие как Display, для пользовательского типа, такого как SocialPost, в рамках нашей
функциональности крейта aggregator, потому что тип SocialPost является локальным для нашего
крейта aggregator. Мы также можем реализовать Summary для Vec<T> в нашем
крейте aggregator, потому что трейт Summary является локальным для нашего крейта
aggregator.
Но мы не можем реализовать внешние трейты для внешних типов. Например, мы не можем
реализовать трейт Display для Vec<T> в нашем крейте aggregator,
потому что и Display, и Vec<T> определены в стандартной библиотеке и
не являются локальными для нашего крейта aggregator. Это ограничение является частью свойства,
называемого согласованностью, и более конкретно правилом сироты, названным так потому,
что родительский тип отсутствует. Это правило гарантирует, что код других людей
не может сломать ваш код, и наоборот. Без этого правила два крейта могли бы
реализовать один и тот же трейт для одного и того же типа, и Rust не знал бы, какую
реализацию использовать.
Использование реализаций по умолчанию
Иногда полезно иметь поведение по умолчанию для некоторых или всех методов в трейте вместо того, чтобы требовать реализации для всех методов для каждого типа. Тогда, реализуя трейт для конкретного типа, мы можем сохранить или переопределить поведение по умолчанию каждого метода.
В листинге 10-14 мы указываем строку по умолчанию для метода summarize трейта
Summary вместо того, чтобы только определять сигнатуру метода, как мы делали в
листинге 10-12.
pub trait Summary {
fn summarize(&self) -> String {
String::from("(Read more...)")
}
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}Summary с реализацией метода summarize по умолчаниюЧтобы использовать реализацию по умолчанию для суммирования экземпляров NewsArticle, мы
указываем пустой блок impl с impl Summary for NewsArticle {}.
Хотя мы больше не определяем метод summarize для NewsArticle
напрямую, мы предоставили реализацию по умолчанию и указали, что
NewsArticle реализует трейт Summary. В результате мы по-прежнему можем вызывать
метод summarize для экземпляра NewsArticle, вот так:
use aggregator::{self, NewsArticle, Summary};
fn main() {
let article = NewsArticle {
headline: String::from("Penguins win the Stanley Cup Championship!"),
location: String::from("Pittsburgh, PA, USA"),
author: String::from("Iceburgh"),
content: String::from(
"The Pittsburgh Penguins once again are the best \
hockey team in the NHL.",
),
};
println!("New article available! {}", article.summarize());
}Этот код печатает New article available! (Read more...).
Создание реализации по умолчанию не требует от нас изменения чего-либо в
реализации Summary для SocialPost в листинге 10-13. Причина в
том, что синтаксис для переопределения реализации по умолчанию такой же, как
синтаксис для реализации метода трейта, который не имеет реализации
по умолчанию.
Реализации по умолчанию могут вызывать другие методы в том же трейте, даже если эти
другие методы не имеют реализации по умолчанию. Таким образом, трейт может
предоставлять много полезной функциональности и требовать от реализующих только указания
небольшой её части. Например, мы могли бы определить трейт Summary так, чтобы он имел
метод summarize_author, реализация которого требуется, а затем определить
метод summarize, который имеет реализацию по умолчанию, вызывающую
метод summarize_author:
pub trait Summary {
fn summarize_author(&self) -> String;
fn summarize(&self) -> String {
format!("(Read more from {}...)", self.summarize_author())
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize_author(&self) -> String {
format!("@{}", self.username)
}
}Чтобы использовать эту версию Summary, нам нужно только определить summarize_author,
когда мы реализуем трейт для типа:
pub trait Summary {
fn summarize_author(&self) -> String;
fn summarize(&self) -> String {
format!("(Read more from {}...)", self.summarize_author())
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize_author(&self) -> String {
format!("@{}", self.username)
}
}После того как мы определили summarize_author, мы можем вызывать summarize для экземпляров
структуры SocialPost, и реализация summarize по умолчанию вызовет
определение summarize_author, которое мы предоставили. Поскольку мы реализовали
summarize_author, трейт Summary дал нам поведение
метода summarize, не требуя от нас писать дополнительный код. Вот как
это выглядит:
use aggregator::{self, SocialPost, Summary};
fn main() {
let post = SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
};
println!("1 new post: {}", post.summarize());
}Этот код печатает 1 new post: (Read more from @horse_ebooks...).
Обратите внимание, что невозможно вызвать реализацию по умолчанию из переопределяющей реализации того же метода.
Использование трейтов в качестве параметров
Теперь, когда вы знаете, как определять и реализовывать трейты, мы можем исследовать, как использовать
трейты для определения функций, принимающих множество различных типов. Мы будем использовать трейт
Summary, который мы реализовали для типов NewsArticle и SocialPost в
листинге 10-13, чтобы определить функцию notify, которая вызывает метод summarize
для своего параметра item, который имеет некоторый тип, реализующий трейт Summary.
Для этого мы используем синтаксис impl Trait, вот так:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
pub fn notify(item: &impl Summary) {
println!("Breaking news! {}", item.summarize());
}Вместо конкретного типа для параметра item мы указываем ключевое слово impl
и имя трейта. Этот параметр принимает любой тип, реализующий
указанный трейт. В теле notify мы можем вызывать любые методы для item,
которые происходят из трейта Summary, такие как summarize. Мы можем вызывать notify
и передавать любой экземпляр NewsArticle или SocialPost. Код, который вызывает
функцию с любым другим типом, таким как String или i32, не скомпилируется,
потому что эти типы не реализуют Summary.
Синтаксис ограничения трейта
Синтаксис impl Trait работает для простых случаев, но на самом деле это синтаксический
сахар для более длинной формы, известной как ограничение трейта; она выглядит так:
pub fn notify<T: Summary>(item: &T) {
println!("Breaking news! {}", item.summarize());
}Эта более длинная форма эквивалентна примеру из предыдущего раздела, но более многословна. Мы размещаем ограничения трейта с объявлением обобщённого типа параметра после двоеточия и внутри угловых скобок.
Синтаксис impl Trait удобен и делает код более лаконичным в простых
случаях, в то время как более полный синтаксис ограничения трейта может выражать большую сложность в других
случаях. Например, у нас может быть два параметра, реализующих Summary. Сделать
это с синтаксисом impl Trait выглядит так:
pub fn notify(item1: &impl Summary, item2: &impl Summary) {Использовать impl Trait уместно, если мы хотим, чтобы эта функция позволяла item1 и
item2 иметь разные типы (при условии, что оба типа реализуют Summary). Если
мы хотим заставить оба параметра иметь один и тот же тип, однако, мы должны использовать
ограничение трейта, вот так:
pub fn notify<T: Summary>(item1: &T, item2: &T) {Обобщённый тип T, указанный как тип параметров item1 и item2,
ограничивает функцию так, что конкретный тип значения,
передаваемого в качестве аргумента для item1 и item2, должен быть одинаковым.
Множественные ограничения трейтов с синтаксисом +
Мы также можем указать более одного ограничения трейта. Допустим, мы хотели, чтобы notify использовал
форматирование отображения, а также summarize для item: мы указываем в определении
notify, что item должен реализовывать как Display, так и Summary. Мы можем
сделать это с помощью синтаксиса +:
pub fn notify(item: &(impl Summary + Display)) {Синтаксис + также допустим с ограничениями трейтов для обобщённых типов:
pub fn notify<T: Summary + Display>(item: &T) {С указанными двумя ограничениями трейтов тело notify может вызывать summarize
и использовать {} для форматирования item.
Более ясные ограничения трейтов с помощью предложений where
Использование слишком большого количества ограничений трейтов имеет свои недостатки. Каждый обобщённый тип имеет свои собственные
ограничения трейтов, поэтому функции с несколькими обобщёнными параметрами типа могут содержать много
информации об ограничениях трейтов между именем функции и её списком параметров,
что делает сигнатуру функции трудной для чтения. По этой причине Rust имеет альтернативный
синтаксис для указания ограничений трейтов внутри предложения where после сигнатуры
функции. Так, вместо того чтобы писать это:
fn some_function<T: Display + Clone, U: Clone + Debug>(t: &T, u: &U) -> i32 {мы можем использовать предложение where, вот так:
fn some_function<T, U>(t: &T, u: &U) -> i32
where
T: Display + Clone,
U: Clone + Debug,
{
unimplemented!()
}Сигнатура этой функции менее загромождена: имя функции, список параметров и тип возвращаемого значения находятся близко друг к другу, как в функции без множества ограничений трейтов.
Возврат типов, реализующих трейты
Мы также можем использовать синтаксис impl Trait в позиции возвращаемого типа, чтобы вернуть
значение некоторого типа, реализующего трейт, как показано здесь:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
fn returns_summarizable() -> impl Summary {
SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
}
}Используя impl Summary для типа возвращаемого значения, мы указываем, что
функция returns_summarizable возвращает некоторый тип, реализующий трейт Summary,
не называя конкретный тип. В этом случае returns_summarizable
возвращает SocialPost, но код, вызывающий эту функцию, не нуждается в знании
этого.
Возможность указать тип возвращаемого значения только по трейту, который он реализует,
особенно полезна в контексте замыканий и итераторов, которые мы рассматриваем в
тринадцатой главе. Замыкания и итераторы создают типы, которые знает только компилятор, или
типы, которые очень длинны для указания. Синтаксис impl Trait позволяет вам лаконично
указать, что функция возвращает некоторый тип, реализующий трейт Iterator,
без необходимости выписывать очень длинный тип.
Однако вы можете использовать impl Trait только в том случае, если возвращаете один тип. Например,
этот код, который возвращает либо NewsArticle, либо SocialPost с
типом возвращаемого значения, указанным как impl Summary, не сработает:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
fn returns_summarizable(switch: bool) -> impl Summary {
if switch {
NewsArticle {
headline: String::from(
"Penguins win the Stanley Cup Championship!",
),
location: String::from("Pittsburgh, PA, USA"),
author: String::from("Iceburgh"),
content: String::from(
"The Pittsburgh Penguins once again are the best \
hockey team in the NHL.",
),
}
} else {
SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
}
}
}Возврат либо NewsArticle, либо SocialPost не разрешён из-за
ограничений на то, как синтаксис impl Trait реализован в компиляторе.
Мы рассмотрим, как написать функцию с таким поведением, в разделе «Использование трейт-объектов для абстрагирования над общим поведением»
в восемнадцатой главе.
Использование ограничений трейтов для условной реализации методов
Используя ограничение трейта с блоком impl, который использует обобщённые параметры типа,
мы можем условно реализовать методы для типов, реализующих указанные
трейты. Например, тип Pair<T> в листинге 10-15 всегда реализует
функцию new для возврата нового экземпляра Pair<T> (напомним из раздела «Синтаксис
методов» в пятой главе, что Self — это псевдоним типа
для типа блока impl, которым в данном случае является Pair<T>). Но
в следующем блоке impl Pair<T> реализует метод cmp_display, только если
его внутренний тип T реализует трейт PartialOrd, который позволяет сравнивать,
и трейт Display, который позволяет печатать.
use std::fmt::Display;
struct Pair<T> {
x: T,
y: T,
}
impl<T> Pair<T> {
fn new(x: T, y: T) -> Self {
Self { x, y }
}
}
impl<T: Display + PartialOrd> Pair<T> {
fn cmp_display(&self) {
if self.x >= self.y {
println!("The largest member is x = {}", self.x);
} else {
println!("The largest member is y = {}", self.y);
}
}
}Мы также можем условно реализовать трейт для любого типа, который реализует
другой трейт. Реализации трейта для любого типа, удовлетворяющего ограничениям
трейта, называются универсальными реализациями и широко используются в
стандартной библиотеке Rust. Например, стандартная библиотека реализует
трейт ToString для любого типа, реализующего трейт Display. Блок impl
в стандартной библиотеке выглядит примерно так:
impl<T: Display> ToString for T {
// --snip--
}Поскольку в стандартной библиотеке есть эта универсальная реализация, мы можем вызывать
метод to_string, определённый трейтом ToString, для любого типа, реализующего
трейт Display. Например, мы можем превратить целые числа в соответствующие
значения String вот так, потому что целые числа реализуют Display:
#![allow(unused)]
fn main() {
let s = 3.to_string();
}Универсальные реализации появляются в документации для трейта в разделе «Implementors» (Реализующие типы).
Трейты и ограничения трейтов позволяют нам писать код, который использует обобщённые параметры типа для уменьшения дублирования, но также указывает компилятору, что мы хотим, чтобы обобщённый тип имел определённое поведение. Затем компилятор может использовать информацию об ограничениях трейта, чтобы проверить, что все конкретные типы, используемые с нашим кодом, предоставляют правильное поведение. В динамически типизированных языках мы получили бы ошибку во время выполнения, если бы вызвали метод для типа, который не определяет этот метод. Но Rust переносит эти ошибки на время компиляции, так что мы вынуждены исправить проблемы ещё до того, как наш код сможет запуститься. Кроме того, нам не нужно писать код, который проверяет поведение во время выполнения, потому что мы уже проверили его во время компиляции. Это повышает производительность без необходимости отказываться от гибкости обобщённых типов.
Проверка ссылок с помощью времён жизни
Проверка ссылок с помощью времён жизни
Времена жизни — это ещё один вид обобщений, который мы уже использовали. Вместо того чтобы гарантировать, что тип обладает нужным нам поведением, времена жизни гарантируют, что ссылки корректны настолько долго, насколько нам это нужно.
Одна деталь, которую мы не обсуждали в разделе «Ссылки и заимствование» в главе 4, заключается в том, что каждая ссылка в Rust имеет время жизни, то есть область видимости, в пределах которой эта ссылка корректна. В большинстве случаев времена жизни неявны и выводятся, точно так же, как в большинстве случаев выводятся типы. Аннотировать типы требуется только тогда, когда возможны несколько типов. Аналогично, мы должны аннотировать времена жизни, когда времена жизни ссылок могут быть связаны несколькими разными способами. Rust требует аннотировать связи с помощью обобщённых параметров времени жизни, чтобы гарантировать, что фактические ссылки, используемые во время выполнения, определённо будут корректны.
Аннотация времён жизни — это даже не концепция, которая есть в большинстве других языков программирования, поэтому это будет казаться непривычным. Хотя мы не будем рассматривать времена жизни целиком в этой главе, мы обсудим распространённые способы, которыми можно столкнуться с синтаксисом времён жизни, чтобы привыкнуть к этой концепции.
Висячие ссылки
Главная цель времён жизни — предотвратить висячие ссылки, которые, если бы им было позволено существовать, заставили бы программу ссылаться на данные, отличные от данных, на которые она должна ссылаться. Рассмотрим программу в листинге 10-16, которая имеет внешнюю область видимости и внутреннюю область видимости.
fn main() {
let r;
{
let x = 5;
r = &x;
}
println!("r: {r}");
}Примечание: В примерах листингов 10-16, 10-17 и 10-23 переменные объявляются без начального значения, поэтому имя переменной существует во внешней области видимости. На первый взгляд это может показаться противоречащим тому, что в Rust нет нулевых значений. Однако если мы попытаемся использовать переменную до присвоения ей значения, мы получим ошибку времени компиляции, что показывает, что Rust действительно не допускает нулевые значения.
Внешняя область видимости объявляет переменную с именем r без начального значения, а
внутренняя область видимости объявляет переменную с именем x с начальным значением 5. Внутри
внутренней области видимости мы пытаемся присвоить r значение ссылки на x.
Затем внутренняя область видимости заканчивается, и мы пытаемся вывести значение в
r. Этот код не скомпилируется, потому что значение, на которое ссылается r, вышло из области видимости
до того, как мы пытаемся его использовать. Вот сообщение об ошибке:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0597]: `x` does not live long enough
--> src/main.rs:6:13
|
5 | let x = 5;
| - binding `x` declared here
6 | r = &x;
| ^^ borrowed value does not live long enough
7 | }
| - `x` dropped here while still borrowed
8 |
9 | println!("r: {r}");
| - borrow later used here
For more information about this error, try `rustc --explain E0597`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Сообщение об ошибке говорит, что переменная x «не живёт достаточно долго». Причина
в том, что x выйдет из области видимости, когда внутренняя область видимости закончится на строке 7.
Но r всё ещё корректна для внешней области видимости; поскольку её область видимости больше, мы говорим,
что она «живёт дольше». Если бы Rust позволил этому коду работать, r ссылалась бы
на память, которая была освобождена, когда x вышла из области видимости, и
всё, что мы попытались бы сделать с r, не работало бы корректно. Итак, как Rust
определяет, что этот код недопустим? Он использует проверку заимствований.
Проверка заимствований
Компилятор Rust имеет проверку заимствований, которая сравнивает области видимости, чтобы определить, корректны ли все заимствования. Листинг 10-17 показывает тот же код, что и листинг 10-16, но с аннотациями, показывающими времена жизни переменных.
fn main() {
let r; // ---------+-- 'a
// |
{ // |
let x = 5; // -+-- 'b |
r = &x; // | |
} // -+ |
// |
println!("r: {r}"); // |
} // ---------+r и x, обозначенных как 'a и 'b соответственноЗдесь мы аннотировали время жизни r как 'a, а время жизни x
как 'b. Как видите, внутренний блок 'b намного меньше внешнего
блока времени жизни 'a. Во время компиляции Rust сравнивает размер этих двух
времён жизни и видит, что r имеет время жизни 'a, но что она ссылается на память
со временем жизни 'b. Программа отклоняется, потому что 'b короче, чем
'a: объект ссылки не живёт так же долго, как ссылка.
Листинг 10-18 исправляет код так, чтобы в нём не было висячей ссылки, и он компилируется без ошибок.
fn main() {
let x = 5; // ----------+-- 'b
// |
let r = &x; // --+-- 'a |
// | |
println!("r: {r}"); // | |
// --+ |
} // ----------+Здесь x имеет время жизни 'b, которое в данном случае больше, чем 'a. Это
означает, что r может ссылаться на x, потому что Rust знает, что ссылка в r будет
всегда корректна, пока корректна x.
Теперь, когда вы знаете, где находятся времена жизни ссылок и как Rust анализирует времена жизни, чтобы гарантировать, что ссылки всегда будут корректны, давайте рассмотрим обобщённые времена жизни в параметрах и возвращаемых значениях функций.
Обобщённые времена жизни в функциях
Мы напишем функцию, которая возвращает более длинную из двух строковых срезов. Эта
функция будет принимать два строковых среза и возвращать один строковый срез. После
того как мы реализуем функцию longest, код в листинге 10-19 должен
вывести The longest string is abcd.
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}main, которая вызывает функцию longest для нахождения более длинного из двух строковых срезовОбратите внимание, что мы хотим, чтобы функция принимала строковые срезы, то есть ссылки,
а не строки, потому что мы не хотим, чтобы функция longest становилась
владельцем своих параметров. Обратитесь к разделу «Строковые срезы как
параметры» в главе 4 для
дальнейшего обсуждения того, почему параметры, которые мы используем в листинге 10-19, — это те,
которые нам нужны.
Если мы попытаемся реализовать функцию longest, как показано в листинге 10-20, она
не скомпилируется.
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest(x: &str, y: &str) -> &str {
if x.len() > y.len() { x } else { y }
}longest, которая возвращает более длинный из двух строковых срезов, но пока не компилируетсяВместо этого мы получаем следующую ошибку, которая говорит о временах жизни:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0106]: missing lifetime specifier
--> src/main.rs:9:33
|
9 | fn longest(x: &str, y: &str) -> &str {
| ---- ---- ^ expected named lifetime parameter
|
= help: this function's return type contains a borrowed value, but the signature does not say whether it is borrowed from `x` or `y`
help: consider introducing a named lifetime parameter
|
9 | fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
| ++++ ++ ++ ++
For more information about this error, try `rustc --explain E0106`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Текст справки показывает, что возвращаемому типу нужен обобщённый параметр времени жизни,
потому что Rust не может определить, ссылается ли возвращаемая ссылка на
x или на y. На самом деле мы тоже этого не знаем, потому что блок if в теле
этой функции возвращает ссылку на x, а блок else возвращает
ссылку на y!
Когда мы определяем эту функцию, мы не знаем конкретные значения, которые будут
переданы в эту функцию, поэтому мы не знаем, будет ли выполняться случай if или
случай else. Мы также не знаем конкретные времена жизни
ссылок, которые будут переданы, поэтому мы не можем посмотреть на области видимости, как мы делали в
листингах 10-17 и 10-18, чтобы определить, будет ли возвращаемая ссылка
всегда корректна. Проверка заимствований тоже не может это определить, потому что она
не знает, как времена жизни x и y соотносятся со временем жизни
возвращаемого значения. Чтобы исправить эту ошибку, мы добавим обобщённые параметры времени жизни, которые
определяют связь между ссылками, чтобы проверка заимствований могла
выполнить свой анализ.
Синтаксис аннотации времён жизни
Аннотации времён жизни не изменяют, как долго живут какие-либо из ссылок. Скорее, они описывают связи между временами жизни нескольких ссылок, не влияя на сами времена жизни. Точно так же, как функции могут принимать любой тип, когда сигнатура указывает обобщённый параметр типа, функции могут принимать ссылки с любым временем жизни, указав обобщённый параметр времени жизни.
Аннотации времён жизни имеют несколько необычный синтаксис: имена параметров времени жизни
должны начинаться с апострофа (') и обычно пишутся строчными буквами
и очень короткими, как обобщённые типы. Большинство людей используют имя 'a для первой
аннотации времени жизни. Мы размещаем аннотации параметров времени жизни после &
ссылки, используя пробел для отделения аннотации от типа ссылки.
Вот несколько примеров — ссылка на i32 без параметра времени жизни,
ссылка на i32, которая имеет параметр времени жизни с именем 'a, и изменяемая
ссылка на i32, которая также имеет время жизни 'a:
&i32 // ссылка
&'a i32 // ссылка с явным временем жизни
&'a mut i32 // изменяемая ссылка с явным временем жизниОдна аннотация времени жизни сама по себе не имеет большого значения, потому что
аннотации предназначены для того, чтобы сообщить Rust, как обобщённые параметры времени жизни нескольких
ссылок соотносятся друг с другом. Давайте рассмотрим, как аннотации времён жизни
соотносятся друг с другом в контексте функции longest.
В сигнатурах функций
Чтобы использовать аннотации времён жизни в сигнатурах функций, нам нужно объявить обобщённые параметры времени жизни внутри угловых скобок между именем функции и списком параметров, точно так же, как мы делали с обобщёнными параметрами типа.
Мы хотим, чтобы сигнатура выражала следующее ограничение: возвращаемая
ссылка будет корректна до тех пор, пока корректны оба параметра. Это
связь между временами жизни параметров и возвращаемого значения.
Мы назовём время жизни 'a, а затем добавим его к каждой ссылке, как показано в
листинге 10-21.
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}longest, в котором указано, что все ссылки в сигнатуре должны иметь одинаковое время жизни 'aЭтот код должен скомпилироваться и выдать желаемый результат при использовании с
функцией main из листинга 10-19.
Сигнатура функции теперь сообщает Rust, что для некоторого времени жизни 'a функция
принимает два параметра, оба из которых являются строковыми срезами, живущими как минимум столько же,
сколько время жизни 'a. Сигнатура функции также сообщает Rust, что строковый
срез, возвращаемый из функции, будет жить как минимум столько же, сколько время жизни 'a.
На практике это означает, что время жизни ссылки, возвращаемой функцией
longest, совпадает с меньшим из времён жизни значений,
на которые ссылаются аргументы функции. Эти связи — то, что мы хотим, чтобы
Rust использовал при анализе этого кода.
Помните, когда мы указываем параметры времени жизни в этой сигнатуре функции,
мы не изменяем времена жизни каких-либо значений, переданных или возвращённых. Скорее,
мы указываем, что проверка заимствований должна отклонять любые значения, которые не
соответствуют этим ограничениям. Обратите внимание, что функции longest не нужно
знать точно, как долго будут жить x и y, только то, что некоторая область видимости может быть
подставлена вместо 'a, которая удовлетворит этой сигнатуре.
При аннотировании времён жизни в функциях аннотации размещаются в сигнатуре функции, а не в теле функции. Аннотации времён жизни становятся частью контракта функции, во многом как типы в сигнатуре. Наличие сигнатур функций, содержащих контракт времени жизни, означает, что анализ, выполняемый компилятором Rust, может быть проще. Если есть проблема с тем, как функция аннотирована или как она вызывается, ошибки компилятора могут указывать на ту часть нашего кода и ограничений более точно. Если бы вместо этого компилятор Rust делал больше выводов о том, какими мы предполагали связи времён жизни, компилятор мог бы только указать на использование нашего кода на много шагов дальше от причины проблемы.
Когда мы передаём конкретные ссылки в longest, конкретное время жизни, которое
подставляется вместо 'a, — это часть области видимости x, которая пересекается с
областью видимости y. Другими словами, обобщённое время жизни 'a получит конкретное
время жизни, равное меньшему из времён жизни x и y. Поскольку
мы аннотировали возвращаемую ссылку тем же параметром времени жизни 'a,
возвращаемая ссылка также будет корректна в течение длины меньшего из
времён жизни x и y.
Давайте посмотрим, как аннотации времён жизни ограничивают функцию longest,
передавая ссылки с разными конкретными временами жизни. Листинг 10-22 —
простой пример.
fn main() {
let string1 = String::from("long string is long");
{
let string2 = String::from("xyz");
let result = longest(string1.as_str(), string2.as_str());
println!("The longest string is {result}");
}
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}longest со ссылками на значения String, которые имеют разные конкретные времена жизниВ этом примере string1 корректна до конца внешней области видимости, string2
корректна до конца внутренней области видимости, а result ссылается на что-то,
что корректно до конца внутренней области видимости. Запустите этот код, и вы увидите,
что проверка заимствований одобряет его; он скомпилируется и выведет The longest string is long string is long.
Далее давайте попробуем пример, который показывает, что время жизни ссылки в
result должно быть меньшим временем жизни из двух аргументов. Мы переместим
объявление переменной result за пределы внутренней области видимости, но оставим
присвоение значения переменной result внутри области видимости с
string2. Затем мы переместим println!, который использует result, за пределы
внутренней области видимости, после того как внутренняя область видимости закончится. Код в листинге 10-23
не скомпилируется.
fn main() {
let string1 = String::from("long string is long");
let result;
{
let string2 = String::from("xyz");
result = longest(string1.as_str(), string2.as_str());
}
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}result после того, как string2 вышла из области видимостиКогда мы пытаемся скомпилировать этот код, мы получаем эту ошибку:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0597]: `string2` does not live long enough
--> src/main.rs:6:44
|
5 | let string2 = String::from("xyz");
| ------- binding `string2` declared here
6 | result = longest(string1.as_str(), string2.as_str());
| ^^^^^^^ borrowed value does not live long enough
7 | }
| - `string2` dropped here while still borrowed
8 | println!("The longest string is {result}");
| ------ borrow later used here
For more information about this error, try `rustc --explain E0597`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Ошибка показывает, что для того, чтобы result была корректна для оператора println!,
string2 должна была бы быть корректна до конца внешней области видимости. Rust знает
это, потому что мы аннотировали времена жизни параметров функции и возвращаемого
значения, используя один и тот же параметр времени жизни 'a.
Как люди, мы можем взглянуть на этот код и увидеть, что string1 длиннее, чем
string2, и, следовательно, result будет содержать ссылку на string1.
Поскольку string1 ещё не вышла из области видимости, ссылка на string1 будет
по-прежнему корректна для оператора println!. Однако компилятор не может увидеть,
что ссылка корректна в этом случае. Мы сообщили Rust, что время жизни
ссылки, возвращаемой функцией longest, совпадает с меньшим из
времён жизни переданных ссылок. Следовательно, проверка заимствований
запрещает код в листинге 10-23 как потенциально содержащий некорректную ссылку.
Попробуйте разработать больше экспериментов, варьируя значения и времена жизни
ссылок, передаваемых в функцию longest, и то, как используется возвращаемая ссылка.
Сформулируйте гипотезы о том, пройдут ли ваши эксперименты
проверку заимствований, прежде чем компилировать; затем проверьте, правы ли вы!
Связи
Способ, которым нужно указывать параметры времени жизни, зависит от того, что делает ваша
функция. Например, если бы мы изменили реализацию функции
longest, чтобы всегда возвращать первый параметр, а не самый длинный
строковый срез, нам не нужно было бы указывать время жизни для параметра y. Следующий
код скомпилируется:
fn main() {
let string1 = String::from("abcd");
let string2 = "efghijklmnopqrstuvwxyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &str) -> &'a str {
x
}Мы указали параметр времени жизни 'a для параметра x и возвращаемого
типа, но не для параметра y, потому что время жизни y не имеет
никакой связи со временем жизни x или возвращаемого значения.
Когда функция возвращает ссылку, параметр времени жизни для
возвращаемого типа должен совпадать с параметром времени жизни для одного из параметров. Если
возвращаемая ссылка не ссылается на один из параметров, она должна ссылаться
на значение, созданное внутри этой функции. Однако это была бы висячая
ссылка, потому что значение выйдет из области видимости в конце функции.
Рассмотрим эту попытку реализации функции longest, которая не будет
компилироваться:
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &str, y: &str) -> &'a str {
let result = String::from("really long string");
result.as_str()
}Здесь, хотя мы указали параметр времени жизни 'a для возвращаемого
типа, эта реализация не скомпилируется, потому что время жизни возвращаемого значения
вообще не связано со временем жизни параметров. Вот
сообщение об ошибке, которое мы получаем:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0515]: cannot return value referencing local variable `result`
--> src/main.rs:11:5
|
11 | result.as_str()
| ------^^^^^^^^^
| |
| returns a value referencing data owned by the current function
| `result` is borrowed here
For more information about this error, try `rustc --explain E0515`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Проблема в том, что result выходит из области видимости и очищается в конце
функции longest. Мы также пытаемся вернуть ссылку на result
из функции. Невозможно указать параметры времени жизни, которые
изменили бы висячую ссылку, и Rust не позволит нам создать висячую
ссылку. В этом случае лучшим исправлением было бы вернуть тип с владением,
а не ссылку, чтобы вызывающая функция затем отвечала за
очистку значения.
В конечном итоге синтаксис времён жизни связан с соединением времён жизни различных параметров и возвращаемых значений функций. Как только они соединены, у Rust есть достаточно информации, чтобы разрешать безопасные операции с памятью и запрещать операции, которые создали бы висячие указатели или иным образом нарушили безопасность памяти.
В определениях структур
До сих пор все структуры, которые мы определяли, хранят типы с владением. Мы можем определять структуры
для хранения ссылок, но в этом случае нам нужно было бы добавить аннотацию времени жизни
к каждой ссылке в определении структуры. Листинг 10-24 показывает
структуру с именем ImportantExcerpt, которая хранит строковый срез.
struct ImportantExcerpt<'a> {
part: &'a str,
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}Эта структура имеет единственное поле part, которое хранит строковый срез, то есть
ссылку. Как и с обобщёнными типами данных, мы объявляем имя обобщённого
параметра времени жизни внутри угловых скобок после имени структуры, чтобы
мы могли использовать параметр времени жизни в теле определения структуры. Эта
аннотация означает, что экземпляр ImportantExcerpt не может пережить ссылку,
которую он хранит в своём поле part.
Функция main здесь создаёт экземпляр структуры ImportantExcerpt,
который хранит ссылку на первое предложение String, принадлежащей
переменной novel. Данные в novel существуют до того, как экземпляр ImportantExcerpt
будет создан. Кроме того, novel не выходит из области видимости до тех пор, пока
ImportantExcerpt не выйдет из области видимости, поэтому ссылка в
экземпляре ImportantExcerpt корректна.
Выведение времён жизни
Вы узнали, что каждая ссылка имеет время жизни и что нужно указывать параметры времени жизни для функций или структур, использующих ссылки. Однако у нас была функция в листинге 4-9, снова показанная в листинге 10-25, которая скомпилировалась без аннотаций времён жизни.
fn first_word(s: &str) -> &str {
let bytes = s.as_bytes();
for (i, &item) in bytes.iter().enumerate() {
if item == b' ' {
return &s[0..i];
}
}
&s[..]
}
fn main() {
let my_string = String::from("hello world");
// first_word работает со срезами `String`
let word = first_word(&my_string[..]);
let my_string_literal = "hello world";
// first_word работает со срезами строковых литералов
let word = first_word(&my_string_literal[..]);
// Поскольку строковые литералы *и есть* срезы строк,
// это тоже работает, без синтаксиса среза!
let word = first_word(my_string_literal);
}Причина, по которой эта функция компилируется без аннотаций времён жизни, историческая: в ранних версиях (до 1.0) Rust этот код не скомпилировался бы, потому что каждая ссылка нуждалась в явном времени жизни. В то время сигнатура функции была бы записана так:
fn first_word<'a>(s: &'a str) -> &'a str {После написания большого количества кода на Rust команда Rust обнаружила, что программисты на Rust вводили одни и те же аннотации времён жизни снова и снова в определённых ситуациях. Эти ситуации были предсказуемы и следовали нескольким детерминированным шаблонам. Разработчики запрограммировали эти шаблоны в код компилятора, чтобы проверка заимствований могла выводить времена жизни в этих ситуациях и не нуждалась в явных аннотациях.
Этот фрагмент истории Rust актуален, потому что возможно, что больше детерминированных шаблонов появится и будет добавлено в компилятор. В будущем может потребоваться ещё меньше аннотаций времён жизни.
Шаблоны, запрограммированные в анализ ссылок Rust, называются правилами выведения времён жизни. Это не правила, которым должны следовать программисты; они представляют собой набор конкретных случаев, которые компилятор будет рассматривать, и если ваш код соответствует этим случаям, вам не нужно писать времена жизни явно.
Правила выведения не обеспечивают полный вывод. Если после применения правил Rust остаётся неоднозначность в отношении того, какие времена жизни имеют ссылки, компилятор не будет угадывать, каким должно быть время жизни оставшихся ссылок. Вместо угадывания компилятор выдаст ошибку, которую можно устранить, добавив аннотации времён жизни.
Времена жизни параметров функции или метода называются входными временами жизни, а времена жизни возвращаемых значений — выходными временами жизни.
Компилятор использует три правила, чтобы определить времена жизни ссылок,
когда нет явных аннотаций. Первое правило применяется к входным
временам жизни, а второе и третье правила применяются к выходным временам жизни. Если
компилятор доходит до конца трёх правил, и всё ещё есть ссылки, для
которых он не может определить времена жизни, компилятор остановится с ошибкой.
Эти правила применяются к определениям fn, а также к блокам impl.
Первое правило состоит в том, что компилятор назначает параметр времени жизни каждому
параметру, который является ссылкой. Другими словами, функция с одним параметром
получает один параметр времени жизни: fn foo<'a>(x: &'a i32); функция с двумя
параметрами получает два отдельных параметра времени жизни: fn foo<'a, 'b>(x: &'a i32, y: &'b i32); и так далее.
Второе правило состоит в том, что если есть ровно один входной параметр времени жизни, это
время жизни назначается всем выходным параметрам времени жизни: fn foo<'a>(x: &'a i32) -> &'a i32.
Третье правило состоит в том, что если есть несколько входных параметров времени жизни, но
один из них — &self или &mut self, потому что это метод, время жизни
self назначается всем выходным параметрам времени жизни. Это третье правило делает
методы гораздо приятнее читать и писать, потому что требуется меньше символов.
Давайте представим, что мы — компилятор. Мы применим эти правила, чтобы определить
времена жизни ссылок в сигнатуре функции first_word из
листинга 10-25. Сигнатура начинается без каких-либо времён жизни, связанных со
ссылками:
fn first_word(s: &str) -> &str {Затем компилятор применяет первое правило, которое указывает, что каждый параметр
получает своё собственное время жизни. Мы назовём его 'a, как обычно, так что теперь сигнатура
такова:
fn first_word<'a>(s: &'a str) -> &str {Второе правило применяется, потому что есть ровно одно входное время жизни. Второе правило указывает, что время жизни единственного входного параметра назначается выходному времени жизни, так что сигнатура теперь такова:
fn first_word<'a>(s: &'a str) -> &'a str {Теперь все ссылки в этой сигнатуре функции имеют времена жизни, и компилятор может продолжить свой анализ, не требуя от программиста аннотировать времена жизни в этой сигнатуре функции.
Давайте посмотрим на другой пример, на этот раз используя функцию longest, у которой
не было параметров времени жизни, когда мы начали работать с ней в листинге 10-20:
fn longest(x: &str, y: &str) -> &str {Давайте применим первое правило: каждый параметр получает своё собственное время жизни. На этот раз у нас два параметра вместо одного, поэтому у нас два времени жизни:
fn longest<'a, 'b>(x: &'a str, y: &'b str) -> &str {Вы можете видеть, что второе правило не применяется, потому что есть более одного
входного времени жизни. Третье правило тоже не применяется, потому что longest — это
функция, а не метод, поэтому ни один из параметров не является self. Пройдя через все три правила,
мы всё ещё не определили, каково время жизни возвращаемого
типа. Именно поэтому мы получили ошибку при попытке скомпилировать код в
листинге 10-20: компилятор прошёл через правила выведения времён жизни, но всё ещё
не смог определить все времена жизни ссылок в сигнатуре.
Поскольку третье правило действительно применяется только в сигнатурах методов, мы рассмотрим времена жизни в этом контексте далее, чтобы понять, почему третье правило означает, что нам не нужно аннотировать времена жизни в сигнатурах методов очень часто.
В определениях методов
Когда мы реализуем методы для структуры с временами жизни, мы используем тот же синтаксис, что и для обобщённых параметров типа, как показано в листинге 10-11. То, где мы объявляем и используем параметры времени жизни, зависит от того, связаны ли они с полями структуры или параметрами метода и возвращаемыми значениями.
Имена времён жизни для полей структуры всегда нужно объявлять после ключевого слова impl,
а затем использовать после имени структуры, потому что эти времена жизни являются частью
типа структуры.
В сигнатурах методов внутри блока impl ссылки могут быть связаны со
временем жизни ссылок в полях структуры, или они могут быть независимыми. Кроме того,
правила выведения времён жизни часто делают так, что аннотации времён жизни
не нужны в сигнатурах методов. Давайте рассмотрим несколько примеров с использованием
структуры с именем ImportantExcerpt, которую мы определили в листинге 10-24.
Сначала мы используем метод с именем level, единственный параметр которого — ссылка на
self, а возвращаемое значение — i32, который не является ссылкой ни на что:
struct ImportantExcerpt<'a> {
part: &'a str,
}
impl<'a> ImportantExcerpt<'a> {
fn level(&self) -> i32 {
3
}
}
impl<'a> ImportantExcerpt<'a> {
fn announce_and_return_part(&self, announcement: &str) -> &str {
println!("Attention please: {announcement}");
self.part
}
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}Объявление параметра времени жизни после impl и его использование после имени типа
требуются, но из-за первого правила выведения нам не требуется
аннотировать время жизни ссылки на self.
Вот пример, где применяется третье правило выведения времён жизни:
struct ImportantExcerpt<'a> {
part: &'a str,
}
impl<'a> ImportantExcerpt<'a> {
fn level(&self) -> i32 {
3
}
}
impl<'a> ImportantExcerpt<'a> {
fn announce_and_return_part(&self, announcement: &str) -> &str {
println!("Attention please: {announcement}");
self.part
}
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}Здесь два входных времени жизни, поэтому Rust применяет первое правило выведения времён жизни
и даёт и &self, и announcement свои собственные времена жизни. Затем, поскольку
один из параметров — &self, возвращаемый тип получает время жизни &self,
и все времена жизни учтены.
Время жизни 'static
Одно особое время жизни, которое нужно обсудить, — это 'static, которое обозначает, что
затронутая ссылка может жить в течение всего времени работы программы. Все
строковые литералы имеют время жизни 'static, что можно аннотировать так:
#![allow(unused)]
fn main() {
let s: &'static str = "I have a static lifetime.";
}Текст этой строки хранится непосредственно в двоичном файле программы, который
всегда доступен. Следовательно, время жизни всех строковых литералов — 'static.
Вы можете увидеть в сообщениях об ошибках предложения использовать время жизни 'static. Но
прежде чем указывать 'static в качестве времени жизни для ссылки, подумайте,
действительно ли ссылка, которая у вас есть, живёт в течение всего времени жизни
вашей программы и хотите ли вы этого. В большинстве случаев сообщение об ошибке,
предлагающее время жизни 'static, является результатом попытки создать висячую
ссылку или несоответствия доступных времён жизни. В таких случаях решение
заключается в исправлении этих проблем, а не в указании времени жизни 'static.
Обобщённые параметры типа, ограничения трейтов и времена жизни
Давайте кратко рассмотрим синтаксис указания обобщённых параметров типа, ограничений трейтов и времён жизни — всё в одной функции!
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest_with_an_announcement(
string1.as_str(),
string2,
"Today is someone's birthday!",
);
println!("The longest string is {result}");
}
use std::fmt::Display;
fn longest_with_an_announcement<'a, T>(
x: &'a str,
y: &'a str,
ann: T,
) -> &'a str
where
T: Display,
{
println!("Announcement! {ann}");
if x.len() > y.len() { x } else { y }
}Это функция longest из листинга 10-21, которая возвращает более длинный из
двух строковых срезов. Но теперь у неё есть дополнительный параметр с именем ann обобщённого
типа T, который может быть заполнен любым типом, реализующим трейт Display,
как указано в предложении where. Этот дополнительный параметр будет выведен
с помощью {}, поэтому необходимо ограничение трейта Display. Поскольку
времена жизни являются разновидностью обобщений, объявления параметра времени жизни
'a и обобщённого параметра типа T идут в одном списке внутри угловых
скобок после имени функции.
Итоги
В этой главе мы рассмотрели многое! Теперь, когда вы знаете об обобщённых параметрах типа, трейтах и ограничениях трейтов, а также об обобщённых параметрах времени жизни, вы готовы писать код без повторений, работающий во многих разных ситуациях. Обобщённые параметры типа позволяют применять код к разным типам. Трейты и ограничения трейтов гарантируют, что даже несмотря на то, что типы обобщённые, у них будет поведение, необходимое коду. Вы узнали, как использовать аннотации времён жизни, чтобы гарантировать, что этот гибкий код не будет содержать висячих ссылок. И весь этот анализ происходит во время компиляции, что не влияет на производительность во время выполнения!
Хотите верьте, хотите нет, но по темам, которые мы обсудили в этой главе, можно узнать гораздо больше: глава 18 рассматривает трейт-объекты, которые являются ещё одним способом использования трейтов. Также существуют более сложные сценарии, связанные с аннотациями времён жизни, которые вам понадобятся только в очень продвинутых случаях; для них вам следует прочитать Справочник по Rust. Но далее вы узнаете, как писать тесты на Rust, чтобы можно было убедиться, что ваш код работает так, как должен.
Написание автоматических тестов
Написание автоматических тестов
В своём эссе 1972 года «Смиренный программист» Эдсгер В. Дейкстра сказал, что «тестирование программ может быть очень эффективным способом показать наличие ошибок, но оно безнадёжно неадекватно для показа их отсутствия». Это не значит, что мы не должны пытаться тестировать как можно больше!
Корректность в наших программах — это степень, в которой наш код делает то, что мы задумали. Rust разработан с высокой степенью заботы о корректности программ, но корректность сложна и нелегка для доказательства. Система типов Rust берёт на себя огромную часть этого бремени, но система типов не может поймать всё. Таким образом, Rust включает поддержку написания автоматических программных тестов.
Скажем, мы пишем функцию add_two, которая добавляет 2 к любому переданному
числу. Сигнатура этой функции принимает целое число в качестве параметра и возвращает
целое число в качестве результата. Когда мы реализуем и компилируем эту функцию, Rust выполняет всю
проверку типов и проверку заимствований, которую вы изучили до сих пор, чтобы гарантировать,
что, например, мы не передаём значение String или недопустимую ссылку
в эту функцию. Но Rust не может проверить, что эта функция будет делать именно
то, что мы задумали, а именно возвращать параметр плюс 2, а не, скажем,
параметр плюс 10 или параметр минус 50! Вот где вступают в игру тесты.
Мы можем написать тесты, которые утверждают, например, что когда мы передаём 3 в
функцию add_two, возвращаемое значение равно 5. Мы можем запускать эти тесты всякий раз,
когда вносим изменения в наш код, чтобы убедиться, что существующее корректное поведение не
изменилось.
Тестирование — сложный навык: хотя мы не можем охватить в одной главе каждую деталь о том, как писать хорошие тесты, в этой главе мы обсудим механику средств тестирования Rust. Мы поговорим об аннотациях и макросах, доступных вам при написании тестов, о поведении по умолчанию и опциях, предоставляемых для запуска тестов, и о том, как организовать тесты на модульные тесты и интеграционные тесты.
Как писать тесты
Как писать тесты
Тесты — это функции Rust, которые проверяют, что не-тестовый код работает ожидаемым образом. Тела тестовых функций обычно выполняют эти три действия:
- Настраивают любые необходимые данные или состояние.
- Запускают код, который требуется протестировать.
- Проверяют, что результаты соответствуют ожиданиям.
Давайте рассмотрим возможности, которые Rust предоставляет специально для написания тестов,
реализующих эти действия, включая атрибут test, несколько макросов и
атрибут should_panic.
Структура тестовых функций
В самом простом случае тест в Rust — это функция, аннотированная атрибутом test.
Атрибуты — это метаданные о фрагментах кода Rust; один из примеров — это
атрибут derive, который мы использовали со структурами в главе 5. Чтобы превратить функцию
в тестовую, добавьте #[test] в строке перед fn. Когда вы запускаете свои
тесты командой cargo test, Rust собирает бинарный файл запуска тестов, который запускает
аннотированные функции и сообщает, проходит ли каждая тестовая функция или
терпит неудачу.
Всякий раз, когда мы создаём новый библиотечный проект с помощью Cargo, для нас автоматически генерируется тестовый модуль с тестовой функцией внутри. Этот модуль даёт вам шаблон для написания тестов, чтобы вам не приходилось искать точную структуру и синтаксис каждый раз, когда вы начинаете новый проект. Вы можете добавить сколько угодно дополнительных тестовых функций и сколько угодно тестовых модулей!
Мы исследуем некоторые аспекты работы тестов, экспериментируя с шаблонным тестом, прежде чем фактически тестировать какой-либо код. Затем мы напишем несколько реальных тестов, которые вызывают код, который мы написали, и проверяют, что его поведение корректно.
Давайте создадим новый библиотечный проект с именем adder, который будет складывать два числа:
$ cargo new adder --lib
Created library `adder` project
$ cd adder
Содержимое файла src/lib.rs в вашей библиотеке adder должно выглядеть как
в листинге 11-1.
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}cargo newФайл начинается с примера функции add, чтобы у нас было что
тестировать.
Пока сосредоточимся исключительно на функции it_works. Обратите внимание на аннотацию #[test]:
этот атрибут указывает, что это тестовая функция, поэтому средство запуска тестов знает,
что эту функцию нужно рассматривать как тест. У нас также могут быть не-тестовые
функции в модуле tests для настройки общих сценариев или выполнения
общих операций, поэтому нам всегда нужно указывать, какие функции являются тестами.
Тело примерной функции использует макрос assert_eq!, чтобы проверить, что result,
содержащий результат вызова add с аргументами 2 и 2, равен 4. Это
утверждение служит примером формата типичного теста. Давайте запустим его,
чтобы увидеть, что этот тест проходит.
Команда cargo test запускает все тесты в нашем проекте, как показано в листинге
11-2.
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.57s
Running unittests src/lib.rs (target/debug/deps/adder-01ad14159ff659ab)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Cargo скомпилировал и запустил тест. Мы видим строку running 1 test. Следующая
строка показывает имя сгенерированной тестовой функции tests::it_works,
и что результат выполнения этого теста — ok. Общая сводка test result: ok.
означает, что все тесты прошли, а фрагмент, который читается как 1 passed; 0 failed, суммирует количество прошедших и неудачных тестов.
Можно пометить тест как игнорируемый, чтобы он не запускался в конкретном
случае; мы рассмотрим это в разделе «Игнорирование тестов, если они не запрошены специально» далее в этой главе. Поскольку мы
не делали этого здесь, в сводке отображается 0 ignored. Мы также можем передать
аргумент команде cargo test, чтобы запускать только тесты, имя которых совпадает со
строкой; это называется фильтрацией, и мы рассмотрим это в разделе «Запуск
подмножества тестов по имени». Здесь мы не
фильтровали запускаемые тесты, поэтому в конце сводки отображается 0 filtered out.
Статистика 0 measured предназначена для бенчмарк-тестов, которые измеряют производительность.
Бенчмарк-тесты на момент написания доступны только в ночной сборке Rust. См.
документацию о бенчмарк-тестах, чтобы узнать больше.
Следующая часть вывода тестов, начинающаяся с Doc-tests adder, относится к
результатам любых документационных тестов. У нас пока нет документационных тестов,
но Rust может компилировать любые примеры кода, которые появляются в нашей документации API.
Эта возможность помогает поддерживать документацию и код в синхронизации! Мы обсудим, как
писать документационные тесты, в разделе «Комментарии документации как тесты» главы 14. Пока мы будем
игнорировать вывод Doc-tests.
Давайте начнём настраивать тест под наши собственные нужды. Сначала изменим имя
функции it_works на другое, например exploration, вот так:
Имя файла: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn exploration() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}Затем снова запустите cargo test. Теперь вывод показывает exploration вместо
it_works:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.59s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::exploration ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Теперь мы добавим ещё один тест, но на этот раз мы сделаем тест, который терпит неудачу! Тесты
терпят неудачу, когда что-то в тестовой функции паникует. Каждый тест запускается в новом
потоке, и когда главный поток видит, что тестовый поток завершился, тест
помечается как неудачный. В главе 9 мы говорили о том, что простейший способ вызвать панику —
вызвать макрос panic!. Введите новый тест как функцию с именем
another, чтобы ваш файл src/lib.rs выглядел как в листинге 11-3.
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn exploration() {
let result = add(2, 2);
assert_eq!(result, 4);
}
#[test]
fn another() {
panic!("Make this test fail");
}
}panic!Снова запустите тесты с помощью cargo test. Вывод должен выглядеть как в листинге
11-4, который показывает, что наш тест exploration прошёл, а another завершился неудачей.
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.72s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::another ... FAILED
test tests::exploration ... ok
failures:
---- tests::another stdout ----
thread 'tests::another' (6019162) panicked at src/lib.rs:17:9:
Make this test fail
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::another
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Вместо ok строка test tests::another показывает FAILED. Появляются два новых
раздела между отдельными результатами и сводкой: первый
отображает подробную причину для каждого неудачного теста. В данном случае мы получаем
сведения о том, что tests::another завершился неудачей, потому что он запаниковал с сообщением Make this test fail
в строке 17 файла src/lib.rs. Следующий раздел перечисляет
только имена всех неудачных тестов, что полезно, когда есть много
тестов и много подробного вывода о неудачных тестах. Мы можем использовать имя
неудачного теста, чтобы запустить только этот тест и отладить его более легко; мы поговорим подробнее
о способах запуска тестов в разделе «Управление запуском тестов».
Строка сводки отображается в конце: в целом, наш результат теста — FAILED. У нас
был один прошедший тест и один неудачный.
Теперь, когда вы увидели, как выглядят результаты тестов в разных сценариях,
давайте рассмотрим некоторые макросы, кроме panic!, которые полезны в тестах.
Проверка результатов с помощью assert!
Макрос assert!, предоставляемый стандартной библиотекой, полезен, когда нужно
убедиться, что некоторое условие в тесте вычисляется в true. Мы передаём
макросу assert! аргумент, который вычисляется в логическое значение. Если значение —
true, ничего не происходит и тест проходит. Если значение — false,
макрос assert! вызывает panic!, чтобы вызвать неудачу теста. Использование макроса assert!
помогает проверить, что наш код работает так, как мы задумали.
В главе 5, листинге 5-15, мы использовали структуру Rectangle и метод can_hold,
которые повторены здесь в листинге 11-5. Давайте поместим этот код в
файл src/lib.rs, а затем напишем для него несколько тестов с использованием макроса assert!.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}Rectangle и её метод can_hold из главы 5Метод can_hold возвращает логическое значение, что означает, что это идеальный случай
для использования макроса assert!. В листинге 11-6 мы пишем тест, который упражняет
метод can_hold, создавая экземпляр Rectangle с шириной 8 и
высотой 7 и утверждая, что он может содержать другой экземпляр Rectangle
с шириной 5 и высотой 1.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
}can_hold, который проверяет, действительно ли больший прямоугольник может содержать меньший прямоугольникОбратите внимание на строку use super::*; внутри модуля tests. Модуль tests —
это обычный модуль, который следует обычным правилам видимости, которые мы рассмотрели в главе
7 в разделе «Пути для ссылки на элемент в дереве
модулей». Поскольку модуль tests является внутренним модулем, нам нужно внести
тестируемый код из внешнего модуля в область видимости внутреннего модуля. Мы используем
здесь glob, поэтому всё, что мы определяем во внешнем модуле, доступно этому
модулю tests.
Мы назвали наш тест larger_can_hold_smaller, и мы создали два
экземпляра Rectangle, которые нам нужны. Затем мы вызвали макрос assert! и
передали ему результат вызова larger.can_hold(&smaller). Это выражение
должно вернуть true, поэтому наш тест должен пройти. Давайте выясним!
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 1 test
test tests::larger_can_hold_smaller ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests rectangle
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Он действительно проходит! Давайте добавим ещё один тест, на этот раз утверждая, что меньший прямоугольник не может содержать больший прямоугольник:
Имя файла: src/lib.rs
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
// --snip--
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
#[test]
fn smaller_cannot_hold_larger() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(!smaller.can_hold(&larger));
}
}Поскольку правильный результат функции can_hold в этом случае — false,
нам нужно инвертировать этот результат, прежде чем передать его в макрос assert!. В результате
наш тест пройдёт, если can_hold вернёт false:
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 2 tests
test tests::larger_can_hold_smaller ... ok
test tests::smaller_cannot_hold_larger ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests rectangle
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Два теста проходят! Теперь давайте посмотрим, что произойдёт с результатами наших тестов, когда мы
внесём ошибку в наш код. Мы изменим реализацию метода can_hold,
заменив знак «больше» (>) на знак «меньше» (<)
при сравнении ширин:
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
// --snip--
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width < other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
#[test]
fn smaller_cannot_hold_larger() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(!smaller.can_hold(&larger));
}
}Теперь выполнение тестов выдаёт следующее:
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 2 tests
test tests::larger_can_hold_smaller ... FAILED
test tests::smaller_cannot_hold_larger ... ok
failures:
---- tests::larger_can_hold_smaller stdout ----
thread 'tests::larger_can_hold_smaller' (6020788) panicked at src/lib.rs:28:9:
assertion failed: larger.can_hold(&smaller)
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::larger_can_hold_smaller
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Наши тесты обнаружили ошибку! Поскольку larger.width равно 8, а smaller.width равно
5, сравнение ширин в can_hold теперь возвращает false: 8 не
меньше 5.
Проверка равенства с помощью assert_eq! и assert_ne!
Распространённый способ проверить функциональность — проверить равенство между результатом
тестируемого кода и значением, которое вы ожидаете получить от кода. Это можно
сделать с помощью макроса assert!, передав ему выражение с оператором
==. Однако это настолько распространённый вид теста, что стандартная библиотека
предоставляет пару макросов — assert_eq! и assert_ne! — для выполнения этой проверки
более удобно. Эти макросы сравнивают два аргумента на равенство или
неравенство соответственно. Они также выведут оба значения, если утверждение
не выполняется, что упрощает понимание причины неудачи теста; напротив,
макрос assert! только указывает, что он получил значение false для выражения ==,
без вывода значений, которые привели к значению false.
В листинге 11-7 мы пишем функцию с именем add_two, которая добавляет 2 к своему
параметру, а затем тестируем эту функцию с помощью макроса assert_eq!.
pub fn add_two(a: u64) -> u64 {
a + 2
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
}add_two с помощью макроса assert_eq!Давайте проверим, что он проходит!
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Мы создаём переменную с именем result, которая содержит результат вызова
add_two(2). Затем мы передаём result и 4 в качестве аргументов макросу
assert_eq!. Строка вывода для этого теста — test tests::it_adds_two ... ok, а текст ok
указывает, что наш тест прошёл!
Давайте внесём ошибку в наш код, чтобы увидеть, как выглядит assert_eq!, когда он
терпит неудачу. Изменим реализацию функции add_two, чтобы она добавляла 3:
pub fn add_two(a: u64) -> u64 {
a + 3
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
}Снова запустите тесты:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::it_adds_two ... FAILED
failures:
---- tests::it_adds_two stdout ----
thread 'tests::it_adds_two' (6020955) panicked at src/lib.rs:12:9:
assertion `left == right` failed
left: 5
right: 4
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::it_adds_two
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Наш тест обнаружил ошибку! Тест tests::it_adds_two завершился неудачей, и сообщение
говорит нам, что невыполненное утверждение было left == right, и каковы значения left
и right. Это сообщение помогает нам начать отладку: аргумент left,
где у нас был результат вызова add_two(2), был 5, но
аргумент right был 4. Вы можете представить, что это было бы особенно полезно,
когда у нас много тестов.
Обратите внимание, что в некоторых языках и тестовых фреймворках параметры функций
проверки равенства называются expected и actual, и порядок, в котором
мы указываем аргументы, имеет значение. Однако в Rust они называются left и
right, и порядок, в котором мы указываем значение, которое ожидаем, и значение,
которое производит код, не имеет значения. Мы могли бы записать утверждение в этом тесте как
assert_eq!(4, result), что привело бы к тому же сообщению о неудаче, которое
отображает assertion `left == right` failed.
Макрос assert_ne! пройдёт, если два переданных ему значения не равны, и
потерпит неудачу, если они равны. Этот макрос наиболее полезен в случаях, когда мы не
уверены, каким будет значение, но знаем, каким значение определённо не должно
быть. Например, если мы тестируем функцию, которая гарантированно изменяет свой
входной параметр каким-либо образом, но то, каким образом изменяется входной параметр, зависит от дня
недели, в который мы запускаем наши тесты, лучше всего утверждать, что
вывод функции не равен входному параметру.
Под капотом макросы assert_eq! и assert_ne! используют операторы
== и != соответственно. Когда утверждения не выполняются, эти макросы выводят свои
аргументы с использованием отладочного форматирования, что означает, что сравниваемые значения должны
реализовывать трейты PartialEq и Debug. Все примитивные типы и большинство
типов стандартной библиотеки реализуют эти трейты. Для структур и перечислений, которые
вы определяете сами, вам нужно будет реализовать PartialEq, чтобы утверждать равенство
этих типов. Вам также нужно будет реализовать Debug, чтобы выводить значения, когда
утверждение не выполняется. Поскольку оба трейта являются выводимыми трейтами, как упомянуто в
листинге 5-12 в главе 5, обычно это так же просто, как добавить
аннотацию #[derive(PartialEq, Debug)] к определению вашей структуры или перечисления. См.
приложение C, «Выводимые трейты», для получения дополнительных
сведений об этих и других выводимых трейтах.
Добавление пользовательских сообщений о неудаче
Вы также можете добавить пользовательское сообщение, которое будет выводиться вместе с сообщением о неудаче, в качестве
необязательных аргументов для макросов assert!, assert_eq! и assert_ne!. Любые
аргументы, указанные после обязательных аргументов, передаются макросу
format! (обсуждавшемуся в разделе «Конкатенация с помощью + или
format!» главы 8), поэтому вы можете передать строку формата, содержащую заполнители {}
и значения для подстановки в эти заполнители. Пользовательские сообщения полезны
для документирования того, что означает утверждение; когда тест терпит неудачу, у вас будет лучшее
представление о том, в чём проблема с кодом.
Например, предположим, у нас есть функция, которая приветствует людей по имени, и мы хотим проверить, что имя, которое мы передаём в функцию, появляется в выводе:
Имя файла: src/lib.rs
pub fn greeting(name: &str) -> String {
format!("Hello {name}!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(result.contains("Carol"));
}
}Требования к этой программе ещё не согласованы, и мы
вполне уверены, что текст Hello в начале приветствия изменится. Мы
решили, что не хотим обновлять тест при изменении требований,
поэтому вместо проверки на точное равенство значению, возвращаемому
функцией greeting, мы просто утверждаем, что вывод содержит текст
входного параметра.
Теперь давайте внесём ошибку в этот код, изменив greeting так, чтобы она исключала
name, и посмотрим, как выглядит стандартное сообщение о неудаче теста:
pub fn greeting(name: &str) -> String {
String::from("Hello!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(result.contains("Carol"));
}
}Выполнение этого теста выдаёт следующее:
$ cargo test
Compiling greeter v0.1.0 (file:///projects/greeter)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.91s
Running unittests src/lib.rs (target/debug/deps/greeter-170b942eb5bf5e3a)
running 1 test
test tests::greeting_contains_name ... FAILED
failures:
---- tests::greeting_contains_name stdout ----
thread 'tests::greeting_contains_name' (6021143) panicked at src/lib.rs:12:9:
assertion failed: result.contains("Carol")
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::greeting_contains_name
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Этот результат просто указывает, что утверждение не выполнено и на какой строке
находится утверждение. Более полезное сообщение о неудаче вывело бы значение из
функции greeting. Давайте добавим пользовательское сообщение о неудаче, состоящее из строки
формата с заполнителем, в который подставлено фактическое значение, полученное нами от
функции greeting:
pub fn greeting(name: &str) -> String {
String::from("Hello!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(
result.contains("Carol"),
"Greeting did not contain name, value was `{result}`"
);
}
}Теперь, когда мы запускаем тест, мы получим более информативное сообщение об ошибке:
$ cargo test
Compiling greeter v0.1.0 (file:///projects/greeter)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.93s
Running unittests src/lib.rs (target/debug/deps/greeter-170b942eb5bf5e3a)
running 1 test
test tests::greeting_contains_name ... FAILED
failures:
---- tests::greeting_contains_name stdout ----
thread 'tests::greeting_contains_name' (6021333) panicked at src/lib.rs:12:9:
Greeting did not contain name, value was `Hello!`
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::greeting_contains_name
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Мы можем видеть значение, которое фактически получили в выводе теста, что помогло бы нам отладить то, что произошло, вместо того, что мы ожидали.
Проверка паник с помощью should_panic
Помимо проверки возвращаемых значений, важно проверять, что наш код
обрабатывает ошибочные условия так, как мы ожидаем. Например, рассмотрим тип Guess,
который мы создали в главе 9, листинге 9-13. Другой код, использующий Guess,
полагается на гарантию, что экземпляры Guess будут содержать только значения
от 1 до 100. Мы можем написать тест, который проверяет, что попытка создать
экземпляр Guess со значением за пределами этого диапазона вызывает панику.
Мы делаем это, добавляя атрибут should_panic к нашей тестовой функции. Тест
проходит, если код внутри функции паникует; тест терпит неудачу, если код
внутри функции не паникует.
Листинг 11-8 показывает тест, который проверяет, что ошибочные условия Guess::new
происходят, когда мы их ожидаем.
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 || value > 100 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic]
fn greater_than_100() {
Guess::new(200);
}
}panic!Мы помещаем атрибут #[should_panic] после атрибута #[test] и
перед тестовой функцией, к которой он применяется. Давайте посмотрим на результат, когда этот тест
проходит:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests guessing_game
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Выглядит хорошо! Теперь давайте внесём ошибку в наш код, удалив условие,
при котором функция new будет паниковать, если значение больше 100:
pub struct Guess {
value: i32,
}
// --snip--
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic]
fn greater_than_100() {
Guess::new(200);
}
}Когда мы запускаем тест из листинга 11-8, он терпит неудачу:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.62s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... FAILED
failures:
---- tests::greater_than_100 stdout ----
note: test did not panic as expected at src/lib.rs:21:8
failures:
tests::greater_than_100
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
В этом случае мы не получаем очень полезного сообщения, но когда мы смотрим на тестовую
функцию, мы видим, что она аннотирована #[should_panic]. Неудача, которую мы получили,
означает, что код в тестовой функции не вызвал панику.
Тесты, использующие should_panic, могут быть неточными. Тест с should_panic
пройдёт, даже если тест паникует по причине, отличной от той, которую мы
ожидали. Чтобы сделать тесты should_panic более точными, мы можем добавить необязательный
параметр expected в атрибут should_panic. Средство запуска тестов
удостоверится, что сообщение о неудаче содержит указанный текст. Например,
рассмотрим изменённый код для Guess в листинге 11-9, где функция new
паникует с разными сообщениями в зависимости от того, слишком мало или
слишком велико значение.
pub struct Guess {
value: i32,
}
// --snip--
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!(
"Guess value must be greater than or equal to 1, got {value}."
);
} else if value > 100 {
panic!(
"Guess value must be less than or equal to 100, got {value}."
);
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic(expected = "less than or equal to 100")]
fn greater_than_100() {
Guess::new(200);
}
}panic! с сообщением о панике, содержащим указанную подстрокуЭтот тест пройдёт, потому что значение, которое мы поместили в параметр expected атрибута
should_panic, является подстрокой сообщения, с которым паникует
функция Guess::new. Мы могли бы указать всё сообщение о панике, которое
ожидаем, что в данном случае было бы Guess value must be less than or equal to 100, got 200. Что выбрать для указания, зависит от того, насколько
сообщение о панике уникально или динамично и насколько точным вы хотите сделать свой тест. В этом
случае подстроки сообщения о панике достаточно, чтобы гарантировать, что код в
тестовой функции выполняет случай else if value > 100.
Чтобы увидеть, что происходит, когда тест should_panic с сообщением expected
терпит неудачу, давайте снова внесём ошибку в наш код, поменяв местами тела
блоков if value < 1 и else if value > 100:
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!(
"Guess value must be less than or equal to 100, got {value}."
);
} else if value > 100 {
panic!(
"Guess value must be greater than or equal to 1, got {value}."
);
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic(expected = "less than or equal to 100")]
fn greater_than_100() {
Guess::new(200);
}
}На этот раз, когда мы запускаем тест should_panic, он терпит неудачу:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... FAILED
failures:
---- tests::greater_than_100 stdout ----
thread 'tests::greater_than_100' (6021675) panicked at src/lib.rs:12:13:
Guess value must be greater than or equal to 1, got 200.
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
note: panic did not contain expected string
panic message: "Guess value must be greater than or equal to 1, got 200."
expected substring: "less than or equal to 100"
failures:
tests::greater_than_100
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Сообщение о неудаче указывает, что этот тест действительно запаниковал, как мы и ожидали,
но сообщение о панике не содержало ожидаемой строки less than or equal to 100. Сообщение о панике, которое мы получили в этом случае, было Guess value must be greater than or equal to 1, got 200. Теперь мы можем начать выяснять, где
наша ошибка!
Использование Result<T, E> в тестах
Все наши тесты до сих пор паниковали, когда терпели неудачу. Мы также можем писать тесты, которые используют
Result<T, E>! Вот тест из листинга 11-1, переписанный с использованием Result<T, E> и возвращающий Err вместо паники:
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() -> Result<(), String> {
let result = add(2, 2);
if result == 4 {
Ok(())
} else {
Err(String::from("two plus two does not equal four"))
}
}
}Функция it_works теперь имеет возвращаемый тип Result<(), String>. В
теле функции вместо вызова макроса assert_eq! мы возвращаем
Ok(()), когда тест проходит, и Err с String внутри, когда тест
терпит неудачу.
Написание тестов так, чтобы они возвращали Result<T, E>, позволяет использовать
оператор вопросительного знака в теле тестов, что может быть удобным способом
написания тестов, которые должны терпеть неудачу, если какая-либо операция внутри них возвращает вариант Err.
Вы не можете использовать аннотацию #[should_panic] в тестах, использующих Result<T, E>. Чтобы утверждать, что операция возвращает вариант Err, не используйте
оператор вопросительного знака для значения Result<T, E>. Вместо этого используйте
assert!(value.is_err()).
Теперь, когда вы знаете несколько способов написания тестов, давайте посмотрим, что происходит,
когда мы запускаем наши тесты, и исследуем различные параметры, которые можно использовать с cargo test.
Управление запуском тестов
Управление запуском тестов
Точно так же, как cargo run компилирует ваш код и затем запускает полученный бинарный файл,
cargo test компилирует ваш код в тестовом режиме и запускает полученный тестовый
бинарный файл. Поведение по умолчанию бинарного файла, созданного cargo test, — запускать
все тесты параллельно и захватывать вывод, сгенерированный во время выполнения тестов,
предотвращая отображение вывода и упрощая чтение
вывода, связанного с результатами тестов. Однако вы можете указать параметры командной строки, чтобы изменить это поведение по умолчанию.
Некоторые параметры командной строки передаются в cargo test, а некоторые — в полученный тестовый
бинарный файл. Чтобы разделить эти два типа аргументов, вы перечисляете аргументы, которые
передаются в cargo test, за которыми следует разделитель --, а затем те, которые передаются в
тестовый бинарный файл. Запуск cargo test --help отображает параметры, которые вы можете использовать
с cargo test, а запуск cargo test -- --help отображает параметры, которые вы
можете использовать после разделителя. Эти параметры также документированы в разделе «Тесты»
книги rustc.
Запуск тестов параллельно или последовательно
Когда вы запускаете несколько тестов, по умолчанию они выполняются параллельно с использованием потоков, что означает, что они завершаются быстрее, и вы получаете обратную связь раньше. Поскольку тесты выполняются одновременно, вы должны убедиться, что ваши тесты не зависят друг от друга или от какого-либо общего состояния, включая общую среду, такую как текущий рабочий каталог или переменные окружения.
Например, предположим, что каждый из ваших тестов выполняет некоторый код, который создаёт файл на диске с именем test-output.txt и записывает некоторые данные в этот файл. Затем каждый тест читает данные в этом файле и утверждает, что файл содержит определённое значение, которое отличается в каждом тесте. Поскольку тесты выполняются одновременно, один тест может перезаписать файл в промежутке между записью и чтением файла другим тестом. Второй тест затем завершится неудачей не потому, что код неверен, а потому что тесты помешали друг другу во время параллельного выполнения. Одно из решений — убедиться, что каждый тест записывает в разный файл; другое решение — запускать тесты по одному.
Если вы не хотите запускать тесты параллельно или хотите более тонкий
контроль над количеством используемых потоков, вы можете передать флаг --test-threads
и количество потоков, которые вы хотите использовать, тестовому бинарному файлу. Взгляните на
следующий пример:
$ cargo test -- --test-threads=1
Мы установили количество тестовых потоков в 1, сказав программе не использовать
параллелизм. Запуск тестов с использованием одного потока займёт больше времени, чем запуск
их параллельно, но тесты не будут мешать друг другу, если они разделяют
состояние.
Отображение вывода функций
По умолчанию, если тест проходит, тестовая библиотека Rust захватывает всё, что печатается в
стандартный вывод. Например, если мы вызываем println! в тесте и тест
проходит, мы не увидим вывод println! в терминале; мы увидим только
строку, указывающую, что тест прошёл. Если тест не проходит, мы увидим всё, что было
напечатано в стандартный вывод, вместе с остальным сообщением о сбое.
В качестве примера, листинг 11-10 содержит глупую функцию, которая печатает значение своего параметра и возвращает 10, а также тест, который проходит, и тест, который не проходит.
fn prints_and_returns_10(a: i32) -> i32 {
println!("I got the value {a}");
10
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn this_test_will_pass() {
let value = prints_and_returns_10(4);
assert_eq!(value, 10);
}
#[test]
fn this_test_will_fail() {
let value = prints_and_returns_10(8);
assert_eq!(value, 5);
}
}println!Когда мы запускаем эти тесты с помощью cargo test, мы увидим следующий вывод:
$ cargo test
Compiling silly-function v0.1.0 (file:///projects/silly-function)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/silly_function-160869f38cff9166)
running 2 tests
test tests::this_test_will_fail ... FAILED
test tests::this_test_will_pass ... ok
failures:
---- tests::this_test_will_fail stdout ----
I got the value 8
thread 'tests::this_test_will_fail' (6019863) panicked at src/lib.rs:19:9:
assertion `left == right` failed
left: 10
right: 5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::this_test_will_fail
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Обратите внимание, что нигде в этом выводе мы не видим I got the value 4, которая
печатается, когда выполняется проходящий тест. Этот вывод был захвачен.
Вывод из теста, который не прошёл, I got the value 8, появляется в разделе
сводки тестов, который также показывает причину сбоя теста.
Если мы хотим видеть напечатанные значения также для проходящих тестов, мы можем сказать Rust
также показывать вывод успешных тестов с помощью --show-output:
$ cargo test -- --show-output
Когда мы запускаем тесты в листинге 11-10 снова с флагом --show-output, мы
видим следующий вывод:
$ cargo test -- --show-output
Compiling silly-function v0.1.0 (file:///projects/silly-function)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.60s
Running unittests src/lib.rs (target/debug/deps/silly_function-160869f38cff9166)
running 2 tests
test tests::this_test_will_fail ... FAILED
test tests::this_test_will_pass ... ok
successes:
---- tests::this_test_will_pass stdout ----
I got the value 4
successes:
tests::this_test_will_pass
failures:
---- tests::this_test_will_fail stdout ----
I got the value 8
thread 'tests::this_test_will_fail' (6022313) panicked at src/lib.rs:19:9:
assertion `left == right` failed
left: 10
right: 5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::this_test_will_fail
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Запуск подмножества тестов по имени
Запуск полного набора тестов иногда может занимать много времени. Если вы работаете над
кодом в определённой области, вы можете захотеть запустить только тесты, относящиеся к
этому коду. Вы можете выбрать, какие тесты запускать, передав cargo test имя
или имена тестов, которые вы хотите запустить, в качестве аргумента.
Чтобы продемонстрировать, как запустить подмножество тестов, мы сначала создадим три теста для
нашей функции add_two, как показано в листинге 11-11, и выберем, какие из них запускать.
pub fn add_two(a: u64) -> u64 {
a + 2
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn add_two_and_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
#[test]
fn add_three_and_two() {
let result = add_two(3);
assert_eq!(result, 5);
}
#[test]
fn one_hundred() {
let result = add_two(100);
assert_eq!(result, 102);
}
}Если мы запустим тесты без передачи каких-либо аргументов, как мы видели ранее, все тесты будут выполняться параллельно:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.62s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 3 tests
test tests::add_three_and_two ... ok
test tests::add_two_and_two ... ok
test tests::one_hundred ... ok
test result: ok. 3 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Запуск отдельных тестов
Мы можем передать имя любой тестовой функции в cargo test, чтобы запустить только этот тест:
$ cargo test one_hundred
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.69s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::one_hundred ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 2 filtered out; finished in 0.00s
Запустился только тест с именем one_hundred; два других теста не совпали с этим именем. Вывод теста сообщает нам, что у нас было больше тестов, которые не запускались,
отображая 2 filtered out в конце.
Мы не можем указать имена нескольких тестов таким образом; будет использоваться только первое значение,
переданное в cargo test. Но есть способ запустить несколько тестов.
Фильтрация для запуска нескольких тестов
Мы можем указать часть имени теста, и любой тест, чьё имя совпадает с этим значением,
будет запущен. Например, поскольку два из наших тестов содержат add в именах, мы можем
запустить их, выполнив cargo test add:
$ cargo test add
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::add_three_and_two ... ok
test tests::add_two_and_two ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 1 filtered out; finished in 0.00s
Эта команда запустила все тесты с add в имени и отфильтровала тест
с именем one_hundred. Также обратите внимание, что модуль, в котором появляется тест, становится
частью имени теста, поэтому мы можем запустить все тесты в модуле, фильтруя
по имени модуля.
Игнорирование тестов, если они не запрошены специально
Иногда некоторые конкретные тесты могут быть очень трудоёмкими для выполнения, поэтому вы
можете захотеть исключить их из большинства запусков cargo test. Вместо
перечисления в качестве аргументов всех тестов, которые вы хотите запустить, вы можете вместо этого аннотировать
трудоёмкие тесты с помощью атрибута ignore, чтобы исключить их, как показано
здесь:
Имя файла: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
#[test]
#[ignore]
fn expensive_test() {
// код, выполнение которого занимает час
}
}После #[test] мы добавляем строку #[ignore] к тесту, который хотим исключить.
Теперь, когда мы запускаем наши тесты, it_works выполняется, но expensive_test — нет:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.60s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::expensive_test ... ignored
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 1 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Функция expensive_test указана как ignored. Если мы хотим запустить только
игнорируемые тесты, мы можем использовать cargo test -- --ignored:
$ cargo test -- --ignored
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::expensive_test ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 1 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Управляя тем, какие тесты запускать, вы можете убедиться, что результаты cargo test
возвращаются быстро. Когда вы находитесь в точке, где имеет смысл проверить
результаты ignored-тестов и у вас есть время ждать результатов,
вы можете запустить cargo test -- --ignored вместо этого. Если вы хотите запустить все тесты,
независимо от того, игнорируются они или нет, вы можете запустить cargo test -- --include-ignored.
Организация тестов
Организация тестов
Как упоминалось в начале главы, тестирование — это сложная дисциплина, и разные люди используют разные терминологию и организацию. Сообщество Rust рассматривает тесты в терминах двух основных категорий: модульные тесты и интеграционные тесты. Модульные тесты небольшие и более сфокусированные, тестируют один модуль в изоляции за раз и могут тестировать приватные интерфейсы. Интеграционные тесты полностью внешние по отношению к вашей библиотеке и используют ваш код так же, как это делал бы любой другой внешний код, используя только публичный интерфейс и потенциально задействуя несколько модулей за один тест.
Написание обоих видов тестов важно для того, чтобы убедиться, что части вашей библиотеки делают то, что вы от них ожидаете, как по отдельности, так и вместе.
Модульные тесты
Цель модульных тестов — тестировать каждую единицу кода в изоляции от остального кода, чтобы быстро определить, где код работает, а где нет, как ожидалось. Вы будете размещать модульные тесты в каталоге src в каждом файле с кодом, который они тестируют. Соглашение состоит в том, чтобы создать модуль с именем tests в каждом файле, содержащий тестовые функции, и аннотировать модуль атрибутом cfg(test).
Модуль tests и атрибут #[cfg(test)]
Аннотация #[cfg(test)] на модуле tests говорит Rust компилировать и запускать тестовый код только при запуске cargo test, а не при запуске cargo build. Это экономит время компиляции, когда вы хотите только собрать библиотеку, и экономит место в результирующем скомпилированном артефакте, потому что тесты не включаются. Вы увидите, что поскольку интеграционные тесты находятся в другом каталоге, им не нужна аннотация #[cfg(test)]. Однако, поскольку модульные тесты находятся в тех же файлах, что и код, вы будете использовать #[cfg(test)], чтобы указать, что они не должны включаться в скомпилированный результат.
Вспомните, что когда мы создали новый проект adder в первом разделе этой главы, Cargo сгенерировал для нас этот код:
Имя файла: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}В автоматически сгенерированном модуле tests атрибут cfg означает конфигурация и говорит Rust, что следующий элемент должен быть включён только при определённой опции конфигурации. В этом случае опция конфигурации — это test, которая предоставляется Rust для компиляции и запуска тестов. Используя атрибут cfg, Cargo компилирует наш тестовый код только если мы активно запускаем тесты с помощью cargo test. Это включает любые вспомогательные функции, которые могут быть в этом модуле, в дополнение к функциям, аннотированным #[test].
Тестирование приватных функций
В сообществе тестировщиков ведутся дебаты о том, следует ли тестировать приватные функции напрямую, и в других языках сделать это сложно или невозможно. Независимо от того, какой идеологии тестирования вы придерживаетесь, правила приватности Rust позволяют тестировать приватные функции. Рассмотрим код в листинге 11-12 с приватной функцией internal_adder.
pub fn add_two(a: u64) -> u64 {
internal_adder(a, 2)
}
fn internal_adder(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn internal() {
let result = internal_adder(2, 2);
assert_eq!(result, 4);
}
}Обратите внимание, что функция internal_adder не помечена как pub. Тесты — это просто код на Rust, а модуль tests — это просто ещё один модуль. Как мы обсуждали в разделе «Пути для ссылки на элемент в дереве модулей», элементы в дочерних модулях могут использовать элементы в своих родительских модулях. В этом тесте мы вводим в область видимости все элементы, принадлежащие родительскому модулю модуля tests, с помощью use super::*, и затем тест может вызвать internal_adder. Если вы не считаете, что приватные функции следует тестировать, ничто в Rust не заставит вас это делать.
Интеграционные тесты
В Rust интеграционные тесты полностью внешние по отношению к вашей библиотеке. Они используют вашу библиотеку так же, как это делал бы любой другой код, что означает, что они могут вызывать только функции, которые являются частью публичного API вашей библиотеки. Их цель — проверить, работают ли многие части вашей библиотеки вместе правильно. Единицы кода, которые работают правильно сами по себе, могут иметь проблемы при интеграции, поэтому покрытие тестами интегрированного кода также важно. Чтобы создать интеграционные тесты, вам сначала нужен каталог tests.
Каталог tests
Мы создаём каталог tests на верхнем уровне каталога нашего проекта, рядом с src. Cargo знает, что нужно искать файлы интеграционных тестов в этом каталоге. Затем мы можем создать столько тестовых файлов, сколько захотим, и Cargo скомпилирует каждый из файлов как отдельный крейт.
Давайте создадим интеграционный тест. С кодом из листинга 11-12 всё ещё в файле src/lib.rs, создайте каталог tests и создайте новый файл с именем tests/integration_test.rs. Структура вашего каталога должна выглядеть так:
adder
├── Cargo.lock
├── Cargo.toml
├── src
│ └── lib.rs
└── tests
└── integration_test.rs
Введите код из листинга 11-13 в файл tests/integration_test.rs.
use adder::add_two;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}adderКаждый файл в каталоге tests — это отдельный крейт, поэтому нам нужно ввести нашу библиотеку в область видимости каждого тестового крейта. По этой причине мы добавляем use adder::add_two; в начало кода, что не требовалось в модульных тестах.
Нам не нужно аннотировать какой-либо код в tests/integration_test.rs атрибутом #[cfg(test)]. Cargo обрабатывает каталог tests особым образом и компилирует файлы в этом каталоге только при запуске cargo test. Запустите cargo test сейчас:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.31s
Running unittests src/lib.rs (target/debug/deps/adder-1082c4b063a8fbe6)
running 1 test
test tests::internal ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/integration_test.rs (target/debug/deps/integration_test-1082c4b063a8fbe6)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Три раздела вывода включают модульные тесты, интеграционный тест и doc-тесты. Обратите внимание, что если какой-либо тест в разделе завершится неудачно, последующие разделы не будут запущены. Например, если модульный тест завершится неудачно, не будет никакого вывода для интеграционных тестов и doc-тестов, потому что эти тесты запускаются только если все модульные тесты проходят.
Первый раздел для модульных тестов такой же, как мы видели: одна строка для каждого модульного теста (один с именем internal, который мы добавили в листинге 11-12), а затем итоговая строка для модульных тестов.
Раздел интеграционных тестов начинается со строки Running tests/integration_test.rs. Затем идёт строка для каждой тестовой функции в этом интеграционном тесте и итоговая строка для результатов интеграционного теста прямо перед началом раздела Doc-tests adder.
Каждый файл интеграционных тестов имеет свой собственный раздел, поэтому если мы добавим больше файлов в каталог tests, будет больше разделов интеграционных тестов.
Мы всё ещё можем запустить конкретную функцию интеграционного теста, указав имя тестовой функции в качестве аргумента для cargo test. Чтобы запустить все тесты в определённом файле интеграционных тестов, используйте аргумент --test для cargo test, за которым следует имя файла:
$ cargo test --test integration_test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.64s
Running tests/integration_test.rs (target/debug/deps/integration_test-82e7799c1bc62298)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Эта команда запускает только тесты в файле tests/integration_test.rs.
Подмодули в интеграционных тестах
По мере добавления всё большего числа интеграционных тестов вы можете захотеть создать больше файлов в каталоге tests, чтобы помочь их организовать; например, вы можете сгруппировать тестовые функции по функциональности, которую они тестируют. Как упоминалось ранее, каждый файл в каталоге tests компилируется как отдельный крейт, что полезно для создания отдельных областей видимости, чтобы более точно имитировать то, как конечные пользователи будут использовать ваш крейт. Однако это означает, что файлы в каталоге tests не ведут себя так же, как файлы в src, как вы узнали в главе 7 относительно того, как разделять код на модули и файлы.
Различие в поведении файлов в каталоге tests наиболее заметно, когда у вас есть набор вспомогательных функций для использования в нескольких файлах интеграционных тестов, и вы пытаетесь выполнить шаги из раздела «Разделение модулей на разные файлы» главы 7, чтобы извлечь их в общий модуль. Например, если мы создадим tests/common.rs и поместим в него функцию с именем setup, мы можем добавить некоторый код в setup, который мы хотим вызывать из нескольких тестовых функций в нескольких тестовых файлах:
Имя файла: tests/common.rs
pub fn setup() {
// код настройки, специфичный для тестов вашей библиотеки, будет здесь
}Когда мы снова запустим тесты, мы увидим новый раздел в выводе тестов для файла common.rs, хотя этот файл не содержит тестовых функций и мы ниоткуда не вызывали функцию setup:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.89s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::internal ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/common.rs (target/debug/deps/common-92948b65e88960b4)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/integration_test.rs (target/debug/deps/integration_test-92948b65e88960b4)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Наличие common в результатах тестов с отображением running 0 tests для него — это не то, что мы хотели. Мы просто хотели поделиться некоторым кодом с другими файлами интеграционных тестов. Чтобы избежать появления common в выводе тестов, вместо создания tests/common.rs мы создадим tests/common/mod.rs. Каталог проекта теперь выглядит так:
├── Cargo.lock
├── Cargo.toml
├── src
│ └── lib.rs
└── tests
├── common
│ └── mod.rs
└── integration_test.rs
Это более старый стиль именования файлов, который Rust также понимает, о котором мы упоминали в разделе «Альтернативные пути к файлам» главы 7. Называя файл таким образом, вы говорите Rust не обрабатывать модуль common как файл интеграционного теста. Когда мы перемещаем код функции setup в tests/common/mod.rs и удаляем файл tests/common.rs, раздел в выводе тестов больше не будет появляться. Файлы в подкаталогах каталога tests не компилируются как отдельные крейты и не имеют разделов в выводе тестов.
После того как мы создали tests/common/mod.rs, мы можем использовать его из любого из файлов интеграционных тестов как модуль. Вот пример вызова функции setup из теста it_adds_two в tests/integration_test.rs:
Имя файла: tests/integration_test.rs
use adder::add_two;
mod common;
#[test]
fn it_adds_two() {
common::setup();
let result = add_two(2);
assert_eq!(result, 4);
}Обратите внимание, что объявление mod common; такое же, как объявление модуля, которое мы демонстрировали в листинге 7-21. Затем в тестовой функции мы можем вызвать функцию common::setup().
Интеграционные тесты для бинарных крейтов
Если наш проект — это бинарный крейт, который содержит только файл src/main.rs и не имеет файла src/lib.rs, мы не можем создавать интеграционные тесты в каталоге tests и вводить функции, определённые в файле src/main.rs, в область видимости с помощью оператора use. Только библиотечные крейты предоставляют функции, которые могут использовать другие крейты; бинарные крейты предназначены для запуска сами по себе.
Это одна из причин, по которой проекты на Rust, предоставляющие бинарный файл, имеют простой файл src/main.rs, который вызывает логику, находящуюся в файле src/lib.rs. Используя такую структуру, интеграционные тесты могут тестировать библиотечный крейт с помощью use, чтобы сделать важную функциональность доступной. Если важная функциональность работает, небольшой объём кода в файле src/main.rs также будет работать, и этот небольшой объём кода не нужно тестировать.
Итоги
Возможности тестирования Rust предоставляют способ указать, как должен работать код, чтобы гарантировать, что он продолжает работать так, как вы ожидаете, даже когда вы вносите изменения. Модульные тесты проверяют различные части библиотеки по отдельности и могут тестировать детали приватной реализации. Интеграционные тесты проверяют, что многие части библиотеки работают вместе правильно, и используют публичный API библиотеки для тестирования кода так же, как его будет использовать внешний код. Даже несмотря на то, что система типов и правила владения Rust помогают предотвратить некоторые виды ошибок, тесты всё ещё важны для уменьшения логических ошибок, связанных с тем, как, как ожидается, должен вести себя ваш код.
Давайте объединим знания, которые вы изучили в этой главе и в предыдущих главах, чтобы поработать над проектом!
Проект ввода-вывода: создание программы командной строки
Проект ввода-вывода: создание программы командной строки
Эта глава — повторение многих навыков, которые вы изучили до сих пор, и исследование нескольких дополнительных возможностей стандартной библиотеки. Мы создадим инструмент командной строки, который взаимодействует с файлами и вводом-выводом командной строки, чтобы попрактиковаться в некоторых концепциях Rust, которые теперь у вас есть.
Скорость, безопасность, единый бинарный вывод и кроссплатформенная поддержка Rust делают его
идеальным языком для создания инструментов командной строки, поэтому для нашего проекта мы
сделаем свою версию классического инструмента поиска в командной строке grep
(globally search a regular expression and print). В
простейшем случае использования grep ищет в указанном файле указанную строку. Для
этого grep принимает в качестве аргументов путь к файлу и строку. Затем он читает
файл, находит строки в этом файле, содержащие строковый аргумент, и печатает
эти строки.
Попутно мы покажем, как заставить наш инструмент командной строки использовать функции терминала,
которые используют многие другие инструменты командной строки. Мы прочитаем значение
переменной окружения, чтобы позволить пользователю настроить поведение нашего инструмента.
Мы также будем печатать сообщения об ошибках в консольный поток стандартных ошибок (stderr)
вместо стандартного вывода (stdout), чтобы, например, пользователь мог
перенаправить успешный вывод в файл, продолжая видеть сообщения об ошибках на экране.
Один член сообщества Rust, Эндрю Галлант, уже создал полнофункциональную,
очень быструю версию grep под названием ripgrep. По сравнению с ней наша
версия будет довольно простой, но эта глава даст вам некоторые
фоновые знания, необходимые для понимания реального проекта, такого как
ripgrep.
Наш проект grep объединит ряд концепций, которые вы уже изучили:
- Организация кода (глава 7)
- Использование векторов и строк (глава 8)
- Обработка ошибок (глава 9)
- Использование трейтов и времён жизни, где это уместно (глава 10)
- Написание тестов (глава 11)
Мы также кратко представим замыкания, итераторы и трейт-объекты, которые глава 13 и глава 18 рассмотрят подробно.
Приём аргументов командной строки
Приём аргументов командной строки
Давайте создадим новый проект, как всегда, с помощью cargo new. Мы назовём наш проект minigrep, чтобы отличать его от инструмента grep, который, возможно, уже есть в вашей системе:
$ cargo new minigrep
Created binary (application) `minigrep` project
$ cd minigrep
Первая задача — заставить minigrep принимать два аргумента командной строки: путь к файлу и строку для поиска. То есть мы хотим иметь возможность запускать нашу программу с помощью cargo run, двух дефисов, чтобы указать, что следующие аргументы предназначены для нашей программы, а не для cargo, строки для поиска и пути к файлу для поиска, вот так:
$ cargo run -- searchstring example-filename.txt
Прямо сейчас программа, сгенерированная cargo new, не может обрабатывать аргументы, которые мы ей передаём. Некоторые существующие библиотеки на crates.io могут помочь с написанием программы, принимающей аргументы командной строки, но поскольку вы только изучаете эту концепцию, давайте реализуем эту возможность сами.
Чтение значений аргументов
Чтобы minigrep мог читать значения аргументов командной строки, которые мы ему передаём, нам понадобится функция std::env::args, предоставляемая стандартной библиотекой Rust. Эта функция возвращает итератор по аргументам командной строки, переданным в minigrep. Мы полностью рассмотрим итераторы в главе 13. Пока вам нужно знать только две детали об итераторах: итераторы производят серию значений, и мы можем вызвать метод collect для итератора, чтобы превратить его в коллекцию, такую как вектор, которая содержит все элементы, производимые итератором.
Код в листинге 12-1 позволяет вашей программе minigrep читать любые аргументы командной строки, переданные ей, а затем собирать значения в вектор.
use std::env;
fn main() {
let args: Vec<String> = env::args().collect();
dbg!(args);
}Сначала мы вводим модуль std::env в область видимости с помощью инструкции use, чтобы мы могли использовать его функцию args. Обратите внимание, что функция std::env::args вложена на два уровня модулей. Как мы обсуждали в главе 7, в случаях, когда нужная функция вложена более чем в один модуль, мы решили ввести в область видимости родительский модуль, а не саму функцию. Поступая так, мы можем легко использовать другие функции из std::env. Это также менее двусмысленно, чем добавление use std::env::args и последующий вызов функции просто как args, потому что args легко можно принять за функцию, определённую в текущем модуле.
Функция args и недопустимый Unicode
Обратите внимание, что std::env::args вызовет панику, если какой-либо аргумент содержит недопустимый Unicode. Если вашей программе нужно принимать аргументы, содержащие недопустимый Unicode, используйте вместо этого std::env::args_os. Эта функция возвращает итератор, который производит значения OsString вместо значений String. Мы выбрали std::env::args здесь для простоты, потому что значения OsString различаются на разных платформах и сложнее в работе, чем значения String.
В первой строке main мы вызываем env::args и сразу используем collect, чтобы превратить итератор в вектор, содержащий все значения, произведённые итератором. Мы можем использовать функцию collect для создания многих видов коллекций, поэтому мы явно аннотируем тип args, чтобы указать, что нам нужен вектор строк. Хотя вам очень редко нужно аннотировать типы в Rust, collect — это одна из функций, для которых вам часто нужно это делать, потому что Rust не может вывести, какой вид коллекции вы хотите.
Наконец, мы печатаем вектор с помощью макроса отладки. Давайте попробуем запустить код сначала без аргументов, а затем с двумя аргументами:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.61s
Running `target/debug/minigrep`
[src/main.rs:5:5] args = [
"target/debug/minigrep",
]
$ cargo run -- needle haystack
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 1.57s
Running `target/debug/minigrep needle haystack`
[src/main.rs:5:5] args = [
"target/debug/minigrep",
"needle",
"haystack",
]
Обратите внимание, что первое значение в векторе — "target/debug/minigrep", это имя нашего бинарного файла. Это соответствует поведению списка аргументов в C, позволяя программам использовать имя, под которым они были вызваны при выполнении. Часто удобно иметь доступ к имени программы, если вы хотите напечатать его в сообщениях или изменить поведение программы в зависимости от того, какой псевдоним командной строки был использован для вызова программы. Но для целей этой главы мы проигнорируем его и сохраним только два аргумента, которые нам нужны.
Сохранение значений аргументов в переменных
Программа в настоящее время может получать доступ к значениям, указанным в качестве аргументов командной строки. Теперь нам нужно сохранить значения двух аргументов в переменных, чтобы мы могли использовать эти значения на протяжении всей остальной части программы. Мы делаем это в листинге 12-2.
use std::env;
fn main() {
let args: Vec<String> = env::args().collect();
let query = &args[1];
let file_path = &args[2];
println!("Searching for {query}");
println!("In file {file_path}");
}Как мы видели при печати вектора, имя программы занимает первое значение в векторе по индексу args[0], поэтому мы начинаем аргументы с индекса 1. Первый аргумент, который принимает minigrep, — это строка, которую мы ищем, поэтому мы помещаем ссылку на первый аргумент в переменную query. Второй аргумент будет путём к файлу, поэтому мы помещаем ссылку на второй аргумент в переменную file_path.
Мы временно печатаем значения этих переменных, чтобы доказать, что код работает так, как мы задумали. Давайте снова запустим эту программу с аргументами test и sample.txt:
$ cargo run -- test sample.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep test sample.txt`
Searching for test
In file sample.txt
Отлично, программа работает! Значения нужных нам аргументов сохраняются в правильные переменные. Позже мы добавим некоторую обработку ошибок для работы с некоторыми возможными ошибочными ситуациями, например, когда пользователь не предоставляет аргументы; пока мы проигнорируем эту ситуацию и вместо этого займёмся добавлением возможностей чтения файлов.
Чтение файла
Чтение файла
Теперь мы добавим функциональность для чтения файла, указанного в аргументе file_path.
Сначала нам нужен образец файла для тестирования: мы будем использовать файл с
небольшим количеством текста в несколько строк с некоторыми повторяющимися словами. В листинге 12-3
есть стихотворение Эмили Дикинсон, которое хорошо подойдёт! Создайте файл с именем
poem.txt в корне вашего проекта и введите стихотворение «I'm Nobody!
Who are you?»
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
Разместив текст, отредактируйте src/main.rs и добавьте код для чтения файла, как показано в листинге 12-4.
use std::env;
use std::fs;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let query = &args[1];
let file_path = &args[2];
println!("Searching for {query}");
println!("In file {file_path}");
let contents = fs::read_to_string(file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}Сначала мы подключаем соответствующую часть стандартной библиотеки с помощью оператора use:
нам нужен std::fs для работы с файлами.
В main новый оператор fs::read_to_string принимает file_path, открывает
этот файл и возвращает значение типа std::io::Result<String>, которое содержит
содержимое файла.
После этого мы снова добавляем временный оператор println!, который печатает значение
contents после чтения файла, чтобы мы могли проверить, что программа работает
на данный момент.
Давайте запустим этот код с любой строкой в качестве первого аргумента командной строки (поскольку мы ещё не реализовали часть поиска) и файлом poem.txt в качестве второго аргумента:
$ cargo run -- the poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep the poem.txt`
Searching for the
In file poem.txt
With text:
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
Отлично! Код прочитал и затем напечатал содержимое файла. Но в коде
есть несколько недостатков. На данный момент функция main имеет несколько
обязанностей: как правило, функции яснее и проще в поддержке, если
каждая функция отвечает только за одну идею. Другая проблема в том, что мы
не обрабатываем ошибки так хорошо, как могли бы. Программа всё ещё мала, так что эти
недостатки не являются большой проблемой, но по мере роста программы их будет сложнее исправить
чисто. Хорошая практика — начать рефакторинг на раннем этапе
разработки программы, потому что гораздо проще рефакторить меньшие объёмы
кода. Мы сделаем это далее.
Рефакторинг для улучшения модульности и обработки ошибок
Рефакторинг для улучшения модульности и обработки ошибок
Чтобы улучшить нашу программу, мы исправим четыре проблемы, связанные со структурой программы и тем, как она обрабатывает потенциальные ошибки. Во-первых, наша функция main теперь выполняет две задачи: она разбирает аргументы и читает файлы. По мере роста программы количество отдельных задач, которые обрабатывает функция main, будет увеличиваться. По мере того как функция приобретает обязанности, становится всё труднее рассуждать о ней, труднее тестировать и труднее изменять, не сломав какую-либо из её частей. Лучше разделить функциональность так, чтобы каждая функция отвечала за одну задачу.
Эта проблема также связана со второй проблемой: хотя query и file_path являются конфигурационными переменными для нашей программы, переменные вроде contents используются для выполнения логики программы. Чем длиннее становится main, тем больше переменных нам нужно будет ввести в область видимости; чем больше переменных у нас в области видимости, тем труднее будет отслеживать назначение каждой. Лучше сгруппировать конфигурационные переменные в одну структуру, чтобы сделать их назначение ясным.
Третья проблема заключается в том, что мы использовали expect для печати сообщения об ошибке, когда чтение файла не удаётся, но сообщение об ошибке просто печатает Should have been able to read the file. Чтение файла может завершиться неудачей по ряду причин: например, файл может отсутствовать, или у нас может не быть разрешения на его открытие. Прямо сейчас, независимо от ситуации, мы печатали бы одно и то же сообщение об ошибке для всего, что не дало бы пользователю никакой информации!
В-четвёртых, мы используем expect для обработки ошибки, и если пользователь запускает нашу программу, не указав достаточно аргументов, он получит ошибку index out of bounds от Rust, которая не объясняет проблему чётко. Было бы лучше, если бы весь код обработки ошибок находился в одном месте, чтобы будущим сопровождающим нужно было проконсультироваться только в одном месте, если логику обработки ошибок потребуется изменить. Наличие всего кода обработки ошибок в одном месте также гарантирует, что мы печатаем сообщения, которые будут значимы для наших конечных пользователей.
Давайте решим эти четыре проблемы, проведя рефакторинг нашего проекта.
Разделение обязанностей в бинарных проектах
Организационная проблема распределения ответственности за несколько задач между функцией main характерна для многих бинарных проектов. В результате многие программисты на Rust находят полезным разделить отдельные задачи бинарной программы, когда функция main начинает разрастаться. Этот процесс состоит из следующих шагов:
- Разделите программу на файл main.rs и файл lib.rs и переместите логику программы в lib.rs.
- Пока логика разбора командной строки невелика, она может оставаться в функции
main. - Когда логика разбора командной строки начинает усложняться, извлеките её из функции
mainв другие функции или типы.
Обязанности, которые остаются в функции main после этого процесса, должны быть ограничены следующим:
- Вызов логики разбора командной строки со значениями аргументов
- Настройка любой другой конфигурации
- Вызов функции
runв lib.rs - Обработка ошибки, если
runвозвращает ошибку
Этот шаблон заключается в разделении обязанностей: main.rs отвечает за запуск программы, а lib.rs отвечает за всю логику текущей задачи. Поскольку вы не можете тестировать функцию main напрямую, эта структура позволяет вам тестировать всю логику вашей программы, переместив её из функции main. Код, который остаётся в функции main, будет достаточно мал, чтобы проверить его корректность путём чтения. Давайте переработаем нашу программу, следуя этому процессу.
Извлечение парсера аргументов
Мы извлечём функциональность разбора аргументов в функцию, которую вызовет main. Листинг 12-5 показывает новое начало функции main, которая вызывает новую функцию parse_config, которую мы определим в src/main.rs.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let (query, file_path) = parse_config(&args);
// --snip--
println!("Searching for {query}");
println!("In file {file_path}");
let contents = fs::read_to_string(file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
fn parse_config(args: &[String]) -> (&str, &str) {
let query = &args[1];
let file_path = &args[2];
(query, file_path)
}parse_config из mainМы по-прежнему собираем аргументы командной строки в вектор, но вместо того, чтобы присваивать значение аргумента по индексу 1 переменной query, а значение аргумента по индексу 2 переменной file_path внутри функции main, мы передаём весь вектор функции parse_config. Функция parse_config затем содержит логику, которая определяет, какой аргумент в какую переменную попадает, и передаёт значения обратно в main. Мы по-прежнему создаём переменные query и file_path в main, но main больше не несёт ответственности за определение того, как аргументы командной строки и переменные соответствуют друг другу.
Эта переработка может показаться излишней для нашей небольшой программы, но мы проводим рефакторинг небольшими, постепенными шагами. После внесения этого изменения запустите программу снова, чтобы убедиться, что разбор аргументов по-прежнему работает. Хорошо часто проверять прогресс, чтобы помочь выявить причину проблем, когда они возникают.
Группировка конфигурационных значений
Мы можем сделать ещё один небольшой шаг для дальнейшего улучшения функции parse_config. На данный момент мы возвращаем кортеж, но затем сразу же снова разбиваем этот кортеж на отдельные части. Это признак того, что, возможно, у нас ещё нет правильной абстракции.
Ещё один индикатор, показывающий, что есть место для улучшения, — это часть config в parse_config, которая подразумевает, что два возвращаемых значения связаны и оба являются частью одного конфигурационного значения. Мы в настоящее время не передаём это значение в структуре данных иначе, как только группируя два значения в кортеж; вместо этого мы поместим два значения в одну структуру и дадим каждому из полей структуры осмысленное имя. Это облегчит будущим сопровождающим этого кода понимание того, как различные значения связаны друг с другом и каково их назначение.
Листинг 12-6 показывает улучшения функции parse_config.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = parse_config(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
// --snip--
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
fn parse_config(args: &[String]) -> Config {
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}parse_config для возврата экземпляра структуры ConfigМы добавили структуру с именем Config, определённую с полями query и file_path. Сигнатура parse_config теперь указывает, что она возвращает значение Config. В теле parse_config, где мы раньше возвращали срезы строк, ссылающиеся на значения String в args, мы теперь определяем Config, чтобы он содержал владеющие значения String. Переменная args в main является владельцем значений аргументов и только позволяет функции parse_config заимствовать их, что означает, что мы нарушили бы правила заимствования Rust, если бы Config попытался взять на себя владение значениями в args.
Есть несколько способов, которыми мы могли бы управлять данными String; самый простой, хотя и несколько неэффективный, путь — вызвать метод clone для значений. Это сделает полную копию данных, которой будет владеть экземпляр Config, что занимает больше времени и памяти, чем хранение ссылки на строковые данные. Однако клонирование данных также делает наш код очень простым, потому что нам не нужно управлять временами жизни ссылок; в этих обстоятельствах отказ от небольшой производительности ради простоты — это стоящий компромисс.
Компромиссы использования clone
Среди многих Rustaceans существует тенденция избегать использования clone для решения проблем владения из-за его стоимости во время выполнения. В главе 13 вы узнаете, как использовать более эффективные методы в такой ситуации. Но пока нормально копировать несколько строк, чтобы продолжать двигаться вперёд, потому что вы сделаете эти копии только один раз, и ваш путь к файлу и строка запроса очень малы. Лучше иметь работающую программу, которая немного неэффективна, чем пытаться гипероптимизировать код с первого прохода. По мере того как вы будете приобретать больше опыта с Rust, будет легче начинать с наиболее эффективного решения, но пока вполне приемлемо вызывать clone.
Мы обновили main так, чтобы она помещала экземпляр Config, возвращаемый parse_config, в переменную с именем config, и мы обновили код, который ранее использовал отдельные переменные query и file_path, так что теперь он использует поля структуры Config.
Теперь наш код более ясно передаёт, что query и file_path связаны и что их назначение — настроить, как будет работать программа. Любой код, использующий эти значения, знает, что их нужно искать в экземпляре config в полях, названных в соответствии с их назначением.
Создание конструктора для Config
До сих пор мы извлекли логику, отвечающую за разбор аргументов командной строки, из main и поместили её в функцию parse_config. Это помогло нам увидеть, что значения query и file_path связаны, и эта связь должна быть передана в нашем коде. Затем мы добавили структуру Config, чтобы назвать связанное назначение query и file_path и иметь возможность возвращать имена значений в качестве имён полей структуры из функции parse_config.
Итак, теперь, когда назначение функции parse_config — создать экземпляр Config, мы можем изменить parse_config с обычной функции на функцию с именем new, связанную со структурой Config. Внесение этого изменения сделает код более идиоматичным. Мы можем создавать экземпляры типов в стандартной библиотеке, таких как String, вызывая String::new. Аналогично, изменив parse_config на функцию new, связанную с Config, мы сможем создавать экземпляры Config, вызывая Config::new. Листинг 12-7 показывает изменения, которые нам нужно внести.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
// --snip--
}
// --snip--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn new(args: &[String]) -> Config {
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}
}parse_config на Config::newМы обновили main там, где вызывали parse_config, чтобы вместо этого вызывать Config::new. Мы изменили имя parse_config на new и переместили его внутрь блока impl, который связывает функцию new с Config. Попробуйте снова скомпилировать этот код, чтобы убедиться, что он работает.
Исправление обработки ошибок
Теперь мы займёмся исправлением нашей обработки ошибок. Вспомните, что попытка получить доступ к значениям в векторе args по индексу 1 или индексу 2 вызовет панику программы, если вектор содержит меньше трёх элементов. Попробуйте запустить программу без аргументов; это будет выглядеть так:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep`
thread 'main' (6023615) panicked at src/main.rs:27:21:
index out of bounds: the len is 1 but the index is 1
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Строка index out of bounds: the len is 1 but the index is 1 — это сообщение об ошибке, предназначенное для программистов. Оно не поможет нашим конечным пользователям понять, что им следует делать вместо этого. Давайте исправим это сейчас.
Улучшение сообщения об ошибке
В листинге 12-8 мы добавляем проверку в функцию new, которая проверит, достаточно ли длинный срез перед доступом к индексу 1 и индексу 2. Если срез недостаточно длинный, программа паникует и отображает лучшее сообщение об ошибке.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
// --snip--
fn new(args: &[String]) -> Config {
if args.len() < 3 {
panic!("not enough arguments");
}
// --snip--
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}
}Этот код похож на функцию Guess::new, которую мы написали в листинге 9-13, где мы вызывали panic!, когда аргумент value был вне диапазона допустимых значений. Вместо проверки диапазона значений здесь мы проверяем, что длина args не меньше 3, и остальная часть функции может работать в предположении, что это условие выполнено. Если в args меньше трёх элементов, это условие будет true, и мы вызываем макрос panic!, чтобы немедленно завершить программу.
С этими дополнительными несколькими строками кода в new давайте снова запустим программу без аргументов, чтобы увидеть, как теперь выглядит ошибка:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep`
thread 'main' (6023776) panicked at src/main.rs:26:13:
not enough arguments
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Этот вывод лучше: теперь у нас есть разумное сообщение об ошибке. Однако у нас также есть посторонняя информация, которую мы не хотим давать нашим пользователям. Возможно, техника, которую мы использовали в листинге 9-13, не лучшая для использования здесь: вызов panic! больше подходит для проблемы программирования, чем для проблемы использования, как обсуждалось в главе 9. Вместо этого мы будем использовать другую технику, которую вы узнали в главе 9, — возврат Result, который указывает либо на успех, либо на ошибку.
Возврат Result вместо вызова panic!
Вместо этого мы можем вернуть значение Result, которое будет содержать экземпляр Config в случае успеха и описывать проблему в случае ошибки. Мы также собираемся изменить имя функции с new на build, потому что многие программисты ожидают, что функции new никогда не будут завершаться неудачей. Когда Config::build сообщает main, мы можем использовать тип Result, чтобы сигнализировать о проблеме. Затем мы можем изменить main, чтобы преобразовать вариант Err в более практичную ошибку для наших пользователей без окружающего текста про thread 'main' и RUST_BACKTRACE, который вызывает вызов panic!.
Листинг 12-9 показывает изменения, которые нам нужно внести в возвращаемое значение функции, которую мы теперь называем Config::build, и в тело функции, необходимое для возврата Result. Обратите внимание, что этот код не скомпилируется, пока мы также не обновим main, что мы сделаем в следующем листинге.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}Result из Config::buildНаша функция build возвращает Result с экземпляром Config в случае успеха и строковым литералом в случае ошибки. Наши значения ошибок всегда будут строковыми литералами, имеющими время жизни 'static.
Мы сделали два изменения в теле функции: вместо вызова panic!, когда пользователь не передаёт достаточно аргументов, мы теперь возвращаем значение Err, и мы обернули возвращаемое значение Config в Ok. Эти изменения заставляют функцию соответствовать её новой сигнатуре типа.
Возврат значения Err из Config::build позволяет функции main обработать значение Result, возвращаемое функцией build, и более чисто завершить процесс в случае ошибки.
Вызов Config::build и обработка ошибок
Чтобы обработать случай ошибки и напечатать удобное для пользователя сообщение, нам нужно обновить main, чтобы обработать Result, возвращаемый Config::build, как показано в листинге 12-10. Мы также возьмём на себя ответственность за выход из инструмента командной строки с ненулевым кодом ошибки у panic! и вместо этого реализуем это вручную. Ненулевой статус выхода — это соглашение, чтобы сигнализировать процессу, который вызвал нашу программу, что программа завершилась с состоянием ошибки.
use std::env;
use std::fs;
use std::process;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
// --snip--
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}Config не удаласьВ этом листинге мы использовали метод, который ещё не рассматривали подробно: unwrap_or_else, который определён для Result<T, E> стандартной библиотекой. Использование unwrap_or_else позволяет нам определить некоторую пользовательскую, не-panic! обработку ошибок. Если Result является значением Ok, поведение этого метода похоже на unwrap: он возвращает внутреннее значение, которое оборачивает Ok. Однако если значение является значением Err, этот метод вызывает код в замыкании, которое является анонимной функцией, которую мы определяем и передаём в качестве аргумента в unwrap_or_else. Мы рассмотрим замыкания более подробно в главе 13. Пока вам просто нужно знать, что unwrap_or_else передаст внутреннее значение Err, которое в данном случае является статической строкой "not enough arguments", которую мы добавили в листинге 12-9, нашему замыканию в аргументе err, который появляется между вертикальными чертами. Код в замыкании затем может использовать значение err, когда оно выполняется.
Мы добавили новую строку use, чтобы привнести process из стандартной библиотеки в область видимости. Код в замыкании, который будет выполняться в случае ошибки, состоит всего из двух строк: мы печатаем значение err и затем вызываем process::exit. Функция process::exit немедленно остановит программу и вернёт число, которое было передано в качестве кода статуса выхода. Это похоже на обработку на основе panic!, которую мы использовали в листинге 12-8, но мы больше не получаем весь дополнительный вывод. Давайте попробуем:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
Running `target/debug/minigrep`
Problem parsing arguments: not enough arguments
Отлично! Этот вывод гораздо дружелюбнее для наших пользователей.
Извлечение логики из main
Теперь, когда мы закончили рефакторинг разбора конфигурации, давайте перейдём к логике программы. Как мы заявили в разделе «Разделение обязанностей в бинарных проектах», мы извлечём функцию с именем run, которая будет содержать всю логику, находящуюся в настоящее время в функции main и не связанную с настройкой конфигурации или обработкой ошибок. Когда мы закончим, функция main будет краткой и легкой для проверки путём осмотра, и мы сможем написать тесты для всей остальной логики.
Листинг 12-11 показывает небольшое постепенное улучшение, извлекающее функцию run.
use std::env;
use std::fs;
use std::process;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
run(config);
}
fn run(config: Config) {
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
// --snip--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}run, содержащей остальную логику программыФункция run теперь содержит всю оставшуюся логику из main, начиная с чтения файла. Функция run принимает экземпляр Config в качестве аргумента.
Возврат ошибок из run
С отделённой в функцию run оставшейся логикой программы мы можем улучшить обработку ошибок, как мы делали с Config::build в листинге 12-9. Вместо того чтобы позволять программе паниковать, вызывая expect, функция run будет возвращать Result<T, E>, когда что-то пойдёт не так. Это позволит нам ещё больше консолидировать логику обработки ошибок в main удобным для пользователя способом. Листинг 12-12 показывает изменения, которые нам нужно внести в сигнатуру и тело run.
use std::env;
use std::fs;
use std::process;
use std::error::Error;
// --snip--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
run(config);
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
println!("With text:\n{contents}");
Ok(())
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}run для возврата ResultМы сделали три значительных изменения здесь. Во-первых, мы изменили тип возвращаемого значения функции run на Result<(), Box<dyn Error>>. Эта функция ранее возвращала unit-тип (), и мы сохраняем его в качестве значения, возвращаемого в случае Ok.
Для типа ошибки мы использовали трейт-объект Box<dyn Error> (и мы привнесли std::error::Error в область видимости с помощью инструкции use вверху). Мы рассмотрим трейт-объекты в главе 18. Пока просто знайте, что Box<dyn Error> означает, что функция вернёт тип, реализующий трейт Error, но нам не нужно указывать, какой конкретный тип будет иметь возвращаемое значение. Это даёт нам гибкость возвращать значения ошибок, которые могут быть разных типов в разных случаях ошибок. Ключевое слово dyn — это сокращение от dynamic (динамический).
Во-вторых, мы удалили вызов expect в пользу оператора ?, как мы говорили в главе 9. Вместо panic! при ошибке ? вернёт значение ошибки из текущей функции для обработки вызывающей стороной.
В-третьих, функция run теперь возвращает значение Ok в случае успеха. Мы объявили успешный тип функции run как () в сигнатуре, что означает, что нам нужно обернуть значение unit-типа в значение Ok. Этот синтаксис Ok(()) может показаться немного странным поначалу. Но использование () таким образом — это идиоматический способ указать, что мы вызываем run только ради его побочных эффектов; она не возвращает значение, которое нам нужно.
Когда вы запустите этот код, он скомпилируется, но отобразит предупреждение:
$ cargo run -- the poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
warning: unused `Result` that must be used
--> src/main.rs:19:5
|
19 | run(config);
| ^^^^^^^^^^^
|
= note: this `Result` may be an `Err` variant, which should be handled
= note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
|
19 | let _ = run(config);
| +++++++
warning: `minigrep` (bin "minigrep") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.71s
Running `target/debug/minigrep the poem.txt`
Searching for the
In file poem.txt
With text:
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
Rust сообщает нам, что наш код проигнорировал значение Result, и значение Result может указывать на то, что произошла ошибка. Но мы не проверяем, была ли ошибка, и компилятор напоминает нам, что мы, вероятно, имели в виду какой-то код обработки ошибок здесь! Давайте исправим эту проблему сейчас.
Обработка ошибок, возвращаемых из run, в main
Мы будем проверять наличие ошибок и обрабатывать их, используя технику, подобную той, которую мы использовали с Config::build в листинге 12-10, но с небольшим отличием:
Имя файла: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
println!("With text:\n{contents}");
Ok(())
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}Мы используем if let, а не unwrap_or_else, чтобы проверить, возвращает ли run значение Err, и вызвать process::exit(1), если оно возвращает. Функция run не возвращает значение, которое мы хотим unwrap так же, как Config::build возвращает экземпляр Config. Поскольку run возвращает () в случае успеха, нас интересует только обнаружение ошибки, поэтому нам не нужен unwrap_or_else для возврата развёрнутого значения, которым было бы только ().
Тела if let и функций unwrap_or_else одинаковы в обоих случаях: мы печатаем ошибку и выходим.
Разделение кода на библиотечный крейт
Наш проект minigrep пока выглядит хорошо! Теперь мы разделим файл src/main.rs и поместим часть кода в файл src/lib.rs. Таким образом, мы сможем тестировать код и иметь файл src/main.rs с меньшим количеством обязанностей.
Давайте определим код, отвечающий за поиск текста, в src/lib.rs, а не в src/main.rs, что позволит нам (или любому другому пользователю нашей библиотеки minigrep) вызывать функцию поиска из большего числа контекстов, чем наш бинарный файл minigrep.
Сначала давайте определим сигнатуру функции search в src/lib.rs, как показано в листинге 12-13, с телом, которое вызывает макрос unimplemented!. Мы объясним сигнатуру более подробно, когда заполним реализацию.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
unimplemented!();
}search в src/lib.rsМы использовали ключевое слово pub в определении функции, чтобы обозначить search как часть публичного API нашего библиотечного крейта. Теперь у нас есть библиотечный крейт, который мы можем использовать из нашего бинарного крейта и который мы можем тестировать!
Теперь нам нужно привнести код, определённый в src/lib.rs, в область видимости бинарного крейта в src/main.rs и вызвать его, как показано в листинге 12-14.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
// --snip--
use minigrep::search;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
// --snip--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
for line in search(&config.query, &contents) {
println!("{line}");
}
Ok(())
}search библиотечного крейта minigrep в src/main.rsМы добавляем строку use minigrep::search, чтобы привнести функцию search из библиотечного крейта в область видимости бинарного крейта. Затем в функции run вместо печати содержимого файла мы вызываем функцию search и передаём ей значение config.query и contents в качестве аргументов. Затем run будет использовать цикл for для печати каждой строки, возвращённой из search, которая совпала с запросом. Это также хорошее время, чтобы удалить вызовы println! в функции main, которые отображали запрос и путь к файлу, чтобы наша программа печатала только результаты поиска (если не возникает ошибок).
Обратите внимание, что функция search будет собирать все результаты в вектор, который она возвращает, прежде чем произойдёт какая-либо печать. Эта реализация может быть медленной при выводе результатов поиска в больших файлах, потому что результаты не печатаются по мере их обнаружения; мы обсудим возможный способ исправить это с помощью итераторов в главе 13.
Ух! Это была большая работа, но мы подготовили себя к успеху в будущем. Теперь гораздо легче обрабатывать ошибки, и мы сделали код более модульным. Почти вся наша работа будет выполняться в src/lib.rs с этого момента.
Давайте воспользуемся этой вновь обретённой модульностью, сделав то, что было бы трудно со старым кодом, но легко с новым кодом: мы напишем несколько тестов!
Добавление функциональности с помощью разработки через тестирование
Добавление функциональности с помощью разработки через тестирование
Теперь, когда у нас есть логика поиска в src/lib.rs отдельно от функции main, писать тесты для основной функциональности нашего кода гораздо проще. Мы можем вызывать функции напрямую с различными аргументами и проверять возвращаемые значения, не вызывая наш бинарный файл из командной строки.
В этом разделе мы добавим логику поиска в программу minigrep, используя процесс разработки через тестирование (TDD) со следующими шагами:
- Напишите тест, который терпит неудачу, и запустите его, чтобы убедиться, что он терпит неудачу по той причине, которую вы ожидаете.
- Напишите или измените ровно столько кода, сколько нужно, чтобы новый тест прошёл.
- Проведите рефакторинг только что добавленного или изменённого кода и убедитесь, что тесты продолжают проходить.
- Повторите с шага 1!
Хотя это лишь один из многих способов написания программного обеспечения, TDD может помочь управлять дизайном кода. Написание теста перед написанием кода, который заставляет тест пройти, помогает поддерживать высокое покрытие тестами на протяжении всего процесса.
Мы будем разрабатывать через тестирование реализацию функциональности, которая фактически выполнит поиск строки запроса в содержимом файла и создаст список строк, соответствующих запросу. Мы добавим эту функциональность в функцию с именем search.
Написание терпящего неудачу теста
В src/lib.rs мы добавим модуль tests с тестовой функцией, как мы делали в главе 11. Тестовая функция определяет поведение, которое мы хотим, чтобы имела функция search: она будет принимать запрос и текст для поиска, и она будет возвращать только те строки из текста, которые содержат запрос. Листинг 12-15 показывает этот тест.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
unimplemented!();
}
// --snip--
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}search на функциональность, которую мы хотели бы иметьЭтот тест ищет строку "duct". Текст, который мы ищем, состоит из трёх строк, только одна из которых содержит "duct" (обратите внимание, что обратная косая черта после открывающей двойной кавычки указывает Rust не помещать символ новой строки в начало содержимого этого строкового литерала). Мы утверждаем, что значение, возвращённое из функции search, содержит только строку, которую мы ожидаем.
Если мы запустим этот тест, он в настоящее время потерпит неудачу, потому что макрос unimplemented! паникует с сообщением «not implemented». В соответствии с принципами TDD мы сделаем небольшой шаг — добавим ровно столько кода, чтобы тест не паниковал при вызове функции, определив функцию search так, чтобы она всегда возвращала пустой вектор, как показано в листинге 12-16. Затем тест должен скомпилироваться и потерпеть неудачу, потому что пустой вектор не соответствует вектору, содержащему строку "safe, fast, productive.".
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
vec![]
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}search, чтобы её вызов не паниковалТеперь давайте обсудим, почему нам нужно определить явное время жизни 'a в сигнатуре search и использовать это время жизни с аргументом contents и возвращаемым значением. Напомним из главы 10, что параметры времени жизни определяют, какое время жизни аргумента связано со временем жизни возвращаемого значения. В этом случае мы указываем, что возвращаемый вектор должен содержать срезы строк, которые ссылаются на части аргумента contents (а не аргумента query).
Другими словами, мы сообщаем Rust, что данные, возвращаемые функцией search, будут жить столько же, сколько данные, переданные в функцию search в аргументе contents. Это важно! Данные, на которые ссылается срез, должны быть действительны, чтобы ссылка была действительной; если компилятор предполагает, что мы делаем срезы строк из query, а не из contents, он неправильно выполнит свою проверку безопасности.
Если мы забудем аннотации времени жизни и попытаемся скомпилировать эту функцию, мы получим эту ошибку:
$ cargo build
Compiling minigrep v0.1.0 (file:///projects/minigrep)
error[E0106]: missing lifetime specifier
--> src/lib.rs:1:51
|
1 | pub fn search(query: &str, contents: &str) -> Vec<&str> {
| ---- ---- ^ expected named lifetime parameter
|
= help: this function's return type contains a borrowed value, but the signature does not say whether it is borrowed from `query` or `contents`
help: consider introducing a named lifetime parameter
|
1 | pub fn search<'a>(query: &'a str, contents: &'a str) -> Vec<&'a str> {
| ++++ ++ ++ ++
For more information about this error, try `rustc --explain E0106`.
error: could not compile `minigrep` (lib) due to 1 previous error
Rust не может знать, какой из двух параметров нам нужен для вывода, поэтому нам нужно явно указать ему. Обратите внимание, что справочный текст предлагает указать один и тот же параметр времени жизни для всех параметров и типа вывода, что неверно! Поскольку contents — это параметр, который содержит весь наш текст, и мы хотим вернуть части этого текста, которые совпадают, мы знаем, что contents — единственный параметр, который должен быть связан с возвращаемым значением с использованием синтаксиса времени жизни.
Другие языки программирования не требуют от вас связывать аргументы с возвращаемыми значениями в сигнатуре, но эта практика станет легче со временем. Вы можете сравнить этот пример с примерами в разделе «Проверка ссылок с помощью времён жизни» главы 10.
Написание кода для прохождения теста
В настоящее время наш тест терпит неудачу, потому что мы всегда возвращаем пустой вектор. Чтобы это исправить и реализовать search, нашей программе нужно выполнить следующие шаги:
- Перебрать каждую строку содержимого.
- Проверить, содержит ли строка нашу строку запроса.
- Если содержит, добавить её в список возвращаемых значений.
- Если не содержит, ничего не делать.
- Вернуть список совпавших результатов.
Давайте проработаем каждый шаг, начиная с перебора строк.
Перебор строк с помощью метода lines
В Rust есть полезный метод для построчного перебора строк, удобно названный lines, который работает, как показано в листинге 12-17. Обратите внимание, что этот код пока не скомпилируется.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
for line in contents.lines() {
// делаем что-то со строкой
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}contentsМетод lines возвращает итератор. Мы подробно рассмотрим итераторы в главе 13. Но вспомните, что вы видели этот способ использования итератора в листинге 3-5, где мы использовали цикл for с итератором для выполнения кода для каждого элемента коллекции.
Поиск запроса в каждой строке
Далее мы проверим, содержит ли текущая строка нашу строку запроса. К счастью, у строк есть полезный метод с именем contains, который делает это за нас! Добавьте вызов метода contains в функцию search, как показано в листинге 12-18. Обратите внимание, что этот код по-прежнему не скомпилируется.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
for line in contents.lines() {
if line.contains(query) {
// делаем что-то со строкой
}
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}queryНа данный момент мы наращиваем функциональность. Чтобы код скомпилировался, нам нужно вернуть значение из тела, как мы указали в сигнатуре функции.
Сохранение совпавших строк
Чтобы завершить эту функцию, нам нужен способ сохранить совпавшие строки, которые мы хотим вернуть. Для этого мы можем создать изменяемый вектор перед циклом for и вызвать метод push, чтобы сохранить line в векторе. После цикла for мы возвращаем вектор, как показано в листинге 12-19.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}Теперь функция search должна возвращать только строки, содержащие query, и наш тест должен пройти. Давайте запустим тест:
$ cargo test
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.22s
Running unittests src/lib.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 1 test
test tests::one_result ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests minigrep
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Наш тест прошёл, поэтому мы знаем, что он работает!
На этом этапе мы могли бы рассмотреть возможности рефакторинга реализации функции поиска, сохраняя тесты проходящими, чтобы поддерживать ту же функциональность. Код в функции поиска не так уж плох, но он не использует некоторые полезные возможности итераторов. Мы вернёмся к этому примеру в главе 13, где подробно рассмотрим итераторы и посмотрим, как его улучшить.
Теперь вся программа должна работать! Давайте попробуем её, сначала со словом, которое должно вернуть ровно одну строку из стихотворения Эмили Дикинсон: frog.
$ cargo run -- frog poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.38s
Running `target/debug/minigrep frog poem.txt`
How public, like a frog
Отлично! Теперь давайте попробуем слово, которое совпадёт с несколькими строками, например body:
$ cargo run -- body poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep body poem.txt`
I'm nobody! Who are you?
Are you nobody, too?
How dreary to be somebody!
И, наконец, давайте убедимся, что мы не получаем никаких строк, когда ищем слово, которого нет в стихотворении, например monomorphization:
$ cargo run -- monomorphization poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep monomorphization poem.txt`
Отлично! Мы создали свою мини-версию классического инструмента и узнали много нового о том, как структурировать приложения. Мы также узнали немного о файловом вводе и выводе, временах жизни, тестировании и разборе командной строки.
Чтобы завершить этот проект, мы кратко продемонстрируем, как работать с переменными окружения и как печатать в стандартный поток ошибок, что полезно при написании программ командной строки.
Работа с переменными окружения
Работа с переменными окружения
Мы улучшим бинарный файл minigrep, добавив дополнительную возможность: опцию
поиска без учёта регистра, которую пользователь может включить через переменную
окружения. Мы могли бы сделать эту возможность параметром командной строки и требовать,
чтобы пользователи вводили его каждый раз, когда хотят её применить, но, сделав её
переменной окружения, мы позволяем пользователям установить переменную окружения один раз
и чтобы все их поиски в этом сеансе терминала выполнялись без учёта регистра.
Написание падающего теста для поиска без учёта регистра
Сначала добавим новую функцию search_case_insensitive в библиотеку minigrep,
которая будет вызываться, когда переменная окружения имеет значение. Мы продолжим
следовать процессу TDD, поэтому первым шагом снова будет написание падающего теста.
Мы добавим новый тест для новой функции search_case_insensitive и переименуем
наш старый тест из one_result в case_sensitive, чтобы прояснить различия
между двумя тестами, как показано в листинге 12-20.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}Обратите внимание, что мы также отредактировали contents старого теста. Мы добавили новую строку
с текстом "Duct tape.", используя заглавную D, которая не должна совпадать с запросом
"duct", когда мы ищем с учётом регистра. Изменение старого теста
таким образом помогает убедиться, что мы случайно не сломаем функциональность поиска с учётом регистра,
которую мы уже реализовали. Этот тест должен пройти сейчас
и должен продолжать проходить по мере нашей работы над поиском без учёта регистра.
Новый тест для поиска без учёта регистра использует "rUsT" в качестве запроса. В
функции search_case_insensitive, которую мы собираемся добавить, запрос "rUsT"
должен совпасть со строкой, содержащей "Rust:" с заглавной R, и совпасть со
строкой "Trust me.", хотя обе имеют другой регистр, чем запрос. Это
наш падающий тест, и он не скомпилируется, потому что мы ещё не определили
функцию search_case_insensitive. Не стесняйтесь добавить скелетную
реализацию, которая всегда возвращает пустой вектор, аналогично тому, как мы делали
для функции search в листинге 12-16, чтобы увидеть, как тест компилируется и падает.
Реализация функции search_case_insensitive
Функция search_case_insensitive, показанная в листинге 12-21, будет почти
такой же, как функция search. Единственное отличие в том, что мы приведём к нижнему регистру
query и каждую line, чтобы независимо от регистра входных аргументов
они были в одном регистре, когда мы проверяем, содержит ли строка запрос.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
pub fn search_case_insensitive<'a>(
query: &str,
contents: &'a str,
) -> Vec<&'a str> {
let query = query.to_lowercase();
let mut results = Vec::new();
for line in contents.lines() {
if line.to_lowercase().contains(&query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}search_case_insensitive для приведения запроса и строки к нижнему регистру перед их сравнениемСначала мы приводим строку query к нижнему регистру и сохраняем её в новую переменную с
тем же именем, затеняя исходный query. Вызов to_lowercase для запроса
необходим, чтобы независимо от того, является ли запрос пользователя "rust", "RUST",
"Rust" или "rUsT", мы обрабатывали запрос так, как если бы он был "rust", и были
нечувствительны к регистру. Хотя to_lowercase обрабатывает базовый Unicode, он
не будет на 100 процентов точным. Если бы мы писали настоящее приложение, мы бы захотели
сделать здесь немного больше работы, но этот раздел о переменных окружения,
а не о Unicode, поэтому мы оставим это здесь.
Обратите внимание, что query теперь является String, а не срезом строки, потому что вызов
to_lowercase создаёт новые данные, а не ссылается на существующие. Скажем,
запрос — "rUsT", например: этот срез строки не содержит строчных
u или t для использования, поэтому мы должны выделить новую String, содержащую
"rust". Когда мы теперь передаём query в качестве аргумента методу contains, нам
нужно добавить амперсанд, потому что сигнатура contains определена как принимающая
срез строки.
Затем мы добавляем вызов to_lowercase для каждой line, чтобы привести к нижнему регистру все
символы. Теперь, когда мы преобразовали line и query к нижнему регистру, мы
найдём совпадения независимо от регистра запроса.
Посмотрим, проходит ли эта реализация тесты:
$ cargo test
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.33s
Running unittests src/lib.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 2 tests
test tests::case_insensitive ... ok
test tests::case_sensitive ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests minigrep
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Отлично! Они прошли. Теперь вызовем новую функцию search_case_insensitive
из функции run. Сначала добавим опцию конфигурации в структуру Config
для переключения между поиском с учётом регистра и без учёта регистра. Добавление
этого поля вызовет ошибки компиляции, потому что мы пока нигде не инициализируем это поле:
Имя файла: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
// --snip--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Мы добавили поле ignore_case, которое хранит логическое значение. Далее нам нужно, чтобы функция run
проверяла значение поля ignore_case и использовала его для решения,
вызывать ли функцию search или функцию search_case_insensitive,
как показано в листинге 12-22. Это всё ещё не скомпилируется.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
// --snip--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}search, либо search_case_insensitive в зависимости от значения в config.ignore_caseНаконец, нам нужно проверить переменную окружения. Функции для
работы с переменными окружения находятся в модуле env стандартной
библиотеки, который уже находится в области видимости в начале src/main.rs. Мы будем использовать
функцию var из модуля env, чтобы проверить, установлено ли какое-либо значение
для переменной окружения с именем IGNORE_CASE, как показано в листинге 12-23.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}IGNORE_CASEЗдесь мы создаём новую переменную ignore_case. Чтобы задать её значение, мы вызываем
функцию env::var и передаём ей имя переменной окружения
IGNORE_CASE. Функция env::var возвращает Result, который будет
успешным вариантом Ok, содержащим значение переменной окружения, если
переменная окружения установлена в любое значение. Она вернёт вариант Err
если переменная окружения не установлена.
Мы используем метод is_ok на Result, чтобы проверить, установлена ли переменная
окружения, что означает, что программа должна выполнить поиск без учёта регистра.
Если переменная окружения IGNORE_CASE ни во что не установлена, is_ok вернёт
false, и программа выполнит поиск с учётом регистра. Нас не интересует
значение переменной окружения, только установлена она или
нет, поэтому мы проверяем is_ok, а не используем unwrap, expect или любой
из других методов, которые мы видели на Result.
Мы передаём значение из переменной ignore_case в экземпляр Config, чтобы
функция run могла прочитать это значение и решить, вызывать ли
search_case_insensitive или search, как мы реализовали в листинге 12-22.
Давайте попробуем! Сначала мы запустим нашу программу без установленной переменной
окружения и с запросом to, который должен совпасть с любой строкой, содержащей
слово to в нижнем регистре:
$ cargo run -- to poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep to poem.txt`
Are you nobody, too?
How dreary to be somebody!
Похоже, это всё ещё работает! Теперь запустим программу с IGNORE_CASE, установленной
в 1, но с тем же запросом to:
$ IGNORE_CASE=1 cargo run -- to poem.txt
Если вы используете PowerShell, вам нужно будет установить переменную окружения и запустить программу отдельными командами:
PS> $Env:IGNORE_CASE=1; cargo run -- to poem.txt
Это сделает IGNORE_CASE постоянной для оставшейся части сеанса оболочки.
Её можно сбросить с помощью командлета Remove-Item:
PS> Remove-Item Env:IGNORE_CASE
Мы должны получить строки, содержащие to, которые могут иметь заглавные буквы:
Are you nobody, too?
How dreary to be somebody!
To tell your name the livelong day
To an admiring bog!
Отлично, мы также получили строки, содержащие To! Наша программа minigrep теперь может выполнять
поиск без учёта регистра, управляемый переменной окружения. Теперь вы знаете,
как управлять опциями, заданными с помощью аргументов командной строки или переменных
окружения.
Некоторые программы допускают аргументы и переменные окружения для одной и той же конфигурации. В таких случаях программы решают, что одно или другое имеет приоритет. В качестве ещё одного упражнения попробуйте управлять чувствительностью к регистру через аргумент командной строки или переменную окружения. Решите, что должно иметь приоритет — аргумент командной строки или переменная окружения, если программа запускается с одним набором для учёта регистра и другим набором для игнорирования регистра.
Модуль std::env содержит множество других полезных возможностей для работы с
переменными окружения: ознакомьтесь с его документацией, чтобы увидеть, что доступно.
Перенаправление ошибок в стандартный поток ошибок
Перенаправление ошибок в стандартный поток ошибок
На данный момент мы выводим весь наш вывод в терминал с помощью макроса println!. В большинстве терминалов есть два вида вывода: стандартный вывод (stdout) для общей информации и стандартный поток ошибок (stderr) для сообщений об ошибках. Это различие позволяет пользователям выбирать, направлять ли успешный вывод программы в файл, но при этом по-прежнему печатать сообщения об ошибках на экран.
Макрос println! способен печатать только в стандартный вывод, поэтому нам нужно использовать что-то другое для печати в стандартный поток ошибок.
Проверка того, куда записываются ошибки
Сначала давайте понаблюдаем, как в настоящее время контент, выводимый minigrep, записывается в стандартный вывод, включая любые сообщения об ошибках, которые мы хотели бы записывать в стандартный поток ошибок. Мы сделаем это, перенаправив поток стандартного вывода в файл, намеренно вызвав ошибку. Мы не будем перенаправлять поток стандартных ошибок, поэтому любой контент, отправленный в стандартный поток ошибок, будет продолжать отображаться на экране.
Ожидается, что программы командной строки отправляют сообщения об ошибках в поток стандартных ошибок, чтобы мы могли по-прежнему видеть сообщения об ошибках на экране, даже если мы перенаправляем поток стандартного вывода в файл. Наша программа сейчас ведёт себя неправильно: мы вот-вот увидим, что она сохраняет вывод сообщения об ошибке в файл вместо этого!
Чтобы продемонстрировать это поведение, мы запустим программу с > и путём к файлу output.txt, в который мы хотим перенаправить поток стандартного вывода. Мы не будем передавать никаких аргументов, что должно вызвать ошибку:
$ cargo run > output.txt
Синтаксис > говорит оболочке записать содержимое стандартного вывода в output.txt вместо экрана. Мы не увидели ожидаемое сообщение об ошибке, напечатанное на экране, значит, оно должно было попасть в файл. Вот что содержит output.txt:
Problem parsing arguments: not enough arguments
Да, наше сообщение об ошибке печатается в стандартный вывод. Для сообщений об ошибках, подобных этому, гораздо полезнее печатать их в стандартный поток ошибок, чтобы в файл попадали только данные успешного запуска. Мы это изменим.
Печать ошибок в стандартный поток ошибок
Мы будем использовать код из листинга 12-24, чтобы изменить способ печати сообщений об ошибках. Благодаря рефакторингу, который мы сделали ранее в этой главе, весь код, который печатает сообщения об ошибках, находится в одной функции, main. Стандартная библиотека предоставляет макрос eprintln!, который печатает в поток стандартных ошибок, поэтому давайте заменим два места, где мы вызывали println! для печати ошибок, на eprintln!.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}eprintln!Давайте теперь снова запустим программу тем же способом, без аргументов и перенаправляя стандартный вывод с помощью >:
$ cargo run > output.txt
Problem parsing arguments: not enough arguments
Теперь мы видим ошибку на экране, а output.txt ничего не содержит, что и является поведением, которое мы ожидаем от программ командной строки.
Давайте снова запустим программу с аргументами, которые не вызывают ошибку, но по-прежнему перенаправляют стандартный вывод в файл, вот так:
$ cargo run -- to poem.txt > output.txt
Мы не увидим никакого вывода в терминале, и output.txt будет содержать наши результаты:
Имя файла: output.txt
Are you nobody, too?
How dreary to be somebody!
Это демонстрирует, что теперь мы используем стандартный вывод для успешного вывода и стандартный поток ошибок для вывода ошибок, как и положено.
Итоги
В этой главе был повторён ряд основных концепций, которые вы изучили до сих пор, а также рассмотрено, как выполнять общие операции ввода-вывода в Rust. Используя аргументы командной строки, файлы, переменные окружения и макрос eprintln! для печати ошибок, вы теперь готовы писать приложения командной строки. В сочетании с концепциями из предыдущих глав ваш код будет хорошо организован, эффективно хранить данные в соответствующих структурах данных, хорошо обрабатывать ошибки и быть хорошо протестированным.
Далее мы рассмотрим некоторые особенности Rust, на которые повлияли функциональные языки: замыкания и итераторы.
Функциональные возможности языка: итераторы и замыкания
Функциональные возможности языка: итераторы и замыкания
Дизайн Rust вдохновлён множеством существующих языков и техник, и одно значительное влияние — это функциональное программирование. Программирование в функциональном стиле часто включает использование функций как значений путём передачи их в аргументах, возврата их из других функций, присваивания их переменным для последующего выполнения и так далее.
В этой главе мы не будем обсуждать вопрос о том, что такое функциональное программирование и что нет, а вместо этого обсудим некоторые возможности Rust, которые похожи на возможности во многих языках, часто называемых функциональными.
Более конкретно, мы рассмотрим:
- Замыкания, конструкцию, подобную функции, которую можно хранить в переменной
- Итераторы, способ обработки последовательности элементов
- Как использовать замыкания и итераторы для улучшения проекта ввода-вывода в двенадцатой главе
- Производительность замыканий и итераторов (спойлер: они быстрее, чем вы могли бы подумать!)
Мы уже рассмотрели некоторые другие возможности Rust, такие как сопоставление с образцом и перечисления, которые также находятся под влиянием функционального стиля. Поскольку освоение замыканий и итераторов является важной частью написания быстрого, идиоматичного кода на Rust, мы посвятим им всю эту главу.
Замыкания
Замыкания
Замыкания в Rust — это анонимные функции, которые можно сохранить в переменной или передать в качестве аргументов другим функциям. Можно создать замыкание в одном месте, а затем вызвать его в другом месте, чтобы вычислить его в другом контексте. В отличие от функций, замыкания могут захватывать значения из области видимости, в которой они определены. Мы продемонстрируем, как эти возможности замыканий позволяют повторно использовать код и настраивать поведение.
Захват окружения
Сначала рассмотрим, как можно использовать замыкания для захвата значений из окружения, в котором они определены, для последующего использования. Вот сценарий: время от времени наша компания по производству футболок дарит эксклюзивную футболку ограниченного выпуска кому-то из нашего списка рассылки в качестве рекламной акции. Люди из списка рассылки могут по желанию добавить свой любимый цвет в свой профиль. Если выбранный для бесплатной футболки человек указал свой любимый цвет, он получает футболку этого цвета. Если человек не указал любимый цвет, он получает тот цвет, которого у компании сейчас больше всего.
Есть много способов реализовать это. В этом примере мы собираемся использовать
перечисление ShirtColor с вариантами Red и Blue (для простоты ограничив
количество доступных цветов). Запасы компании мы представляем с помощью
структуры Inventory с полем shirts, которое
содержит Vec<ShirtColor>, представляющий цвета футболок, имеющихся на складе.
Метод giveaway, определённый для Inventory, получает необязательное предпочтение
цвета футболки победителя розыгрыша и возвращает цвет футболки, который
получит человек. Эта установка показана в листинге 13-1.
#[derive(Debug, PartialEq, Copy, Clone)]
enum ShirtColor {
Red,
Blue,
}
struct Inventory {
shirts: Vec<ShirtColor>,
}
impl Inventory {
fn giveaway(&self, user_preference: Option<ShirtColor>) -> ShirtColor {
user_preference.unwrap_or_else(|| self.most_stocked())
}
fn most_stocked(&self) -> ShirtColor {
let mut num_red = 0;
let mut num_blue = 0;
for color in &self.shirts {
match color {
ShirtColor::Red => num_red += 1,
ShirtColor::Blue => num_blue += 1,
}
}
if num_red > num_blue {
ShirtColor::Red
} else {
ShirtColor::Blue
}
}
}
fn main() {
let store = Inventory {
shirts: vec![ShirtColor::Blue, ShirtColor::Red, ShirtColor::Blue],
};
let user_pref1 = Some(ShirtColor::Red);
let giveaway1 = store.giveaway(user_pref1);
println!(
"The user with preference {:?} gets {:?}",
user_pref1, giveaway1
);
let user_pref2 = None;
let giveaway2 = store.giveaway(user_pref2);
println!(
"The user with preference {:?} gets {:?}",
user_pref2, giveaway2
);
}Определённый в main магазин store имеет две синие футболки и одну красную, оставшиеся
для раздачи в рамках этой акции ограниченного выпуска. Мы вызываем метод giveaway
для пользователя с предпочтением красной футболки и для пользователя без каких-либо предпочтений.
Опять же, этот код можно было бы реализовать многими способами, и здесь, чтобы сосредоточиться на
замыканиях, мы придерживались концепций, которые уже были изучены, за исключением тела
метода giveaway, в котором используется замыкание. В методе giveaway мы получаем
предпочтение пользователя как параметр типа Option<ShirtColor> и вызываем метод
unwrap_or_else для user_preference. Метод unwrap_or_else для
Option<T> определён в стандартной библиотеке.
Он принимает один аргумент: замыкание без аргументов, которое возвращает значение T
(тот же тип, что хранится в варианте Some у Option<T>, в данном случае
ShirtColor). Если Option<T> — это вариант Some, unwrap_or_else
возвращает значение изнутри Some. Если Option<T> — это вариант None,
unwrap_or_else вызывает замыкание и возвращает значение, возвращённое
замыканием.
Мы указываем выражение замыкания || self.most_stocked() в качестве аргумента для
unwrap_or_else. Это замыкание, которое само не принимает параметров (если бы у
замыкания были параметры, они появились бы между двумя вертикальными чертами). Тело
замыкания вызывает self.most_stocked(). Мы определяем замыкание
здесь, а реализация unwrap_or_else вычислит замыкание
позже, если результат понадобится.
Выполнение этого кода выводит следующее:
$ cargo run
Compiling shirt-company v0.1.0 (file:///projects/shirt-company)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.27s
Running `target/debug/shirt-company`
The user with preference Some(Red) gets Red
The user with preference None gets Blue
Один интересный аспект здесь заключается в том, что мы передали замыкание, которое вызывает
self.most_stocked() для текущего экземпляра Inventory. Стандартной библиотеке
не нужно было ничего знать о типах Inventory или ShirtColor, которые мы
определили, или о логике, которую мы хотим использовать в этом сценарии. Замыкание захватывает
неизменяемую ссылку на экземпляр Inventory self и передаёт его вместе с
кодом, который мы указываем, методу unwrap_or_else. Функции, с другой стороны,
не могут захватывать своё окружение таким образом.
Вывод и аннотирование типов замыканий
Между функциями и замыканиями есть и другие различия. Замыкания обычно
не требуют аннотировать типы параметров или возвращаемого значения
так, как это делают функции fn. Аннотации типов обязательны для функций, потому что
типы являются частью явного интерфейса, предоставляемого пользователям. Жёсткое
определение этого интерфейса важно для того, чтобы все соглашались с тем, какие типы
значений использует и возвращает функция. Замыкания, с другой стороны, не используются
в таком открытом интерфейсе: они хранятся в переменных и
используются без именования и предоставления пользователям нашей библиотеки.
Замыкания, как правило, короткие и актуальны только в узком контексте, а не в каком-либо произвольном сценарии. В этих ограниченных контекстах компилятор может вывести типы параметров и возвращаемый тип, подобно тому, как он способен вывести типы большинства переменных (есть редкие случаи, когда компилятору тоже нужны аннотации типов замыканий).
Как и с переменными, можно добавить аннотации типов, если нужно повысить явность и ясность ценой большей многословности, чем строго необходимо. Аннотирование типов для замыкания выглядело бы как определение, показанное в листинге 13-2. В этом примере мы определяем замыкание и сохраняем его в переменной, а не определяем замыкание в том месте, где передаём его как аргумент, как мы делали в листинге 13-1.
use std::thread;
use std::time::Duration;
fn generate_workout(intensity: u32, random_number: u32) {
let expensive_closure = |num: u32| -> u32 {
println!("calculating slowly...");
thread::sleep(Duration::from_secs(2));
num
};
if intensity < 25 {
println!("Today, do {} pushups!", expensive_closure(intensity));
println!("Next, do {} situps!", expensive_closure(intensity));
} else {
if random_number == 3 {
println!("Take a break today! Remember to stay hydrated!");
} else {
println!(
"Today, run for {} minutes!",
expensive_closure(intensity)
);
}
}
}
fn main() {
let simulated_user_specified_value = 10;
let simulated_random_number = 7;
generate_workout(simulated_user_specified_value, simulated_random_number);
}С добавленными аннотациями типов синтаксис замыканий выглядит более похожим на синтаксис функций. Здесь мы определяем функцию, которая добавляет 1 к своему параметру, и замыкание с тем же поведением для сравнения. Мы добавили несколько пробелов, чтобы выровнять соответствующие части. Это иллюстрирует, насколько синтаксис замыканий похож на синтаксис функций, за исключением использования вертикальных черт и объёма синтаксиса, который является необязательным:
fn add_one_v1 (x: u32) -> u32 { x + 1 }
let add_one_v2 = |x: u32| -> u32 { x + 1 };
let add_one_v3 = |x| { x + 1 };
let add_one_v4 = |x| x + 1 ;Первая строка показывает определение функции, а вторая строка показывает полностью
аннотированное определение замыкания. В третьей строке мы удаляем аннотации типов
из определения замыкания. В четвёртой строке мы удаляем скобки, которые
необязательны, потому что тело замыкания состоит только из одного выражения. Все это
допустимые определения, которые при вызове дадут одинаковое поведение. Строки
add_one_v3 и add_one_v4 требуют, чтобы замыкания были вычислены, чтобы
можно было скомпилировать, потому что типы будут выведены из их использования. Это
похоже на то, что let v = Vec::new(); требует либо аннотаций типов, либо значений
некоторого типа, вставленных в Vec, чтобы Rust мог вывести тип.
Для определений замыканий компилятор выведет один конкретный тип для каждого из
их параметров и для их возвращаемого значения. Например, листинг 13-3 показывает
определение короткого замыкания, которое просто возвращает значение, полученное в качестве
параметра. Это замыкание не очень полезно, кроме как для целей этого
примера. Обратите внимание, что мы не добавили никаких аннотаций типов в определение.
Поскольку аннотаций типов нет, мы можем вызывать замыкание с любым типом,
что мы и сделали здесь с String в первый раз. Если затем попытаться вызвать
example_closure с целым числом, мы получим ошибку.
fn main() {
let example_closure = |x| x;
let s = example_closure(String::from("hello"));
let n = example_closure(5);
}Компилятор выдаёт нам эту ошибку:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
error[E0308]: mismatched types
--> src/main.rs:5:29
|
5 | let n = example_closure(5);
| --------------- ^ expected `String`, found integer
| |
| arguments to this function are incorrect
|
note: expected because the closure was earlier called with an argument of type `String`
--> src/main.rs:4:29
|
4 | let s = example_closure(String::from("hello"));
| --------------- ^^^^^^^^^^^^^^^^^^^^^ expected because this argument is of type `String`
| |
| in this closure call
note: closure parameter defined here
--> src/main.rs:2:28
|
2 | let example_closure = |x| x;
| ^
help: try using a conversion method
|
5 | let n = example_closure(5.to_string());
| ++++++++++++
For more information about this error, try `rustc --explain E0308`.
error: could not compile `closure-example` (bin "closure-example") due to 1 previous error
Когда мы впервые вызываем example_closure со значением String, компилятор
выводит тип x и возвращаемый тип замыкания как String. Затем эти
типы фиксируются в замыкании в example_closure, и мы получаем ошибку
типов, когда в следующий раз пытаемся использовать другой тип с тем же замыканием.
Захват ссылок или перемещение владения
Замыкания могут захватывать значения из своего окружения тремя способами, которые непосредственно соответствуют трём способам, которыми функция может принимать параметр: заимствование неизменяемо, заимствование изменяемо и принятие владения. Замыкание решит, какой из них использовать, исходя из того, что тело функции делает с захваченными значениями.
В листинге 13-4 мы определяем замыкание, которое захватывает неизменяемую ссылку на
вектор с именем list, потому что ему нужна только неизменяемая ссылка, чтобы напечатать
значение.
fn main() {
let list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
let only_borrows = || println!("From closure: {list:?}");
println!("Before calling closure: {list:?}");
only_borrows();
println!("After calling closure: {list:?}");
}Этот пример также иллюстрирует, что переменная может связываться с определением замыкания, и мы можем позже вызвать замыкание, используя имя переменной и круглые скобки, как если бы имя переменной было именем функции.
Поскольку у нас может быть несколько неизменяемых ссылок на list одновременно,
list по-прежнему доступен из кода до определения замыкания, после
определения замыкания, но до вызова замыкания, и после того, как замыкание
вызвано. Этот код компилируется, выполняется и печатает:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/closure-example`
Before defining closure: [1, 2, 3]
Before calling closure: [1, 2, 3]
From closure: [1, 2, 3]
After calling closure: [1, 2, 3]
Далее, в листинге 13-5, мы меняем тело замыкания так, чтобы оно добавляло элемент в
вектор list. Теперь замыкание захватывает изменяемую ссылку.
fn main() {
let mut list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
let mut borrows_mutably = || list.push(7);
borrows_mutably();
println!("After calling closure: {list:?}");
}Этот код компилируется, выполняется и печатает:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/closure-example`
Before defining closure: [1, 2, 3]
After calling closure: [1, 2, 3, 7]
Обратите внимание, что между определением и вызовом
замыкания borrows_mutably больше нет println!: когда borrows_mutably определяется, оно захватывает
изменяемую ссылку на list. Мы не используем замыкание снова после того, как замыкание
вызвано, поэтому изменяемое заимствование заканчивается. Между определением замыкания и
вызовом замыкания неизменяемое заимствование для печати не допускается, потому что при
изменяемом заимствовании никакие другие заимствования не разрешены. Попробуйте добавить println!
туда, чтобы увидеть, какое сообщение об ошибке вы получите!
Если нужно заставить замыкание принять владение значениями, которые оно использует в
окружении, даже если тело замыкания строго не требует
владения, можно использовать ключевое слово move перед списком параметров.
Этот приём в основном полезен при передаче замыкания в новый поток, чтобы переместить
данные так, чтобы они принадлежали новому потоку. Мы подробно обсудим потоки и то, зачем
их использовать, в главе 16, когда будем говорить о
конкурентности, но пока кратко рассмотрим порождение нового потока с использованием
замыкания, которому нужно ключевое слово move. Листинг 13-6 показывает листинг 13-4, изменённый
так, чтобы печатать вектор в новом потоке, а не в основном потоке.
use std::thread;
fn main() {
let list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
thread::spawn(move || println!("From thread: {list:?}"))
.join()
.unwrap();
}move, чтобы заставить замыкание для потока принять владение listМы порождаем новый поток, передавая потоку замыкание для запуска в качестве аргумента. Тело
замыкания печатает список. В листинге 13-4 замыкание захватывало list
только через неизменяемую ссылку, потому что это минимальный уровень доступа
к list, необходимый для его печати. В этом примере, хотя тело замыкания
по-прежнему требует только неизменяемую ссылку, нам нужно указать, что list должен
быть перемещён в замыкание, поместив ключевое слово move в начале
определения замыкания. Если бы основной поток выполнил больше операций перед вызовом
join для нового потока, новый поток мог бы завершиться раньше остальной части
основного потока, или основной поток мог бы завершиться первым. Если бы основной поток
сохранял владение list, но завершился до нового потока и удалил
list, неизменяемая ссылка в потоке стала бы недействительной. Поэтому
компилятор требует, чтобы list был перемещён в замыкание, передаваемое новому потоку,
чтобы ссылка оставалась действительной. Попробуйте удалить ключевое слово move или использовать
list в основном потоке после определения замыкания, чтобы увидеть, какие ошибки
компилятора вы получите!
Перемещение захваченных значений из замыканий
После того как замыкание захватило ссылку или владение значением из окружения, в котором определено замыкание (что влияет на то, что, если что-то, перемещается в замыкание), код в теле замыкания определяет, что происходит со ссылками или значениями, когда замыкание вычисляется позже (что влияет на то, что, если что-то, перемещается из замыкания).
Тело замыкания может делать любое из следующего: перемещать захваченное значение из замыкания, изменять захваченное значение, не перемещать и не изменять значение или вообще ничего не захватывать из окружения.
Способ, которым замыкание захватывает и обрабатывает значения из окружения, влияет на
то, какие трейты реализует замыкание, а трейты — это то, как функции и структуры
могут указывать, какие виды замыканий они могут использовать. Замыкания автоматически
реализуют один, два или все три из этих трейтов Fn, аддитивным образом,
в зависимости от того, как тело замыкания обрабатывает значения:
FnOnceприменяется к замыканиям, которые могут быть вызваны один раз. Все замыкания реализуют как минимум этот трейт, потому что все замыкания могут быть вызваны. Замыкание, которое перемещает захваченные значения из своего тела, будет реализовывать толькоFnOnceи ни один из других трейтовFn, потому что оно может быть вызвано только один раз.FnMutприменяется к замыканиям, которые не перемещают захваченные значения из своего тела, но могут изменять захваченные значения. Такие замыкания могут быть вызваны более одного раза.Fnприменяется к замыканиям, которые не перемещают захваченные значения из своего тела и не изменяют захваченные значения, а также к замыканиям, которые ничего не захватывают из своего окружения. Такие замыкания могут быть вызваны более одного раза без изменения своего окружения, что важно в случаях, например, при вызове замыкания несколько раз одновременно.
Давайте посмотрим на определение метода unwrap_or_else для Option<T>, который
мы использовали в листинге 13-1:
impl<T> Option<T> {
pub fn unwrap_or_else<F>(self, f: F) -> T
where
F: FnOnce() -> T
{
match self {
Some(x) => x,
None => f(),
}
}
}Напомним, что T — это обобщённый тип, представляющий тип значения в
варианте Some у Option. Этот тип T также является возвращаемым типом
функции unwrap_or_else: код, который вызывает unwrap_or_else для
Option<String>, например, получит String.
Далее, обратите внимание, что функция unwrap_or_else имеет дополнительный обобщённый параметр
типа F. Тип F — это тип параметра с именем f, который является
замыканием, которое мы предоставляем при вызове unwrap_or_else.
Ограничение трейта, указанное для обобщённого типа F, — это FnOnce() -> T, что
означает, что F должен иметь возможность быть вызванным один раз, не принимать аргументов и возвращать T.
Использование FnOnce в ограничении трейта выражает ограничение, что
unwrap_or_else не будет вызывать f более одного раза. В теле
unwrap_or_else мы видим, что если Option — это Some, f не будет
вызван. Если Option — это None, f будет вызван один раз. Поскольку все
замыкания реализуют FnOnce, unwrap_or_else принимает замыкания всех трёх видов
и настолько гибок, насколько это возможно.
Примечание: если то, что мы хотим сделать, не требует захвата значения из
окружения, мы можем использовать имя функции вместо замыкания там, где
нужно что-то, реализующее один из трейтов Fn. Например, для значения
Option<Vec<T>> мы могли бы вызвать unwrap_or_else(Vec::new), чтобы получить
новый пустой вектор, если значение — None. Компилятор автоматически
реализует тот из трейтов Fn, который применим к определению функции.
Теперь давайте посмотрим на метод стандартной библиотеки sort_by_key, определённый для срезов,
чтобы увидеть, чем он отличается от unwrap_or_else и почему sort_by_key использует
FnMut вместо FnOnce в ограничении трейта. Замыкание получает один аргумент
в виде ссылки на текущий элемент в рассматриваемом срезе
и возвращает значение типа K, которое можно упорядочить. Эта функция полезна
когда нужно отсортировать срез по определённому атрибуту каждого элемента. В
листинге 13-7 у нас есть список экземпляров Rectangle, и мы используем sort_by_key,
чтобы упорядочить их по атрибуту width от меньшего к большему.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
list.sort_by_key(|r| r.width);
println!("{list:#?}");
}sort_by_key для упорядочивания прямоугольников по ширинеЭтот код печатает:
$ cargo run
Compiling rectangles v0.1.0 (file:///projects/rectangles)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.41s
Running `target/debug/rectangles`
[
Rectangle {
width: 3,
height: 5,
},
Rectangle {
width: 7,
height: 12,
},
Rectangle {
width: 10,
height: 1,
},
]
Причина, по которой sort_by_key определён так, что принимает замыкание FnMut, заключается в том, что он вызывает
замыкание несколько раз: по одному разу для каждого элемента в срезе. Замыкание |r| r.width
ничего не захватывает, не изменяет и не перемещает из своего окружения, поэтому
оно соответствует требованиям ограничения трейта.
Напротив, листинг 13-8 показывает пример замыкания, которое реализует только
трейт FnOnce, потому что оно перемещает значение из окружения. Компилятор
не позволит нам использовать это замыкание с sort_by_key.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
let mut sort_operations = vec![];
let value = String::from("closure called");
list.sort_by_key(|r| {
sort_operations.push(value);
r.width
});
println!("{list:#?}");
}FnOnce с sort_by_keyЭто надуманный, запутанный способ (который не работает) попытаться подсчитать количество
раз, которое sort_by_key вызывает замыкание при сортировке list. Этот код
пытается выполнить подсчёт, помещая value — String из окружения замыкания — в
вектор sort_operations. Замыкание захватывает value, а
затем перемещает value из замыкания, передавая владение value
вектору sort_operations. Это замыкание может быть вызвано один раз; попытка вызвать
его второй раз не сработала бы, потому что value больше не было бы в
окружении, чтобы снова поместить его в sort_operations! Поэтому это замыкание
реализует только FnOnce. Когда мы пытаемся скомпилировать этот код, мы получаем эту ошибку,
что value не может быть перемещено из замыкания, потому что замыкание должно
реализовывать FnMut:
$ cargo run
Compiling rectangles v0.1.0 (file:///projects/rectangles)
error[E0507]: cannot move out of `value`, a captured variable in an `FnMut` closure
--> src/main.rs:18:30
|
15 | let value = String::from("closure called");
| ----- ------------------------------ move occurs because `value` has type `String`, which does not implement the `Copy` trait
| |
| captured outer variable
16 |
17 | list.sort_by_key(|r| {
| --- captured by this `FnMut` closure
18 | sort_operations.push(value);
| ^^^^^ `value` is moved here
|
help: `Fn` and `FnMut` closures require captured values to be able to be consumed multiple times, but `FnOnce` closures may consume them only once
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/alloc/src/slice.rs:249:11
help: consider cloning the value if the performance cost is acceptable
|
18 | sort_operations.push(value.clone());
| ++++++++
For more information about this error, try `rustc --explain E0507`.
error: could not compile `rectangles` (bin "rectangles") due to 1 previous error
Ошибка указывает на строку в теле замыкания, которая перемещает value из
окружения. Чтобы исправить это, нужно изменить тело замыкания так, чтобы оно не
перемещало значения из окружения. Хранение счётчика в окружении и
увеличение его значения в теле замыкания — более простой способ
подсчитать количество раз, которое замыкание вызывается. Замыкание в листинге 13-9
работает с sort_by_key, потому что оно захватывает только изменяемую ссылку на
счётчик num_sort_operations и поэтому может быть вызвано более одного раза.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
let mut num_sort_operations = 0;
list.sort_by_key(|r| {
num_sort_operations += 1;
r.width
});
println!("{list:#?}, sorted in {num_sort_operations} operations");
}FnMut с sort_by_key разрешено.Трейты Fn важны при определении или использовании функций или типов, которые
используют замыкания. В следующем разделе мы обсудим итераторы. Многие
методы итераторов принимают аргументы-замыкания, так что имейте в виду эти детали замыканий,
продолжая изучение!
Обработка последовательности элементов с помощью итераторов
Обработка последовательности элементов с помощью итераторов
Паттерн итератора позволяет поочерёдно выполнять некоторую задачу над последовательностью элементов. Итератор отвечает за логику перебора каждого элемента и определение того, когда последовательность закончилась. При использовании итераторов не нужно самому заново реализовывать эту логику.
В Rust итераторы ленивы, то есть они не производят никакого эффекта, пока не будут вызваны
методы, потребляющие итератор. Например, код в
листинге 13-10 создаёт итератор по элементам вектора v1 путём вызова
метода iter, определённого для Vec<T>. Сам по себе этот код не делает ничего
полезного.
fn main() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
}Итератор хранится в переменной v1_iter. После создания
итератора его можно использовать различными способами. В листинге 3-5 мы перебирали
массив с помощью цикла for, чтобы выполнить некоторый код над каждым его элементом. Под
капотом это неявно создавало и затем потребляло итератор, но мы замалчивали
то, как именно это работает, до сих пор.
В примере из листинга 13-11 мы отделяем создание итератора от
использования итератора в цикле for. Когда цикл for вызывается с использованием
итератора в v1_iter, каждый элемент итератора используется в одной
итерации цикла, которая выводит каждое значение.
fn main() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
for val in v1_iter {
println!("Got: {val}");
}
}forВ языках, в которых нет итераторов, предоставляемых стандартной библиотекой, вы, скорее всего, написали бы ту же функциональность, начав переменную с индексом 0, используя эту переменную для индексации в вектор для получения значения и увеличивая значение переменной в цикле, пока она не достигнет общего числа элементов в векторе.
Итераторы выполняют всю эту логику за вас, сокращая повторяющийся код, в котором можно потенциально ошибиться. Итераторы дают больше гибкости для использования одной и той же логики со многими различными видами последовательностей, а не только со структурами данных, которые можно индексировать, как векторы. Давайте рассмотрим, как итераторы это делают.
Трейт Iterator и метод next
Все итераторы реализуют трейт с именем Iterator, который определён в
стандартной библиотеке. Определение трейта выглядит так:
#![allow(unused)]
fn main() {
pub trait Iterator {
type Item;
fn next(&mut self) -> Option<Self::Item>;
// методы с реализациями по умолчанию опущены
}
}Обратите внимание, что это определение использует некоторый новый синтаксис: type Item и Self::Item,
которые определяют ассоциированный тип для этого трейта. Мы подробно поговорим об
ассоциированных типах в главе 20. Пока всё, что нужно знать, — это то, что этот код говорит, что реализация трейта Iterator
требует также определить
тип Item, и этот тип Item используется в возвращаемом типе метода next.
Другими словами, тип Item будет тем типом, который возвращается из
итератора.
Трейт Iterator требует от реализующих его типов определить только один метод: метод
next, который возвращает один элемент итератора за раз, обёрнутый в
Some, а когда итерация завершена, возвращает None.
Мы можем вызывать метод next у итераторов напрямую; листинг 13-12 демонстрирует,
какие значения возвращаются при повторных вызовах next у итератора, созданного
из вектора.
#[cfg(test)]
mod tests {
#[test]
fn iterator_demonstration() {
let v1 = vec![1, 2, 3];
let mut v1_iter = v1.iter();
assert_eq!(v1_iter.next(), Some(&1));
assert_eq!(v1_iter.next(), Some(&2));
assert_eq!(v1_iter.next(), Some(&3));
assert_eq!(v1_iter.next(), None);
}
}next у итератораОбратите внимание, что нам нужно было сделать v1_iter изменяемым: вызов метода next у
итератора изменяет внутреннее состояние, которое итератор использует для отслеживания того, где
он находится в последовательности. Другими словами, этот код потребляет, или использует,
итератор. Каждый вызов next съедает элемент из итератора. Нам не нужно было
делать v1_iter изменяемым, когда мы использовали цикл for, потому что цикл
становился владельцем v1_iter и делал его изменяемым за кулисами.
Также обратите внимание, что значения, которые мы получаем от вызовов next, являются неизменяемыми
ссылками на значения в векторе. Метод iter создаёт итератор
по неизменяемым ссылкам. Если мы хотим создать итератор, который становится
владельцем v1 и возвращает значения с владением, мы можем вызвать into_iter вместо
iter. Аналогично, если мы хотим выполнять перебор по изменяемым ссылкам, мы можем вызвать
iter_mut вместо iter.
Методы, потребляющие итератор
Трейт Iterator имеет ряд различных методов с реализациями по умолчанию,
предоставляемыми стандартной библиотекой; вы можете узнать об этих
методах, посмотрев документацию стандартной библиотеки по API для трейта Iterator.
Некоторые из этих методов вызывают метод next в своих определениях, поэтому
при реализации трейта Iterator требуется реализовать метод next.
Методы, которые вызывают next, называются потребляющими адаптерами, потому что их вызов
расходует итератор. Один из примеров — метод sum, который становится владельцем
итератора и перебирает элементы, повторно вызывая next, тем самым
потребляя итератор. При переборе он добавляет каждый элемент к текущей
сумме и возвращает сумму, когда итерация завершена. В листинге 13-13 есть
тест, иллюстрирующий использование метода sum.
#[cfg(test)]
mod tests {
#[test]
fn iterator_sum() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
let total: i32 = v1_iter.sum();
assert_eq!(total, 6);
}
}sum для получения суммы всех элементов итератораНам не разрешено использовать v1_iter после вызова sum, потому что sum становится
владельцем итератора, у которого он вызван.
Методы, создающие другие итераторы
Адаптеры итераторов — это методы, определённые в трейте Iterator, которые не
потребляют итератор. Вместо этого они создают разные итераторы, изменяя
некоторый аспект исходного итератора.
Листинг 13-14 показывает пример вызова метода-адаптера итератора map,
который принимает замыкание для вызова на каждом элементе по мере перебора элементов.
Метод map возвращает новый итератор, который создаёт изменённые элементы. Замыкание
здесь создаёт новый итератор, в котором каждый элемент из вектора будет
увеличен на 1.
fn main() {
let v1: Vec<i32> = vec![1, 2, 3];
v1.iter().map(|x| x + 1);
}map для создания нового итератораОднако этот код выдаёт предупреждение:
$ cargo run
Compiling iterators v0.1.0 (file:///projects/iterators)
warning: unused `Map` that must be used
--> src/main.rs:4:5
|
4 | v1.iter().map(|x| x + 1);
| ^^^^^^^^^^^^^^^^^^^^^^^^
|
= note: iterators are lazy and do nothing unless consumed
= note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
|
4 | let _ = v1.iter().map(|x| x + 1);
| +++++++
warning: `iterators` (bin "iterators") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.47s
Running `target/debug/iterators`
Код в листинге 13-14 ничего не делает; замыкание, которое мы указали, никогда не вызывается. Предупреждение напоминает нам почему: адаптеры итераторов ленивы, и нам нужно потребить итератор здесь.
Чтобы исправить это предупреждение и потребить итератор, мы используем метод collect,
который мы использовали с env::args в листинге 12-1. Этот метод потребляет
итератор и собирает результирующие значения в тип коллекции.
В листинге 13-15 мы собираем результаты перебора итератора, который
возвращается из вызова map, в вектор. Этот вектор в конечном итоге будет
содержать каждый элемент из исходного вектора, увеличенный на 1.
fn main() {
let v1: Vec<i32> = vec![1, 2, 3];
let v2: Vec<_> = v1.iter().map(|x| x + 1).collect();
assert_eq!(v2, vec![2, 3, 4]);
}map для создания нового итератора, а затем вызов метода collect для потребления нового итератора и создания вектораПоскольку map принимает замыкание, мы можем указать любую операцию, которую хотим выполнить
над каждым элементом. Это отличный пример того, как замыкания позволяют настраивать некоторое
поведение, повторно используя поведение перебора, которое предоставляет трейт
Iterator.
Можно связывать в цепочку несколько вызовов адаптеров итераторов для выполнения сложных действий читаемым способом. Но поскольку все итераторы ленивы, нужно вызвать один из методов потребляющих адаптеров, чтобы получить результаты от вызовов адаптеров итераторов.
Замыкания, захватывающие своё окружение
Многие адаптеры итераторов принимают замыкания в качестве аргументов, и часто замыкания, которые мы указываем в качестве аргументов адаптеров итераторов, будут замыканиями, захватывающими своё окружение.
Для этого примера мы используем метод filter, который принимает замыкание. Замыкание
получает элемент от итератора и возвращает bool. Если замыкание
возвращает true, значение будет включено в итератор, создаваемый
filter. Если замыкание возвращает false, значение не будет включено.
В листинге 13-16 мы используем filter с замыканием, которое захватывает переменную shoe_size
из своего окружения, чтобы перебрать коллекцию экземпляров
структуры Shoe. Он будет возвращать только обувь указанного размера.
#[derive(PartialEq, Debug)]
struct Shoe {
size: u32,
style: String,
}
fn shoes_in_size(shoes: Vec<Shoe>, shoe_size: u32) -> Vec<Shoe> {
shoes.into_iter().filter(|s| s.size == shoe_size).collect()
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn filters_by_size() {
let shoes = vec![
Shoe {
size: 10,
style: String::from("sneaker"),
},
Shoe {
size: 13,
style: String::from("sandal"),
},
Shoe {
size: 10,
style: String::from("boot"),
},
];
let in_my_size = shoes_in_size(shoes, 10);
assert_eq!(
in_my_size,
vec![
Shoe {
size: 10,
style: String::from("sneaker")
},
Shoe {
size: 10,
style: String::from("boot")
},
]
);
}
}filter с замыканием, которое захватывает shoe_sizeФункция shoes_in_size становится владельцем вектора обуви и размера обуви
в качестве параметров. Она возвращает вектор, содержащий только обувь указанного
размера.
В теле shoes_in_size мы вызываем into_iter, чтобы создать итератор, который
становится владельцем вектора. Затем мы вызываем filter, чтобы адаптировать этот итератор
в новый итератор, который содержит только элементы, для которых замыкание возвращает
true.
Замыкание захватывает параметр shoe_size из окружения и
сравнивает значение с размером каждой обуви, сохраняя только обувь указанного
размера. Наконец, вызов collect собирает значения, возвращаемые
адаптированным итератором, в вектор, который возвращается функцией.
Тест показывает, что когда мы вызываем shoes_in_size, мы получаем обратно только обувь, которая
имеет тот же размер, что и указанное нами значение.
Улучшение нашего проекта ввода-вывода
Улучшение нашего проекта ввода-вывода
С этими новыми знаниями об итераторах мы можем улучшить I/O проект из главы 12, используя итераторы, чтобы сделать некоторые места в коде более ясными и краткими. Давайте посмотрим, как итераторы могут улучшить нашу реализацию функции Config::build и функции search.
Удаление clone с помощью итератора
В листинге 12-6 мы добавили код, который принимал срез значений String и создавал экземпляр структуры Config путём индексирования среза и клонирования значений, что позволяло структуре Config владеть этими значениями. В листинге 13-17 мы воспроизвели реализацию функции Config::build в том виде, в каком она была в листинге 12-23.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Config::build из листинга 12-23В то время мы сказали не беспокоиться о неэффективных вызовах clone, потому что мы удалим их в будущем. Что ж, это время пришло!
Нам нужен был clone здесь, потому что у нас есть срез с элементами String в параметре args, но функция build не владеет args. Чтобы вернуть владение экземпляром Config, нам пришлось клонировать значения из полей query и file_path структуры Config, чтобы экземпляр Config мог владеть своими значениями.
С нашими новыми знаниями об итераторах мы можем изменить функцию build, чтобы она принимала владение итератором в качестве аргумента вместо заимствования среза. Мы будем использовать функциональность итератора вместо кода, который проверяет длину среза и индексирует в определённые позиции. Это прояснит, что делает функция Config::build, потому что итератор будет обращаться к значениям.
Как только Config::build примет владение итератором и перестанет использовать операции индексирования, которые заимствуют, мы сможем переместить значения String из итератора в Config вместо вызова clone и создания нового выделения памяти.
Прямое использование возвращённого итератора
Откройте файл src/main.rs вашего I/O проекта, который должен выглядеть так:
Имя файла: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
// --snip--
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Сначала мы изменим начало функции main, которое у нас было в листинге 12-24, на код из листинга 13-18, который на этот раз использует итератор. Это не скомпилируется, пока мы также не обновим Config::build.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
// --snip--
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}env::args в Config::buildФункция env::args возвращает итератор! Вместо того, чтобы собирать значения итератора в вектор и затем передавать срез в Config::build, теперь мы передаём владение итератором, возвращённым из env::args, непосредственно в Config::build.
Далее нам нужно обновить определение Config::build. Давайте изменим сигнатуру Config::build так, чтобы она выглядела как в листинге 13-19. Это всё ещё не скомпилируется, потому что нам нужно обновить тело функции.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(
mut args: impl Iterator<Item = String>,
) -> Result<Config, &'static str> {
// --snip--
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Config::build для ожидания итератораДокументация стандартной библиотеки для функции env::args показывает, что тип возвращаемого ею итератора — std::env::Args, и что этот тип реализует трейт Iterator и возвращает значения String.
Мы обновили сигнатуру функции Config::build так, чтобы параметр args имел обобщённый тип с ограничениями трейта impl Iterator<Item = String> вместо &[String]. Это использование синтаксиса impl Trait, который мы обсуждали в разделе «Использование трейтов в качестве параметров» главы 10, означает, что args может быть любым типом, который реализует трейт Iterator и возвращает элементы String.
Поскольку мы принимаем владение args и будем изменять args путём итерации по нему, мы можем добавить ключевое слово mut в спецификацию параметра args, чтобы сделать его изменяемым.
Использование методов трейта Iterator
Далее мы исправим тело Config::build. Поскольку args реализует трейт Iterator, мы знаем, что можем вызвать для него метод next! Листинг 13-20 обновляет код из листинга 12-23, чтобы использовать метод next.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(
mut args: impl Iterator<Item = String>,
) -> Result<Config, &'static str> {
args.next();
let query = match args.next() {
Some(arg) => arg,
None => return Err("Didn't get a query string"),
};
let file_path = match args.next() {
Some(arg) => arg,
None => return Err("Didn't get a file path"),
};
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Config::build для использования методов итератораПомните, что первое значение в возвращаемом значении env::args — это имя программы. Мы хотим проигнорировать его и перейти к следующему значению, поэтому сначала мы вызываем next и ничего не делаем с возвращаемым значением. Затем мы вызываем next, чтобы получить значение, которое хотим поместить в поле query структуры Config. Если next возвращает Some, мы используем match, чтобы извлечь значение. Если он возвращает None, это означает, что было передано недостаточно аргументов, и мы досрочно возвращаем Err. Мы делаем то же самое для значения file_path.
Прояснение кода с помощью адаптеров итераторов
Мы также можем воспользоваться итераторами в функции search в нашем I/O проекте, которая воспроизведена здесь в листинге 13-21 в том виде, в каком она была в листинге 12-19.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}search из листинга 12-19Мы можем написать этот код более кратко, используя методы-адаптеры итераторов. Это также позволяет нам избежать создания изменяемого промежуточного вектора results. Функциональный стиль программирования предпочитает минимизировать количество изменяемого состояния, чтобы сделать код более понятным. Удаление изменяемого состояния может позволить будущее улучшение, чтобы поиск выполнялся параллельно, потому что нам не пришлось бы управлять конкурентным доступом к вектору results. Листинг 13-22 показывает это изменение.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
contents
.lines()
.filter(|line| line.contains(query))
.collect()
}
pub fn search_case_insensitive<'a>(
query: &str,
contents: &'a str,
) -> Vec<&'a str> {
let query = query.to_lowercase();
let mut results = Vec::new();
for line in contents.lines() {
if line.to_lowercase().contains(&query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}searchВспомните, что цель функции search — вернуть все строки в contents, которые содержат query. Подобно примеру с filter в листинге 13-16, этот код использует адаптер filter, чтобы сохранить только те строки, для которых line.contains(query) возвращает true. Затем мы собираем подходящие строки в другой вектор с помощью collect. Намного проще! Не стесняйтесь сделать то же изменение, чтобы использовать методы итераторов также в функции search_case_insensitive.
Для дальнейшего улучшения верните итератор из функции search, удалив вызов collect и изменив возвращаемый тип на impl Iterator<Item = &'a str>, чтобы функция стала адаптером итератора. Обратите внимание, что вам также нужно будет обновить тесты! Выполните поиск по большому файлу с помощью инструмента minigrep до и после внесения этого изменения, чтобы наблюдать разницу в поведении. До этого изменения программа не будет печатать никаких результатов, пока не соберёт все результаты, но после изменения результаты будут печататься по мере нахождения каждой подходящей строки, потому что цикл for в функции run может воспользоваться ленивостью итератора.
Выбор между циклами и итераторами
Следующий логичный вопрос — какой стиль следует выбирать в собственном коде и почему: исходную реализацию в листинге 13-21 или версию с использованием итераторов в листинге 13-22 (при условии, что мы собираем все результаты перед возвратом, а не возвращаем итератор). Большинство программистов на Rust предпочитают использовать стиль итераторов. Сначала немного сложнее освоиться, но как только вы почувствуете различные адаптеры итераторов и что они делают, итераторы могут быть проще для понимания. Вместо того, чтобы возиться с различными частями циклов и создания новых векторов, код фокусируется на высокоуровневой цели цикла. Это абстрагирует некоторый обыденный код, чтобы было легче увидеть концепции, уникальные для этого кода, такие как условие фильтрации, которое должен пройти каждый элемент итератора.
Но действительно ли две реализации эквивалентны? Интуитивное предположение может быть, что низкоуровневый цикл будет быстрее. Давайте поговорим о производительности.
Производительность: циклы против итераторов
Производительность: циклы против итераторов
Чтобы определить, использовать ли циклы или итераторы, нужно знать, какая
реализация быстрее: версия функции search с явным
циклом for или версия с итераторами.
Мы провели бенчмарк, загрузив всё содержимое «Приключений
Шерлока Холмса» сэра Артура Конан Дойла в String и выполнив поиск слова the в содержимом. Вот результаты бенчмарка для
версии search, использующей цикл for, и версии, использующей итераторы:
test bench_search_for ... bench: 19,620,300 ns/iter (+/- 915,700)
test bench_search_iter ... bench: 19,234,900 ns/iter (+/- 657,200)
Обе реализации имеют схожую производительность! Мы не будем объяснять код бенчмарка здесь, потому что цель не в том, чтобы доказать, что две версии эквивалентны, а в том, чтобы получить общее представление о том, как эти две реализации сравниваются по производительности.
Для более полного бенчмарка следует проверить использование различных текстов
различных размеров в качестве contents, разных слов и слов разной длины
в качестве query и всевозможных других вариаций. Суть в следующем:
итераторы, хотя и являются высокоуровневой абстракцией, компилируются в примерно
тот же код, как если бы вы написали низкоуровневый код самостоятельно. Итераторы — одна
из абстракций с нулевой стоимостью Rust, что означает, что использование абстракции
не накладывает дополнительных накладных расходов во время выполнения. Это аналогично тому, как
Бьярне Страуструп, первоначальный дизайнер и разработчик C++, определяет
нулевые накладные расходы в своей программной речи на ETAPS 2012 «Основы C++»:
В целом реализации C++ подчиняются принципу нулевых накладных расходов: то, что вы не используете, вы не оплачиваете. И более того: то, что вы используете, вы не могли бы написать вручную лучше.
Во многих случаях код Rust, использующий итераторы, компилируется в ту же сборку, которую вы бы написали вручную. Такие оптимизации, как развёртка циклов и устранение проверки границ при доступе к массивам, применяются и делают результирующий код чрезвычайно эффективным. Теперь, когда вы это знаете, вы можете использовать итераторы и замыкания без страха! Они делают код похожим на более высокоуровневый, но не накладывают штраф за производительность во время выполнения за это.
Итоги
Замыкания и итераторы — это функции Rust, вдохновлённые идеями функциональных языков программирования. Они способствуют способности Rust чётко выражать высокоуровневые идеи с низкоуровневой производительностью. Реализации замыканий и итераторов таковы, что производительность во время выполнения не страдает. Это часть цели Rust — стремиться предоставлять абстракции с нулевой стоимостью.
Теперь, когда мы улучшили выразительность нашего проекта ввода-вывода, давайте рассмотрим
некоторые дополнительные функции cargo, которые помогут нам поделиться проектом с
миром.
Подробнее о Cargo и Crates.io
Подробнее о Cargo и Crates.io
До сих пор мы использовали только самые базовые возможности Cargo для сборки, запуска и тестирования кода, но он умеет гораздо больше. В этой главе мы обсудим некоторые из его других, более продвинутых возможностей, чтобы показать, как делать следующее:
- Настраивать сборку с помощью профилей выпуска.
- Публиковать библиотеки на crates.io.
- Организовывать большие проекты с помощью рабочих пространств.
- Устанавливать бинарные файлы с crates.io.
- Расширять Cargo с помощью пользовательских команд.
Cargo умеет даже больше, чем функциональность, которую мы рассматриваем в этой главе, поэтому для полного объяснения всех его возможностей см. его документацию.
Настройка сборок с помощью профилей релиза
Настройка сборок с помощью профилей релиза
В Rust профили релиза — это предопределённые настраиваемые профили с различными конфигурациями, которые позволяют программисту получить больше контроля над различными параметрами компиляции кода. Каждый профиль настраивается независимо от других.
Cargo имеет два основных профиля: профиль dev, который Cargo использует при запуске cargo build, и профиль release, который Cargo использует при запуске cargo build --release. Профиль dev определён с хорошими значениями по умолчанию для разработки,
а профиль release имеет хорошие значения по умолчанию для релизных сборок.
Эти имена профилей могут быть знакомы по выводу ваших сборок:
$ cargo build
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.00s
$ cargo build --release
Finished `release` profile [optimized] target(s) in 0.32s
dev и release — это разные профили, используемые компилятором.
Cargo имеет настройки по умолчанию для каждого из профилей, которые применяются, когда вы явно не
добавили никаких секций [profile.*] в файл Cargo.toml проекта.
Добавляя секции [profile.*] для любого профиля, который хотите настроить, вы
переопределяете любое подмножество настроек по умолчанию. Например, вот значения по умолчанию
для параметра opt-level для профилей dev и release:
Имя файла: Cargo.toml
[profile.dev]
opt-level = 0
[profile.release]
opt-level = 3
Параметр opt-level управляет количеством оптимизаций, которые Rust применит к
вашему коду, в диапазоне от 0 до 3. Применение большего количества оптимизаций увеличивает
время компиляции, поэтому если вы находитесь в процессе разработки и часто компилируете код,
вам нужно меньше оптимизаций для более быстрой компиляции, даже если результирующий код
работает медленнее. Поэтому opt-level по умолчанию для dev равен 0. Когда вы
готовы выпустить код, лучше потратить больше времени на компиляцию. Вы будете
компилировать в режиме release только один раз, но запускать скомпилированную программу много раз,
поэтому режим release обменивает более длительное время компиляции на более быстрый код. Именно
поэтому opt-level по умолчанию для профиля release равен 3.
Вы можете переопределить настройку по умолчанию, добавив для неё другое значение в Cargo.toml. Например, если мы хотим использовать уровень оптимизации 1 в профиле разработки, мы можем добавить эти две строки в файл Cargo.toml нашего проекта:
Имя файла: Cargo.toml
[profile.dev]
opt-level = 1
Этот код переопределяет настройку по умолчанию 0. Теперь, когда мы запустим cargo build,
Cargo будет использовать значения по умолчанию для профиля dev плюс нашу настройку
opt-level. Поскольку мы установили opt-level в 1, Cargo применит больше
оптимизаций, чем по умолчанию, но не столько, сколько при релизной сборке.
Полный список параметров конфигурации и значений по умолчанию для каждого профиля см. в документации Cargo.
Публикация крейта на Crates.io
Публикация крейта на Crates.io
Мы использовали пакеты с crates.io в качестве зависимостей нашего проекта, но вы также можете делиться своим кодом с другими людьми, публикуя собственные пакеты. Реестр крейтов на crates.io распространяет исходный код ваших пакетов, поэтому в основном он размещает код с открытым исходным кодом.
Rust и Cargo имеют возможности, которые делают ваш опубликованный пакет более удобным для поиска и использования. Далее мы поговорим о некоторых из этих возможностей, а затем объясним, как опубликовать пакет.
Написание полезных комментариев документации
Точное документирование ваших пакетов поможет другим пользователям узнать, как и когда
их использовать, поэтому стоит потратить время на написание документации. В главе
3 мы обсуждали, как комментировать код на Rust с помощью двух косых черт, //. В Rust также есть
особый вид комментариев для документации, известный как
комментарий документации, который генерирует HTML-документацию. HTML
отображает содержимое комментариев документации для элементов публичного API, предназначенных
для программистов, интересующихся тем, как использовать ваш крейт, а не тем, как
ваш крейт реализован.
Комментарии документации используют три косые черты, ///, вместо двух и поддерживают
нотацию Markdown для форматирования текста. Размещайте комментарии документации непосредственно
перед элементом, который они документируют. В листинге 14-1 показаны комментарии документации
для функции add_one в крейте с именем my_crate.
/// Adds one to the number given.
///
/// # Examples
///
/// ```
/// let arg = 5;
/// let answer = my_crate::add_one(arg);
///
/// assert_eq!(6, answer);
/// ```
pub fn add_one(x: i32) -> i32 {
x + 1
}Здесь мы даём описание того, что делает функция add_one, начинаем
раздел с заголовком Examples, а затем предоставляем код, демонстрирующий,
как использовать функцию add_one. Мы можем сгенерировать HTML-документацию из
этого комментария документации, запустив cargo doc. Эта команда запускает
инструмент rustdoc, поставляемый с Rust, и помещает сгенерированную HTML-документацию
в каталог target/doc.
Для удобства запуск cargo doc --open соберёт HTML для документации
текущего крейта (а также документацию для всех
зависимостей вашего крейта) и откроет результат в веб-браузере. Перейдите к
функции add_one, и вы увидите, как отображается текст в комментариях документации,
как показано на рис. 14-1.
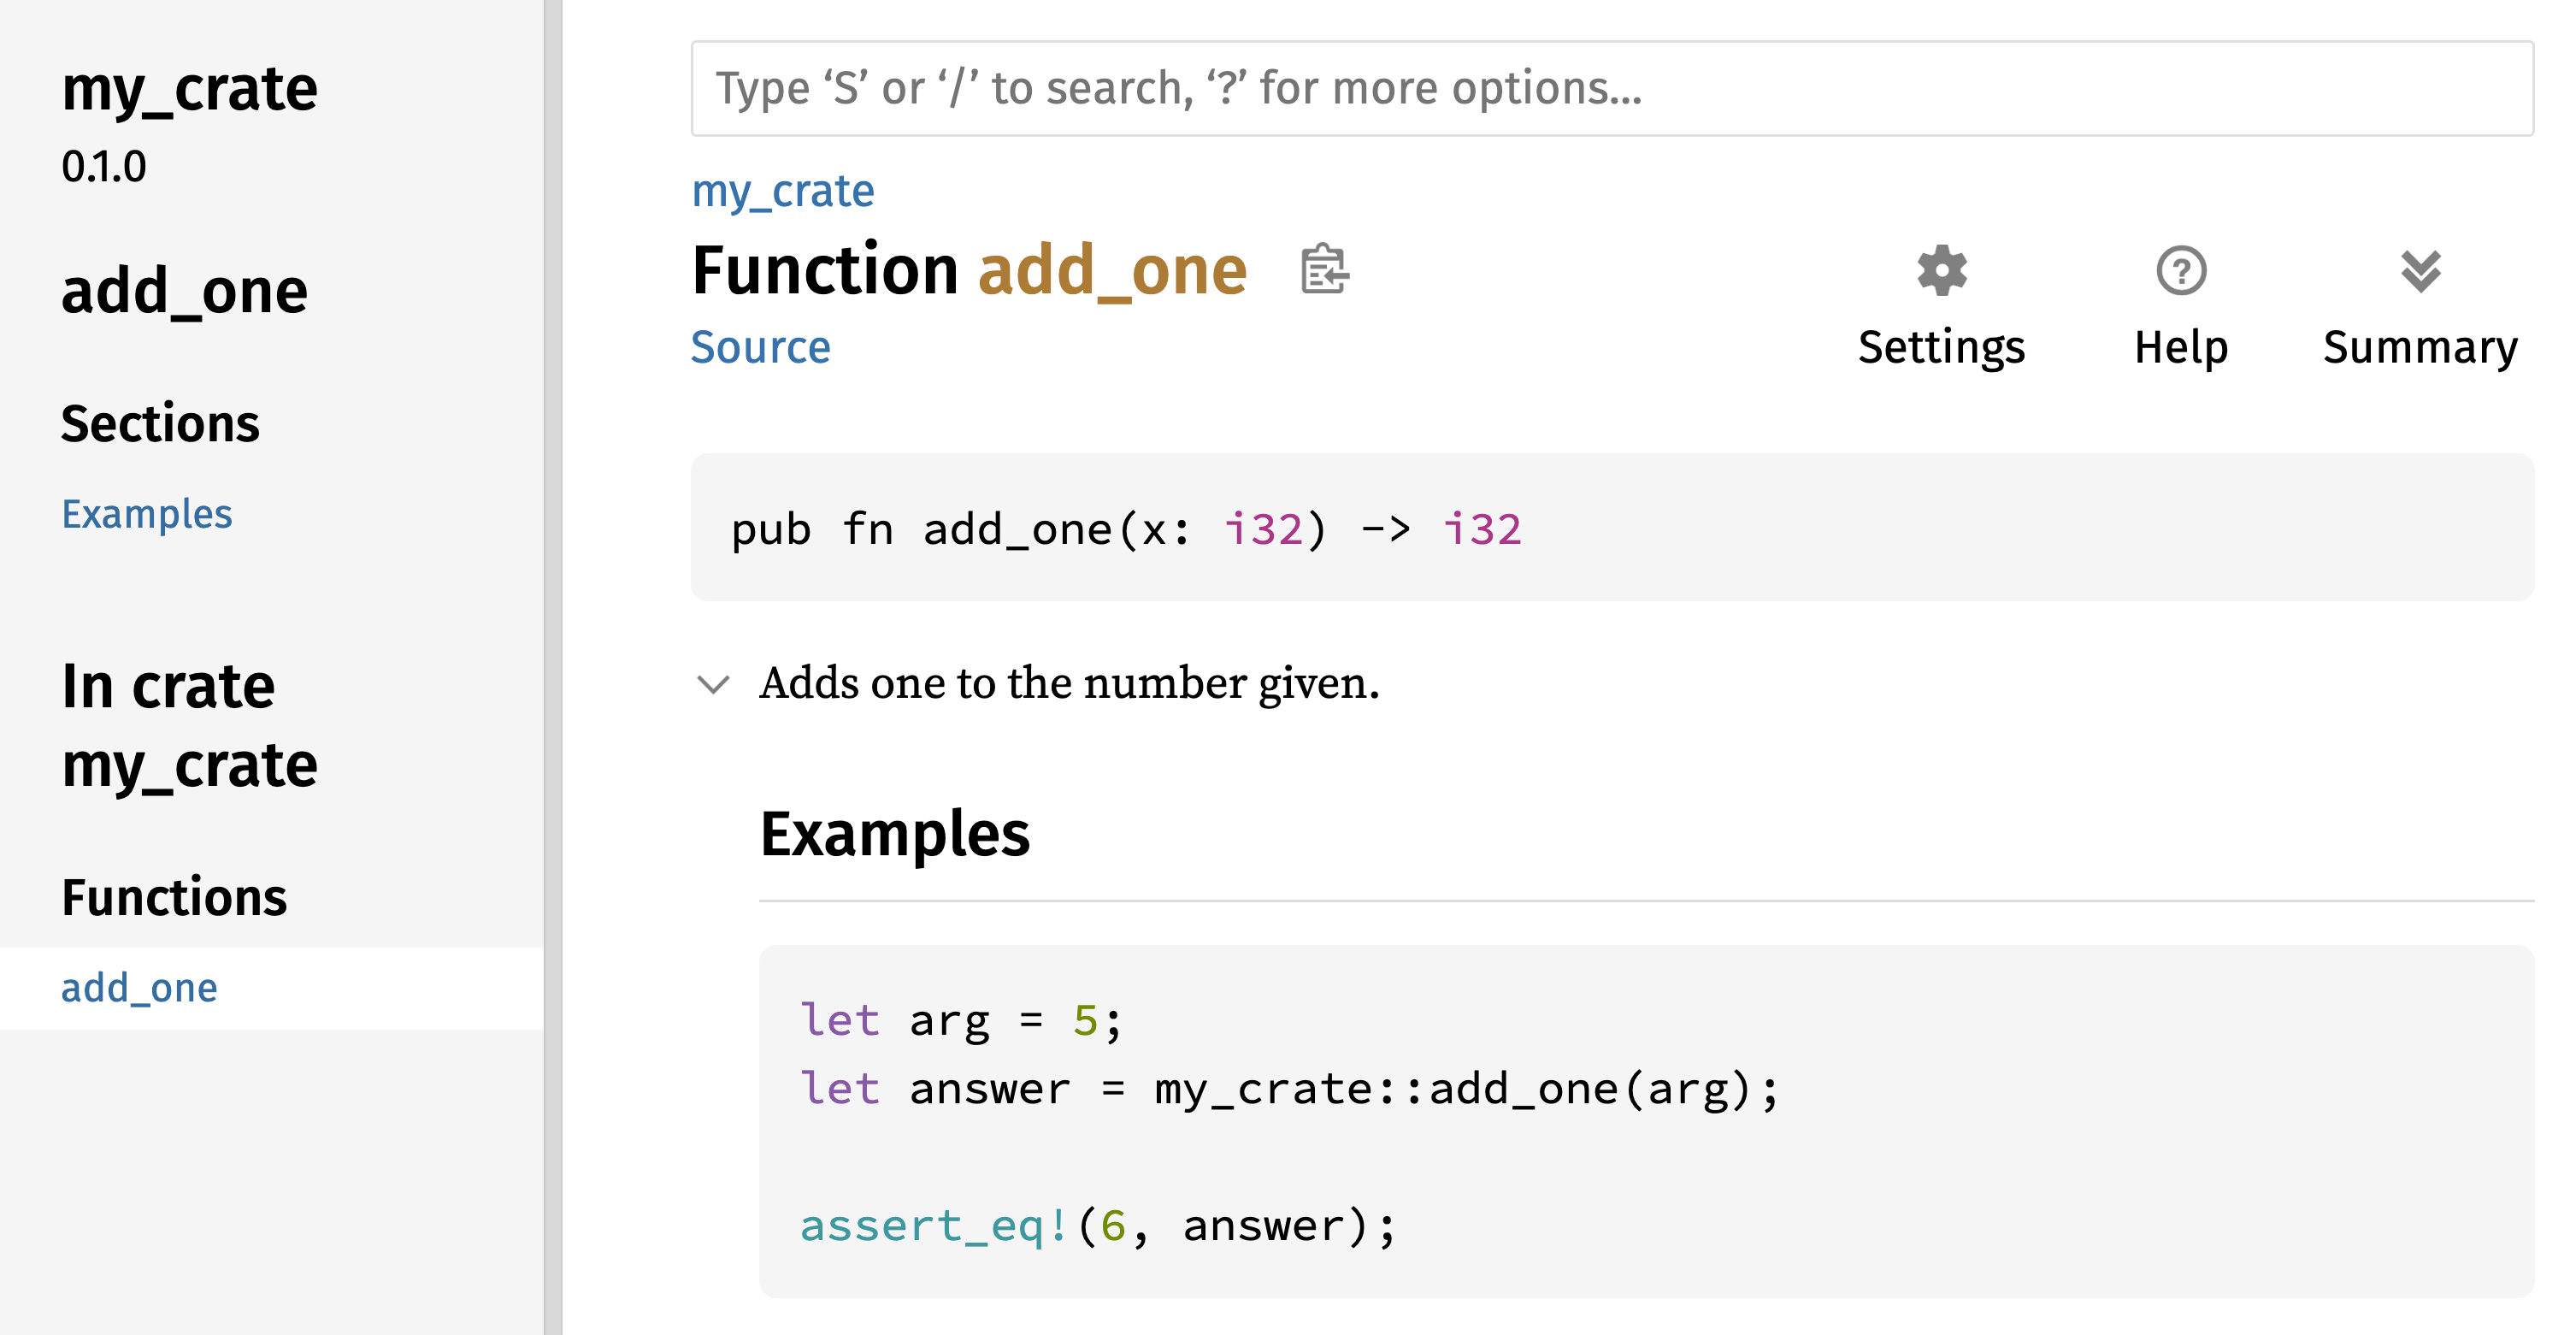
Рисунок 14-1: HTML-документация для функции add_one
Часто используемые разделы
Мы использовали заголовок Markdown # Examples в листинге 14-1, чтобы создать раздел
в HTML с заголовком «Examples». Вот некоторые другие разделы, которые авторы крейтов
обычно используют в своей документации:
- Panics: это сценарии, в которых документируемая функция может вызвать панику. Вызывающие функцию, которые не хотят, чтобы их программы паниковали, должны убедиться, что они не вызывают функцию в этих ситуациях.
- Errors: если функция возвращает
Result, описание видов ошибок, которые могут возникнуть, и условий, которые могут вызвать возврат этих ошибок, может быть полезно вызывающим, чтобы они могли написать код для обработки различных видов ошибок разными способами. - Safety: если функцию
unsafeвызывать (мы обсуждаем небезопасность в главе 20), должен быть раздел, объясняющий, почему функция небезопасна, и описывающий инварианты, которые функция ожидает от вызывающих.
Большинству комментариев документации не нужны все эти разделы, но это хороший контрольный список, напоминающий вам об аспектах вашего кода, которые будут интересны пользователям.
Комментарии документации как тесты
Добавление блоков примера кода в ваши комментарии документации может помочь продемонстрировать,
как использовать вашу библиотеку, и имеет дополнительный бонус: запуск cargo test
запустит примеры кода в вашей документации как тесты! Нет ничего лучше
документации с примерами. Но нет ничего хуже, чем примеры, которые не работают,
потому что код изменился с момента написания документации. Если мы запустим
cargo test с документацией для функции add_one из листинга
14-1, мы увидим в результатах тестов раздел, который выглядит так:
Doc-tests my_crate
running 1 test
test src/lib.rs - add_one (line 5) ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.27s
Теперь, если мы изменим функцию или пример так, что assert_eq!
в примере вызовет панику, и снова запустим cargo test, мы увидим, что doc-тесты
поймают, что пример и код рассинхронизированы друг с другом!
Комментарии содержащих элементов
Стиль doc-комментария //! добавляет документацию к элементу, который содержит
комментарии, а не к элементам, следующим за комментариями. Обычно
мы используем эти doc-комментарии внутри корневого файла крейта (src/lib.rs по соглашению)
или внутри модуля, чтобы документировать крейт или модуль целиком.
Например, чтобы добавить документацию, описывающую назначение крейта my_crate,
содержащего функцию add_one, мы добавляем комментарии документации, которые
начинаются с //!, в начало файла src/lib.rs, как показано в листинге
14-2.
//! # My Crate
//!
//! `my_crate` is a collection of utilities to make performing certain
//! calculations more convenient.
/// Adds one to the number given.
// --snip--
///
/// # Examples
///
/// ```
/// let arg = 5;
/// let answer = my_crate::add_one(arg);
///
/// assert_eq!(6, answer);
/// ```
pub fn add_one(x: i32) -> i32 {
x + 1
}my_crate в целомОбратите внимание, что после последней строки, начинающейся с //!, нет кода. Поскольку
мы начали комментарии с //!, а не с ///, мы документируем элемент,
который содержит этот комментарий, а не элемент, следующий за этим комментарием. В
этом случае этим элементом является файл src/lib.rs, который является корнем крейта. Эти
комментарии описывают весь крейт.
Когда мы запустим cargo doc --open, эти комментарии отобразятся на главной странице
документации для my_crate над списком публичных элементов в
крейте, как показано на рис. 14-2.
Комментарии документации внутри элементов особенно полезны для описания крейтов и модулей. Используйте их, чтобы объяснить общее назначение контейнера, чтобы помочь пользователям понять организацию крейта.
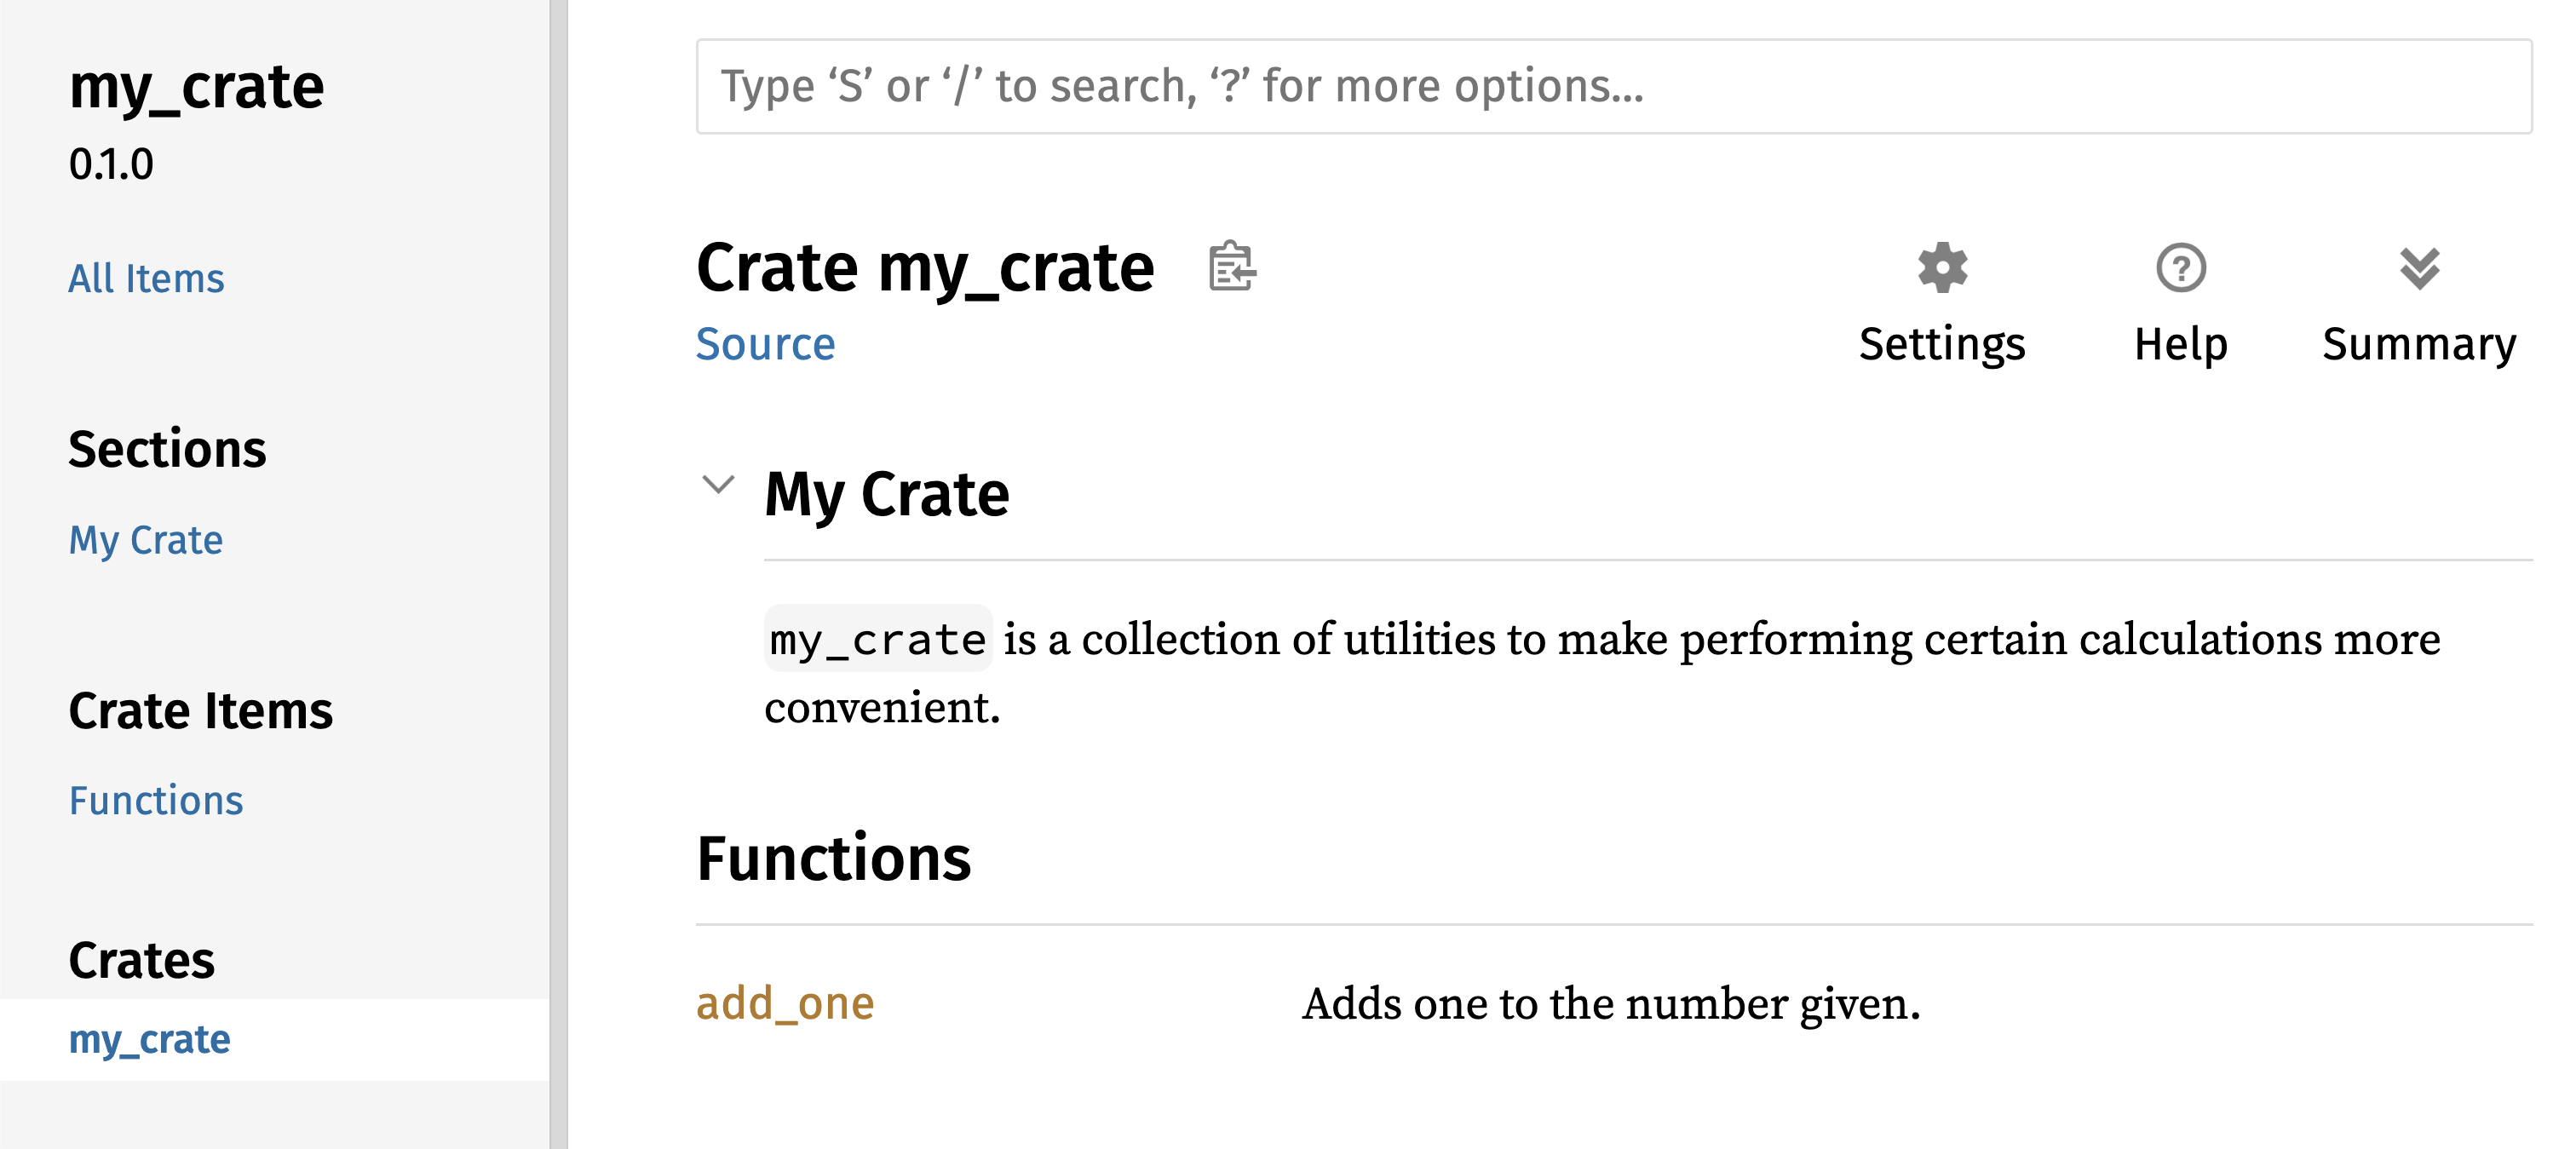
Рисунок 14-2: Отрисованная документация для my_crate,
включая комментарий, описывающий крейт в целом
Экспорт удобного публичного API
Структура вашего публичного API является важным соображением при публикации крейта. Люди, использующие ваш крейт, менее знакомы со структурой, чем вы, и могут испытывать трудности с поиском нужных им частей, если у вашего крейта большая иерархия модулей.
В главе 7 мы рассмотрели, как делать элементы публичными с помощью ключевого слова pub, и
как вводить элементы в область видимости с помощью ключевого слова use. Однако структура,
которая кажется вам логичной во время разработки крейта, может быть не очень
удобной для ваших пользователей. Вы можете захотеть организовать свои структуры в
иерархию, содержащую несколько уровней, но тогда люди, желающие использовать тип,
который вы определили глубоко в иерархии, могут испытывать трудности с обнаружением этого типа.
Их также может раздражать необходимость вводить use my_crate::some_module::another_module::UsefulType; вместо use my_crate::UsefulType;.
Хорошая новость в том, что если структура не удобна для использования другими
из другой библиотеки, вам не нужно перестраивать свою внутреннюю организацию:
вместо этого вы можете реэкспортировать элементы, чтобы создать публичную структуру, отличную
от вашей приватной структуры, используя pub use. Реэкспорт берёт публичный
элемент в одном месте и делает его публичным в другом месте, как если бы он был
определён в другом месте.
Например, скажем, мы создали библиотеку с именем art для моделирования художественных концепций.
Внутри этой библиотеки два модуля: модуль kinds, содержащий два перечисления
с именами PrimaryColor и SecondaryColor, и модуль utils, содержащий
функцию с именем mix, как показано в листинге 14-3.
//! # Art
//!
//! A library for modeling artistic concepts.
pub mod kinds {
/// The primary colors according to the RYB color model.
pub enum PrimaryColor {
Red,
Yellow,
Blue,
}
/// The secondary colors according to the RYB color model.
pub enum SecondaryColor {
Orange,
Green,
Purple,
}
}
pub mod utils {
use crate::kinds::*;
/// Combines two primary colors in equal amounts to create
/// a secondary color.
pub fn mix(c1: PrimaryColor, c2: PrimaryColor) -> SecondaryColor {
// --snip--
unimplemented!();
}
}art с элементами, организованными в модули kinds и utilsНа рис. 14-3 показано, как будет выглядеть главная страница документации для этого крейта,
сгенерированной cargo doc.
Рисунок 14-3: Главная страница документации для art,
на которой перечислены модули kinds и utils
Обратите внимание, что типы PrimaryColor и SecondaryColor не перечислены на
главной странице, как и функция mix. Нам нужно щёлкнуть kinds и utils, чтобы
увидеть их.
Другому крейту, который зависит от этой библиотеки, понадобятся операторы use, которые
вводят элементы из art в область видимости, с указанием структуры модулей,
которая сейчас определена. В листинге 14-4 показан пример крейта, который использует
элементы PrimaryColor и mix из крейта art.
use art::kinds::PrimaryColor;
use art::utils::mix;
fn main() {
let red = PrimaryColor::Red;
let yellow = PrimaryColor::Yellow;
mix(red, yellow);
}art с экспортированной внутренней структуройАвтору кода в листинге 14-4, который использует крейт art, пришлось
выяснить, что PrimaryColor находится в модуле kinds, а mix — в
модуле utils. Структура модулей крейта art более релевантна
разработчикам, работающим над крейтом art, чем тем, кто его использует. Внутренняя
структура не содержит никакой полезной информации для тех, кто пытается
понять, как использовать крейт art, а скорее вызывает путаницу, потому что
разработчикам, использующим его, приходится выяснять, где искать, и указывать
имена модулей в операторах use.
Чтобы убрать внутреннюю организацию из публичного API, мы можем изменить код
крейта art в листинге 14-3, добавив операторы pub use для реэкспорта
элементов на верхнем уровне, как показано в листинге 14-5.
//! # Art
//!
//! A library for modeling artistic concepts.
pub use self::kinds::PrimaryColor;
pub use self::kinds::SecondaryColor;
pub use self::utils::mix;
pub mod kinds {
// --snip--
/// The primary colors according to the RYB color model.
pub enum PrimaryColor {
Red,
Yellow,
Blue,
}
/// The secondary colors according to the RYB color model.
pub enum SecondaryColor {
Orange,
Green,
Purple,
}
}
pub mod utils {
// --snip--
use crate::kinds::*;
/// Combines two primary colors in equal amounts to create
/// a secondary color.
pub fn mix(c1: PrimaryColor, c2: PrimaryColor) -> SecondaryColor {
SecondaryColor::Orange
}
}pub use для реэкспорта элементовДокументация API, которую cargo doc генерирует для этого крейта, теперь будет перечислять
и ссылаться на реэкспорты на главной странице, как показано на рис. 14-4, что делает
типы PrimaryColor и SecondaryColor и функцию mix более удобными для поиска.
Рисунок 14-4: Главная страница документации для art,
на которой перечислены реэкспорты
Пользователи крейта art по-прежнему могут видеть и использовать внутреннюю структуру из листинга
14-3, как показано в листинге 14-4, или они могут использовать более удобную
структуру из листинга 14-5, как показано в листинге 14-6.
use art::PrimaryColor;
use art::mix;
fn main() {
// --snip--
let red = PrimaryColor::Red;
let yellow = PrimaryColor::Yellow;
mix(red, yellow);
}artВ случаях, когда есть много вложенных модулей, реэкспорт типов на верхнем
уровне с помощью pub use может существенно повлиять на опыт
людей, использующих крейт. Другое распространённое использование pub use — реэкспорт
определений зависимости в текущем крейте, чтобы сделать определения этого крейта
частью публичного API вашего крейта.
Создание полезной структуры публичного API — скорее искусство, чем наука, и вы
можете итеративно найти API, который лучше всего подходит для ваших пользователей. Выбор pub use
даёт вам гибкость в том, как вы структурируете свой крейт внутренне, и отделяет
эту внутреннюю структуру от того, что вы представляете пользователям. Посмотрите на некоторый
код установленных вами крейтов, чтобы увидеть, отличается ли их внутренняя структура
от их публичного API.
Настройка учётной записи на Crates.io
Прежде чем вы сможете публиковать какие-либо крейты, вам нужно создать учётную запись на
crates.io и получить API-токен. Для этого
посетите главную страницу crates.io и войдите
через учётную запись GitHub. (Учётная запись GitHub в настоящее время является требованием, но
сайт может поддерживать другие способы создания учётной записи в будущем.) После
входа посетите настройки своей учётной записи по адресу
https://crates.io/me/ и получите свой
API-ключ. Затем запустите команду cargo login и вставьте свой API-ключ, когда будет предложено, вот так:
$ cargo login
abcdefghijklmnopqrstuvwxyz012345
Эта команда сообщит Cargo ваш API-токен и сохранит его локально в ~/.cargo/credentials.toml. Обратите внимание, что этот токен является секретом: не делитесь им ни с кем. Если вы по какой-либо причине поделитесь им с кем-либо, вам следует отозвать его и сгенерировать новый токен на crates.io.
Добавление метаданных в новый крейт
Скажем, у вас есть крейт, который вы хотите опубликовать. Перед публикацией вам нужно
будет добавить некоторые метаданные в секцию [package] файла Cargo.toml
крейта.
Вашему крейту понадобится уникальное имя. Пока вы работаете над крейтом локально,
вы можете назвать крейт как угодно. Однако имена крейтов на
crates.io распределяются по принципу «первым пришёл — первым обслужен».
Как только имя крейта занято, никто больше не может опубликовать крейт
с таким именем. Перед попыткой опубликовать крейт поищите имя, которое
хотите использовать. Если имя уже использовалось, вам нужно будет найти другое имя и
отредактировать поле name в файле Cargo.toml в секции [package], чтобы
использовать новое имя для публикации, вот так:
Имя файла: Cargo.toml
[package]
name = "guessing_game"
Даже если вы выбрали уникальное имя, когда вы запустите cargo publish, чтобы опубликовать
крейт на этом этапе, вы получите предупреждение, а затем ошибку:
$ cargo publish
Updating crates.io index
warning: manifest has no description, license, license-file, documentation, homepage or repository.
See https://doc.rust-lang.org/cargo/reference/manifest.html#package-metadata for more info.
--snip--
error: failed to publish to registry at https://crates.io
Caused by:
the remote server responded with an error (status 400 Bad Request): missing or empty metadata fields: description, license. Please see https://doc.rust-lang.org/cargo/reference/manifest.html for more information on configuring these fields
Это приводит к ошибке, потому что вам не хватает некоторой важной информации: требуются
описание и лицензия, чтобы люди знали, что делает ваш крейт
и на каких условиях они могут его использовать. В Cargo.toml добавьте описание,
состоящее всего из одного-двух предложений, потому что оно будет отображаться с вашим крейтом в результатах
поиска. Для поля license вам нужно указать значение идентификатора
лицензии. Software Package Data Exchange (SPDX) Linux Foundation
перечисляет идентификаторы, которые вы можете использовать для этого значения. Например, чтобы указать, что
вы лицензировали свой крейт по лицензии MIT, добавьте идентификатор MIT:
Имя файла: Cargo.toml
[package]
name = "guessing_game"
license = "MIT"
Если вы хотите использовать лицензию, которой нет в SPDX, вам нужно поместить
текст этой лицензии в файл, включить файл в свой проект, а затем
использовать license-file для указания имени этого файла вместо использования
ключа license.
Рекомендации о том, какая лицензия подходит для вашего проекта, выходят за рамки
этой книги. Многие люди в сообществе Rust лицензируют свои проекты так же,
как Rust, используя двойную лицензию MIT OR Apache-2.0. Эта практика
демонстрирует, что вы также можете указать несколько идентификаторов лицензий, разделённых
OR, чтобы иметь несколько лицензий для вашего проекта.
С уникальным именем, версией, вашим описанием и добавленной лицензией файл Cargo.toml для проекта, готового к публикации, может выглядеть так:
Имя файла: Cargo.toml
[package]
name = "guessing_game"
version = "0.1.0"
edition = "2024"
description = "A fun game where you guess what number the computer has chosen."
license = "MIT OR Apache-2.0"
[dependencies]
Документация Cargo описывает другие метаданные, которые вы можете указать, чтобы другие могли обнаружить и использовать ваш крейт более легко.
Публикация на Crates.io
Теперь, когда вы создали учётную запись, сохранили свой API-токен, выбрали имя для своего крейта и указали необходимые метаданные, вы готовы к публикации! Публикация крейта загружает определённую версию на crates.io для использования другими.
Будьте осторожны, потому что публикация постоянна. Версия никогда не может быть перезаписана, и код не может быть удалён, кроме определённых обстоятельств. Одна из главных целей Crates.io — служить постоянным архивом кода, чтобы сборки всех проектов, зависящих от крейтов с crates.io, продолжали работать. Разрешение удаления версий сделало бы достижение этой цели невозможным. Однако нет ограничений на количество версий крейта, которые вы можете опубликовать.
Снова запустите команду cargo publish. Теперь она должна успешно выполниться:
$ cargo publish
Updating crates.io index
Packaging guessing_game v0.1.0 (file:///projects/guessing_game)
Packaged 6 files, 1.2KiB (895.0B compressed)
Verifying guessing_game v0.1.0 (file:///projects/guessing_game)
Compiling guessing_game v0.1.0
(file:///projects/guessing_game/target/package/guessing_game-0.1.0)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.19s
Uploading guessing_game v0.1.0 (file:///projects/guessing_game)
Uploaded guessing_game v0.1.0 to registry `crates-io`
note: waiting for `guessing_game v0.1.0` to be available at registry
`crates-io`.
You may press ctrl-c to skip waiting; the crate should be available shortly.
Published guessing_game v0.1.0 at registry `crates-io`
Поздравляем! Теперь вы поделились своим кодом с сообществом Rust, и любой может легко добавить ваш крейт в качестве зависимости своего проекта.
Публикация новой версии существующего крейта
Когда вы внесли изменения в свой крейт и готовы выпустить новую версию,
вы меняете значение version, указанное в вашем файле Cargo.toml, и
публикуете заново. Используйте правила семантического версионирования, чтобы решить, какой
следующий номер версии уместен, исходя из типов внесённых вами изменений.
Затем запустите cargo publish, чтобы загрузить новую версию.
Устаревание версий на Crates.io
Хотя вы не можете удалить предыдущие версии крейта, вы можете предотвратить добавление их в качестве новой зависимости будущими проектами. Это полезно, когда версия крейта по той или иной причине сломана. В таких ситуациях Cargo поддерживает отзыв (yanking) версии крейта.
Отзыв версии предотвращает зависимость новых проектов от этой версии, при этом позволяя всем существующим проектам, которые от неё зависят, продолжать работу. По сути, отзыв означает, что все проекты с Cargo.lock не сломаются, и любые будущие Cargo.lock не будут использовать отозванную версию.
Чтобы отозвать версию крейта, в каталоге крейта, который вы
ранее опубликовали, запустите cargo yank и укажите, какую версию вы хотите
отозвать. Например, если мы опубликовали крейт с именем guessing_game версии
1.0.1 и хотим его отозвать, мы запустим следующее в каталоге проекта
guessing_game:
$ cargo yank --vers 1.0.1
Updating crates.io index
Yank guessing_game@1.0.1
Добавив --undo к команде, вы также можете отменить отзыв и позволить проектам
снова начать зависеть от версии:
$ cargo yank --vers 1.0.1 --undo
Updating crates.io index
Unyank guessing_game@1.0.1
Отзыв не удаляет какой-либо код. Он не может, например, удалить случайно загруженные секреты. Если это произойдёт, вы должны немедленно сбросить эти секреты.
Рабочие пространства Cargo
Рабочие пространства Cargo
В главе 12 мы создали пакет, включавший бинарный крейт и библиотечный крейт. По мере развития проекта вы можете обнаружить, что библиотечный крейт продолжает расти, и вам захочется разделить пакет дальше на несколько библиотечных крейтов. Cargo предлагает функцию под названием рабочие пространства, которая может помочь управлять несколькими связанными пакетами, разрабатываемыми совместно.
Создание рабочего пространства
Рабочее пространство — это набор пакетов, которые используют общий файл Cargo.lock и общий
выходной каталог. Давайте создадим проект с использованием рабочего пространства — мы будем использовать тривиальный код, чтобы
можно было сосредоточиться на структуре рабочего пространства. Есть несколько
способов структурировать рабочее пространство, поэтому мы просто покажем один распространённый способ. У нас будет
рабочее пространство, содержащее бинарный крейт и две библиотеки. Бинарный крейт, который будет предоставлять
основную функциональность, будет зависеть от двух библиотек. Одна библиотека будет
предоставлять функцию add_one, а другая библиотека — функцию add_two.
Эти три крейта будут частью одного рабочего пространства. Мы начнём с создания
нового каталога для рабочего пространства:
$ mkdir add
$ cd add
Затем в каталоге add мы создаём файл Cargo.toml, который будет
настраивать всё рабочее пространство. В этом файле не будет раздела [package].
Вместо этого он начнётся с раздела [workspace], который позволит нам добавлять
члены в рабочее пространство. Мы также обратим внимание на использование последней и наилучшей
версии алгоритма разрешения зависимостей Cargo в нашем рабочем пространстве, установив
значение resolver в "3":
Имя файла: Cargo.toml
[workspace]
resolver = "3"
Затем мы создадим бинарный крейт adder, запустив cargo new в каталоге
add:
$ cargo new adder
Created binary (application) `adder` package
Adding `adder` as member of workspace at `file:///projects/add`
Запуск cargo new внутри рабочего пространства также автоматически добавляет только что созданный
пакет в ключ members в определении [workspace] в файле рабочего пространства
Cargo.toml, вот так:
[workspace]
resolver = "3"
members = ["adder"]
На этом этапе мы можем собрать рабочее пространство, запустив cargo build. Файлы
в вашем каталоге add должны выглядеть так:
├── Cargo.lock
├── Cargo.toml
├── adder
│ ├── Cargo.toml
│ └── src
│ └── main.rs
└── target
В рабочем пространстве есть один каталог target на верхнем уровне, в который будут помещаться скомпилированные
артефакты; у пакета adder нет собственного
каталога target. Даже если бы мы запустили cargo build изнутри
каталога adder, скомпилированные артефакты всё равно оказались бы в add/target,
а не в add/adder/target. Cargo структурирует каталог target в
рабочем пространстве таким образом, потому что крейты в рабочем пространстве предназначены для того, чтобы зависеть друг от
друга. Если бы каждый крейт имел собственный каталог target, каждый крейт пришлось бы
перекомпилировать каждый из других крейтов в рабочем пространстве, чтобы поместить артефакты
в собственный каталог target. Благодаря общему каталогу target крейты
могут избежать ненужной пересборки.
Создание второго пакета в рабочем пространстве
Затем создадим ещё один член-пакет в рабочем пространстве и назовём его
add_one. Создайте новый библиотечный крейт с именем add_one:
$ cargo new add_one --lib
Created library `add_one` package
Adding `add_one` as member of workspace at `file:///projects/add`
Теперь верхний файл Cargo.toml будет включать путь add_one в списке members:
Имя файла: Cargo.toml
[workspace]
resolver = "3"
members = ["adder", "add_one"]
Теперь в вашем каталоге add должны быть следующие каталоги и файлы:
├── Cargo.lock
├── Cargo.toml
├── add_one
│ ├── Cargo.toml
│ └── src
│ └── lib.rs
├── adder
│ ├── Cargo.toml
│ └── src
│ └── main.rs
└── target
В файле add_one/src/lib.rs давайте добавим функцию add_one:
Имя файла: add_one/src/lib.rs
pub fn add_one(x: i32) -> i32 {
x + 1
}Теперь мы можем заставить пакет adder с нашим бинарным крейтом зависеть от пакета add_one,
содержащего нашу библиотеку. Сначала нам нужно добавить зависимость по пути
add_one в adder/Cargo.toml.
Имя файла: adder/Cargo.toml
[dependencies]
add_one = { path = "../add_one" }
Cargo не предполагает, что крейты в рабочем пространстве будут зависеть друг от друга, поэтому нам нужно явно указать отношения зависимости.
Затем давайте использовать функцию add_one (из крейта add_one) в
крейте adder. Откройте файл adder/src/main.rs и измените функцию main,
чтобы она вызывала функцию add_one, как в листинге 14-7.
fn main() {
let num = 10;
println!("Hello, world! {num} plus one is {}!", add_one::add_one(num));
}add_one из крейта adderДавайте соберём рабочее пространство, запустив cargo build в верхнем каталоге add!
$ cargo build
Compiling add_one v0.1.0 (file:///projects/add/add_one)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.22s
Чтобы запустить бинарный крейт из каталога add, мы можем указать, какой пакет
в рабочем пространстве мы хотим запустить, используя аргумент -p и имя пакета
с помощью cargo run:
$ cargo run -p adder
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.00s
Running `target/debug/adder`
Hello, world! 10 plus one is 11!
Это запускает код в adder/src/main.rs, который зависит от крейта add_one.
Зависимость от внешнего пакета
Обратите внимание, что в рабочем пространстве есть только один файл Cargo.lock на верхнем уровне,
а не по одному Cargo.lock в каталоге каждого крейта. Это гарантирует, что
все крейты используют одну и ту же версию всех зависимостей. Если мы добавим пакет rand
в файлы adder/Cargo.toml и add_one/Cargo.toml, Cargo
разрешит обе эти зависимости в одну версию rand и запишет это в единственный
Cargo.lock. Использование всеми крейтами рабочего пространства одних и тех же зависимостей
означает, что крейты всегда будут совместимы друг с другом. Давайте добавим
крейт rand в раздел [dependencies] файла add_one/Cargo.toml,
чтобы можно было использовать крейт rand в крейте add_one:
Имя файла: add_one/Cargo.toml
[dependencies]
rand = "0.10.1"
Теперь мы можем добавить use rand; в файл add_one/src/lib.rs, и сборка
всего рабочего пространства путём запуска cargo build в каталоге add приведёт к загрузке
и компиляции крейта rand. Мы получим одно предупреждение, потому что мы не
ссылаемся на rand, который мы ввели в область видимости:
$ cargo build
Updating crates.io index
Downloaded rand v0.10.1
--snip--
Compiling rand v0.10.1
Compiling add_one v0.1.0 (file:///projects/add/add_one)
warning: unused import: `rand`
--> add_one/src/lib.rs:1:5
|
1 | use rand;
| ^^^^
|
= note: `#[warn(unused_imports)]` (part of `#[warn(unused)]`) on by default
warning: `add_one` (lib) generated 1 warning (run `cargo fix --lib -p add_one` to apply 1 suggestion)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.95s
Теперь верхний файл Cargo.lock содержит информацию о зависимости
add_one от rand. Однако, даже если rand используется где-то в
рабочем пространстве, мы не можем использовать его в других крейтах рабочего пространства, если не добавим
rand в их файлы Cargo.toml тоже. Например, если мы добавим use rand;
в файл adder/src/main.rs для пакета adder, мы получим ошибку:
$ cargo build
--snip--
Compiling adder v0.1.0 (file:///projects/add/adder)
error[E0432]: unresolved import `rand`
--> adder/src/main.rs:2:5
|
2 | use rand;
| ^^^^ no external crate `rand`
Чтобы исправить это, отредактируйте файл Cargo.toml пакета adder и укажите,
что rand также является для него зависимостью. Сборка пакета adder добавит
rand в список зависимостей для adder в Cargo.lock, но никакие
дополнительные копии rand не будут загружены. Cargo гарантирует, что каждый
крейт в каждом пакете рабочего пространства, использующий пакет rand, будет использовать
ту же версию, пока они указывают совместимые версии rand, экономя нам
место и гарантируя, что крейты рабочего пространства будут совместимы друг с
другом.
Если крейты в рабочем пространстве указывают несовместимые версии одной и той же зависимости, Cargo разрешит каждую из них, но всё равно попытается разрешить как можно меньше версий.
Добавление теста в рабочее пространство
В качестве ещё одного улучшения давайте добавим тест для функции add_one::add_one
внутри крейта add_one:
Имя файла: add_one/src/lib.rs
pub fn add_one(x: i32) -> i32 {
x + 1
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
assert_eq!(3, add_one(2));
}
}Теперь запустите cargo test в верхнем каталоге add. Запуск cargo test в
рабочем пространстве, структурированном таким образом, запустит тесты для всех крейтов в
рабочем пространстве:
$ cargo test
Compiling add_one v0.1.0 (file:///projects/add/add_one)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.20s
Running unittests src/lib.rs (target/debug/deps/add_one-93c49ee75dc46543)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/adder-3a47283c568d2b6a)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests add_one
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Первый раздел вывода показывает, что тест it_works в крейте add_one
прошёл. Следующий раздел показывает, что в крейте adder не найдено ни одного теста,
а затем последний раздел показывает, что документационные тесты в
крейте add_one не найдены.
Мы также можем запускать тесты для одного конкретного крейта в рабочем пространстве из
верхнего каталога, используя флаг -p и указывая имя крейта,
который мы хотим протестировать:
$ cargo test -p add_one
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.00s
Running unittests src/lib.rs (target/debug/deps/add_one-93c49ee75dc46543)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests add_one
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Этот вывод показывает, что cargo test запустил тесты только для крейта add_one и
не запускал тесты крейта adder.
Если вы публикуете крейты из рабочего пространства на
crates.io, каждый крейт в рабочем пространстве
потребуется публиковать отдельно. Как и cargo test, мы можем опубликовать
конкретный крейт в нашем рабочем пространстве, используя флаг -p и указывая
имя крейта, который хотим опубликовать.
Для дополнительной практики добавьте крейт add_two в это рабочее пространство аналогичным
образом, как крейт add_one!
По мере роста проекта рассмотрите возможность использования рабочего пространства: оно позволяет работать с меньшими, более простыми для понимания компонентами, чем один большой блок кода. Кроме того, хранение крейтов в рабочем пространстве может упростить координацию между крейтами, если они часто изменяются одновременно.
Установка бинарных файлов с помощью cargo install
Установка бинарных файлов с помощью cargo install
Команда cargo install позволяет вам устанавливать и использовать
бинарные крейты локально. Она не предназначена для замены системных
пакетов; она задумана как удобный способ для разработчиков Rust
устанавливать инструменты, которыми другие поделились на
crates.io. Обратите внимание, что вы
можете устанавливать только пакеты, у которых есть бинарные цели.
Бинарная цель — это исполняемая программа, которая создаётся, если
крейт имеет файл src/main.rs или другой файл, указанный как бинарный, в
отличие от библиотечной цели, которая не является исполняемой сама по себе,
но подходит для включения в другие программы. Обычно крейты содержат
информацию в файле README о том, является ли крейт библиотекой, имеет
бинарную цель или и то, и другое.
Все бинарные файлы, установленные с помощью cargo install, хранятся в
папке bin корневого каталога установки. Если вы установили Rust с
помощью rustup.rs и не имеете никаких пользовательских конфигураций,
этот каталог будет $HOME/.cargo/bin. Убедитесь, что этот каталог
находится в вашем $PATH, чтобы иметь возможность запускать программы,
которые вы установили с помощью cargo install.
Например, в главе 12 мы упоминали, что существует реализация инструмента
grep на Rust под названием ripgrep для поиска в файлах. Чтобы
установить ripgrep, мы можем выполнить следующее:
$ cargo install ripgrep
Updating crates.io index
Downloaded ripgrep v14.1.1
Downloaded 1 crate (213.6 KB) in 0.40s
Installing ripgrep v14.1.1
--snip--
Compiling grep v0.3.2
Finished `release` profile [optimized + debuginfo] target(s) in 6.73s
Installing ~/.cargo/bin/rg
Installed package `ripgrep v14.1.1` (executable `rg`)
Предпоследняя строка вывода показывает расположение и имя установленного
бинарного файла, который в случае ripgrep — это rg. Пока каталог
установки находится в вашем $PATH, как упоминалось ранее, вы можете
запустить rg --help и начать использовать более быстрый, более
«растовый» инструмент для поиска в файлах!
Расширение Cargo пользовательскими командами
Расширение Cargo пользовательскими командами
Cargo спроектирован так, что его можно расширять новыми подкомандами, не
изменяя сам Cargo. Если бинарный файл в $PATH называется cargo-something, его можно
запустить, как если бы это была подкоманда Cargo, выполнив cargo something. Такие пользовательские
команды также отображаются при запуске cargo --list. Возможность
использовать cargo install для установки расширений и затем запускать их так же, как
встроенные инструменты Cargo, — очень удобное преимущество дизайна Cargo!
Итоги
Обмен кодом с помощью Cargo и crates.io — это часть того, что делает экосистему Rust полезной для многих различных задач. Стандартная библиотека Rust невелика и стабильна, но крейты легко делиться, использовать и улучшать по графику, отличному от графика развития языка. Не стесняйтесь делиться полезным для вас кодом на crates.io; вполне вероятно, что он будет полезен и кому-то другому!
Умные указатели
Умные указатели
Указатель — это общее понятие для переменной, содержащей адрес в
памяти. Этот адрес ссылается на некоторые другие данные, или «указывает на» них. Наиболее
распространённый вид указателя в Rust — это ссылка, о которой вы узнали в
главе 4. Ссылки обозначаются символом & и заимствуют значение, на которое
они указывают. Они не имеют никаких особых возможностей, кроме ссылки на
данные, и не имеют накладных расходов.
Умные указатели, с другой стороны, — это структуры данных, которые ведут себя как указатель, но также имеют дополнительные метаданные и возможности. Понятие умных указателей не уникально для Rust: умные указатели возникли в C++ и существуют в других языках тоже. В Rust есть множество умных указателей, определённых в стандартной библиотеке, которые предоставляют функциональность сверх той, что предоставляют ссылки. Чтобы исследовать общую концепцию, мы рассмотрим пару разных примеров умных указателей, включая тип умного указателя с подсчётом ссылок. Этот указатель позволяет разрешить данным иметь несколько владельцев, отслеживая количество владельцев и очищая данные, когда не остаётся ни одного владельца.
В Rust с его концепцией владения и заимствования есть дополнительное различие между ссылками и умными указателями: в то время как ссылки только заимствуют данные, во многих случаях умные указатели владеют данными, на которые они указывают.
Умные указатели обычно реализуются с помощью структур. В отличие от обычной
структуры, умные указатели реализуют трейты Deref и Drop. Трейт Deref
позволяет экземпляру структуры умного указателя вести себя как ссылка,
так что можно писать код, работающий как со ссылками, так и с умными
указателями. Трейт Drop позволяет настроить код, который выполняется, когда
экземпляр умного указателя выходит из области видимости. В этой главе мы обсудим
оба этих трейта и продемонстрируем, почему они важны для умных указателей.
Учитывая, что паттерн умного указателя — это общий паттерн проектирования, часто используемый в Rust, эта глава не будет охватывать все существующие умные указатели. Многие библиотеки имеют собственные умные указатели, и вы даже можете написать свои. Мы рассмотрим наиболее распространённые умные указатели в стандартной библиотеке:
Box<T>для размещения значений в кучеRc<T>, тип с подсчётом ссылок, который позволяет несколько владельцевRef<T>иRefMut<T>, доступ к которым осуществляется черезRefCell<T>, тип, который обеспечивает соблюдение правил заимствования во время выполнения вместо времени компиляции
Кроме того, мы рассмотрим паттерн внутренней изменяемости, где неизменяемый тип предоставляет API для изменения внутреннего значения. Мы также обсудим циклы ссылок: как они могут приводить к утечкам памяти и как их предотвратить.
Давайте погрузимся!
Использование Box<T> для указания на данные в куче
Использование Box<T> для указания на данные в куче
Самый простой умный указатель — это бокс, тип которого записывается
как Box<T>. Боксы позволяют хранить данные в куче, а не в стеке.
Что остаётся в стеке — это указатель на данные в куче. Обратитесь к главе 4,
чтобы вспомнить разницу между стеком и кучей.
Боксы не имеют накладных расходов на производительность, кроме хранения своих данных в куче, а не в стеке. Но у них также нет многих дополнительных возможностей. Вы будете использовать их чаще всего в этих ситуациях:
- Когда у вас есть тип, размер которого не может быть известен во время компиляции, и вы хотите использовать значение этого типа в контексте, требующем точного размера
- Когда у вас есть большой объём данных и вы хотите передать владение, но гарантировать, что данные не будут скопированы при этом
- Когда вы хотите владеть значением и вас заботит только то, что это тип, реализующий определённый трейт, а не конкретный тип
Мы продемонстрируем первую ситуацию в «Включение рекурсивных типов с помощью боксов». Во второй случае передача владения большим объёмом данных может занять много времени, потому что данные копируются в стеке. Чтобы улучшить производительность в этой ситуации, мы можем сохранить большой объём данных в куче в боксе. Затем только небольшой объём данных указателя копируется в стеке, в то время как данные, на которые он ссылается, остаются на одном месте в куче. Третий случай известен как трейт-объект, и «Использование трейт-объектов для абстрагирования над общим поведением» в главе 18 посвящена этой теме. Так что то, что вы узнаете здесь, вы примените снова в том разделе!
Хранение данных в куче
Прежде чем мы обсудим вариант использования Box<T> для хранения в куче, мы рассмотрим
синтаксис и то, как взаимодействовать со значениями, хранящимися внутри Box<T>.
Листинг 15-1 показывает, как использовать бокс для хранения значения i32 в куче.
fn main() {
let b = Box::new(5);
println!("b = {b}");
}i32 в куче с помощью боксаМы определяем переменную b со значением Box, которое указывает на
значение 5, размещённое в куче. Эта программа напечатает b = 5; в
этом случае мы можем получить доступ к данным в боксе аналогично тому, как мы бы это делали, если бы эти
данные были в стеке. Как и любое принадлежащее значение, когда бокс выходит из
области видимости, как b в конце main, он будет освобождён.
Освобождение происходит как для бокса (хранящегося в стеке), так и для данных, на которые
он указывает (хранящихся в куче).
Помещение одного значения в кучу не очень полезно, поэтому вы не будете использовать боксы
сами по себе таким образом очень часто. Наличие значений, таких как один i32,
в стеке, где они хранятся по умолчанию, более уместно в большинстве
ситуаций. Давайте рассмотрим случай, когда боксы позволяют нам определять типы, которые мы
не могли бы определить, если бы у нас не было боксов.
Включение рекурсивных типов с помощью боксов
Значение рекурсивного типа может иметь другое значение того же типа как часть себя. Рекурсивные типы создают проблему, потому что Rust нужно знать во время компиляции, сколько места занимает тип. Однако вложенность значений рекурсивных типов теоретически может продолжаться бесконечно, поэтому Rust не может знать, сколько места нужно значению. Поскольку боксы имеют известный размер, мы можем включить рекурсивные типы, вставив бокс в определение рекурсивного типа.
В качестве примера рекурсивного типа давайте исследуем cons-список. Это тип данных, обычно встречающийся в функциональных языках программирования. Тип cons-списка, который мы определим, прост, за исключением рекурсии; поэтому концепции в примере, с которым мы будем работать, будут полезны всякий раз, когда вы столкнётесь с более сложными ситуациями, связанными с рекурсивными типами.
Понимание cons-списка
Cons-список — это структура данных, происходящая из языка программирования Lisp
и его диалектов, состоящая из вложенных пар, и является версией связного списка в Lisp.
Его название происходит от функции cons (сокращение от construct
function) в Lisp, которая создаёт новую пару из двух своих аргументов. Вызывая cons
на паре, состоящей из значения и другой пары, мы можем
построить cons-списки, состоящие из рекурсивных пар.
Например, вот псевдокодовое представление cons-списка, содержащего
список 1, 2, 3, где каждая пара в скобках:
(1, (2, (3, Nil)))
Каждый элемент в cons-списке содержит два элемента: значение текущего элемента
и следующего элемента. Последний элемент в списке содержит только значение под названием
Nil без следующего элемента. Cons-список создаётся путём рекурсивного вызова функции
cons. Каноническое имя для обозначения базового случая рекурсии — Nil.
Обратите внимание, что это не то же самое, что понятие «null» или «nil», обсуждавшееся
в главе 6, которое является недопустимым или отсутствующим значением.
Cons-список не является часто используемой структурой данных в Rust. В большинстве случаев,
когда у вас есть список элементов в Rust, Vec<T> — лучший выбор для использования.
Другие, более сложные рекурсивные типы данных являются полезными в различных ситуациях,
но начав с cons-списка в этой главе, мы можем исследовать, как боксы
позволяют нам определить рекурсивный тип данных без особых отвлечений.
Листинг 15-2 содержит определение перечисления для cons-списка. Обратите внимание, что этот код
пока не скомпилируется, потому что тип List не имеет известного размера, что
мы продемонстрируем.
enum List {
Cons(i32, List),
Nil,
}
fn main() {}i32Примечание: мы реализуем cons-список, который содержит только значения i32, для
целей этого примера. Мы могли бы реализовать его с использованием обобщённых типов, как мы
обсуждали в главе 10, чтобы определить тип cons-списка, который мог бы хранить значения
любого типа.
Использование типа List для хранения списка 1, 2, 3 выглядело бы как код в
листинге 15-3.
enum List {
Cons(i32, List),
Nil,
}
// --snip--
use crate::List::{Cons, Nil};
fn main() {
let list = Cons(1, Cons(2, Cons(3, Nil)));
}List для хранения списка 1, 2, 3Первое значение Cons содержит 1 и другое значение List. Это значение List —
другое значение Cons, которое содержит 2 и другое значение List. Это значение List —
ещё одно значение Cons, которое содержит 3 и значение List, которое, наконец,
является Nil, нерекурсивным вариантом, сигнализирующим о конце списка.
Если мы попытаемся скомпилировать код в листинге 15-3, мы получим ошибку, показанную в листинге 15-4.
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
error[E0072]: recursive type `List` has infinite size
--> src/main.rs:1:1
|
1 | enum List {
| ^^^^^^^^^
2 | Cons(i32, List),
| ---- recursive without indirection
|
help: insert some indirection (e.g., a `Box`, `Rc`, or `&`) to break the cycle
|
2 | Cons(i32, Box<List>),
| ++++ +
For more information about this error, try `rustc --explain E0072`.
error: could not compile `cons-list` (bin "cons-list") due to 1 previous error
Ошибка показывает, что этот тип «имеет бесконечный размер». Причина в том, что мы определили
List с вариантом, который является рекурсивным: он содержит другое значение самого себя
напрямую. В результате Rust не может определить, сколько места нужно для хранения
значения List. Давайте разберём, почему мы получаем эту ошибку. Сначала мы рассмотрим, как
Rust решает, сколько места нужно для хранения значения нерекурсивного типа.
Вычисление размера нерекурсивного типа
Вспомните перечисление Message, которое мы определили в листинге 6-2, когда обсуждали
определения перечислений в главе 6:
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {}Чтобы определить, сколько места выделить для значения Message, Rust просматривает
каждый из вариантов, чтобы увидеть, какой вариант требует больше всего места. Rust
видит, что Message::Quit не требует места, Message::Move требует достаточно
места для хранения двух значений i32, и так далее. Поскольку будет использоваться только один вариант,
наибольшее пространство, которое потребуется значению Message, — это пространство, которое потребовалось бы для
хранения наибольшего из его вариантов.
Сравните это с тем, что происходит, когда Rust пытается определить, сколько места
нужно рекурсивному типу, такому как перечисление List в листинге 15-2. Компилятор начинает
с просмотра варианта Cons, который содержит значение типа i32 и значение
типа List. Следовательно, Cons требует объём пространства, равный размеру
i32 плюс размер List. Чтобы выяснить, сколько памяти нужно типу List,
компилятор смотрит на варианты, начиная с варианта Cons. Вариант Cons
содержит значение типа i32 и значение типа List, и этот процесс продолжается
бесконечно, как показано на Рисунке 15-1.
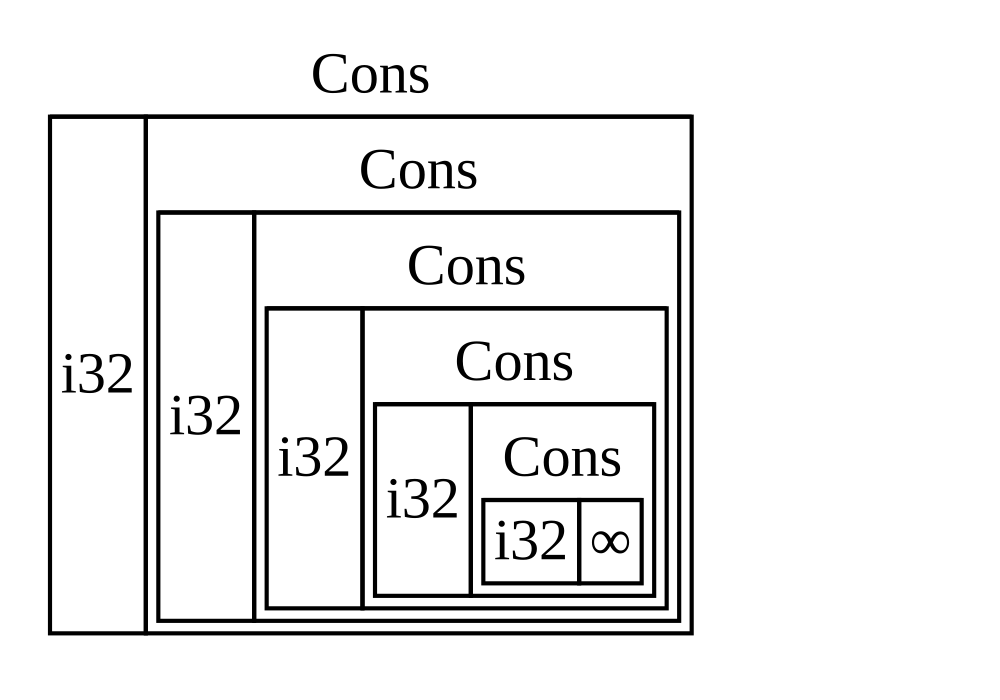
Рисунок 15-1: Бесконечный List, состоящий из бесконечных
вариантов Cons
Получение рекурсивного типа с известным размером
Поскольку Rust не может определить, сколько места выделить для рекурсивно определённых типов, компилятор выдаёт ошибку с этим полезным предложением:
help: insert some indirection (e.g., a `Box`, `Rc`, or `&`) to break the cycle
|
2 | Cons(i32, Box<List>),
| ++++ +
В этом предложении косвенность означает, что вместо хранения значения напрямую мы должны изменить структуру данных, чтобы хранить значение косвенно, сохраняя указатель на значение вместо этого.
Поскольку Box<T> является указателем, Rust всегда знает, сколько места нужно Box<T>:
размер указателя не меняется в зависимости от объёма данных, на которые он
указывает. Это означает, что мы можем поместить Box<T> в вариант Cons вместо
другого значения List напрямую. Box<T> будет указывать на следующее значение List,
которое будет в куче, а не внутри варианта Cons.
Концептуально у нас всё ещё есть список, созданный из списков, содержащих другие списки, но
эта реализация теперь больше похожа на размещение элементов рядом друг с другом,
а не внутри друг друга.
Мы можем изменить определение перечисления List в листинге 15-2 и использование
List в листинге 15-3 на код в листинге 15-5, который скомпилируется.
enum List {
Cons(i32, Box<List>),
Nil,
}
use crate::List::{Cons, Nil};
fn main() {
let list = Cons(1, Box::new(Cons(2, Box::new(Cons(3, Box::new(Nil))))));
}List, которое использует Box<T>, чтобы иметь известный размерВарианту Cons нужен размер i32 плюс пространство для хранения данных указателя
бокса. Вариант Nil не хранит значений, поэтому ему нужно меньше места в
стеке, чем варианту Cons. Теперь мы знаем, что любое значение List займёт
размер i32 плюс размер данных указателя бокса. Используя бокс,
мы разорвали бесконечную рекурсивную цепочку, поэтому компилятор может определить
размер, необходимый для хранения значения List. Рисунок 15-2 показывает, как выглядит вариант Cons
теперь.
Рисунок 15-2: List, который не имеет бесконечного размера,
потому что Cons содержит Box
Боксы обеспечивают только косвенность и выделение в куче; у них нет никаких других особых возможностей, подобных тем, которые мы увидим с другими типами умных указателей. Они также не имеют накладных расходов на производительность, которые влекут за собой эти особые возможности, поэтому они могут быть полезны в случаях, подобных cons-списку, где косвенность — единственная необходимая нам функция. Мы рассмотрим больше вариантов использования боксов в главе 18.
Тип Box<T> является умным указателем, потому что он реализует трейт Deref,
который позволяет обращаться со значениями Box<T> как со ссылками. Когда значение Box<T>
выходит из области видимости, данные в куче, на которые указывает бокс, также очищаются
благодаря реализации трейта Drop. Эти два трейта будут
ещё более важны для функциональности, предоставляемой другими типами умных указателей,
которые мы обсудим в оставшейся части этой главы. Давайте рассмотрим эти два трейта
более подробно.
Обращение с умными указателями как с обычными ссылками
Обращение с умными указателями как с обычными ссылками
Реализация трейта Deref позволяет настроить поведение
оператора разыменования * (не путать с оператором умножения или
glob-оператором). Реализуя Deref так, что с умным указателем можно
обращаться как с обычной ссылкой, можно писать код, работающий с
ссылками, и использовать этот код также с умными указателями.
Сначала рассмотрим, как оператор разыменования работает с обычными ссылками.
Затем попробуем определить пользовательский тип, который ведёт себя как Box<T>, и посмотрим, почему
оператор разыменования не работает как со ссылкой на нашем только что определённом
типе. Мы исследуем, как реализация трейта Deref позволяет
умным указателям работать подобно ссылкам. Затем рассмотрим
возможность Rust под названием «разыменовывающее приведение» (deref coercion) и то, как она позволяет работать
как со ссылками, так и с умными указателями.
Переход по ссылке к значению
Обычная ссылка — это разновидность указателя, и один из способов думать об указателе —
это стрелка к значению, хранящемуся где-то ещё. В листинге 15-6 мы создаём
ссылку на значение i32 и затем используем оператор разыменования, чтобы перейти по
ссылке к значению.
fn main() {
let x = 5;
let y = &x;
assert_eq!(5, x);
assert_eq!(5, *y);
}i32Переменная x хранит значение i32, равное 5. Мы устанавливаем y равной ссылке на
x. Мы можем утверждать, что x равно 5. Однако если мы хотим сделать
утверждение о значении в y, нам нужно использовать *y, чтобы перейти по ссылке
к значению, на которое она указывает (отсюда разыменование), чтобы компилятор мог
сравнить фактическое значение. Как только мы разыменуем y, мы получаем доступ к
целочисленному значению, на которое указывает y, и можем сравнить его с 5.
Если бы мы попытались написать assert_eq!(5, y); вместо этого, мы получили бы такую ошибку
компиляции:
$ cargo run
Compiling deref-example v0.1.0 (file:///projects/deref-example)
error[E0277]: can't compare `{integer}` with `&{integer}`
--> src/main.rs:6:5
|
6 | assert_eq!(5, y);
| ^^^^^^^^^^^^^^^^ no implementation for `{integer} == &{integer}`
|
= help: the trait `PartialEq<&{integer}>` is not implemented for `{integer}`
= help: the following other types implement trait `PartialEq<Rhs>`:
f128
f16
f32
f64
i128
i16
i32
i64
and 8 others
For more information about this error, try `rustc --explain E0277`.
error: could not compile `deref-example` (bin "deref-example") due to 1 previous error
Сравнивать число и ссылку на число не разрешается, потому что это разные типы. Мы должны использовать оператор разыменования, чтобы перейти по ссылке к значению, на которое она указывает.
Использование Box<T> как ссылки
Мы можем переписать код из листинга 15-6, чтобы использовать Box<T> вместо
ссылки; оператор разыменования, применённый к Box<T> в листинге 15-7,
работает так же, как оператор разыменования, применённый к ссылке в
листинге 15-6.
fn main() {
let x = 5;
let y = Box::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}Box<i32>Основное отличие листинга 15-7 от листинга 15-6 в том, что здесь мы устанавливаем
y как экземпляр бокса, указывающего на скопированное значение x, а не
ссылку, указывающую на значение x. В последнем утверждении мы можем использовать
оператор разыменования, чтобы перейти по указателю бокса так же, как мы делали,
когда y была ссылкой. Далее мы исследуем, что особенного в Box<T>,
что позволяет нам использовать оператор разыменования, определив собственный тип бокса.
Определение собственного умного указателя
Давайте создадим тип-обёртку, аналогичный типу Box<T>, предоставляемому
стандартной библиотекой, чтобы на практике увидеть, как типы умных указателей по умолчанию ведут себя иначе, чем
ссылки. Затем рассмотрим, как добавить возможность использовать
оператор разыменования.
Примечание: есть одно большое различие между типом MyBox<T>, который мы собираемся
создать, и настоящим Box<T>: наша версия не будет хранить свои данные в куче.
Мы сосредоточены в этом примере на Deref, поэтому то, где на самом деле хранятся данные,
менее важно, чем поведение, подобное указателю.
Тип Box<T> в конечном итоге определён как кортежная структура с одним элементом, поэтому
листинг 15-8 определяет тип MyBox<T> таким же образом. Мы также определим
функцию new, чтобы соответствовать функции new, определённой на Box<T>.
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {}MyBox<T>Мы определяем структуру с именем MyBox и объявляем обобщённый параметр T, потому что
хотим, чтобы наш тип хранил значения любого типа. Тип MyBox — это кортежная структура
с одним элементом типа T. Функция MyBox::new принимает один параметр
типа T и возвращает экземпляр MyBox, хранящий переданное значение.
Давайте попробуем добавить функцию main из листинга 15-7 в листинг 15-8 и
изменить её, чтобы использовать определённый нами тип MyBox<T> вместо Box<T>. Код
в листинге 15-9 не скомпилируется, потому что Rust не знает, как
разыменовать MyBox.
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {
let x = 5;
let y = MyBox::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}MyBox<T> так же, как мы использовали ссылки и Box<T>Вот полученная ошибка компиляции:
$ cargo run
Compiling deref-example v0.1.0 (file:///projects/deref-example)
error[E0614]: type `MyBox<{integer}>` cannot be dereferenced
--> src/main.rs:14:19
|
14 | assert_eq!(5, *y);
| ^^ can't be dereferenced
For more information about this error, try `rustc --explain E0614`.
error: could not compile `deref-example` (bin "deref-example") due to 1 previous error
Наш тип MyBox<T> не может быть разыменован, потому что мы не реализовали эту
возможность для нашего типа. Чтобы включить разыменование с помощью оператора *, мы
реализуем трейт Deref.
Реализация трейта Deref
Как обсуждалось в разделе «Реализация трейта для типа» в
главе 10, чтобы реализовать трейт, нам нужно предоставить реализации для
обязательных методов трейта. Трейт Deref, предоставляемый стандартной библиотекой,
требует от нас реализации одного метода с именем deref, который заимствует self и
возвращает ссылку на внутренние данные. Листинг 15-10 содержит реализацию
Deref, которую нужно добавить к определению MyBox<T>.
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &Self::Target {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {
let x = 5;
let y = MyBox::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}Deref для MyBox<T>Синтаксис type Target = T; определяет ассоциированный тип, который будет использовать трейт Deref.
Ассоциированные типы — это немного иной способ объявления обобщённого
параметра, но пока о них не нужно беспокоиться; мы рассмотрим их
подробнее в главе 20.
Мы заполняем тело метода deref выражением &self.0, чтобы deref
возвращал ссылку на значение, к которому мы хотим получить доступ с помощью оператора *;
напомним из раздела «Создание разных типов с помощью кортежных структур» в главе 5, что .0 обращается к первому значению в кортежной структуре.
Функция main в листинге 15-9, которая вызывает * для значения MyBox<T>, теперь
компилируется, и утверждения проходят!
Без трейта Deref компилятор может разыменовывать только ссылки &.
Метод deref даёт компилятору возможность взять значение любого типа,
реализующего Deref, и вызвать метод deref, чтобы получить ссылку, которую
он умеет разыменовывать.
Когда мы ввели *y в листинге 15-9, за кулисами Rust фактически выполнил такой
код:
*(y.deref())Rust заменяет оператор * вызовом метода deref, а затем
обычным разыменованием, чтобы нам не приходилось думать о том, нужно ли
вызывать метод deref. Эта возможность Rust позволяет нам писать код, который работает
одинаково независимо от того, есть ли у нас обычная ссылка или тип, реализующий
Deref.
Причина, по которой метод deref возвращает ссылку на значение, и то, что
обычное разыменование за скобками в *(y.deref()) всё ещё необходимо,
связаны с системой владения. Если бы метод deref возвращал значение
напрямую, а не ссылку на значение, значение было бы перемещено из
self. Мы не хотим брать владение внутренним значением внутри MyBox<T> в
этом случае или в большинстве случаев, когда мы используем оператор разыменования.
Обратите внимание, что оператор * заменяется вызовом метода deref, а
затем вызовом оператора * только один раз, каждый раз, когда мы используем * в нашем коде.
Поскольку замена оператора * не рекурсивна бесконечно, мы
в итоге получаем данные типа i32, которые соответствуют 5 в assert_eq! в
листинге 15-9.
Использование разыменовывающего приведения в функциях и методах
Разыменовывающее приведение (deref coercion) преобразует ссылку на тип, реализующий трейт Deref,
в ссылку на другой тип. Например, разыменовывающее приведение может преобразовать
&String в &str, потому что String реализует трейт Deref так, что он
возвращает &str. Разыменовывающее приведение — это удобство, которое Rust применяет к аргументам
функций и методов, и оно работает только с типами, реализующими трейт Deref.
Оно происходит автоматически, когда мы передаём ссылку на значение определённого типа
в качестве аргумента функции или методу, которые не соответствуют типу параметра
в определении функции или метода. Последовательность вызовов метода deref
преобразует предоставленный нами тип в тип, который нужен параметру.
Разыменовывающее приведение было добавлено в Rust, чтобы программистам, пишущим вызовы функций и
методов, не нужно было добавлять так много явных ссылок и разыменований
с помощью & и *. Возможность разыменовывающего приведения также позволяет нам писать больше кода, который
может работать как со ссылками, так и с умными указателями.
Чтобы увидеть разыменовывающее приведение в действии, давайте используем тип MyBox<T>, который мы определили в
листинге 15-8, а также реализацию Deref, которую мы добавили в листинге
15-10. Листинг 15-11 показывает определение функции с параметром
среза строки.
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {}hello с параметром name типа &strМы можем вызвать функцию hello со срезом строки в качестве аргумента, например
hello("Rust");. Разыменовывающее приведение позволяет вызвать hello
со ссылкой на значение типа MyBox<String>, как показано в листинге 15-12.
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &T {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {
let m = MyBox::new(String::from("Rust"));
hello(&m);
}hello со ссылкой на значение MyBox<String>, что работает благодаря разыменовывающему приведениюЗдесь мы вызываем функцию hello с аргументом &m, который является
ссылкой на значение MyBox<String>. Поскольку мы реализовали трейт Deref
для MyBox<T> в листинге 15-10, Rust может преобразовать &MyBox<String> в &String
путём вызова deref. Стандартная библиотека предоставляет реализацию Deref
для String, которая возвращает срез строки, и это есть в документации API
для Deref. Rust снова вызывает deref, чтобы превратить &String в &str, что
соответствует определению функции hello.
Если бы Rust не реализовал разыменовывающее приведение, нам пришлось бы написать код
из листинга 15-13 вместо кода из листинга 15-12, чтобы вызвать hello со значением
типа &MyBox<String>.
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &T {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {
let m = MyBox::new(String::from("Rust"));
hello(&(*m)[..]);
}(*m) разыменовывает MyBox<String> в String. Затем & и
[..] берут срез строки из String, равный всей строке, чтобы
соответствовать сигнатуре hello. Этот код без разыменовывающего приведения труднее
читать, писать и понимать со всеми этими символами. Разыменовывающее приведение
позволяет Rust обрабатывать эти преобразования за нас автоматически.
Когда трейт Deref определён для задействованных типов, Rust проанализирует
типы и будет использовать Deref::deref столько раз, сколько необходимо, чтобы получить ссылку,
соответствующую типу параметра. Количество раз, которое нужно вставить Deref::deref,
определяется во время компиляции, поэтому за использование разыменовывающего приведения
нет никаких затрат во время выполнения!
Обработка разыменовывающего приведения с изменяемыми ссылками
Подобно тому, как вы используете трейт Deref для переопределения оператора * для
неизменяемых ссылок, вы можете использовать трейт DerefMut для переопределения оператора *
для изменяемых ссылок.
Rust выполняет разыменовывающее приведение, когда находит типы и реализации трейтов в трёх случаях:
- Из
&Tв&U, когдаT: Deref<Target=U> - Из
&mut Tв&mut U, когдаT: DerefMut<Target=U> - Из
&mut Tв&U, когдаT: Deref<Target=U>
Первые два случая одинаковы, за исключением того, что второй реализует изменяемость.
Первый случай утверждает, что если у вас есть &T и T реализует Deref к
некоторому типу U, вы можете прозрачно получить &U. Второй случай утверждает, что
то же разыменовывающее приведение происходит для изменяемых ссылок.
Третий случай сложнее: Rust также приведёт изменяемую ссылку к неизменяемой. Но обратное невозможно: неизменяемые ссылки никогда не будут приведены к изменяемым ссылкам. Из-за правил заимствования, если у вас есть изменяемая ссылка, эта изменяемая ссылка должна быть единственной ссылкой на эти данные (иначе программа не скомпилируется). Преобразование одной изменяемой ссылки в одну неизменяемую ссылку никогда не нарушит правила заимствования. Преобразование неизменяемой ссылки в изменяемую потребовало бы, чтобы исходная неизменяемая ссылка была единственной неизменяемой ссылкой на эти данные, но правила заимствования этого не гарантируют. Поэтому Rust не может сделать предположение, что преобразование неизменяемой ссылки в изменяемую возможно.
Выполнение кода при очистке с помощью трейта Drop
Выполнение кода при очистке с помощью трейта Drop
Второй трейт, важный для паттерна умных указателей, — это Drop, который позволяет
настроить, что происходит, когда значение вот-вот выйдет из области видимости. Вы можете
предоставить реализацию трейта Drop для любого типа, и этот код может
использоваться для освобождения ресурсов, таких как файлы или сетевые соединения.
Мы вводим Drop в контексте умных указателей, потому что
функциональность трейта Drop почти всегда используется при реализации
умного указателя. Например, когда Box<T> уничтожается, он освобождает
пространство в куче, на которое указывает box.
В некоторых языках для некоторых типов программист должен вызывать код для освобождения памяти или ресурсов каждый раз, когда он заканчивает использовать экземпляр этих типов. Примеры включают файловые дескрипторы, сокеты и блокировки. Если программист забудет, система может перегрузиться и упасть. В Rust вы можете указать, что конкретный фрагмент кода должен выполняться всякий раз, когда значение выходит из области видимости, и компилятор вставит этот код автоматически. В результате вам не нужно быть осторожным с размещением кода очистки везде в программе, где экземпляр конкретного типа закончил использоваться — вы всё равно не допустите утечки ресурсов!
Вы указываете код, который должен выполняться, когда значение выходит из области видимости, реализуя
трейт Drop. Трейт Drop требует реализовать один метод с именем
drop, который принимает изменяемую ссылку на self. Чтобы увидеть, когда Rust вызывает drop,
давайте пока реализуем drop с операторами println!.
Листинг 15-14 показывает структуру CustomSmartPointer, единственная настраиваемая
функциональность которой — печать Dropping CustomSmartPointer!, когда
экземпляр выходит из области видимости, чтобы показать, когда Rust запускает метод drop.
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("my stuff"),
};
let d = CustomSmartPointer {
data: String::from("other stuff"),
};
println!("CustomSmartPointers created");
}CustomSmartPointer, которая реализует трейт Drop, где мы поместили бы наш код очисткиТрейт Drop включён в прелюдию, так что нам не нужно вводить его в
область видимости. Мы реализуем трейт Drop для CustomSmartPointer и предоставляем
реализацию метода drop, который вызывает println!. Тело метода
drop — это место, куда вы поместили бы любую логику, которую хотели бы выполнить, когда
экземпляр вашего типа выходит из области видимости. Здесь мы печатаем некоторый текст, чтобы
визуально продемонстрировать, когда Rust вызовет drop.
В main мы создаём два экземпляра CustomSmartPointer, а затем печатаем
CustomSmartPointers created. В конце main наши экземпляры
CustomSmartPointer выйдут из области видимости, и Rust вызовет код, который мы поместили
в метод drop, напечатав наше финальное сообщение. Обратите внимание, что нам не нужно было
вызывать метод drop явно.
Когда мы запустим эту программу, мы увидим следующий вывод:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.60s
Running `target/debug/drop-example`
CustomSmartPointers created
Dropping CustomSmartPointer with data `other stuff`!
Dropping CustomSmartPointer with data `my stuff`!
Rust автоматически вызвал drop за нас, когда наши экземпляры вышли из области видимости,
выполнив код, который мы указали. Переменные уничтожаются в обратном порядке
их создания, поэтому d был уничтожен раньше c. Цель этого примера —
дать вам визуальное руководство о том, как работает метод drop; обычно вы бы
указывали код очистки, который нужен вашему типу, а не печать
сообщения.
К сожалению, отключить автоматическую функциональность drop не так просто.
Отключение drop обычно не нужно; весь смысл
трейта Drop в том, что он обрабатывается автоматически. Иногда, однако,
вы можете захотеть очистить значение раньше. Один из примеров — при использовании умных
указателей, управляющих блокировками: вы можете захотеть принудительно вызвать метод drop, который
освобождает блокировку, чтобы другой код в той же области видимости мог получить блокировку.
Rust не позволяет вам вызывать метод drop трейта Drop вручную; вместо этого
вам нужно вызвать функцию std::mem::drop, предоставляемую стандартной библиотекой,
если вы хотите принудительно уничтожить значение до конца его области видимости.
Попытка вызвать метод drop трейта Drop вручную, изменив
функцию main из листинга 15-14, не сработает, как показано в листинге 15-15.
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("some data"),
};
println!("CustomSmartPointer created");
c.drop();
println!("CustomSmartPointer dropped before the end of main");
}drop трейта Drop вручную для ранней очисткиКогда мы попытаемся скомпилировать этот код, мы получим эту ошибку:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
error[E0040]: explicit use of destructor method
--> src/main.rs:16:7
|
16 | c.drop();
| ^^^^ explicit destructor calls not allowed
|
help: consider using `drop` function
|
16 - c.drop();
16 + drop(c);
|
For more information about this error, try `rustc --explain E0040`.
error: could not compile `drop-example` (bin "drop-example") due to 1 previous error
Это сообщение об ошибке говорит, что нам не разрешено явно вызывать drop.
В сообщении об ошибке используется термин деструктор, который является общим программистским термином
для функции, которая очищает экземпляр. Деструктор аналогичен
конструктору, который создаёт экземпляр. Функция drop в Rust — это один
из конкретных деструкторов.
Rust не позволяет нам вызывать drop явно, потому что Rust всё равно
автоматически вызовет drop для значения в конце main. Это вызовет
ошибку двойного освобождения, потому что Rust попытается очистить одно и то же значение дважды.
Мы не можем отключить автоматическую вставку drop, когда значение выходит из
области видимости, и мы не можем вызвать метод drop явно. Поэтому, если нам нужно принудительно
очистить значение раньше, мы используем функцию std::mem::drop.
Функция std::mem::drop отличается от метода drop в трейте
Drop. Мы вызываем её, передавая в качестве аргумента значение, которое хотим принудительно уничтожить.
Функция находится в прелюдии, поэтому мы можем изменить main в листинге 15-15, чтобы
вызвать функцию drop, как показано в листинге 15-16.
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("some data"),
};
println!("CustomSmartPointer created");
drop(c);
println!("CustomSmartPointer dropped before the end of main");
}std::mem::drop для явного уничтожения значения до того, как оно выйдет из области видимостиЗапуск этого кода напечатает следующее:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.73s
Running `target/debug/drop-example`
CustomSmartPointer created
Dropping CustomSmartPointer with data `some data`!
CustomSmartPointer dropped before the end of main
Текст Dropping CustomSmartPointer with data `some data`! печатается
между текстом CustomSmartPointer created и CustomSmartPointer dropped before the end of main, показывая, что код метода drop вызывается для уничтожения
c в этот момент.
Вы можете использовать код, указанный в реализации трейта Drop, многими способами, чтобы
сделать очистку удобной и безопасной: например, вы можете использовать его для создания вашего
собственного аллокатора памяти! С трейтом Drop и системой владения Rust вам
не нужно помнить об очистке, потому что Rust делает это автоматически.
Вам также не нужно беспокоиться о проблемах, возникающих из-за случайной
очистки значений, всё ещё используемых: система владения, которая гарантирует, что
ссылки всегда действительны, также гарантирует, что drop вызывается только один раз, когда
значение больше не используется.
Теперь, когда мы рассмотрели Box<T> и некоторые характеристики умных
указателей, давайте посмотрим на несколько других умных указателей, определённых в стандартной
библиотеке.
Rc<T>, умный указатель с подсчётом ссылок
Rc<T>, умный указатель с подсчётом ссылок
В большинстве случаев владение очевидно: точно известно, какая переменная владеет данным значением. Однако бывают случаи, когда у одного значения может быть несколько владельцев. Например, в структурах данных графов несколько рёбер могут указывать на один и тот же узел, и этот узел концептуально принадлежит всем рёбрам, которые на него указывают. Узел не должен очищаться, пока на него не указывает ни одного ребра и, следовательно, у него нет владельцев.
Множественное владение нужно включать явно, используя тип Rust
Rc<T>, что является сокращением от подсчёта ссылок. Тип Rc<T>
отслеживает количество ссылок на значение, чтобы определить, используется ли
значение всё ещё. Если ссылок на значение ноль, значение
может быть очищено без того, чтобы какие-либо ссылки стали недействительными.
Представьте Rc<T> как телевизор в семейной комнате. Когда один человек входит, чтобы посмотреть телевизор,
он включает его. Другие могут войти в комнату и смотреть телевизор. Когда последний
человек покидает комнату, он выключает телевизор, потому что его больше никто не
смотрит. Если кто-то выключит телевизор, пока другие всё ещё смотрят его, оставшиеся зрители
устроят бунт!
Мы используем тип Rc<T>, когда хотим выделить некоторые данные в куче для
того, чтобы несколько частей нашей программы читали их, и мы не можем определить во время компиляции,
какая часть закончит использовать данные последней. Если бы мы знали, какая часть закончит
последней, мы могли бы просто сделать эту часть владельцем данных, и обычные правила владения,
проверяемые во время компиляции, вступили бы в силу.
Обратите внимание, что Rc<T> предназначен только для использования в однопоточных сценариях. Когда мы будем обсуждать
конкурентность в главе 16, мы рассмотрим, как выполнять подсчёт ссылок в
многопоточных программах.
Совместное использование данных
Давайте вернёмся к нашему примеру cons-списка из листинга 15-5. Напомним, что мы определили
его с помощью Box<T>. На этот раз мы создадим два списка, которые оба владеют
третьим списком. Концептуально это похоже на рисунок 15-3.
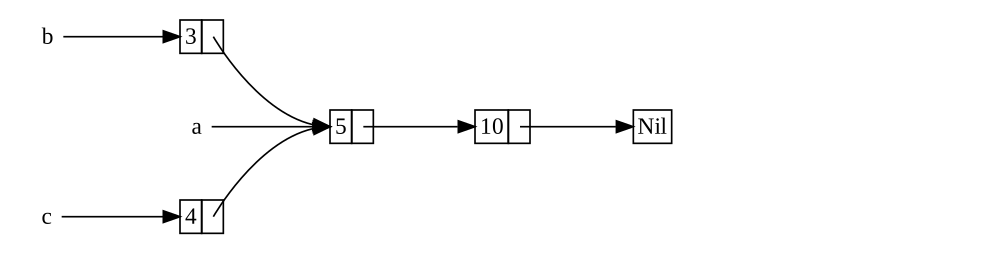
Рисунок 15-3: Два списка, b и c, совместно владеющие
третьим списком, a
Мы создадим список a, который содержит 5, а затем 10. Затем мы создадим два
других списка: b, который начинается с 3, и c, который начинается с 4. Оба списка b
и c затем продолжат к первому списку a, содержащему 5 и
10. Другими словами, оба списка будут совместно владеть первым списком, содержащим 5 и
10.
Попытка реализовать этот сценарий с использованием нашего определения List с Box<T>
не сработает, как показано в листинге 15-17.
enum List {
Cons(i32, Box<List>),
Nil,
}
use crate::List::{Cons, Nil};
fn main() {
let a = Cons(5, Box::new(Cons(10, Box::new(Nil))));
let b = Cons(3, Box::new(a));
let c = Cons(4, Box::new(a));
}Box<T>, которые пытаются совместно владеть третьим спискомКогда мы компилируем этот код, мы получаем эту ошибку:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
error[E0382]: use of moved value: `a`
--> src/main.rs:11:30
|
9 | let a = Cons(5, Box::new(Cons(10, Box::new(Nil))));
| - move occurs because `a` has type `List`, which does not implement the `Copy` trait
10 | let b = Cons(3, Box::new(a));
| - value moved here
11 | let c = Cons(4, Box::new(a));
| ^ value used here after move
|
note: if `List` implemented `Clone`, you could clone the value
--> src/main.rs:1:1
|
1 | enum List {
| ^^^^^^^^^ consider implementing `Clone` for this type
...
10 | let b = Cons(3, Box::new(a));
| - you could clone this value
For more information about this error, try `rustc --explain E0382`.
error: could not compile `cons-list` (bin "cons-list") due to 1 previous error
Варианты Cons владеют данными, которые они содержат, поэтому, когда мы создаём список b, a
перемещается в b и b владеет a. Затем, когда мы пытаемся снова использовать a при
создании c, нам это не разрешено, потому что a был перемещён.
Мы могли бы изменить определение Cons, чтобы хранить ссылки вместо этого, но тогда
нам пришлось бы указать параметры времени жизни. Указывая параметры
времени жизни, мы бы указывали, что каждый элемент в списке будет жить по
крайней мере столько же, сколько весь список. Это верно для элементов и списков
в листинге 15-17, но не в каждом сценарии.
Вместо этого мы изменим наше определение List, чтобы использовать Rc<T> вместо
Box<T>, как показано в листинге 15-18. Каждый вариант Cons теперь будет хранить значение
и Rc<T>, указывающий на List. Когда мы создаём b, вместо того чтобы принимать
владение a, мы клонируем Rc<List>, которым владеет a,
тем самым увеличивая количество ссылок с одного до двух и позволяя a и b
совместно владеть данными в этом Rc<List>. Мы также клонируем a при
создании c, увеличивая количество ссылок с двух до трёх. Каждый раз, когда
мы вызываем Rc::clone, счётчик ссылок на данные внутри Rc<List> будет
увеличиваться, и данные не будут очищены, пока на них не будет ноль ссылок.
enum List {
Cons(i32, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::rc::Rc;
fn main() {
let a = Rc::new(Cons(5, Rc::new(Cons(10, Rc::new(Nil)))));
let b = Cons(3, Rc::clone(&a));
let c = Cons(4, Rc::clone(&a));
}List, использующее Rc<T>Нам нужно добавить инструкцию use, чтобы ввести Rc<T> в область видимости, потому что его нет
в прелюдии. В main мы создаём список, содержащий 5 и 10, и сохраняем его
в новом Rc<List> в a. Затем, когда мы создаём b и c, мы вызываем функцию
Rc::clone и передаём ссылку на Rc<List> в a в качестве
аргумента.
Мы могли бы вызвать a.clone() вместо Rc::clone(&a), но соглашение Rust —
использовать Rc::clone в этом случае. Реализация
Rc::clone не делает глубокую копию всех данных, как это делают реализации clone
большинства типов. Вызов Rc::clone только увеличивает
счётчик ссылок, что не занимает много времени. Глубокие копии данных могут занимать
много времени. Используя Rc::clone для подсчёта ссылок, мы можем визуально
отличить разновидности клонирования с глубокой копией от разновидностей клонирования, которые
увеличивают счётчик ссылок. При поиске проблем с производительностью в
коде нам нужно учитывать только клоны с глубокой копией и можно не обращать внимания на вызовы
Rc::clone.
Клонирование для увеличения счётчика ссылок
Давайте изменим наш рабочий пример в листинге 15-18 так, чтобы мы могли видеть,
как счётчик ссылок меняется при создании и удалении ссылок на Rc<List> в
a.
В листинге 15-19 мы изменим main так, чтобы у него была внутренняя область видимости вокруг списка
c; затем мы сможем увидеть, как изменяется счётчик ссылок, когда c выходит из
области видимости.
enum List {
Cons(i32, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::rc::Rc;
// --snip--
fn main() {
let a = Rc::new(Cons(5, Rc::new(Cons(10, Rc::new(Nil)))));
println!("count after creating a = {}", Rc::strong_count(&a));
let b = Cons(3, Rc::clone(&a));
println!("count after creating b = {}", Rc::strong_count(&a));
{
let c = Cons(4, Rc::clone(&a));
println!("count after creating c = {}", Rc::strong_count(&a));
}
println!("count after c goes out of scope = {}", Rc::strong_count(&a));
}В каждой точке программы, где изменяется счётчик ссылок, мы печатаем
счётчик ссылок, который получаем, вызывая функцию Rc::strong_count. Эта
функция называется strong_count, а не count, потому что у типа Rc<T>
есть также weak_count; мы увидим, для чего используется weak_count, в разделе «Предотвращение
циклов ссылок с помощью Weak<T>».
Этот код печатает следующее:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.45s
Running `target/debug/cons-list`
count after creating a = 1
count after creating b = 2
count after creating c = 3
count after c goes out of scope = 2
Мы видим, что Rc<List> в a имеет начальный счётчик ссылок 1;
затем каждый раз, когда мы вызываем clone, счётчик увеличивается на 1. Когда c выходит из
области видимости, счётчик уменьшается на 1. Нам не нужно вызывать функцию для уменьшения
счётчика ссылок, как мы должны вызывать Rc::clone для увеличения счётчика
ссылок: реализация трейта Drop автоматически уменьшает счётчик ссылок,
когда значение Rc<T> выходит из области видимости.
Чего мы не можем увидеть в этом примере, так это то, что когда b, а затем a выходят из области видимости
в конце main, счётчик становится равным 0, и Rc<List> полностью
очищается. Использование Rc<T> позволяет одному значению иметь нескольких владельцев, а
счётчик гарантирует, что значение остаётся действительным, пока существует любой из владельцев.
Через неизменяемые ссылки Rc<T> позволяет совместно использовать данные между несколькими
частями программы только для чтения. Если бы Rc<T> позволял также иметь несколько
изменяемых ссылок, можно было бы нарушить одно из правил заимствования, обсуждавшихся
в главе 4: несколько изменяемых заимствований одного и того же места могут вызвать гонки данных
и несоответствия. Но возможность изменять данные очень полезна! В следующем
разделе мы обсудим паттерн внутренней изменяемости и тип RefCell<T>,
который можно использовать вместе с Rc<T>, чтобы обойти это
ограничение неизменяемости.
RefCell<T> и паттерн внутренней изменяемости
RefCell<T> и паттерн внутренней изменяемости
Внутренняя изменяемость — это паттерн проектирования в Rust, который позволяет изменять
данные даже при наличии неизменяемых ссылок на эти данные; обычно это
действие запрещено правилами заимствования. Для изменения данных паттерн использует
unsafe-код внутри структуры данных, чтобы обойти обычные правила Rust, управляющие
изменением и заимствованием. Небезопасный код указывает компилятору, что мы
проверяем правила вручную, а не полагаемся на компилятор в их проверке
за нас; подробнее о небезопасном коде мы поговорим в главе 20.
Мы можем использовать типы, применяющие паттерн внутренней изменяемости, только когда можем
гарантировать, что правила заимствования будут соблюдаться во время выполнения, даже если
компилятор не может этого гарантировать. Задействованный unsafe-код затем оборачивается в
безопасный API, а внешний тип по-прежнему остаётся неизменяемым.
Давайте исследуем эту концепцию, рассмотрев тип RefCell<T>, который следует
паттерну внутренней изменяемости.
Проверка правил заимствования во время выполнения
В отличие от Rc<T>, тип RefCell<T> представляет единоличное владение данными,
которые он хранит. Так что же отличает RefCell<T> от такого типа, как Box<T>?
Вспомните правила заимствования, которые вы узнали в главе 4:
- В любой момент времени у вас может быть либо одна изменяемая ссылка, либо любое количество неизменяемых ссылок (но не обе одновременно).
- Ссылки всегда должны быть действительными.
Для ссылок и Box<T> инварианты правил заимствования проверяются
во время компиляции. Для RefCell<T> эти инварианты проверяются во время выполнения.
При использовании ссылок, если вы нарушите эти правила, вы получите ошибку компилятора. При использовании
RefCell<T>, если вы нарушите эти правила, ваша программа запаникует и завершится.
Преимущества проверки правил заимствования во время компиляции заключаются в том, что ошибки будут обнаружены раньше в процессе разработки, и нет никакого влияния на производительность во время выполнения, поскольку весь анализ выполняется заранее. По этим причинам проверка правил заимствования во время компиляции — лучший выбор в большинстве случаев, поэтому это поведение по умолчанию в Rust.
Преимущество проверки правил заимствования во время выполнения, напротив, заключается в том, что определённые безопасные с точки зрения памяти сценарии становятся разрешёнными, тогда как они были бы запрещены проверками во время компиляции. Статический анализ, как в компиляторе Rust, по своей сути консервативен. Некоторые свойства кода невозможно обнаружить путём анализа кода: самый известный пример — проблема останова, которая выходит за рамки этой книги, но является интересной темой для исследования.
Поскольку некоторый анализ невозможен, если компилятор Rust не может быть уверен, что
код соблюдает правила владения, он может отклонить корректную программу; таким
образом он консервативен. Если бы Rust принимал некорректную программу, пользователи
не могли бы доверять гарантиям, которые даёт Rust. Однако если Rust отклоняет
корректную программу, программист будет испытывать неудобства, но ничего
катастрофического не произойдёт. Тип RefCell<T> полезен, когда вы уверены, что ваш
код соблюдает правила заимствования, но компилятор не может это понять и
гарантировать.
Подобно Rc<T>, RefCell<T> предназначен только для использования в однопоточных сценариях
и выдаст ошибку во время компиляции, если вы попытаетесь использовать его в многопоточном
контексте. Мы поговорим о том, как получить функциональность RefCell<T> в
многопоточной программе, в главе 16.
Вот краткое изложение причин выбрать Box<T>, Rc<T> или RefCell<T>:
Rc<T>позволяет нескольким владельцам одних и тех же данных;Box<T>иRefCell<T>имеют одного владельца.Box<T>допускает неизменяемые или изменяемые заимствования, проверяемые во время компиляции;Rc<T>допускает только неизменяемые заимствования, проверяемые во время компиляции;RefCell<T>допускает неизменяемые или изменяемые заимствования, проверяемые во время выполнения.- Поскольку
RefCell<T>допускает изменяемые заимствования, проверяемые во время выполнения, вы можете изменять значение внутриRefCell<T>, даже когдаRefCell<T>является неизменяемым.
Изменение значения внутри неизменяемого значения — это паттерн внутренней изменяемости. Давайте рассмотрим ситуацию, в которой внутренняя изменяемость полезна, и изучим, как она возможна.
Использование внутренней изменяемости
Следствием правил заимствования является то, что когда у вас есть неизменяемое значение, вы не можете заимствовать его изменяемо. Например, этот код не скомпилируется:
fn main() {
let x = 5;
let y = &mut x;
}Если вы попытаетесь скомпилировать этот код, вы получите следующую ошибку:
$ cargo run
Compiling borrowing v0.1.0 (file:///projects/borrowing)
error[E0596]: cannot borrow `x` as mutable, as it is not declared as mutable
--> src/main.rs:3:13
|
3 | let y = &mut x;
| ^^^^^^ cannot borrow as mutable
|
help: consider changing this to be mutable
|
2 | let mut x = 5;
| +++
For more information about this error, try `rustc --explain E0596`.
error: could not compile `borrowing` (bin "borrowing") due to 1 previous error
Однако существуют ситуации, когда было бы полезно, чтобы значение изменяло
себя в своих методах, но выглядело неизменяемым для другого кода. Код вне
методов значения не смог бы изменять значение. Использование RefCell<T> —
один из способов получить возможность внутренней изменяемости, но RefCell<T>
не обходит правила заимствования полностью: проверка заимствований в
компиляторе допускает эту внутреннюю изменяемость, а правила заимствования проверяются
во время выполнения. Если вы нарушите правила, вы получите panic! вместо
ошибки компилятора.
Давайте рассмотрим практический пример, где мы можем использовать RefCell<T> для изменения
неизменяемого значения, и увидим, почему это полезно.
Тестирование с mock-объектами
Иногда во время тестирования программист использует один тип вместо другого, чтобы наблюдать определённое поведение и убедиться, что оно реализовано правильно. Этот тип-заглушка называется test double. Подумайте о нём в смысле дублёра в кинематографе, где человек вступает в роль и заменяет актёра в особо сложной сцене. Test double заменяют другие типы, когда мы запускаем тесты. Mock-объекты — это особые виды test double, которые записывают, что происходит во время теста, чтобы вы могли убедиться, что были выполнены правильные действия.
В Rust нет объектов в том же смысле, в каком объекты есть в других языках, и в Rust нет функциональности mock-объектов, встроенной в стандартную библиотеку, как в некоторых других языках. Однако вы вполне можете создать структуру, которая будет служить тем же целям, что и mock-объект.
Вот сценарий, который мы будем тестировать: мы создадим библиотеку, которая отслеживает значение относительно максимального значения и отправляет сообщения в зависимости от того, насколько близко к максимальному значению находится текущее значение. Эта библиотека может использоваться для отслеживания квоты пользователя на количество разрешённых ему вызовов API, например.
Наша библиотека будет предоставлять только функциональность отслеживания того, насколько близко к
максимуму находится значение и какими должны быть сообщения в какие моменты. Приложения,
использующие нашу библиотеку, должны будут предоставить механизм отправки
сообщений: приложение может показывать сообщение пользователю напрямую, отправлять
электронное письмо, отправлять текстовое сообщение или делать что-то ещё. Библиотеке не нужно
знать эти детали. Всё, что ей нужно, — это что-то, реализующее предоставляемый нами трейт
под названием Messenger. В листинге 15-20 показан код библиотеки.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}Одна важная часть этого кода — трейт Messenger имеет один метод
под названием send, который принимает неизменяемую ссылку на self и текст
сообщения. Этот трейт — интерфейс, который должен реализовать наш mock-объект, чтобы
mock можно было использовать так же, как настоящий объект. Другая важная часть
заключается в том, что мы хотим протестировать поведение метода set_value у
LimitTracker. Мы можем изменить то, что передаём в параметр value, но
set_value ничего не возвращает, чтобы мы могли делать утверждения. Мы хотим иметь возможность
сказать, что если мы создаём LimitTracker с чем-то, реализующим
трейт Messenger, и определённым значением для max, messenger получает указание
отправить соответствующие сообщения, когда мы передаём разные числа для value.
Нам нужен mock-объект, который вместо отправки электронного письма или текстового сообщения при
вызове send будет только записывать сообщения, которые ему велено отправить. Мы можем
создать новый экземпляр mock-объекта, создать LimitTracker, использующий
mock-объект, вызвать метод set_value у LimitTracker, а затем проверить, что
mock-объект содержит ожидаемые нами сообщения. В листинге 15-21 показана попытка
реализовать mock-объект именно для этого, но проверка заимствований не позволит это сделать.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
struct MockMessenger {
sent_messages: Vec<String>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: vec![],
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
self.sent_messages.push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.len(), 1);
}
}MockMessenger, которая не разрешена проверкой заимствованийЭтот тестовый код определяет структуру MockMessenger с полем sent_messages
типа Vec значений String для отслеживания сообщений, которые ей велено
отправить. Мы также определяем ассоциированную функцию new, чтобы было удобно
создавать новые значения MockMessenger, начиная с пустого списка сообщений. Затем
мы реализуем трейт Messenger для MockMessenger, чтобы можно было передать
MockMessenger в LimitTracker. В определении метода send мы
берём сообщение, переданное в качестве параметра, и сохраняем его в списке
sent_messages объекта MockMessenger.
В тесте мы проверяем, что происходит, когда LimitTracker получает указание установить
value в значение, превышающее 75 процентов от max. Сначала мы
создаём новый MockMessenger, который начнёт с пустого списка сообщений.
Затем создаём новый LimitTracker и передаём ему ссылку на новый
MockMessenger и значение max, равное 100. Мы вызываем метод set_value у
LimitTracker со значением 80, что больше 75 процентов от 100.
Затем мы утверждаем, что список сообщений, который отслеживает MockMessenger,
теперь должен содержать одно сообщение.
Однако с этим тестом есть одна проблема, как показано здесь:
$ cargo test
Compiling limit-tracker v0.1.0 (file:///projects/limit-tracker)
error[E0596]: cannot borrow `self.sent_messages` as mutable, as it is behind a `&` reference
--> src/lib.rs:58:13
|
58 | self.sent_messages.push(String::from(message));
| ^^^^^^^^^^^^^^^^^^ `self` is a `&` reference, so it cannot be borrowed as mutable
|
help: consider changing this to be a mutable reference in the `impl` method and the `trait` definition
|
2 ~ fn send(&mut self, msg: &str);
3 | }
...
56 | impl Messenger for MockMessenger {
57 ~ fn send(&mut self, message: &str) {
|
For more information about this error, try `rustc --explain E0596`.
error: could not compile `limit-tracker` (lib test) due to 1 previous error
Мы не можем изменить MockMessenger, чтобы он отслеживал сообщения, потому что
метод send принимает неизменяемую ссылку на self. Мы также не можем принять
предложение из текста ошибки использовать &mut self как в методе impl, так и
в определении трейта. Мы не хотим менять трейт Messenger исключительно ради
тестирования. Вместо этого нам нужно найти способ заставить наш тестовый код работать
правильно с нашей существующей архитектурой.
Это ситуация, в которой может помочь внутренняя изменяемость! Мы будем хранить
sent_messages внутри RefCell<T>, и тогда метод send сможет
изменять sent_messages, чтобы сохранять сообщения, которые мы видели. Листинг 15-22 показывает,
как это выглядит.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
use std::cell::RefCell;
struct MockMessenger {
sent_messages: RefCell<Vec<String>>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: RefCell::new(vec![]),
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
self.sent_messages.borrow_mut().push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
// --snip--
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.borrow().len(), 1);
}
}RefCell<T> для изменения внутреннего значения, в то время как внешнее значение считается неизменяемымПоле sent_messages теперь имеет тип RefCell<Vec<String>> вместо
Vec<String>. В функции new мы создаём новый экземпляр RefCell<Vec<String>>
вокруг пустого вектора.
Для реализации метода send первый параметр по-прежнему является
неизменяемым заимствованием self, что соответствует определению трейта. Мы вызываем
borrow_mut для RefCell<Vec<String>> в self.sent_messages, чтобы получить
изменяемую ссылку на значение внутри RefCell<Vec<String>>, то есть на
вектор. Затем мы можем вызвать push для изменяемой ссылки на вектор, чтобы
отслеживать сообщения, отправленные во время теста.
Последнее изменение, которое нам нужно сделать, — в утверждении: чтобы увидеть, сколько элементов
во внутреннем векторе, мы вызываем borrow для RefCell<Vec<String>>, чтобы получить
неизменяемую ссылку на вектор.
Теперь, когда вы увидели, как использовать RefCell<T>, давайте углубимся в то, как это работает!
Отслеживание заимствований во время выполнения
При создании неизменяемых и изменяемых ссылок мы используем синтаксис & и &mut
соответственно. С RefCell<T> мы используем методы borrow и borrow_mut,
которые являются частью безопасного API, принадлежащего RefCell<T>. Метод
borrow возвращает тип умного указателя Ref<T>, а borrow_mut —
тип умного указателя RefMut<T>. Оба типа реализуют Deref, поэтому мы
можем обращаться с ними как с обычными ссылками.
RefCell<T> отслеживает, сколько умных указателей Ref<T> и RefMut<T>
активно в данный момент. Каждый раз, когда мы вызываем borrow, RefCell<T>
увеличивает свой счётчик активных неизменяемых заимствований. Когда значение Ref<T>
выходит из области видимости, счётчик неизменяемых заимствований уменьшается на 1. Так же
как и правила заимствования во время компиляции, RefCell<T> позволяет нам иметь много неизменяемых
заимствований или одно изменяемое заимствование в любой момент времени.
Если мы попытаемся нарушить эти правила, вместо ошибки компилятора, как было бы
со ссылками, реализация RefCell<T> запаникует во
время выполнения. В листинге 15-23 показана модификация реализации send из
листинга 15-22. Мы намеренно пытаемся создать два активных изменяемых заимствования
в одной области видимости, чтобы показать, что RefCell<T> не позволяет нам делать это
во время выполнения.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
use std::cell::RefCell;
struct MockMessenger {
sent_messages: RefCell<Vec<String>>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: RefCell::new(vec![]),
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
let mut one_borrow = self.sent_messages.borrow_mut();
let mut two_borrow = self.sent_messages.borrow_mut();
one_borrow.push(String::from(message));
two_borrow.push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.borrow().len(), 1);
}
}RefCell<T> запаникуетМы создаём переменную one_borrow для умного указателя RefMut<T>, возвращаемого
из borrow_mut. Затем мы создаём ещё одно изменяемое заимствование таким же образом в
переменной two_borrow. Это создаёт две изменяемые ссылки в одной области видимости,
что не разрешено. Когда мы запускаем тесты для нашей библиотеки, код из листинга
15-23 скомпилируется без ошибок, но тест завершится неудачно:
$ cargo test
Compiling limit-tracker v0.1.0 (file:///projects/limit-tracker)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.91s
Running unittests src/lib.rs (target/debug/deps/limit_tracker-e599811fa246dbde)
running 1 test
test tests::it_sends_an_over_75_percent_warning_message ... FAILED
failures:
---- tests::it_sends_an_over_75_percent_warning_message stdout ----
thread 'tests::it_sends_an_over_75_percent_warning_message' (6028024) panicked at src/lib.rs:60:53:
RefCell already borrowed
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::it_sends_an_over_75_percent_warning_message
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Обратите внимание, что код запаниковал с сообщением already borrowed: BorrowMutError. Именно так RefCell<T> обрабатывает нарушения
правил заимствования во время выполнения.
Выбор отлавливать ошибки заимствования во время выполнения, а не во время компиляции,
как мы сделали здесь, означает, что вы потенциально будете обнаруживать ошибки в своём коде позже
в процессе разработки: возможно, только после того, как ваш код будет развёрнут в
производственной среде. Кроме того, ваш код будет нести небольшой штраф по производительности
во время выполнения из-за отслеживания заимствований во время выполнения, а не во время компиляции.
Однако использование RefCell<T> позволяет написать mock-объект, который может
изменять себя, чтобы отслеживать увиденные сообщения, пока вы используете его
в контексте, где разрешены только неизменяемые значения. Вы можете использовать RefCell<T>,
несмотря на его компромиссы, чтобы получить больше функциональности, чем предоставляют
обычные ссылки.
Разрешение нескольких владельцев изменяемых данных
Распространённый способ использования RefCell<T> — в сочетании с Rc<T>. Вспомните, что
Rc<T> позволяет иметь несколько владельцев некоторых данных, но предоставляет только неизменяемый
доступ к этим данным. Если у вас есть Rc<T>, содержащий RefCell<T>, вы можете
получить значение, которое может иметь несколько владельцев и которое вы можете изменять!
Например, вспомните пример cons-списка в листинге 15-18, где мы использовали
Rc<T>, чтобы несколько списков могли совместно владеть другим списком. Поскольку
Rc<T> хранит только неизменяемые значения, мы не можем изменить какие-либо значения в
списке после того, как мы их создали. Давайте добавим RefCell<T> ради его способности
изменять значения в списках. В листинге 15-24 показано, что, используя
RefCell<T> в определении Cons, мы можем изменить значение, хранящееся во всех
списках.
#[derive(Debug)]
enum List {
Cons(Rc<RefCell<i32>>, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
fn main() {
let value = Rc::new(RefCell::new(5));
let a = Rc::new(Cons(Rc::clone(&value), Rc::new(Nil)));
let b = Cons(Rc::new(RefCell::new(3)), Rc::clone(&a));
let c = Cons(Rc::new(RefCell::new(4)), Rc::clone(&a));
*value.borrow_mut() += 10;
println!("a after = {a:?}");
println!("b after = {b:?}");
println!("c after = {c:?}");
}Rc<RefCell<i32>> для создания List, который мы можем изменятьМы создаём значение, являющееся экземпляром Rc<RefCell<i32>>, и сохраняем его в
переменной с именем value, чтобы позже иметь к нему прямой доступ. Затем мы создаём
List в a с вариантом Cons, содержащим value. Нам нужно клонировать
value, чтобы и a, и value владели внутренним значением 5,
вместо передачи владения от value к a или заимствования a
у value.
Мы оборачиваем список a в Rc<T>, чтобы, когда мы создаём списки b и c,
они оба могли ссылаться на a, как мы делали в листинге 15-18.
После того как мы создали списки в a, b и c, мы хотим добавить 10 к
значению в value. Мы делаем это, вызывая borrow_mut для value, что использует
возможность автоматического разыменования, которую мы обсуждали в разделе «Где оператор ->?» в главе 5, чтобы разыменовать
Rc<T> до внутреннего значения RefCell<T>. Метод borrow_mut возвращает
умный указатель RefMut<T>, и мы используем для него оператор разыменования и изменяем
внутреннее значение.
Когда мы выводим a, b и c, мы видим, что все они имеют изменённое
значение 15 вместо 5:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.63s
Running `target/debug/cons-list`
a after = Cons(RefCell { value: 15 }, Nil)
b after = Cons(RefCell { value: 3 }, Cons(RefCell { value: 15 }, Nil))
c after = Cons(RefCell { value: 4 }, Cons(RefCell { value: 15 }, Nil))
Этот приём довольно изящен! Используя RefCell<T>, мы имеем внешне
неизменяемое значение List. Но мы можем использовать методы RefCell<T>, которые
обеспечивают доступ к его внутренней изменяемости, чтобы мы могли изменять наши данные, когда
это необходимо. Проверки правил заимствования во время выполнения защищают нас от гонок данных, и
иногда стоит пожертвовать немного скоростью ради этой гибкости в наших структурах
данных. Обратите внимание, что RefCell<T> не работает для многопоточного кода!
Mutex<T> — это потокобезопасная версия RefCell<T>, и мы обсудим
Mutex<T> в главе 16.
Циклы ссылок могут приводить к утечке памяти
Циклы ссылок могут приводить к утечке памяти
Гарантии безопасности памяти Rust делают трудным, но не невозможным
случайное создание памяти, которая никогда не очищается (известное как утечка памяти).
Предотвращение утечек памяти полностью не входит в гарантии Rust, что означает,
что утечки памяти безопасны с точки зрения памяти в Rust. Мы можем видеть, что Rust допускает утечки памяти,
используя Rc<T> и RefCell<T>: можно создать ссылки, где
элементы ссылаются друг на друга в цикле. Это создаёт утечки памяти, потому что
счётчик ссылок каждого элемента в цикле никогда не достигнет 0, и значения
никогда не будут освобождены.
Создание цикла ссылок
Давайте посмотрим, как может возникнуть цикл ссылок и как его предотвратить,
начав с определения перечисления List и метода tail в листинге
15-25.
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
enum List {
Cons(i32, RefCell<Rc<List>>),
Nil,
}
impl List {
fn tail(&self) -> Option<&RefCell<Rc<List>>> {
match self {
Cons(_, item) => Some(item),
Nil => None,
}
}
}
fn main() {}RefCell<T>, чтобы мы могли изменять то, на что ссылается вариант ConsМы используем другой вариант определения List из листинга 15-5. Второй
элемент в варианте Cons теперь имеет тип RefCell<Rc<List>>, что означает, что
вместо возможности изменять значение i32, как мы делали в листинге
15-24, мы хотим изменять значение List, на которое указывает вариант Cons.
Мы также добавляем метод tail, чтобы было удобно получать доступ ко
второму элементу, если у нас есть вариант Cons.
В листинге 15-26 мы добавляем функцию main, которая использует определения из
листинга 15-25. Этот код создаёт список в a и список в b, который указывает на
список в a. Затем он изменяет список в a, чтобы он указывал на b, создавая
цикл ссылок. По ходу есть операторы println!, чтобы показать, какими
являются счётчики ссылок в различных точках этого процесса.
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
enum List {
Cons(i32, RefCell<Rc<List>>),
Nil,
}
impl List {
fn tail(&self) -> Option<&RefCell<Rc<List>>> {
match self {
Cons(_, item) => Some(item),
Nil => None,
}
}
}
fn main() {
let a = Rc::new(Cons(5, RefCell::new(Rc::new(Nil))));
println!("a initial rc count = {}", Rc::strong_count(&a));
println!("a next item = {:?}", a.tail());
let b = Rc::new(Cons(10, RefCell::new(Rc::clone(&a))));
println!("a rc count after b creation = {}", Rc::strong_count(&a));
println!("b initial rc count = {}", Rc::strong_count(&b));
println!("b next item = {:?}", b.tail());
if let Some(link) = a.tail() {
*link.borrow_mut() = Rc::clone(&b);
}
println!("b rc count after changing a = {}", Rc::strong_count(&b));
println!("a rc count after changing a = {}", Rc::strong_count(&a));
// Раскомментируйте следующую строку, чтобы увидеть, что у нас цикл;
// он приведёт к переполнению стека.
// println!("a next item = {:?}", a.tail());
}List, указывающих друг на другаМы создаём экземпляр Rc<List>, содержащий значение List, в переменной a
с начальным списком 5, Nil. Затем мы создаём экземпляр Rc<List>, содержащий
другое значение List, в переменной b, которое содержит значение 10 и
указывает на список в a.
Мы изменяем a, чтобы он указывал на b вместо Nil, создавая цикл. Мы
делаем это, используя метод tail, чтобы получить ссылку на
RefCell<Rc<List>> в a, которую мы помещаем в переменную link. Затем мы используем
метод borrow_mut для RefCell<Rc<List>>, чтобы изменить значение внутри
с Rc<List>, содержащего значение Nil, на Rc<List> в b.
Когда мы запускаем этот код, оставив последний println! закомментированным на
данный момент, мы получим такой вывод:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.53s
Running `target/debug/cons-list`
a initial rc count = 1
a next item = Some(RefCell { value: Nil })
a rc count after b creation = 2
b initial rc count = 1
b next item = Some(RefCell { value: Cons(5, RefCell { value: Nil }) })
b rc count after changing a = 2
a rc count after changing a = 2
Счётчик ссылок экземпляров Rc<List> как в a, так и в b равен 2 после
того, как мы изменили список в a, чтобы он указывал на b. В конце main Rust освобождает
переменную b, что уменьшает счётчик ссылок экземпляра Rc<List> в b
с 2 до 1. Память, которую Rc<List> имеет в куче, не будет
освобождена в этот момент, потому что её счётчик ссылок равен 1, а не 0. Затем Rust освобождает
a, что также уменьшает счётчик ссылок экземпляра Rc<List> в a с 2
до 1. Память этого экземпляра также не может быть освобождена, потому что другой
экземпляр Rc<List> всё ещё ссылается на неё. Память, выделенная для списка, останется
неосвобождённой навсегда. Чтобы визуализировать этот цикл ссылок, мы создали
диаграмму на рис. 15-4.
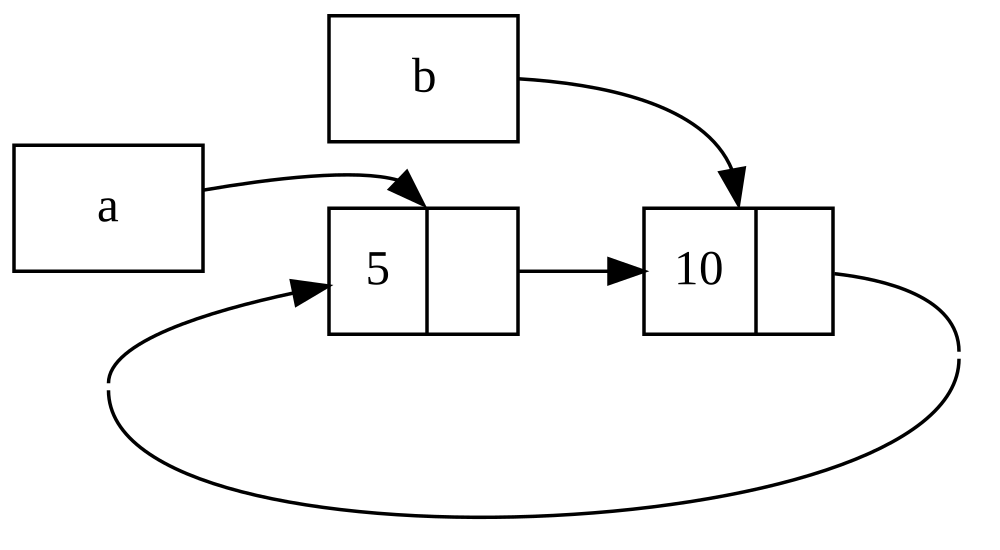
Рисунок 15-4: Цикл ссылок списков a и b,
указывающих друг на друга
Если вы раскомментируете последний println! и запустите программу, Rust попытается
напечатать этот цикл: a указывает на b, b указывает на a, и так далее, пока не
переполнится стек.
По сравнению с реальной программой последствия создания цикла ссылок в этом примере не очень серьёзны: сразу после создания цикла ссылок программа завершается. Однако если более сложная программа выделила много памяти в цикле и удерживала её в течение длительного времени, программа использовала бы больше памяти, чем нужно, и могла бы перегрузить систему, вызвав нехватку доступной памяти.
Создание циклов ссылок не делается легко, но и не невозможно.
Если у вас есть значения RefCell<T>, содержащие значения Rc<T> или подобные вложенные
комбинации типов с внутренней изменяемостью и подсчётом ссылок, вы должны
убедиться, что не создаёте циклы; вы не можете полагаться на то, что Rust их поймает.
Создание цикла ссылок было бы логической ошибкой в вашей программе, которую следует
минимизировать с помощью автоматических тестов, обзоров кода и других практик разработки программного обеспечения.
Другое решение для избежания циклов ссылок — реорганизовать ваши структуры
данных так, чтобы некоторые ссылки выражали владение, а некоторые — нет.
В результате вы можете иметь циклы, состоящие из некоторых отношений владения и
некоторых отношений без владения, и только отношения владения влияют на
то, может ли значение быть освобождено. В листинге 15-25 мы всегда хотим, чтобы варианты Cons
владели своим списком, поэтому реорганизовать структуру данных невозможно.
Давайте рассмотрим пример с графами, состоящими из родительских узлов и дочерних
узлов, чтобы увидеть, когда отношения без владения являются подходящим способом предотвращения
циклов ссылок.
Предотвращение циклов ссылок с помощью Weak<T>
До сих пор мы демонстрировали, что вызов Rc::clone увеличивает
strong_count экземпляра Rc<T>, и экземпляр Rc<T> очищается только
если его strong_count равен 0. Вы также можете создать слабую ссылку на
значение внутри экземпляра Rc<T>, вызвав Rc::downgrade и передав
ссылку на Rc<T>. Сильные ссылки — это способ разделить владение
экземпляром Rc<T>. Слабые ссылки не выражают отношение
владения, и их количество не влияет на то, когда экземпляр Rc<T>
очищается. Они не вызовут цикл ссылок, потому что любой цикл, включающий
некоторые слабые ссылки, будет разорван, как только сильный счётчик ссылок значений,
участвующих в нём, станет равен 0.
Когда вы вызываете Rc::downgrade, вы получаете умный указатель типа Weak<T>.
Вместо увеличения strong_count в экземпляре Rc<T> на 1, вызов
Rc::downgrade увеличивает weak_count на 1. Тип Rc<T> использует
weak_count для отслеживания того, сколько ссылок Weak<T> существует, подобно
strong_count. Разница в том, что weak_count не должен быть равен 0, чтобы
экземпляр Rc<T> был очищен.
Поскольку значение, на которое ссылается Weak<T>, могло быть освобождено, чтобы делать
что-либо со значением, на которое указывает Weak<T>, вы должны убедиться, что
значение всё ещё существует. Сделайте это, вызвав метод upgrade для экземпляра
Weak<T>, который вернёт Option<Rc<T>>. Вы получите результат Some,
если значение Rc<T> ещё не освобождено, и результат None, если
значение Rc<T> было освобождено. Поскольку upgrade возвращает Option<Rc<T>>,
Rust обеспечит обработку случая Some и случая None, и
не будет недопустимого указателя.
В качестве примера, вместо использования списка, элементы которого знают только о следующем элементе, мы создадим дерево, элементы которого знают о своих дочерних элементах и своих родительских элементах.
Создание структуры данных дерева
Для начала мы создадим дерево с узлами, которые знают о своих дочерних узлах.
Мы создадим структуру с именем Node, которая хранит своё собственное значение i32, а также
ссылки на свои дочерние значения Node:
Имя файла: src/main.rs
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
struct Node {
value: i32,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
children: RefCell::new(vec![]),
});
let branch = Rc::new(Node {
value: 5,
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
}Мы хотим, чтобы Node владел своими дочерними элементами, и мы хотим разделить это владение
с переменными, чтобы мы могли напрямую обращаться к каждому Node в дереве. Для этого
мы определяем элементы Vec<T> как значения типа Rc<Node>. Мы также хотим
изменять, какие узлы являются дочерними для другого узла, поэтому у нас есть RefCell<T> в
children вокруг Vec<Rc<Node>>.
Затем мы используем наше определение структуры и создаём один экземпляр Node с именем
leaf со значением 3 и без дочерних элементов, и другой экземпляр с именем branch
со значением 5 и leaf в качестве одного из его дочерних элементов, как показано в листинге 15-27.
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
struct Node {
value: i32,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
children: RefCell::new(vec![]),
});
let branch = Rc::new(Node {
value: 5,
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
}leaf без дочерних элементов и узла branch с leaf в качестве одного из его дочерних элементовМы клонируем Rc<Node> в leaf и сохраняем его в branch, что означает, что
Node в leaf теперь имеет двух владельцев: leaf и branch. Мы можем перейти от
branch к leaf через branch.children, но нет способа перейти от
leaf к branch. Причина в том, что leaf не имеет ссылки на branch и
не знает, что они связаны. Мы хотим, чтобы leaf знал, что branch — его
родитель. Мы сделаем это далее.
Добавление ссылки от дочернего элемента к его родителю
Чтобы дочерний узел знал о своём родителе, нам нужно добавить поле parent в
определение нашей структуры Node. Проблема в том, чтобы решить, каким должен быть тип
parent. Мы знаем, что он не может содержать Rc<T>, потому что это
создало бы цикл ссылок: leaf.parent указывал бы на branch, а
branch.children указывал бы на leaf, что привело бы к тому, что их значения strong_count
никогда не станут равны 0.
Рассматривая отношения по-другому, родительский узел должен владеть своими дочерними элементами: если родительский узел освобождён, его дочерние узлы также должны быть освобождены. Однако дочерний элемент не должен владеть своим родителем: если мы освободим дочерний узел, родитель должен по-прежнему существовать. Это случай для слабых ссылок!
Итак, вместо Rc<T> мы сделаем тип parent использующим Weak<T>,
а именно RefCell<Weak<Node>>. Теперь наше определение структуры Node выглядит
так:
Имя файла: src/main.rs
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}Узел сможет ссылаться на своего родительского узел, но не владеет своим родителем. В
листинге 15-28 мы обновляем main, чтобы использовать это новое определение, так что узел leaf
получит способ ссылаться на своего родителя, branch.
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}leaf со слабой ссылкой на его родительский узел branchСоздание узла leaf выглядит аналогично листингу 15-27, за исключением
поля parent: leaf начинает без родителя, поэтому мы создаём новый,
пустой экземпляр ссылки Weak<Node>.
На этом этапе, когда мы пытаемся получить ссылку на родителя leaf, используя
метод upgrade, мы получаем значение None. Мы видим это в выводе первого
оператора println!:
leaf parent = None
Когда мы создаём узел branch, он также будет иметь новую ссылку Weak<Node>
в поле parent, потому что branch не имеет родительского узла. У нас
по-прежнему leaf является одним из дочерних элементов branch. Как только у нас есть экземпляр Node
в branch, мы можем изменить leaf, чтобы дать ему ссылку Weak<Node>
на его родителя. Мы используем метод borrow_mut для RefCell<Weak<Node>> в
поле parent у leaf, а затем используем функцию Rc::downgrade, чтобы
создать ссылку Weak<Node> на branch из Rc<Node> в branch.
Когда мы снова печатаем родителя leaf, на этот раз мы получим вариант Some,
содержащий branch: теперь leaf может получить доступ к своему родителю! Когда мы печатаем leaf, мы
также избегаем цикла, который в конечном итоге привёл к переполнению стека, как было в
листинге 15-26; ссылки Weak<Node> печатаются как (Weak):
leaf parent = Some(Node { value: 5, parent: RefCell { value: (Weak) },
children: RefCell { value: [Node { value: 3, parent: RefCell { value: (Weak) },
children: RefCell { value: [] } }] } })
Отсутствие бесконечного вывода указывает на то, что этот код не создал цикл
ссылок. Мы также можем сказать это, посмотрев на значения, которые мы получаем при вызове
Rc::strong_count и Rc::weak_count.
Визуализация изменений strong_count и weak_count
Давайте посмотрим, как изменяются значения strong_count и weak_count экземпляров
Rc<Node>, создав новую внутреннюю область видимости и переместив создание
branch в эту область. Таким образом мы сможем увидеть, что происходит, когда branch
создаётся, а затем освобождается, когда выходит из области видимости. Модификации показаны
в листинге 15-29.
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
{
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!(
"branch strong = {}, weak = {}",
Rc::strong_count(&branch),
Rc::weak_count(&branch),
);
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
}
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
}branch во внутренней области видимости и изучение счётчиков сильных и слабых ссылокПосле создания leaf его Rc<Node> имеет сильный счётчик 1 и слабый
счётчик 0. Во внутренней области видимости мы создаём branch и связываем его с
leaf, и в этот момент, когда мы печатаем счётчики, Rc<Node> в branch
будет иметь сильный счётчик 1 и слабый счётчик 1 (для leaf.parent, указывающего
на branch через Weak<Node>). Когда мы печатаем счётчики для leaf, мы увидим,
что он будет иметь сильный счётчик 2, потому что branch теперь имеет клон
Rc<Node> из leaf, хранящийся в branch.children, но по-прежнему будет иметь слабый
счётчик 0.
Когда внутренняя область видимости заканчивается, branch выходит из области видимости, и сильный счётчик
Rc<Node> уменьшается до 0, поэтому его Node освобождается. Слабый счётчик 1
из leaf.parent не влияет на то, освобождается ли Node, поэтому мы
не получаем никаких утечек памяти!
Если мы попытаемся получить доступ к родителю leaf после окончания области видимости, мы снова получим
None. В конце программы Rc<Node> в leaf имеет сильный
счётчик 1 и слабый счётчик 0, потому что переменная leaf теперь снова является единственной
ссылкой на Rc<Node>.
Вся логика, управляющая счётчиками и освобождением значений, встроена в
Rc<T> и Weak<T> и их реализации трейта Drop. Указав, что
отношение от дочернего элемента к его родителю должно быть ссылкой
Weak<T> в определении Node, вы можете иметь родительские
узлы, указывающие на дочерние узлы, и наоборот, без создания цикла ссылок
и утечек памяти.
Итоги
В этой главе рассматривалось, как использовать умные указатели, чтобы обеспечить иные гарантии и
компромиссы, чем те, которые Rust предоставляет по умолчанию с обычными ссылками. Тип
Box<T> имеет известный размер и указывает на данные, выделенные в куче. Тип
Rc<T> отслеживает количество ссылок на данные в куче, чтобы
данные могли иметь несколько владельцев. Тип RefCell<T> с его внутренней
изменяемостью даёт нам тип, который мы можем использовать, когда нам нужен неизменяемый тип, но
нужно изменить внутреннее значение этого типа; он также проверяет правила заимствования
во время выполнения, а не во время компиляции.
Также обсуждались трейты Deref и Drop, которые обеспечивают большую часть
функциональности умных указателей. Мы исследовали циклы ссылок, которые могут вызывать
утечки памяти, и то, как их предотвратить с помощью Weak<T>.
Если эта глава пробудила ваш интерес и вы хотите реализовать собственные умные указатели, обратитесь к «The Rustonomicon» за более полезной информацией.
Далее мы поговорим о конкурентности в Rust. Вы даже узнаете о нескольких новых умных указателях.
Бесстрашная конкурентность
Бесстрашная конкурентность
Безопасная и эффективная обработка конкурентного программирования — ещё одна из главных целей Rust. Конкурентное программирование, при котором разные части программы выполняются независимо, и параллельное программирование, при котором разные части программы выполняются одновременно, становятся всё более важными по мере того, как всё больше компьютеров используют преимущества своих нескольких процессоров. Исторически программирование в этих контекстах было трудным и подверженным ошибкам. Rust надеется изменить это.
Изначально команда Rust считала, что обеспечение безопасности памяти и предотвращение проблем конкурентности — это две отдельные задачи, которые нужно решать разными методами. Со временем команда обнаружила, что система владения и типов — это мощный набор инструментов для управления безопасностью памяти и проблемами конкурентности! Используя владение и проверку типов, многие ошибки конкурентности становятся ошибками времени компиляции в Rust, а не ошибками времени выполнения. Поэтому вместо того, чтобы заставлять тратить много времени на попытки воспроизвести точные обстоятельства, при которых возникает ошибка конкурентности во время выполнения, некорректный код откажется компилироваться и выдаст сообщение об ошибке, объясняющее проблему. В результате можно исправлять код во время работы над ним, а не потенциально после того, как он был отправлен в продакшн. Мы прозвали этот аспект Rust бесстрашной конкурентностью. Бесстрашная конкурентность позволяет писать код, свободный от тонких ошибок и легко поддающийся рефакторингу без внесения новых ошибок.
Примечание: для простоты мы будем называть многие из проблем конкурентными, а не более точно говорить конкурентными и/или параллельными. В этой главе мысленно заменяйте конкурентный на конкурентный и/или параллельный всякий раз, когда мы используем слово конкурентный. В следующей главе, где различие более важно, мы будем более точны.
Многие языки догматичны в отношении решений, которые они предлагают для обработки конкурентных проблем. Например, Erlang обладает элегантной функциональностью для конкурентности с передачей сообщений, но имеет лишь неясные способы совместного использования состояния между потоками. Поддержка только подмножества возможных решений — разумная стратегия для языков более высокого уровня, потому что язык более высокого уровня обещает преимущества от отказа от некоторого контроля ради получения абстракций. Однако языки более низкого уровня должны предоставлять решение с наилучшей производительностью в любой данной ситуации и иметь меньше абстракций над оборудованием. Поэтому Rust предлагает множество инструментов для моделирования задач любым способом, подходящим для ситуации и требований.
Вот темы, которые мы рассмотрим в этой главе:
- Как создавать потоки для одновременного выполнения нескольких частей кода
- Конкурентность с передачей сообщений, где каналы отправляют сообщения между потоками
- Конкурентность с общим состоянием, где несколько потоков имеют доступ к некоторой части данных
- Трейты
SyncиSend, которые распространяют гарантии конкурентности Rust на пользовательские типы, а также на типы, предоставляемые стандартной библиотекой
Использование потоков для одновременного выполнения кода
Использование потоков для одновременного выполнения кода
В большинстве современных операционных систем код выполняемой программы выполняется в процессе, и операционная система управляет несколькими процессами одновременно. Внутри программы вы также можете иметь независимые части, которые выполняются одновременно. Функции, которые выполняют эти независимые части, называются потоками. Например, веб-сервер может иметь несколько потоков, чтобы он мог отвечать на более чем один запрос одновременно.
Разделение вычислений в вашей программе на несколько потоков для выполнения нескольких задач одновременно может улучшить производительность, но также добавляет сложность. Поскольку потоки могут выполняться одновременно, нет никакой внутренней гарантии относительно порядка, в котором части вашего кода в разных потоках будут выполняться. Это может привести к проблемам, таким как:
- Состояния гонки, в которых потоки обращаются к данным или ресурсам в несогласованном порядке
- Взаимные блокировки, в которых два потока ждут друг друга, не позволяя обоим потокам продолжить
- Ошибки, которые возникают только в определённых ситуациях и которые трудно воспроизвести и исправить надёжно
Rust пытается смягчить негативные последствия использования потоков, но программирование в многопоточном контексте всё ещё требует тщательного обдумывания и требует структуры кода, отличной от той, что в программах, работающих в одном потоке.
Языки программирования реализуют потоки несколькими разными способами, и многие операционные системы предоставляют API, который язык программирования может вызывать для создания новых потоков. Стандартная библиотека Rust использует модель 1:1 реализации потоков, при которой программа использует один поток операционной системы на один поток языка. Есть крейты, которые реализуют другие модели потоков, которые делают другие компромиссы по сравнению с моделью 1:1. (Асинхронная система Rust, которую мы увидим в следующей главе, также предоставляет другой подход к конкурентности.)
Создание нового потока с помощью spawn
Чтобы создать новый поток, мы вызываем функцию thread::spawn и передаём ей
замыкание (мы говорили о замыканиях в главе 13), содержащее код, который мы хотим
выполнить в новом потоке. Пример в листинге 16-1 печатает некоторый текст из основного
потока и другой текст из нового потока.
use std::thread;
use std::time::Duration;
fn main() {
thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
}Обратите внимание, что когда основной поток программы на Rust завершается, все порождённые потоки завершаются, независимо от того, закончили ли они выполнение. Вывод этой программы может немного отличаться каждый раз, но он будет выглядеть примерно так:
hi number 1 from the main thread!
hi number 1 from the spawned thread!
hi number 2 from the main thread!
hi number 2 from the spawned thread!
hi number 3 from the main thread!
hi number 3 from the spawned thread!
hi number 4 from the main thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
Вызовы thread::sleep заставляют поток остановить своё выполнение на короткое
время, позволяя другому потоку выполняться. Потоки, вероятно, будут
чередоваться, но это не гарантируется: это зависит от того, как ваша операционная система
планирует потоки. В этом запуске основной поток напечатал первым, хотя
оператор печати из порождённого потока появляется первым в коде. И хотя
мы сказали порождённому потоку печатать, пока i не станет 9, он успел только до 5,
прежде чем основной поток завершился.
Если вы запустите этот код и увидите только вывод из основного потока или не увидите никакого перекрытия, попробуйте увеличить числа в диапазонах, чтобы создать больше возможностей для операционной системы переключаться между потоками.
Ожидание завершения всех потоков
Код в листинге 16-1 не только останавливает порождённый поток преждевременно в большинстве случаев из-за завершения основного потока, но и, поскольку нет гарантии порядка выполнения потоков, мы также не можем гарантировать, что порождённый поток получит возможность выполняться вообще!
Мы можем решить проблему того, что порождённый поток не выполняется или завершается
преждевременно, сохранив возвращаемое значение thread::spawn в переменной. Тип
возвращаемого значения thread::spawn — JoinHandle<T>. JoinHandle<T> — это
принадлежащее значение, которое, когда мы вызываем на нём метод join, будет ждать, пока его
поток не завершится. Листинг 16-2 показывает, как использовать JoinHandle<T>
потока, который мы создали в листинге 16-1, и как вызвать join, чтобы убедиться, что
порождённый поток завершится до выхода main.
use std::thread;
use std::time::Duration;
fn main() {
let handle = thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
handle.join().unwrap();
}JoinHandle<T> из thread::spawn для гарантии того, что поток выполнится до концаВызов join на дескрипторе блокирует поток, выполняющийся в данный момент, до тех пор, пока
поток, представленный дескриптором, не завершится. Блокировка потока означает, что
этому потоку запрещено выполнять работу или завершаться. Поскольку мы поместили вызов
join после цикла for основного потока, запуск листинга 16-2 должен
дать вывод, подобный этому:
hi number 1 from the main thread!
hi number 2 from the main thread!
hi number 1 from the spawned thread!
hi number 3 from the main thread!
hi number 2 from the spawned thread!
hi number 4 from the main thread!
hi number 3 from the spawned thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
hi number 6 from the spawned thread!
hi number 7 from the spawned thread!
hi number 8 from the spawned thread!
hi number 9 from the spawned thread!
Два потока продолжают чередоваться, но основной поток ждёт из-за
вызова handle.join() и не заканчивается, пока порождённый поток не завершится.
Но давайте посмотрим, что произойдёт, если мы вместо этого переместим handle.join() перед
циклом for в main, вот так:
use std::thread;
use std::time::Duration;
fn main() {
let handle = thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
handle.join().unwrap();
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
}Основной поток будет ждать завершения порождённого потока, а затем запустит свой
цикл for, поэтому вывод больше не будет чередоваться, как показано здесь:
hi number 1 from the spawned thread!
hi number 2 from the spawned thread!
hi number 3 from the spawned thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
hi number 6 from the spawned thread!
hi number 7 from the spawned thread!
hi number 8 from the spawned thread!
hi number 9 from the spawned thread!
hi number 1 from the main thread!
hi number 2 from the main thread!
hi number 3 from the main thread!
hi number 4 from the main thread!
Мелкие детали, такие как место вызова join, могут повлиять на то, будут ли ваши
потоки выполняться одновременно.
Использование замыканий move с потоками
Мы часто будем использовать ключевое слово move с замыканиями, передаваемыми в thread::spawn,
потому что тогда замыкание забирает владение значениями, которые оно использует из
окружения, тем самым передавая владение этими значениями из одного потока в
другой. В «Захват ссылок или перемещение владения» в главе 13 мы обсуждали move в контексте замыканий. Теперь мы
сосредоточимся больше на взаимодействии между move и thread::spawn.
Обратите внимание в листинге 16-1, что замыкание, которое мы передаём в thread::spawn, не принимает
аргументов: мы не используем никаких данных из основного потока в коде порождённого
потока. Чтобы использовать данные из основного потока в порождённом потоке,
замыкание порождённого потока должно захватить нужные ему значения. Листинг 16-3 показывает
попытку создать вектор в основном потоке и использовать его в порождённом
потоке. Однако это пока не сработает, как вы увидите через мгновение.
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(|| {
println!("Here's a vector: {v:?}");
});
handle.join().unwrap();
}Замыкание использует v, поэтому оно захватит v и сделает его частью окружения замыкания.
Поскольку thread::spawn выполняет это замыкание в новом потоке, мы
должны иметь возможность доступа к v внутри этого нового потока. Но когда мы компилируем этот
пример, мы получаем следующую ошибку:
$ cargo run
Compiling threads v0.1.0 (file:///projects/threads)
error[E0373]: closure may outlive the current function, but it borrows `v`, which is owned by the current function
--> src/main.rs:6:32
|
6 | let handle = thread::spawn(|| {
| ^^ may outlive borrowed value `v`
7 | println!("Here's a vector: {v:?}");
| - `v` is borrowed here
|
note: function requires argument type to outlive `'static`
--> src/main.rs:6:18
|
6 | let handle = thread::spawn(|| {
| __________________^
7 | | println!("Here's a vector: {v:?}");
8 | | });
| |______^
help: to force the closure to take ownership of `v` (and any other referenced variables), use the `move` keyword
|
6 | let handle = thread::spawn(move || {
| ++++
For more information about this error, try `rustc --explain E0373`.
error: could not compile `threads` (bin "threads") due to 1 previous error
Rust выводит, как захватывать v, и поскольку println! нужна только ссылка
на v, замыкание пытается заимствовать v. Однако есть проблема: Rust не может
определить, как долго будет выполняться порождённый поток, поэтому он не знает, будет ли
ссылка на v всегда допустимой.
Листинг 16-4 предоставляет сценарий, в котором более вероятно наличие ссылки на v,
которая не будет допустимой.
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(|| {
println!("Here's a vector: {v:?}");
});
drop(v); // ой-ой!
handle.join().unwrap();
}v из основного потока, который удаляет vЕсли бы Rust позволил нам выполнить этот код, была бы вероятность, что порождённый
поток был бы немедленно помещён в фоновый режим, вообще не выполнившись. У
порождённого потока есть ссылка на v внутри, но основной поток немедленно
удаляет v, используя функцию drop, которую мы обсуждали в главе 15. Затем, когда
порождённый поток начнёт выполняться, v больше недействителен, поэтому ссылка на него
также недействительна. О нет!
Чтобы исправить ошибку компилятора в листинге 16-3, мы можем воспользоваться советом из сообщения об ошибке:
help: to force the closure to take ownership of `v` (and any other referenced variables), use the `move` keyword
|
6 | let handle = thread::spawn(move || {
| ++++
Добавив ключевое слово move перед замыканием, мы заставляем замыкание взять
владение значениями, которые оно использует, вместо того чтобы позволить Rust вывести, что оно
должно заимствовать значения. Модификация листинга 16-3, показанная в листинге
16-5, скомпилируется и выполнится, как мы задумали.
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(move || {
println!("Here's a vector: {v:?}");
});
handle.join().unwrap();
}move, чтобы заставить замыкание взять владение значениями, которые оно используетМы могли бы быть искушены попробовать то же самое, чтобы исправить код в листинге 16-4, где
основной поток вызывал drop, используя замыкание move. Однако это исправление
не сработает, потому что то, что пытается сделать листинг 16-4, запрещено по
другой причине. Если бы мы добавили move к замыканию, мы бы переместили v в
окружение замыкания, и мы больше не могли бы вызывать drop на нём в основном
потоке. Вместо этого мы получили бы эту ошибку компилятора:
$ cargo run
Compiling threads v0.1.0 (file:///projects/threads)
error[E0382]: use of moved value: `v`
--> src/main.rs:10:10
|
4 | let v = vec![1, 2, 3];
| - move occurs because `v` has type `Vec<i32>`, which does not implement the `Copy` trait
5 |
6 | let handle = thread::spawn(move || {
| ------- value moved into closure here
7 | println!("Here's a vector: {v:?}");
| - variable moved due to use in closure
...
10 | drop(v); // oh no!
| ^ value used here after move
|
help: consider cloning the value before moving it into the closure
|
6 ~ let value = v.clone();
7 ~ let handle = thread::spawn(move || {
8 ~ println!("Here's a vector: {value:?}");
|
For more information about this error, try `rustc --explain E0382`.
error: could not compile `threads` (bin "threads") due to 1 previous error
Правила владения Rust снова спасли нас! Мы получили ошибку из кода в
листинге 16-3, потому что Rust был консервативен и только заимствовал v для
потока, что означало, что основной поток теоретически мог сделать недействительной
ссылку порождённого потока. Сказав Rust переместить владение v в порождённый
поток, мы гарантируем Rust, что основной поток больше не будет использовать v.
Если мы изменим листинг 16-4 таким же образом, мы нарушим правила
владения, когда попытаемся использовать v в основном потоке. Ключевое слово move
переопределяет консервативное поведение Rust по умолчанию — заимствование; оно не позволяет нам нарушать
правила владения.
Теперь, когда мы рассмотрели, что такое потоки и методы, предоставляемые API потоков, давайте рассмотрим некоторые ситуации, в которых мы можем использовать потоки.
Передача данных между потоками с помощью передачи сообщений
Передача данных между потоками с помощью передачи сообщений
Один из всё более популярных подходов к обеспечению безопасной конкурентности — передача сообщений, при которой потоки или акторы взаимодействуют, отправляя друг другу сообщения, содержащие данные. Вот идея в виде лозунга из документации языка Go: «Не общайтесь через разделяемую память; вместо этого разделяйте память через общение».
Чтобы реализовать конкурентность через отправку сообщений, стандартная библиотека Rust предоставляет реализацию каналов. Канал — это общая концепция программирования, при которой данные отправляются из одного потока в другой.
Вы можете представить канал в программировании как направленный канал воды, например ручей или реку. Если вы поместите что-то вроде резиновой уточки в реку, она поплывёт вниз по течению до конца водного пути.
У канала есть две половины: передатчик и приёмник. Половина-передатчик — это место вверх по течению, куда вы кладёте резиновую уточку в реку, а половина-приёмник — это место, куда уточка попадает вниз по течению. Одна часть вашего кода вызывает методы на передатчике с данными, которые вы хотите отправить, а другая часть проверяет принимающий конец на наличие прибывающих сообщений. Говорят, что канал закрыт, если отброшена любая из половин — передатчик или приёмник.
Здесь мы дойдём до программы, в которой один поток генерирует значения и отправляет их по каналу, а другой поток получает эти значения и выводит их на печать. Мы будем отправлять простые значения между потоками с помощью канала, чтобы проиллюстрировать эту возможность. Как только вы освоите эту технику, вы сможете использовать каналы для любых потоков, которым нужно взаимодействовать друг с другом, например для системы чата или системы, в которой множество потоков выполняют части вычисления и отправляют части одному потоку, который агрегирует результаты.
Сначала в листинге 16-6 мы создадим канал, но не будем с ним ничего делать. Обратите внимание, что это ещё не скомпилируется, потому что Rust не может определить, какой тип значений мы хотим отправлять по каналу.
use std::sync::mpsc;
fn main() {
let (tx, rx) = mpsc::channel();
}tx и rxМы создаём новый канал с помощью функции mpsc::channel; mpsc расшифровывается как multiple producer, single consumer (множество производителей, один потребитель). Короче говоря, способ, которым стандартная библиотека Rust реализует каналы, означает, что канал может иметь несколько отправляющих концов, которые производят значения, но только один принимающий конец, который потребляет эти значения. Представьте несколько ручьёв, впадающих вместе в одну большую реку: всё, что отправлено вниз по любому из ручьёв, в конце окажется в одной реке. Пока мы начнём с одного производителя, но добавим несколько производителей, когда заработает этот пример.
Функция mpsc::channel возвращает кортеж, первый элемент которого — отправляющий конец (передатчик), а второй элемент — принимающий конец (приёмник). Сокращения tx и rx традиционно используются во многих областях для transmitter (передатчик) и receiver (приёмник) соответственно, поэтому мы так называем наши переменные, чтобы обозначить каждый конец. Мы используем оператор let с шаблоном, который деструктурирует кортеж; мы обсудим использование шаблонов в операторах let и деструктуризацию в главе 19. Пока просто знайте, что использование оператора let таким образом — удобный подход к извлечению частей кортежа, возвращаемого mpsc::channel.
Давайте переместим передающий конец в порождённый поток и заставим его отправить одну строку, чтобы порождённый поток взаимодействовал с главным потоком, как показано в листинге 16-7. Это похоже на помещение резиновой уточки в реку вверх по течению или на отправку сообщения в чате из одного потока в другой.
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
});
}tx в порождённый поток и отправка "hi"Снова мы используем thread::spawn, чтобы создать новый поток, а затем используем move, чтобы переместить tx в замыкание, чтобы порождённый поток владел tx. Порождённому потоку нужно владеть передатчиком, чтобы иметь возможность отправлять сообщения через канал.
У передатчика есть метод send, который принимает значение, которое мы хотим отправить. Метод send возвращает тип Result<T, E>, поэтому, если приёмник уже был отброшен и отправлять значение некуда, операция отправки вернёт ошибку. В этом примере мы вызываем unwrap, чтобы вызвать панику в случае ошибки. Но в реальном приложении мы бы обработали её должным образом: обратитесь к главе 9, чтобы повторить стратегии правильной обработки ошибок.
В листинге 16-8 мы получим значение от приёмника в главном потоке. Это похоже на извлечение резиновой уточки из воды в конце реки или на получение сообщения в чате.
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
});
let received = rx.recv().unwrap();
println!("Got: {received}");
}"hi" в главном потоке и его печатьУ приёмника есть два полезных метода: recv и try_recv. Мы используем recv, сокращение от receive (получать), который заблокирует выполнение главного потока и будет ждать, пока значение не будет отправлено по каналу. Как только значение отправлено, recv вернёт его в Result<T, E>. Когда передатчик закрывается, recv вернёт ошибку, сигнализирующую, что больше значений не будет.
Метод try_recv не блокирует, а вместо этого немедленно возвращает Result<T, E>: значение Ok, содержащее сообщение, если оно доступно, и значение Err, если в этот раз сообщений нет. Использование try_recv полезно, если у этого потока есть другая работа, которую можно делать в ожидании сообщений: мы могли бы написать цикл, который вызывает try_recv время от времени, обрабатывает сообщение, если оно доступно, и в противном случае выполняет другую работу в течение некоторого времени, пока снова не проверит.
В этом примере мы использовали recv для простоты; у нас нет другой работы для главного потока, кроме ожидания сообщений, поэтому блокировка главного потока уместна.
Когда мы запустим код из листинга 16-8, мы увидим значение, напечатанное из главного потока:
Got: hi
Отлично!
Передача владения через каналы
Правила владения играют жизненно важную роль в отправке сообщений, потому что они помогают писать безопасный конкурентный код. Предотвращение ошибок в конкурентном программировании — это преимущество размышления о владении на протяжении всех ваших программ на Rust. Давайте проведём эксперимент, чтобы показать, как каналы и владение работают вместе, чтобы предотвратить проблемы: мы попытаемся использовать значение val в порождённом потоке после того, как мы отправили его по каналу. Попробуйте скомпилировать код из листинга 16-9, чтобы увидеть, почему этот код не разрешён.
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
println!("val is {val}");
});
let received = rx.recv().unwrap();
println!("Got: {received}");
}val после того, как мы отправили её по каналуЗдесь мы пытаемся напечатать val после того, как отправили её по каналу через tx.send. Разрешить это было бы плохой идеей: как только значение было отправлено в другой поток, этот поток может изменить или отбросить его до того, как мы попытаемся использовать значение снова. Потенциально модификации другого потока могли бы вызвать ошибки или неожиданные результаты из-за противоречивых или несуществующих данных. Однако Rust выдаёт нам ошибку, если мы попытаемся скомпилировать код из листинга 16-9:
$ cargo run
Compiling message-passing v0.1.0 (file:///projects/message-passing)
error[E0382]: borrow of moved value: `val`
--> src/main.rs:10:27
|
8 | let val = String::from("hi");
| --- move occurs because `val` has type `String`, which does not implement the `Copy` trait
9 | tx.send(val).unwrap();
| --- value moved here
10 | println!("val is {val}");
| ^^^ value borrowed here after move
For more information about this error, try `rustc --explain E0382`.
error: could not compile `message-passing` (bin "message-passing") due to 1 previous error
Наша конкурентная ошибка вызвала ошибку времени компиляции. Функция send принимает владение своим параметром, и когда значение перемещается, приёмник принимает владение им. Это не позволяет нам случайно использовать значение снова после его отправки; система владения проверяет, что всё в порядке.
Отправка нескольких значений
Код из листинга 16-8 скомпилировался и запустился, но он не показал нам ясно, что два отдельных потока общаются друг с другом через канал.
В листинге 16-10 мы внесли некоторые изменения, которые докажут, что код из листинга 16-8 выполняется конкурентно: порождённый поток теперь будет отправлять несколько сообщений и делать паузу на секунду между каждым сообщением.
use std::sync::mpsc;
use std::thread;
use std::time::Duration;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("thread"),
];
for val in vals {
tx.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
for received in rx {
println!("Got: {received}");
}
}На этот раз у порождённого потока есть вектор строк, которые мы хотим отправить главному потоку. Мы перебираем их, отправляя каждую отдельно, и делаем паузу между каждым вызовом функции thread::sleep со значением Duration в одну секунду.
В главном потоке мы больше не вызываем функцию recv явно: вместо этого мы обращаемся с rx как с итератором. Для каждого полученного значения мы его печатаем. Когда канал закрывается, итерация заканчивается.
При запуске кода из листинга 16-10 вы должны увидеть следующий вывод с одной секундной паузой между каждой строкой:
Got: hi
Got: from
Got: the
Got: thread
Поскольку у нас нет никакого кода, который делает паузу или задержку в цикле for главного потока, мы можем сказать, что главный поток ждёт получения значений от порождённого потока.
Создание нескольких производителей
Ранее мы упоминали, что mpsc — это аббревиатура от multiple producer, single consumer (множество производителей, один потребитель). Давайте используем mpsc и расширим код из листинга 16-10, чтобы создать несколько потоков, которые все отправляют значения одному и тому же приёмнику. Мы можем сделать это, клонировав передатчик, как показано в листинге 16-11.
use std::sync::mpsc;
use std::thread;
use std::time::Duration;
fn main() {
// --snip--
let (tx, rx) = mpsc::channel();
let tx1 = tx.clone();
thread::spawn(move || {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("thread"),
];
for val in vals {
tx1.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
thread::spawn(move || {
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
for received in rx {
println!("Got: {received}");
}
// --snip--
}На этот раз, прежде чем мы создадим первый порождённый поток, мы вызываем clone на передатчике. Это даст нам новый передатчик, который мы можем передать первому порождённому потоку. Мы передаём исходный передатчик второму порождённому потоку. Это даёт нам два потока, каждый из которых отправляет разные сообщения одному приёмнику.
Когда вы запустите код, ваш вывод должен выглядеть примерно так:
Got: hi
Got: more
Got: from
Got: messages
Got: for
Got: the
Got: thread
Got: you
В зависимости от вашей системы вы можете увидеть значения в другом порядке. Это то, что делает конкурентность интересной и одновременно сложной. Если вы поэкспериментируете с thread::sleep, задавая ему различные значения в разных потоках, каждый запуск будет более недетерминированным и создаст разный вывод каждый раз.
Теперь, когда мы рассмотрели, как работают каналы, давайте посмотрим на другой метод конкурентности.
Конкурентность с разделяемым состоянием
Конкурентность с разделяемым состоянием
Передача сообщений — прекрасный способ обработки конкурентности, но не единственный. Другой метод — когда несколько потоков обращаются к одним и тем же разделяемым данным. Вновь рассмотрим эту часть слогана из документации языка Go: «Не общайтесь через разделяемую память».
Как бы выглядело общение через разделяемую память? Кроме того, почему сторонники передачи сообщений предостерегают от использования разделяемой памяти?
В некотором смысле каналы в любом языке программирования похожи на единоличное владение, потому что, как только вы передаёте значение по каналу, вы больше не должны использовать это значение. Конкурентность с разделяемой памятью подобна множественному владению: несколько потоков могут одновременно обращаться к одному и тому же месту в памяти. Как вы видели в главе 15, где умные указатели сделали возможным множественное владение, множественное владение может добавить сложности, потому что эти разные владельцы нуждаются в управлении. Система типов и правила владения Rust сильно помогают в правильном управлении. Для примера давайте рассмотрим мьютексы — один из наиболее распространённых примитивов конкурентности для разделяемой памяти.
Управление доступом с помощью мьютексов
Mutex — это сокращение от mutual exclusion (взаимное исключение): мьютекс позволяет только одному потоку обращаться к некоторым данным в любой момент времени. Чтобы получить доступ к данным в мьютексе, поток должен сначала сообщить, что он хочет получить доступ, запросив захват блокировки мьютекса. Блокировка — это структура данных, которая является частью мьютекса и отслеживает, кто в настоящее время имеет исключительный доступ к данным. Поэтому говорят, что мьютекс охраняет данные, которые он содержит, с помощью системы блокировок.
Мьютексы имеют репутацию сложных в использовании, потому что нужно помнить два правила:
- Необходимо попытаться захватить блокировку перед использованием данных.
- Когда вы закончили с данными, которые охраняет мьютекс, необходимо разблокировать данные, чтобы другие потоки могли захватить блокировку.
Для реальной метафоры мьютекса представьте панельную дискуссию на конференции с единственным микрофоном. Прежде чем участник дискуссии сможет говорить, он должен попросить или сообщить, что хочет использовать микрофон. Когда он получает микрофон, он может говорить столько, сколько хочет, а затем передать микрофон следующему участнику, который попросит говорить. Если участник забудет передать микрофон, когда закончит, никто больше не сможет говорить. Если управление общим микрофоном пойдёт неправильно, панель не будет работать, как планировалось!
Управление мьютексами может быть невероятно сложным для правильной реализации, поэтому многие люди с энтузиазмом относятся к каналам. Однако благодаря системе типов и правилам владения Rust вы не сможете ошибиться с блокировкой и разблокировкой.
API Mutex<T>
В качестве примера использования мьютекса давайте начнём с использования мьютекса в однопоточном контексте, как показано в листинге 16-12.
use std::sync::Mutex;
fn main() {
let m = Mutex::new(5);
{
let mut num = m.lock().unwrap();
*num = 6;
}
println!("m = {m:?}");
}Mutex<T> в однопоточном контексте для простотыКак и со многими типами, мы создаём Mutex<T> с помощью ассоциированной функции new. Чтобы получить доступ к данным внутри мьютекса, мы используем метод lock для захвата блокировки. Этот вызов заблокирует текущий поток, чтобы он не мог выполнять никакой работы, пока не наступит наша очередь получить блокировку.
Вызов lock завершился бы неудачей, если бы другой поток, удерживающий блокировку, запаниковал. В этом случае никто никогда не смог бы получить блокировку, поэтому мы решили вызвать unwrap и позволить этому потоку запаниковать, если мы окажемся в такой ситуации.
После того, как мы захватили блокировку, мы можем рассматривать возвращаемое значение, названное num в этом случае, как изменяемую ссылку на данные внутри. Система типов гарантирует, что мы захватим блокировку перед использованием значения в m. Тип m — Mutex<i32>, а не i32, поэтому мы должны вызвать lock, чтобы иметь возможность использовать значение i32. Мы не можем забыть; система типов не позволит нам получить доступ к внутреннему i32 иначе.
Вызов lock возвращает тип под названием MutexGuard, обёрнутый в LockResult, который мы обработали вызовом unwrap. Тип MutexGuard реализует Deref, чтобы указывать на наши внутренние данные; тип также имеет реализацию Drop, которая автоматически освобождает блокировку, когда MutexGuard выходит из области видимости, что происходит в конце внутренней области видимости. В результате мы не рискуем забыть освободить блокировку и заблокировать мьютекс от использования другими потоками, потому что освобождение блокировки происходит автоматически.
После снятия блокировки мы можем напечатать значение мьютекса и увидеть, что нам удалось изменить внутренний i32 на 6.
Разделяемый доступ к Mutex<T>
Теперь давайте попробуем разделить значение между несколькими потоками с помощью Mutex<T>. Мы запустим 10 потоков и заставим каждый из них увеличить значение счётчика на 1, так что счётчик пойдёт от 0 до 10. Пример в листинге 16-13 вызовет ошибку компилятора, и мы используем эту ошибку, чтобы узнать больше об использовании Mutex<T> и о том, как Rust помогает нам правильно его использовать.
use std::sync::Mutex;
use std::thread;
fn main() {
let counter = Mutex::new(0);
let mut handles = vec![];
for _ in 0..10 {
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}Mutex<T>Мы создаём переменную counter для хранения i32 внутри Mutex<T>, как мы делали в листинге 16-12. Затем мы создаём 10 потоков, итерируя по диапазону чисел. Мы используем thread::spawn и даём всем потокам одно и то же замыкание: то, которое перемещает счётчик в поток, захватывает блокировку Mutex<T> вызовом метода lock, а затем добавляет 1 к значению в мьютексе. Когда поток завершает выполнение своего замыкания, num выйдет из области видимости и освободит блокировку, чтобы другой поток мог её захватить.
В главном потоке мы собираем все дескрипторы join. Затем, как мы делали в листинге 16-2, мы вызываем join для каждого дескриптора, чтобы убедиться, что все потоки завершились. В этот момент главный поток захватит блокировку и напечатает результат этой программы.
Мы намекнули, что этот пример не скомпилируется. Теперь давайте выясним почему!
$ cargo run
Compiling shared-state v0.1.0 (file:///projects/shared-state)
error[E0382]: borrow of moved value: `counter`
--> src/main.rs:21:29
|
5 | let counter = Mutex::new(0);
| ------- move occurs because `counter` has type `std::sync::Mutex<i32>`, which does not implement the `Copy` trait
...
8 | for _ in 0..10 {
| -------------- inside of this loop
9 | let handle = thread::spawn(move || {
| ------- value moved into closure here, in previous iteration of loop
...
21 | println!("Result: {}", *counter.lock().unwrap());
| ^^^^^^^ value borrowed here after move
For more information about this error, try `rustc --explain E0382`.
error: could not compile `shared-state` (bin "shared-state") due to 1 previous error
Сообщение об ошибке указывает, что значение counter было перемещено в предыдущей итерации цикла. Rust сообщает нам, что мы не можем переместить владение блокировкой counter в несколько потоков. Давайте исправим ошибку компилятора с помощью метода множественного владения, который мы обсуждали в главе 15.
Множественное владение с несколькими потоками
В главе 15 мы дали значение нескольким владельцам, используя умный указатель Rc<T> для создания значения со счётчиком ссылок. Давайте сделаем то же самое здесь и посмотрим, что произойдёт. Мы обернём Mutex<T> в Rc<T> в листинге 16-14 и клонируем Rc<T> перед перемещением владения в поток.
use std::rc::Rc;
use std::sync::Mutex;
use std::thread;
fn main() {
let counter = Rc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let counter = Rc::clone(&counter);
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}Rc<T>, чтобы несколько потоков владели Mutex<T>Снова компилируем и получаем… другие ошибки! Компилятор учит нас многому:
$ cargo run
Compiling shared-state v0.1.0 (file:///projects/shared-state)
error[E0277]: `Rc<std::sync::Mutex<i32>>` cannot be sent between threads safely
--> src/main.rs:11:36
|
11 | let handle = thread::spawn(move || {
| ------------- ^------
| | |
| ______________________|_____________within this `{closure@src/main.rs:11:36: 11:43}`
| | |
| | required by a bound introduced by this call
12 | | let mut num = counter.lock().unwrap();
13 | |
14 | | *num += 1;
15 | | });
| |_________^ `Rc<std::sync::Mutex<i32>>` cannot be sent between threads safely
|
= help: within `{closure@src/main.rs:11:36: 11:43}`, the trait `Send` is not implemented for `Rc<std::sync::Mutex<i32>>`
note: required because it's used within this closure
--> src/main.rs:11:36
|
11 | let handle = thread::spawn(move || {
| ^^^^^^^
note: required by a bound in `spawn`
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/std/src/thread/functions.rs:125:0
For more information about this error, try `rustc --explain E0277`.
error: could not compile `shared-state` (bin "shared-state") due to 1 previous error
Ух, это сообщение об ошибке очень многословное! Вот важная часть, на которой нужно сосредоточиться: `Rc<Mutex<i32>>` cannot be sent between threads safely. Компилятор также сообщает нам причину: the trait `Send` is not implemented for `Rc<Mutex<i32>>`. Мы поговорим о Send в следующем разделе: это один из трейтов, который гарантирует, что типы, которые мы используем с потоками, предназначены для использования в конкурентных ситуациях.
К сожалению, Rc<T> небезопасно разделять между потоками. Когда Rc<T> управляет счётчиком ссылок, он добавляет к счётчику при каждом вызове clone и вычитает из счётчика при каждом удалении клона. Но он не использует никаких примитивов конкурентности, чтобы гарантировать, что изменения счётчика не могут быть прерваны другим потоком. Это может привести к неправильным значениям счётчика — тонким ошибкам, которые, в свою очередь, могут привести к утечкам памяти или к тому, что значение будет удалено до того, как мы закончим с ним. Нам нужен тип, который точно такой же, как Rc<T>, но который изменяет счётчик ссылок потокобезопасным способом.
Атомарный подсчёт ссылок с помощью Arc<T>
К счастью, Arc<T> — это тип, подобный Rc<T>, который безопасно использовать в конкурентных ситуациях. a означает atomic (атомарный), что означает, что это атомарно подсчитываемый ссылками тип. Атомики — это дополнительный вид примитива конкурентности, который мы не будем здесь подробно рассматривать: см. документацию стандартной библиотеки для std::sync::atomic для получения дополнительной информации. На данном этапе вам просто нужно знать, что атомики работают как примитивные типы, но безопасны для разделения между потоками.
Вы могли бы затем задаться вопросом, почему все примитивные типы не являются атомарными и почему типы стандартной библиотеки не реализованы так, чтобы использовать Arc<T> по умолчанию. Причина в том, что потокобезопасность сопряжена с потерей производительности, за которую вы хотите платить только тогда, когда вам это действительно нужно. Если вы просто выполняете операции со значениями в одном потоке, ваш код может работать быстрее, если ему не нужно обеспечивать гарантии, которые предоставляют атомики.
Давайте вернёмся к нашему примеру: Arc<T> и Rc<T> имеют одинаковый API, поэтому мы исправляем нашу программу, изменив строку use, вызов new и вызов clone. Код в листинге 16-15 наконец скомпилируется и запустится.
use std::sync::{Arc, Mutex};
use std::thread;
fn main() {
let counter = Arc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let counter = Arc::clone(&counter);
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}Arc<T> для обёртывания Mutex<T>, чтобы иметь возможность разделять владение между несколькими потокамиЭтот код напечатает следующее:
Result: 10
Мы сделали это! Мы посчитали от 0 до 10, что может показаться не очень впечатляющим, но это научило нас многому о Mutex<T> и потокобезопасности. Вы также можете использовать структуру этой программы для выполнения более сложных операций, чем просто инкремент счётчика. Используя эту стратегию, вы можете разделить вычисление на независимые части, распределить эти части по потокам, а затем использовать Mutex<T>, чтобы каждый поток обновлял окончательный результат своей частью.
Обратите внимание, что если вы выполняете простые числовые операции, есть типы проще, чем типы Mutex<T>, предоставляемые модулем std::sync::atomic стандартной библиотеки. Эти типы обеспечивают безопасный, конкурентный, атомарный доступ к примитивным типам. Мы выбрали использование Mutex<T> с примитивным типом для этого примера, чтобы мы могли сосредоточиться на том, как работает Mutex<T>.
Сравнение RefCell<T>/Rc<T> и Mutex<T>/Arc<T>
Вы могли заметить, что counter неизменяем, но мы могли получить изменяемую ссылку на значение внутри него; это означает, что Mutex<T> обеспечивает внутреннюю изменяемость, как и семейство Cell. Точно так же, как мы использовали RefCell<T> в главе 15, чтобы позволить нам изменять содержимое внутри Rc<T>, мы используем Mutex<T> для изменения содержимого внутри Arc<T>.
Ещё одна деталь, которую следует отметить, — Rust не может защитить вас от всех видов логических ошибок при использовании Mutex<T>. Вспомните из главы 15, что использование Rc<T> сопряжено с риском создания циклов ссылок, где два значения Rc<T> ссылаются друг на друга, вызывая утечки памяти. Аналогично, Mutex<T> сопряжён с риском создания взаимных блокировок (deadlock). Они возникают, когда операция должна заблокировать два ресурса, и два потока уже захватили по одной из блокировок, заставляя их ждать друг друга вечно. Если вас интересуют взаимные блокировки, попробуйте создать программу на Rust, которая имеет взаимную блокировку; затем исследуйте стратегии смягчения взаимных блокировок для мьютексов в любом языке и попробуйте реализовать их на Rust. Документация API стандартной библиотеки для Mutex<T> и MutexGuard предлагает полезную информацию.
Мы завершим эту главу разговором о трейтах Send и Sync и о том, как мы можем использовать их с пользовательскими типами.
Расширяемая конкурентность с Send и Sync
Расширяемая конкурентность с Send и Sync
Интересно, что почти все возможности конкурентности, которые мы обсуждали до сих пор в этой главе, были частью стандартной библиотеки, а не языка. Ваши варианты обработки конкурентности не ограничены языком или стандартной библиотекой; вы можете писать свои собственные возможности конкурентности или использовать те, что написаны другими.
Однако среди ключевых концепций конкурентности, которые встроены в язык,
а не в стандартную библиотеку, есть маркерные трейты std::marker Send и Sync.
Передача владения между потоками
Маркерный трейт Send указывает, что владение значениями типа,
реализующего Send, может быть передано между потоками. Почти каждый тип Rust
реализует Send, но есть некоторые исключения, включая Rc<T>: он
не может реализовать Send, потому что если вы клонировали значение Rc<T> и попытались
передать владение клоном другому потоку, оба потока могли бы одновременно обновлять
счётчик ссылок. По этой причине Rc<T> реализован
для использования в однопоточных ситуациях, где вы не хотите платить
за потерю производительности из-за потокобезопасности.
Следовательно, система типов и ограничения трейтов Rust гарантируют, что вы никогда
случайно не передадите значение Rc<T> между потоками небезопасно. Когда мы пытались
сделать это в листинге 16-14, мы получили ошибку the trait `Send` is not implemented for `Rc<Mutex<i32>>`. Когда мы переключились на Arc<T>, который реализует
Send, код скомпилировался.
Любой тип, полностью состоящий из типов Send, автоматически помечается как Send
также. Почти все примитивные типы являются Send, кроме сырых указателей, которые
мы обсудим в двадцатой главе.
Доступ из нескольких потоков
Маркерный трейт Sync указывает, что безопасно для типа, реализующего
Sync, иметь ссылки из нескольких потоков. Другими словами, любой тип T
реализует Sync, если &T (неизменяемая ссылка на T) реализует Send,
что означает, что ссылку можно безопасно передать другому потоку. Подобно Send,
примитивные типы все реализуют Sync, а типы, полностью состоящие из типов, которые
реализуют Sync, также реализуют Sync.
Умный указатель Rc<T> также не реализует Sync по тем же причинам,
по которым он не реализует Send. Тип RefCell<T> (о котором мы говорили
в пятнадцатой главе) и семейство связанных типов Cell<T> не реализуют
Sync. Реализация проверки заимствований, которую RefCell<T> выполняет во время выполнения,
не является потокобезопасной. Умный указатель Mutex<T> реализует Sync и может
использоваться для совместного доступа из нескольких потоков, как вы видели в разделе «Разделяемый доступ к Mutex<T>».
Ручная реализация Send и Sync небезопасна
Поскольку типы, полностью состоящие из других типов, реализующих трейты Send и
Sync, также автоматически реализуют Send и Sync, нам не нужно
реализовывать эти трейты вручную. Как маркерные трейты, они даже не имеют никаких
методов для реализации. Они просто полезны для обеспечения инвариантов, связанных с
конкурентностью.
Ручная реализация этих трейтов включает написание небезопасного кода Rust.
Мы поговорим об использовании небезопасного кода Rust в двадцатой главе; пока важная
информация состоит в том, что создание новых конкурентных типов, не состоящих из частей Send и
Sync, требует тщательного обдумывания для поддержания гарантий безопасности. «Rustonomicon» содержит больше информации об этих гарантиях и о том, как
их поддерживать.
Итог
Это не последний раз, когда вы увидите конкурентность в этой книге: следующая глава посвящена асинхронному программированию, а проект в двадцать первой главе будет использовать концепции из этой главы в более реалистичной ситуации, чем небольшие примеры, обсуждавшиеся здесь.
Как упоминалось ранее, поскольку очень малая часть того, как Rust обрабатывает конкурентность, является частью языка, многие решения для конкурентности реализованы как крейты. Они развиваются быстрее, чем стандартная библиотека, поэтому обязательно ищите в интернете актуальные, современные крейты для использования в многопоточных ситуациях.
Стандартная библиотека Rust предоставляет каналы для передачи сообщений и умные
указатели, такие как Mutex<T> и Arc<T>, которые безопасно использовать в
конкурентных контекстах. Система типов и проверка заимствований гарантируют, что
код, использующий эти решения, не приведёт к гонкам данных или недопустимым ссылкам.
Как только ваш код скомпилируется, вы можете быть уверены, что он будет спокойно
работать в нескольких потоках без трудно отслеживаемых ошибок, распространённых в
других языках. Конкурентное программирование больше не концепция, которую нужно бояться:
вперёд и делайте свои программы конкурентными, бесстрашно!
Основы асинхронного программирования: async, await, фьючерсы и стримы
Основы асинхронного программирования: async, await, фьючерсы и стримы
Многие операции, которые мы просим компьютер выполнить, могут занять некоторое время. Было бы неплохо, если бы мы могли делать что-то ещё, пока ждём завершения этих длительных процессов. Современные компьютеры предлагают две техники для работы более чем с одной операцией одновременно: параллелизм и конкурентность. Однако логика наших программ написана в основном линейным образом. Мы хотели бы иметь возможность указать операции, которые программа должна выполнить, и точки, в которых функция может приостановиться, а какая-то другая часть программы могла бы выполняться вместо неё, без необходимости заранее точно указывать порядок и способ выполнения каждого фрагмента кода. Асинхронное программирование — это абстракция, которая позволяет нам выражать наш код в терминах потенциальных точек приостановки и итоговых результатов, беря на себя детали координации за нас.
Эта глава строится на использовании потоков в главе 16 для параллелизма и конкурентности, вводя альтернативный подход к написанию кода: фьючерсы, стримы в Rust и синтаксис async и await, которые позволяют нам выражать, как операции могут быть асинхронными, а также сторонние крейты, реализующие асинхронные рантаймы: код, который управляет и координирует выполнение асинхронных операций.
Рассмотрим пример. Допустим, вы экспортируете видео, которое вы создали на семейном празднике, — операция, которая может занять от нескольких минут до нескольких часов. Экспорт видео будет использовать столько мощности CPU и GPU, сколько сможет. Если бы у вас был только один ядер CPU, и ваша операционная система не приостанавливала бы этот экспорт до его завершения — то есть если бы она выполняла экспорт синхронно, — вы не могли бы делать ничего другого на вашем компьютере, пока эта задача выполняется. Это был бы довольно разочаровывающий опыт. К счастью, операционная система вашего компьютера может и делает это — она невидимо прерывает экспорт достаточно часто, чтобы вы могли одновременно выполнять другую работу.
Теперь допустим, вы скачиваете видео, которым поделился кто-то другой, что также может занять некоторое время, но не занимает столько времени CPU. В этом случае CPU должен ждать поступления данных из сети. Хотя вы можете начать читать данные, как только они начнут поступать, может потребоваться некоторое время, чтобы все они появились. Даже когда все данные присутствуют, если видео довольно большое, может потребоваться по крайней мере секунда или две, чтобы загрузить его полностью. Это может звучать не так уж много, но это очень долгое время для современного процессора, который может выполнять миллиарды операций каждую секунду. Опять же, ваша операционная система невидимо прервёт вашу программу, чтобы позволить CPU выполнять другую работу, пока ожидается завершение сетевого вызова.
Экспорт видео — это пример операции, ограниченной CPU или ограниченной вычислениями. Она ограничена потенциальной скоростью обработки данных компьютером в CPU или GPU и тем, сколько этой скорости он может выделить для операции. Скачивание видео — это пример операции, ограниченной вводом-выводом, потому что она ограничена скоростью ввода и вывода компьютера; она может идти только так быстро, как данные могут быть переданы по сети.
В обоих этих примерах невидимые прерывания операционной системы обеспечивают форму конкурентности. Однако эта конкурентность происходит только на уровне всей программы: операционная система прерывает одну программу, чтобы другие программы могли выполнять работу. Во многих случаях, поскольку мы понимаем наши программы на гораздо более детальном уровне, чем операционная система, мы можем заметить возможности для конкурентности, которые операционная система не видит.
Например, если мы создаём инструмент для управления загрузкой файлов, мы должны быть в состоянии написать нашу программу так, чтобы запуск одной загрузки не блокировал пользовательский интерфейс, и пользователи могли запускать несколько загрузок одновременно. Однако многие API операционной системы для взаимодействия с сетью являются блокирующими; то есть они блокируют продвижение программы до тех пор, пока обрабатываемые ими данные не будут полностью готовы.
Примечание: Именно так работает большинство вызовов функций, если подумать. Однако термин блокирующий обычно зарезервирован для вызовов функций, которые взаимодействуют с файлами, сетью или другими ресурсами на компьютере, потому что именно в этих случаях отдельная программа выиграла бы от того, чтобы операция была не-блокирующей.
Мы могли бы избежать блокировки нашего основного потока, запустив выделенный поток для загрузки каждого файла. Однако накладные расходы системных ресурсов, используемых этими потоками, в конечном итоге станут проблемой. Было бы предпочтительнее, если бы вызов изначально не блокировал, а вместо этого мы могли бы определить ряд задач, которые мы хотели бы, чтобы наша программа выполнила, и позволить рантайму выбрать лучший порядок и способ их выполнения.
Именно это даёт нам абстракция async (сокращение от asynchronous) в Rust. В этой главе вы узнаете всё об async, пока мы рассматриваем следующие темы:
- Как использовать синтаксис
asyncиawaitв Rust и выполнять асинхронные функции с помощью рантайма - Как использовать модель async для решения некоторых из тех же задач, которые мы рассматривали в главе 16
- Как многопоточность и async предоставляют взаимодополняющие решения, которые вы можете комбинировать во многих случаях
Однако прежде чем мы увидим, как async работает на практике, нам нужно сделать небольшое отступление, чтобы обсудить различия между параллелизмом и конкурентностью.
Параллелизм и конкурентность
До сих пор мы относились к параллелизму и конкурентности как в основном к взаимозаменяемым понятиям. Теперь нам нужно более точно различать их, потому что различия проявятся, когда мы начнём работать.
Рассмотрим различные способы, которыми команда могла бы разделить работу над программным проектом. Вы могли бы назначить одному члену несколько задач, назначить каждому члену одну задачу или использовать смесь этих двух подходов.
Когда отдельный человек работает над несколькими различными задачами до того, как какая-либо из них завершена, это конкурентность. Один из способов реализовать конкурентность похож на то, как если бы у вас было два разных проекта, извлечённых на ваш компьютер, и когда вам становится скучно или вы застреваете на одном проекте, вы переключаетесь на другой. Вы всего один человек, поэтому вы не можете продвигаться по обеим задачам в одно и то же время, но вы можете выполнять многозадачность, продвигаясь по одной за раз, переключаясь между ними (см. рисунок 17-1).
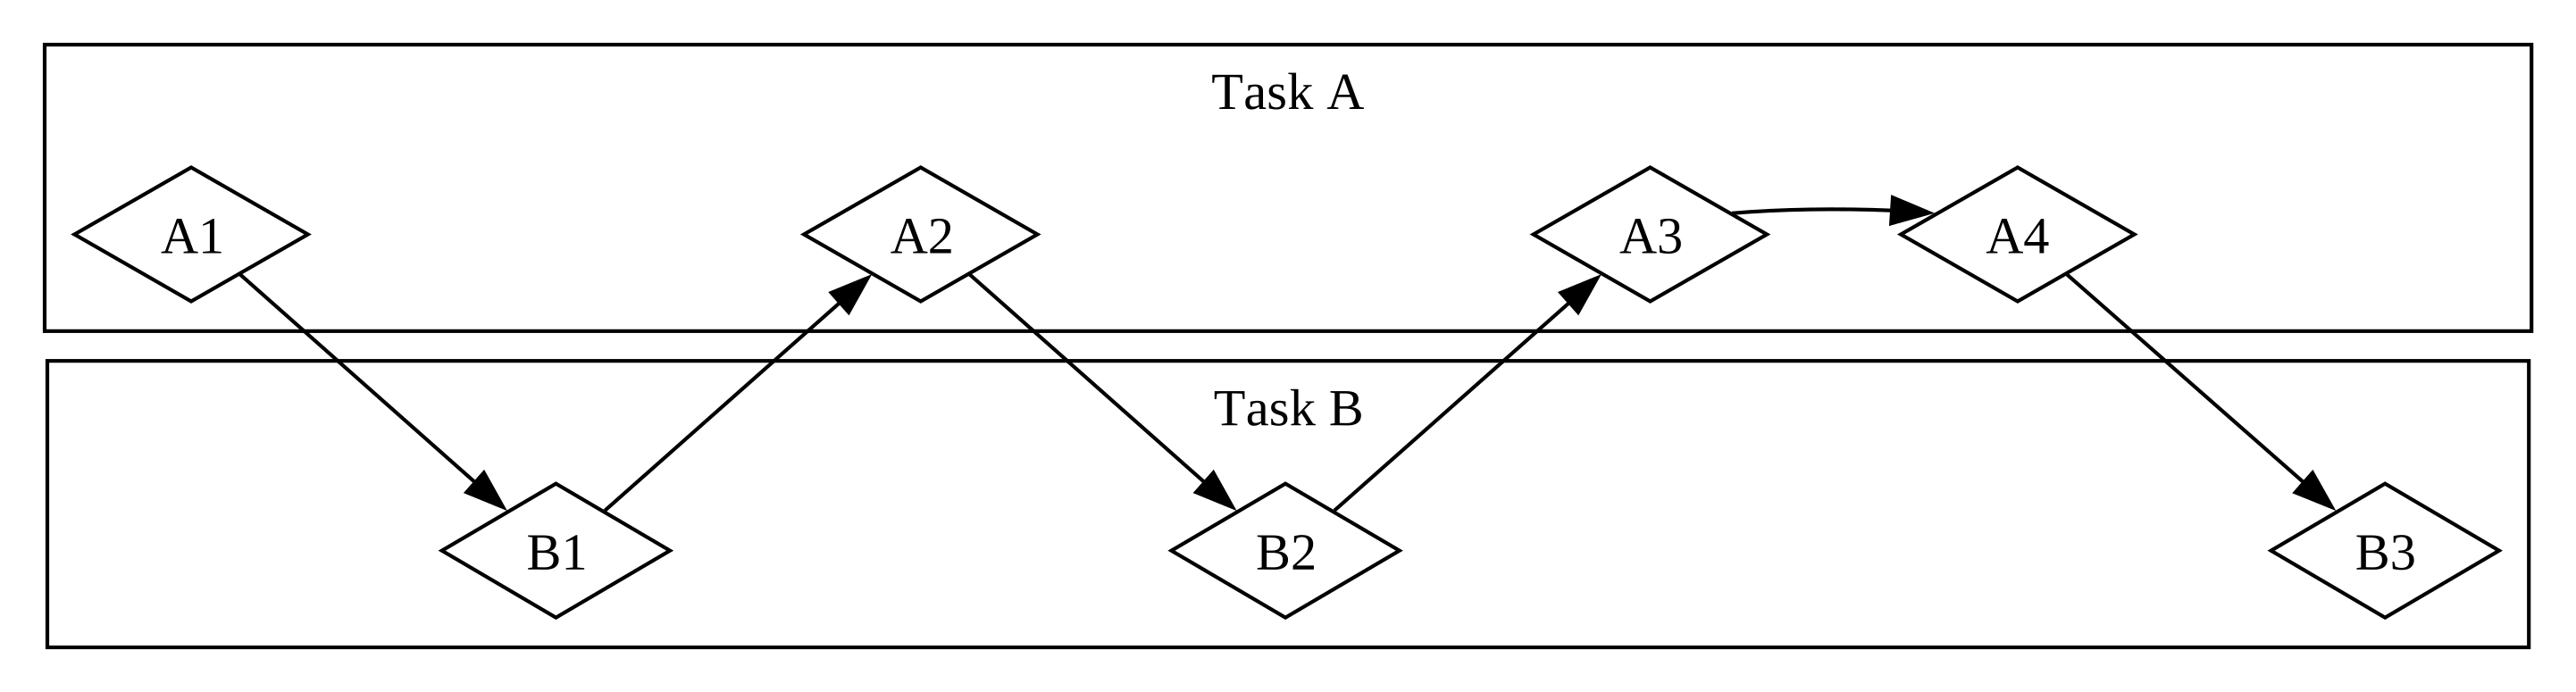
Когда команда разделяет группу задач, позволяя каждому члену взять одну задачу и работать над ней самостоятельно, это параллелизм. Каждый человек в команде может продвигаться в одно и то же время (см. рисунок 17-2).
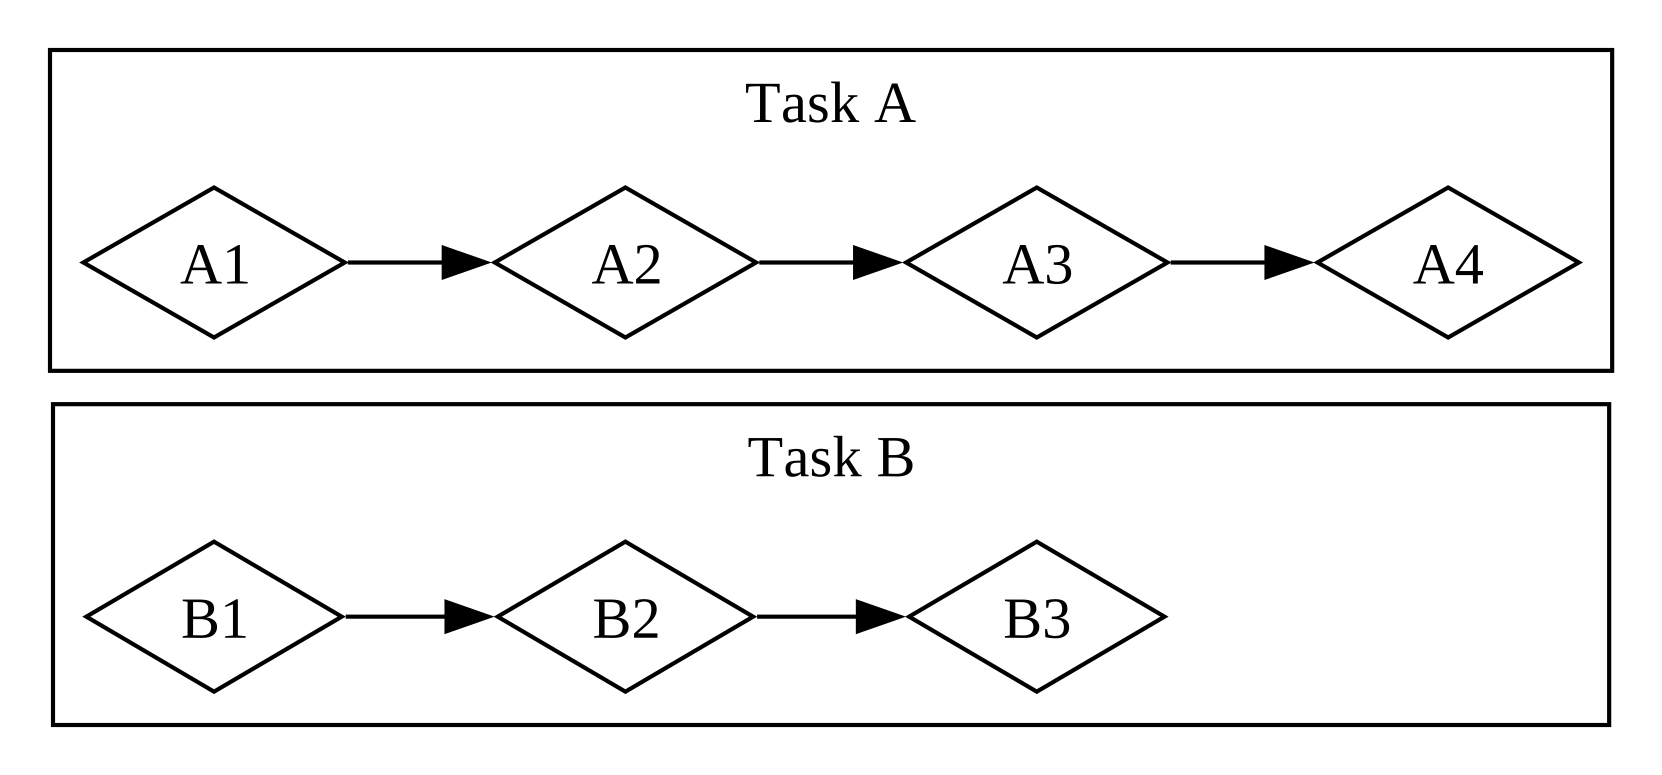
В обоих этих рабочих процессах вам может потребоваться координация между различными задачами. Возможно, вы думали, что задача, назначенная одному человеку, полностью независима от работы всех остальных, но на самом деле для её выполнения сначала требуется, чтобы другой человек в команде завершил свою задачу. Некоторую часть работы можно было бы выполнить параллельно, но некоторая часть на самом деле была последовательной: она могла происходить только последовательно, одна задача за другой, как на рисунке 17-3.
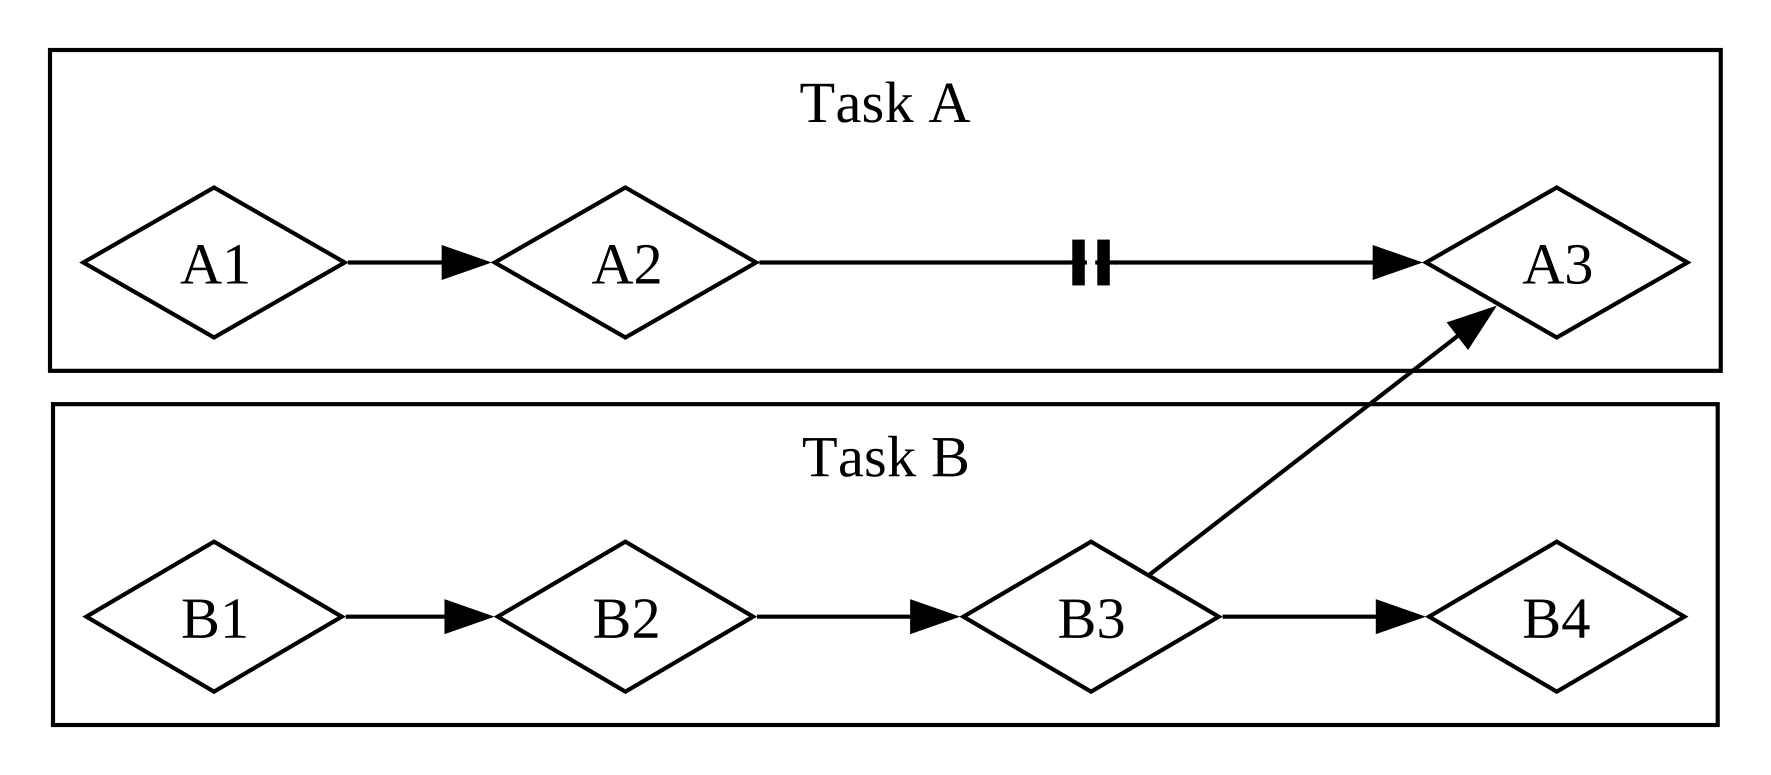
Аналогично, вы можете понять, что одна из ваших собственных задач зависит от другой вашей задачи. Теперь ваша конкурентная работа также стала последовательной.
Параллелизм и конкурентность могут также пересекаться друг с другом. Если вы узнаёте, что коллега застрял, пока вы не завершите одну из ваших задач, вы, вероятно, сосредоточите все свои усилия на этой задаче, чтобы «разблокировать» вашего коллегу. Вы и ваш коллега больше не можете работать параллельно, и вы также больше не можете работать конкурентно над своими собственными задачами.
Та же базовая динамика действует в программном обеспечении и аппаратном обеспечении. На машине с одним ядром CPU процессор может выполнять только одну операцию за раз, но он всё ещё может работать конкурентно. Используя такие инструменты, как потоки, процессы и async, компьютер может приостанавливать одну активность и переключаться на другие, прежде чем в конечном итоге вернуться к этой первой активности. На машине с несколькими ядрами CPU он также может выполнять работу параллельно. Одно ядро может выполнять одну задачу, в то время как другое ядро выполняет совершенно не связанную с ней задачу, и эти операции на самом деле происходят одновременно.
Выполнение асинхронного кода в Rust обычно происходит конкурентно. В зависимости от аппаратного обеспечения, операционной системы и используемого нами асинхронного рантайма (подробнее об асинхронных рантаймах вскоре) эта конкурентность может также использовать параллелизм под капотом.
Теперь давайте погрузимся в то, как асинхронное программирование в Rust на самом деле работает.
Фьючерсы и синтаксис async
Фьючерсы и синтаксис async
Ключевыми элементами асинхронного программирования в Rust являются фьючерсы и ключевые слова async и await.
Фьючерс — это значение, которое может быть не готово сейчас, но станет готово в какой-то момент в будущем. (Та же концепция появляется во многих языках, иногда под другими именами, такими как задача или обещание.) Rust предоставляет трейт Future в качестве строительного блока, чтобы различные асинхронные операции могли быть реализованы с помощью различных структур данных, но с общим интерфейсом. В Rust фьючерсы — это типы, которые реализуют трейт Future. Каждый фьючерс хранит свою собственную информацию о достигнутом прогрессе и о том, что означает «готово».
Вы можете применить ключевое слово async к блокам и функциям, чтобы указать, что они могут быть прерваны и возобновлены. Внутри асинхронного блока или асинхронной функции вы можете использовать ключевое слово await, чтобы ожидать фьючерс (то есть ждать, пока он станет готовым). Любая точка, где вы ожидаете фьючерс внутри асинхронного блока или функции, — это потенциальное место для приостановки и возобновления этого блока или функции. Процесс проверки фьючерса на предмет того, доступно ли его значение, называется опросом (polling).
Некоторые другие языки, такие как C# и JavaScript, также используют ключевые слова async и await для асинхронного программирования. Если вы знакомы с этими языками, вы можете заметить некоторые существенные различия в том, как Rust обрабатывает синтаксис. И на это есть веские причины, как мы увидим!
При написании асинхронного кода на Rust мы большую часть времени используем ключевые слова async и await. Rust компилирует их в эквивалентный код с использованием трейта Future, точно так же, как он компилирует циклы for в эквивалентный код с использованием трейта Iterator. Однако, поскольку Rust предоставляет трейт Future, вы также можете реализовать его для своих собственных типов данных, когда вам это нужно. Многие функции, которые мы увидим в этой главе, возвращают типы с собственными реализациями Future. Мы вернёмся к определению трейта в конце главы и подробнее разберём, как он работает, но этих деталей достаточно, чтобы двигаться вперёд.
Всё это может показаться немного абстрактным, поэтому давайте напишем нашу первую асинхронную программу: небольшой веб-скрапер. Мы передадим два URL-адреса из командной строки, конкурентно извлечём их оба и вернём результат того, который завершится первым. В этом примере будет довольно много нового синтаксиса, но не волнуйтесь — мы объясним всё, что вам нужно знать, по ходу дела.
Наша первая асинхронная программа
Чтобы сосредоточить главу на изучении async, а не на жонглировании частями экосистемы, мы создали крейт trpl (trpl — сокращение от «The Rust Programming Language»). Он реэкспортирует все типы, трейты и функции, которые вам понадобятся, в первую очередь из крейтов futures и tokio. Крейт futures — официальный дом для экспериментов с асинхронным кодом на Rust, и именно там изначально был спроектирован трейт Future. Tokio — это наиболее широко используемый асинхронный рантайм в Rust на сегодняшний день, особенно для веб-приложений. Есть и другие отличные рантаймы, и они могут быть более подходящими для ваших целей. Мы используем крейт tokio под капотом trpl, потому что он хорошо протестирован и широко используется.
В некоторых случаях trpl также переименовывает или оборачивает оригинальные API, чтобы сосредоточить ваше внимание на деталях, относящихся к этой главе. Если вы хотите понять, что делает крейт, мы рекомендуем вам ознакомиться с его исходным кодом. Вы сможете увидеть, из какого крейта происходит каждый реэкспорт, и мы оставили подробные комментарии, объясняющие, что делает крейт.
Создайте новый бинарный проект с именем hello-async и добавьте крейт trpl в качестве зависимости:
$ cargo new hello-async
$ cd hello-async
$ cargo add trpl
Теперь мы можем использовать различные части, предоставляемые trpl, чтобы написать нашу первую асинхронную программу. Мы создадим небольшой инструмент командной строки, который извлекает две веб-страницы, извлекает элемент <title> из каждой и печатает заголовок той страницы, которая завершит весь этот процесс первой.
Определение функции page_title
Давайте начнём с написания функции, которая принимает один URL страницы в качестве параметра, делает запрос к нему и возвращает текст элемента <title> (см. Листинг 17-1).
extern crate trpl; // required for mdbook test
fn main() {
// TODO: добавим это следующим шагом!
}
use trpl::Html;
async fn page_title(url: &str) -> Option<String> {
let response = trpl::get(url).await;
let response_text = response.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}<title> с HTML-страницыСначала мы определяем функцию с именем page_title и помечаем её ключевым словом async. Затем мы используем функцию trpl::get, чтобы получить любой переданный URL, и добавляем ключевое слово await, чтобы дождаться ответа. Чтобы получить текст response, мы вызываем его метод text и снова ожидаем его с помощью ключевого слова await. Оба этих шага асинхронны. Для функции get нам нужно дождаться, пока сервер отправит обратно первую часть своего ответа, которая будет включать HTTP-заголовки, cookie и так далее, и может быть доставлена отдельно от тела ответа. Особенно если тело очень большое, может потребоваться некоторое время, чтобы всё оно прибыло. Поскольку нам нужно дождаться всего ответа, метод text также асинхронный.
Мы должны явно ожидать оба этих фьючерса, потому что фьючерсы в Rust ленивы: они ничего не делают, пока вы не попросите их с помощью ключевого слова await. (На самом деле, Rust выдаст предупреждение компилятора, если вы не используете фьючерс.) Это может напомнить вам обсуждение итераторов в разделе «Обработка последовательности элементов с помощью итераторов» главы 13. Итераторы ничего не делают, пока вы не вызовете их метод next — напрямую или с помощью циклов for или методов, таких как map, которые используют next под капотом. Точно так же фьючерсы ничего не делают, пока вы явно их не попросите. Эта ленивость позволяет Rust избегать выполнения асинхронного кода, пока он действительно не понадобится.
Примечание: Это отличается от поведения, которое мы видели при использовании thread::spawn в разделе «Создание нового потока с помощью spawn» главы 16, где замыкание, которое мы передали другому потоку, начинало выполняться немедленно. Это также отличается от того, как многие другие языки подходят к async. Но для Rust важно иметь возможность предоставлять свои гарантии производительности, так же как и с итераторами.
Как только у нас есть response_text, мы можем разобрать его в экземпляр типа Html с помощью Html::parse. Вместо необработанной строки у нас теперь есть тип данных, который мы можем использовать для работы с HTML как с более богатой структурой данных. В частности, мы можем использовать метод select_first, чтобы найти первое вхождение заданного CSS-селектора. Передав строку "title", мы получим первый элемент <title> в документе, если он есть. Поскольку соответствующего элемента может не быть, select_first возвращает Option<ElementRef>. Наконец, мы используем метод Option::map, который позволяет нам работать с элементом в Option, если он присутствует, и ничего не делать, если его нет. (Мы также могли бы использовать здесь выражение match, но map более идиоматичен.) В теле функции, которую мы передаём в map, мы вызываем inner_html у title, чтобы получить его содержимое, которое является String. В конечном итоге у нас есть Option<String>.
Обратите внимание, что ключевое слово await в Rust ставится после выражения, которого вы ожидаете, а не перед ним. То есть это постфиксное ключевое слово. Это может отличаться от того, к чему вы привыкли, если вы использовали async в других языках, но в Rust это делает цепочки методов гораздо более удобными для работы. В результате мы могли бы изменить тело page_title, чтобы объединить вызовы функций trpl::get и text с await между ними, как показано в листинге 17-2.
extern crate trpl; // required for mdbook test
use trpl::Html;
fn main() {
// TODO: добавим это следующим шагом!
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}awaitС этим мы успешно написали нашу первую асинхронную функцию! Прежде чем мы добавим некоторый код в main, чтобы вызвать её, давайте немного поговорим о том, что мы написали и что это значит.
Когда Rust видит блок, помеченный ключевым словом async, он компилирует его в уникальный анонимный тип данных, который реализует трейт Future. Когда Rust видит функцию, помеченную async, он компилирует её в неасинхронную функцию, тело которой является асинхронным блоком. Тип возвращаемого значения асинхронной функции — это тип анонимного типа данных, который компилятор создаёт для этого асинхронного блока.
Таким образом, написание async fn эквивалентно написанию функции, которая возвращает фьючерс возвращаемого типа. Для компилятора определение функции, такое как async fn page_title в листинге 17-1, примерно эквивалентно неасинхронной функции, определённой следующим образом:
#![allow(unused)]
fn main() {
extern crate trpl; // required for mdbook test
use std::future::Future;
use trpl::Html;
fn page_title(url: &str) -> impl Future<Output = Option<String>> {
async move {
let text = trpl::get(url).await.text().await;
Html::parse(&text)
.select_first("title")
.map(|title| title.inner_html())
}
}
}Давайте пройдёмся по каждой части преобразованной версии:
- Она использует синтаксис
impl Trait, который мы обсуждали в главе 10 в разделе «Трейты как параметры». - Возвращаемое значение реализует трейт
Futureсо связанным типомOutput. Обратите внимание, что типOutput— этоOption<String>, который совпадает с оригинальным возвращаемым типом из версииasync fnфункцииpage_title. - Весь код, вызываемый в теле оригинальной функции, обёрнут в блок
async move. Помните, что блоки — это выражения. Весь этот блок — это выражение, возвращаемое из функции. - Этот асинхронный блок создаёт значение с типом
Option<String>, как только что было описано. Это значение соответствует типуOutputв возвращаемом типе. Это точно так же, как и другие блоки, которые вы видели. - Тело новой функции — это блок
async moveиз-за того, как он использует параметрurl. (Мы поговорим гораздо больше оasyncпротивasync moveпозже в главе.)
Теперь мы можем вызвать page_title в main.
Выполнение асинхронной функции с помощью рантайма
Для начала мы получим заголовок одной страницы, как показано в листинге 17-3. К сожалению, этот код ещё не компилируется.
extern crate trpl; // required for mdbook test
use trpl::Html;
async fn main() {
let args: Vec<String> = std::env::args().collect();
let url = &args[1];
match page_title(url).await {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}page_title из main с аргументом, предоставленным пользователемМы следуем тому же шаблону, который использовали для получения аргументов командной строки в разделе «Приём аргументов командной строки» главы 12. Затем мы передаём аргумент URL в page_title и ожидаем результат. Поскольку значение, создаваемое фьючерсом, — это Option<String>, мы используем выражение match, чтобы напечатать разные сообщения в зависимости от того, был ли у страницы <title>.
Единственное место, где мы можем использовать ключевое слово await, — это асинхронные функции или блоки, и Rust не позволит нам пометить специальную функцию main как async.
error[E0752]: `main` function is not allowed to be `async`
--> src/main.rs:6:1
|
6 | async fn main() {
| ^^^^^^^^^^^^^^^ `main` function is not allowed to be `async`
Причина, по которой main нельзя помечать как async, заключается в том, что асинхронному коду нужен рантайм: крейт Rust, который управляет деталями выполнения асинхронного кода. Функция main программы может инициализировать рантайм, но она не является рантаймом сама по себе. (Мы увидим больше о том, почему это так, чуть позже.) Каждая программа на Rust, которая выполняет асинхронный код, имеет как минимум одно место, где она настраивает рантайм, который выполняет фьючерсы.
Большинство языков, поддерживающих async, включают рантайм в комплект, но Rust — нет. Вместо этого есть много различных доступных асинхронных рантаймов, каждый из которых делает разные компромиссы, подходящие для варианта использования, на который он нацелен. Например, высокопроизводительный веб-сервер с множеством ядер CPU и большим объёмом RAM имеет совершенно иные потребности, чем микроконтроллер с одним ядром, небольшим объёмом RAM и без возможности выделения памяти в куче. Крейты, которые предоставляют эти рантаймы, также часто поставляют асинхронные версии общей функциональности, такой как файловый или сетевой ввод-вывод.
Здесь и на протяжении всей остальной части главы мы будем использовать функцию block_on из крейта trpl, которая принимает фьючерс в качестве аргумента и блокирует текущий поток до тех пор, пока этот фьючерс не выполнится до завершения. Под капотом вызов block_on настраивает рантайм с использованием крейта tokio, который используется для выполнения переданного фьючерса (поведение block_on в крейте trpl аналогично функциям block_on других крейтов рантаймов). Как только фьючерс завершается, block_on возвращает то значение, которое создал фьючерс.
Мы могли бы передать фьючерс, возвращаемый page_title, непосредственно в block_on и, как только он завершится, сопоставить полученный Option<String>, как мы пытались сделать в листинге 17-3. Однако для большинства примеров в главе (и для большей части асинхронного кода в реальном мире) мы будем делать больше, чем просто один вызов асинхронной функции, поэтому вместо этого мы передадим асинхронный блок и явно ожидаем результат вызова page_title, как в листинге 17-4.
extern crate trpl; // required for mdbook test
use trpl::Html;
fn main() {
let args: Vec<String> = std::env::args().collect();
trpl::block_on(async {
let url = &args[1];
match page_title(url).await {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
})
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}trpl::block_onКогда мы запускаем этот код, мы получаем поведение, которое изначально ожидали:
$ cargo run -- "https://www.rust-lang.org"
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.05s
Running `target/debug/async_await 'https://www.rust-lang.org'`
The title for https://www.rust-lang.org was
Rust Programming Language
Уф — наконец-то у нас есть работающий асинхронный код! Но прежде чем мы добавим код, чтобы устроить гонку между двумя сайтами, давайте ненадолго вернём наше внимание к тому, как работают фьючерсы.
Каждая точка await — то есть каждое место, где код использует ключевое слово await, — представляет собой место, где управление возвращается рантайму. Чтобы это работало, Rust должен отслеживать состояние, задействованное в асинхронном блоке, так чтобы рантайм мог запустить некоторую другую работу, а затем вернуться, когда будет готов снова попытаться продвинуть первый. Это невидимая машина состояний, как если бы вы написали перечисление, подобное этому, чтобы сохранить текущее состояние в каждой точке await:
#![allow(unused)]
fn main() {
extern crate trpl; // required for mdbook test
enum PageTitleFuture<'a> {
Initial { url: &'a str },
GetAwaitPoint { url: &'a str },
TextAwaitPoint { response: trpl::Response },
}
}Написание кода для перехода между каждым состоянием вручную было бы утомительным и подверженным ошибкам, однако, особенно когда вам нужно добавить больше функциональности и больше состояний в код позже. К счастью, компилятор Rust автоматически создаёт и управляет структурами данных машины состояний для асинхронного кода. Обычные правила заимствования и владения вокруг структур данных по-прежнему применяются, и, к счастью, компилятор также проверяет их за нас и предоставляет полезные сообщения об ошибках. Мы разберём некоторые из них позже в главе.
В конечном итоге что-то должно выполнять эту машину состояний, и это что-то — рантайм. (Вот почему вы можете встретить упоминания исполнителей при изучении рантаймов: исполнитель — это часть рантайма, ответственная за выполнение асинхронного кода.)
Теперь вы можете понять, почему компилятор остановил нас от того, чтобы сделать main самой асинхронной функцией в листинге 17-3. Если бы main была асинхронной функцией, что-то другое должно было бы управлять машиной состояний для любого фьючерса, возвращаемого main, но main — это отправная точка программы! Вместо этого мы вызвали функцию trpl::block_on в main, чтобы настроить рантайм и выполнить фьючерс, возвращаемый асинхронным блоком, до его завершения.
Примечание: Некоторые рантаймы предоставляют макросы, так что вы можете написать асинхронную функцию main. Эти макросы переписывают async fn main() { ... } в обычную fn main, которая делает то же, что мы сделали вручную в листинге 17-4: вызывает функцию, которая выполняет фьючерс до завершения так же, как это делает trpl::block_on.
Теперь давайте соберём эти части вместе и посмотрим, как мы можем написать конкурентный код.
Гонка двух URL-адресов друг с другом конкурентно
В листинге 17-5 мы вызываем page_title с двумя разными URL-адресами, переданными из командной строки, и устраиваем гонку между ними, выбирая тот фьючерс, который завершится первым.
extern crate trpl; // required for mdbook test
use trpl::{Either, Html};
fn main() {
let args: Vec<String> = std::env::args().collect();
trpl::block_on(async {
let title_fut_1 = page_title(&args[1]);
let title_fut_2 = page_title(&args[2]);
let (url, maybe_title) =
match trpl::select(title_fut_1, title_fut_2).await {
Either::Left(left) => left,
Either::Right(right) => right,
};
println!("{url} returned first");
match maybe_title {
Some(title) => println!("Its page title was: '{title}'"),
None => println!("It had no title."),
}
})
}
async fn page_title(url: &str) -> (&str, Option<String>) {
let response_text = trpl::get(url).await.text().await;
let title = Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html());
(url, title)
}page_title для двух URL-адресов, чтобы увидеть, какой вернётся первымМы начинаем с вызова page_title для каждого из URL-адресов, предоставленных пользователем. Мы сохраняем полученные фьючерсы как title_fut_1 и title_fut_2. Помните, они пока ничего не делают, потому что фьючерсы ленивы, и мы ещё не ожидали их. Затем мы передаём фьючерсы в trpl::select, который возвращает значение, указывающее, какой из переданных ему фьючерсов завершится первым.
Примечание: Под капотом trpl::select построен на более общей функции select, определённой в крейте futures. Функция select крейта futures может делать много вещей, которые не может делать функция trpl::select, но она также имеет дополнительную сложность, которую мы можем пока пропустить.
Любой фьючерс может законно «победить», поэтому не имеет смысла возвращать Result. Вместо этого trpl::select возвращает тип, который мы раньше не видели, — trpl::Either. Тип Either несколько похож на Result тем, что имеет два случая. Однако в отличие от Result в Either нет понятия успеха или неудачи. Вместо этого он использует Left и Right, чтобы указать «одно или другое»:
#![allow(unused)]
fn main() {
enum Either<A, B> {
Left(A),
Right(B),
}
}Функция select возвращает Left с выходным значением этого фьючерса, если побеждает первый аргумент, и Right с выходным значением второго аргумента фьючерса, если побеждает он. Это соответствует порядку, в котором аргументы появляются при вызове функции: первый аргумент находится слева от второго.
Мы также обновили page_title, чтобы она возвращала тот же URL, который был передан. Таким образом, если страница, которая вернётся первой, не имеет <title>, который мы можем получить, мы всё равно можем напечатать осмысленное сообщение. С этой информацией мы завершаем, обновляя наш вывод println!, чтобы указать, какой URL завершился первым и какой, если он есть, <title> у веб-страницы по этому URL.
Вы создали небольшой работающий веб-скрапер! Выберите пару URL-адресов и запустите инструмент командной строки. Вы можете обнаружить, что некоторые сайты стабильно быстрее других, в то время как в других случаях более быстрый сайт меняется от запуска к запуску. Что более важно, вы изучили основы работы с фьючерсами, так что теперь мы можем углубиться в то, что мы можем делать с async.
Применение конкурентности с async
Применение конкурентности с async
В этом разделе мы применим async к некоторым из тех же задач конкурентности, которые мы решали с потоками в главе 16. Поскольку мы уже говорили о многих ключевых идеях там, в этом разделе мы сосредоточимся на том, что отличается между потоками и фьючерсами.
Во многих случаях API для работы с конкурентностью с помощью async очень похожи на API для работы с потоками. В других случаях они оказываются довольно разными. Даже когда API выглядят похожими между потоками и async, они часто ведут себя по-разному — и почти всегда имеют разные характеристики производительности.
Создание новой задачи с помощью spawn_task
Первая операция, которую мы рассмотрели в разделе «Создание нового потока с помощью spawn» в главе 16, была подсчёт на двух отдельных потоках. Давайте сделаем то же самое с помощью async. Крейт trpl предоставляет функцию spawn_task, которая выглядит очень похоже на API thread::spawn, и функцию sleep, которая является async-версией API thread::sleep. Мы можем использовать их вместе, чтобы реализовать пример подсчёта, как показано в листинге 17-6.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
trpl::spawn_task(async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
}В качестве отправной точки мы настроили нашу функцию main с помощью trpl::block_on, чтобы наша функция верхнего уровня могла быть async.
Примечание: С этого момента в главе каждый пример будет включать этот же самый оборачивающий код с trpl::block_on в main, поэтому мы часто будем его пропускать, как мы это делаем с main. Не забудьте включить его в свой код!
Затем мы пишем два цикла внутри этого блока, каждый содержит вызов trpl::sleep, который ждёт полсекунды (500 миллисекунд) перед отправкой следующего сообщения. Мы помещаем один цикл в тело trpl::spawn_task, а другой — в цикл for верхнего уровня. Мы также добавляем await после вызовов sleep.
Этот код ведёт себя аналогично реализации на потоках — включая тот факт, что вы можете увидеть сообщения в другом порядке в вашем собственном терминале при запуске:
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
Эта версия останавливается, как только цикл for в теле главного async-блока завершается, потому что задача, порождённая spawn_task, завершается при завершении функции main. Если вы хотите, чтобы она выполнялась до самого завершения задачи, вам нужно будет использовать дескриптор соединения (join handle), чтобы дождаться завершения первой задачи. С потоками мы использовали метод join, чтобы «заблокироваться» до того, как поток закончит работу. В листинге 17-7 мы можем использовать await, чтобы сделать то же самое, потому что сам дескриптор задачи является фьючерсом. Его тип Output — это Result, поэтому мы также разворачиваем его (unwrap) после await.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let handle = trpl::spawn_task(async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
handle.await.unwrap();
});
}await с дескриптором соединения для выполнения задачи до завершенияЭта обновлённая версия выполняется до тех пор, пока оба цикла не завершатся:
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
До сих пор похоже, что async и потоки дают нам схожие результаты, только с другим синтаксисом: использование await вместо вызова join на дескрипторе соединения и ожидание вызовов sleep.
Более существенное отличие в том, что нам не нужно было порождать другой поток операционной системы, чтобы сделать это. На самом деле нам даже не нужно порождать здесь задачу. Поскольку async-блоки компилируются в анонимные фьючерсы, мы можем поместить каждый цикл в async-блок и позволить среде выполнения выполнить оба до завершения с помощью функции trpl::join.
В разделе «Ожидание завершения всех потоков» в главе 16 мы показали, как использовать метод join на типе JoinHandle, возвращаемом при вызове std::thread::spawn. Функция trpl::join похожа, но для фьючерсов. Когда вы передаёте ей два фьючерса, она создаёт один новый фьючерс, вывод которого — кортеж, содержащий вывод каждого фьючерса, который вы передали, как только они оба завершатся. Таким образом, в листинге 17-8 мы используем trpl::join, чтобы дождаться завершения обоих fut1 и fut2. Мы не ожидаем fut1 и fut2, а вместо этого новый фьючерс, созданный trpl::join. Мы игнорируем вывод, потому что это просто кортеж, содержащий два единичных значения.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let fut1 = async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
};
let fut2 = async {
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
};
trpl::join(fut1, fut2).await;
});
}trpl::join для ожидания двух анонимных фьючерсовКогда мы запускаем это, мы видим, что оба фьючерса выполняются до завершения:
hi number 1 from the first task!
hi number 1 from the second task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
Теперь вы будете видеть одинаковый порядок каждый раз, что сильно отличается от того, что мы видели с потоками и с trpl::spawn_task в листинге 17-7. Это потому, что функция trpl::join справедлива: она проверяет каждый фьючерс одинаково часто, чередуя их, и никогда не позволяет одному обогнать другого, если другой готов. С потоками операционная система решает, какой поток проверять и как долго ему работать. С async Rust среда выполнения решает, какую задачу проверять. (На практике детали усложняются, потому что async-среда выполнения может использовать потоки операционной системы под капотом как часть того, как она управляет конкурентностью, поэтому гарантировать справедливость может быть больше работы для среды выполнения — но это всё равно возможно!) Среды выполнения не обязаны гарантировать справедливость для любой данной операции, и они часто предлагают разные API, позволяющие вам выбирать, хотите вы справедливости или нет.
Попробуйте некоторые из этих вариаций ожидания фьючерсов и посмотрите, что они делают:
- Удалите async-блок из одного или обоих циклов.
- Ожидайте каждый async-блок сразу после его определения.
- Оберните только первый цикл в async-блок и ожидайте получившийся фьючерс после тела второго цикла.
В качестве дополнительной задачи попробуйте разобраться, каким будет вывод в каждом случае до запуска кода!
Отправка данных между двумя задачами с помощью передачи сообщений
Обмен данными между фьючерсами также будет знаком: мы снова будем использовать передачу сообщений, но на этот раз с async-версиями типов и функций. Мы пойдём несколько иным путём, чем в разделе «Передача данных между потоками с помощью передачи сообщений» в главе 16, чтобы проиллюстрировать некоторые ключевые различия между конкурентностью на основе потоков и конкурентностью на основе фьючерсов. В листинге 17-9 мы начнём только с одного async-блока — не порождая отдельную задачу, как мы порождали отдельный поток.
extern crate trpl; // required for mdbook test
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let val = String::from("hi");
tx.send(val).unwrap();
let received = rx.recv().await.unwrap();
println!("received '{received}'");
});
}tx и rxЗдесь мы используем trpl::channel — async-версию API канала с множеством производителей и одним потребителем, которую мы использовали с потоками в главе 16. Async-версия API лишь немного отличается от версии на основе потоков: она использует изменяемый, а не неизменяемый приёмник rx, и её метод recv производит фьючерс, который нам нужно ожидать, а не производит значение напрямую. Теперь мы можем отправлять сообщения от отправителя к приёмнику. Обратите внимание, что нам не нужно порождать отдельный поток или даже задачу; нам нужно только ожидать вызов rx.recv.
Синхронный метод Receiver::recv в std::mpsc::channel блокируется, пока не получит сообщение. Метод trpl::Receiver::recv этого не делает, потому что он async. Вместо блокировки он возвращает управление среде выполнения, пока не будет получено сообщение или пока не закроется отправляющая сторона канала. В отличие от этого, мы не ожидаем вызов send, потому что он не блокирует. Ему не нужно, потому что канал, в который мы его отправляем, неограничен (unbounded).
Примечание: Поскольку весь этот async-код выполняется в async-блоке в вызове trpl::block_on, всё внутри него может избегать блокировки. Однако код снаружи него будет блокироваться на возврате из функции block_on. В этом весь смысл функции trpl::block_on: она позволяет вам выбрать, где блокироваться на каком-то наборе async-кода, и, таким образом, где переходить между синхронным и async-кодом.
Обратите внимание на две вещи в этом примере. Во-первых, сообщение придёт сразу. Во-вторых, хотя мы здесь используем фьючерс, конкурентности пока нет. Всё в листинге происходит последовательно, так же как если бы фьючерсов не было.
Давайте решим первую часть, отправив серию сообщений и засыпая между ними, как показано в листинге 17-10.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
});
}await между каждым сообщениемВ дополнение к отправке сообщений нам нужно их получать. В этом случае, поскольку мы знаем, сколько сообщений придёт, мы могли бы сделать это вручную, вызвав rx.recv().await четыре раза. Однако в реальном мире мы обычно будем ждать неизвестного числа сообщений, поэтому нам нужно продолжать ждать, пока мы не определим, что больше сообщений нет.
В листинге 16-10 мы использовали цикл for для обработки всех элементов, полученных из синхронного канала. Однако у Rust пока нет способа использовать цикл for с асинхронно производимой серией элементов, поэтому нам нужно использовать цикл, который мы ещё не видели: условный цикл while let. Это версия цикла конструкции if let, которую мы видели в разделе «Краткий поток управления с if let и let...else» в главе 6. Цикл будет продолжать выполняться, пока указанный им шаблон продолжает соответствовать значению.
Вызов rx.recv производит фьючерс, который мы ожидаем. Среда выполнения приостановит фьючерс, пока он не будет готов. Как только сообщение прибывает, фьючерс разрешится в Some(message) столько раз, сколько прибывает сообщение. Когда канал закрывается, независимо от того, прибыли ли какие-либо сообщения, фьючерс вместо этого разрешится в None, чтобы указать, что больше значений нет и, следовательно, мы должны прекратить опрос — то есть прекратить ожидание.
Цикл while let объединяет всё это. Если результат вызова rx.recv().await — Some(message), мы получаем доступ к сообщению и можем использовать его в теле цикла, точно так же, как мы могли бы с if let. Если результат — None, цикл заканчивается. Каждый раз, когда цикл завершается, он снова достигает точки await, поэтому среда выполнения снова приостанавливает его, пока не придёт другое сообщение.
Теперь код успешно отправляет и получает все сообщения. К сожалению, всё ещё есть пара проблем. Во-первых, сообщения не прибывают с полусекундными интервалами. Они прибывают все сразу, через 2 секунды (2000 миллисекунд) после запуска программы. Во-вторых, эта программа также никогда не завершается! Вместо этого она ждёт новых сообщений вечно. Вам нужно будет остановить её с помощью ctrl-C.
Код внутри одного async-блока выполняется линейно
Давайте начнём с рассмотрения того, почему сообщения приходят все сразу после полной задержки, а не приходят с задержками между каждым. Внутри данного async-блока порядок, в котором появляются ключевые слова await в коде, также является порядком, в котором они выполняются при запуске программы.
В листинге 17-10 только один async-блок, поэтому всё в нём выполняется линейно. Конкурентности по-прежнему нет. Все вызовы tx.send происходят, перемежаясь со всеми вызовами trpl::sleep и связанными с ними точками await. Только затем цикл while let добирается до каких-либо точек await на вызовах recv.
Чтобы получить желаемое поведение, когда задержка сна происходит между каждым сообщением, нам нужно поместить операции tx и rx в их собственные async-блоки, как показано в листинге 17-11. Тогда среда выполнения может выполнять каждый из них отдельно с помощью trpl::join, как в листинге 17-8. Снова мы ожидаем результат вызова trpl::join, а не отдельные фьючерсы. Если бы мы ожидали отдельные фьючерсы последовательно, мы бы просто вернулись к последовательному потоку — именно то, чего мы пытаемся избежать.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx_fut = async {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
trpl::join(tx_fut, rx_fut).await;
});
}send и recv на их собственные async-блоки и ожидание фьючерсов для этих блоковС обновлённым кодом в листинге 17-11 сообщения печатаются с интервалами 500 миллисекунд, а не все сразу через 2 секунды.
Перемещение владения в async-блок
Программа всё ещё никогда не завершается, хотя, из-за того, как цикл while let взаимодействует с trpl::join:
- Фьючерс, возвращаемый
trpl::join, завершается только после того, как оба переданных ему фьючерса завершатся. - Фьючерс
tx_futзавершается после того, как он закончит спать после отправки последнего сообщения вvals. - Фьючерс
rx_futне завершится, пока не закончится циклwhile let. - Цикл
while letне закончится, пока ожиданиеrx.recvне произведётNone. - Ожидание
rx.recvвернётNoneтолько после того, как другой конец канала будет закрыт. - Канал закроется только в том случае, если мы вызовем
rx.closeили когда отправляющая сторонаtxбудет отброшена. - Мы нигде не вызываем
rx.close, аtxне будет отброшен, пока не закончится самый внешний async-блок, переданный вtrpl::block_on. - Блок не может закончиться, потому что он заблокирован на завершении
trpl::join, что возвращает нас к началу этого списка.
Прямо сейчас async-блок, в котором мы отправляем сообщения, только заимствует tx, потому что отправка сообщения не требует владения, но если бы мы могли переместить tx в этот async-блок, он был бы отброшен, как только этот блок закончится. В разделе «Захват ссылок или перемещение владения» в главе 13 вы узнали, как использовать ключевое слово move с замыканиями, и, как обсуждалось в разделе «Использование замыканий move с потоками» в главе 16, нам часто нужно перемещать данные в замыкания при работе с потоками. Та же базовая динамика применима к async-блокам, поэтому ключевое слово move работает с async-блоками так же, как и с замыканиями.
В листинге 17-12 мы меняем блок, используемый для отправки сообщений, с async на async move.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx_fut = async move {
// --snip--
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
trpl::join(tx_fut, rx_fut).await;
});
}Когда мы запускаем эту версию кода, она корректно завершается после того, как последнее сообщение отправлено и получено. Далее давайте посмотрим, что нужно было бы изменить, чтобы отправлять данные из более чем одного фьючерса.
Соединение нескольких фьючерсов с помощью макроса join!
Этот async-канал также является каналом с множеством производителей, поэтому мы можем вызвать clone на tx, если хотим отправлять сообщения из нескольких фьючерсов, как показано в листинге 17-13.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = async move {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
let tx_fut = async move {
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(1500)).await;
}
};
trpl::join!(tx1_fut, tx_fut, rx_fut);
});
}Сначала мы клонируем tx, создавая tx1 вне первого async-блока. Мы перемещаем tx1 в этот блок точно так же, как делали раньше с tx. Затем позже мы перемещаем исходный tx в новый async-блок, где отправляем больше сообщений с немного более медленной задержкой. Мы случайно поместили этот новый async-блок после async-блока для получения сообщений, но он мог бы идти и перед ним. Ключ — это порядок, в котором фьючерсы ожидаются, а не в котором они создаются.
Оба async-блока для отправки сообщений должны быть блоками async move, чтобы и tx, и tx1 отбрасывались при завершении этих блоков. В противном случае мы вернёмся в тот же бесконечный цикл, с которого начали.
Наконец, мы переключаемся с trpl::join на trpl::join!, чтобы обработать дополнительный фьючерс: макрос join! ожидает произвольное число фьючерсов, когда число фьючерсов известно во время компиляции. Мы обсудим ожидание коллекции неизвестного числа фьючерсов позже в этой главе.
Теперь мы видим все сообщения от обоих фьючерсов-отправителей, и, поскольку фьючерсы-отправители используют немного разные задержки после отправки, сообщения также получаются с этими разными интервалами:
received 'hi'
received 'more'
received 'from'
received 'the'
received 'messages'
received 'future'
received 'for'
received 'you'
Мы рассмотрели, как использовать передачу сообщений для отправки данных между фьючерсами, как код внутри async-блока выполняется последовательно, как перемещать владение в async-блок и как соединять несколько фьючерсов. Далее давайте обсудим, как и зачем говорить среде выполнения, что она может переключиться на другую задачу.
Работа с любым количеством фьючерсов
Передача управления среде выполнения
Вспомните из раздела «Наша первая асинхронная программа», что в каждой точке await Rust даёт среде выполнения возможность приостановить задачу и переключиться на другую, если ожидаемый фьючерс не готов. Обратное также верно: Rust только приостанавливает асинхронные блоки и возвращает управление среде выполнения в точке await. Всё между точками await является синхронным.
Это означает, что если вы выполняете много работы в асинхронном блоке без точки await, этот фьючерс заблокирует продвижение других фьючерсов. Иногда вы можете услышать, что это называется голоданием одного фьючерса другими фьючерсами. В некоторых случаях это может быть не большой проблемой. Однако, если вы выполняете какую-то дорогостоящую настройку или длительную работу, или если у вас есть фьючерс, который будет бесконечно выполнять какую-то конкретную задачу, вам нужно подумать о том, когда и где передать управление обратно среде выполнения.
Давайте смоделируем длительную операцию, чтобы проиллюстрировать проблему голодания, а затем исследуем, как её решить. Листинг 17-14 вводит функцию slow.
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
// Позже мы вызовем `slow` здесь
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}thread::sleep для имитации медленных операцийЭтот код использует std::thread::sleep вместо trpl::sleep, так что вызов slow заблокирует текущий поток на некоторое количество миллисекунд. Мы можем использовать slow, чтобы заменить реальные операции, которые одновременно являются длительными и блокирующими.
В листинге 17-15 мы используем slow, чтобы имитировать выполнение такой работы, привязанной к процессору, в паре фьючерсов.
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let a = async {
println!("'a' started.");
slow("a", 30);
slow("a", 10);
slow("a", 20);
trpl::sleep(Duration::from_millis(50)).await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
slow("b", 10);
slow("b", 15);
slow("b", 350);
trpl::sleep(Duration::from_millis(50)).await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}slow для имитации медленных операцийКаждый фьючерс передаёт управление среде выполнения только после выполнения множества медленных операций. Если вы запустите этот код, вы увидите следующий вывод:
'a' started.
'a' ran for 30ms
'a' ran for 10ms
'a' ran for 20ms
'b' started.
'b' ran for 75ms
'b' ran for 10ms
'b' ran for 15ms
'b' ran for 350ms
'a' finished.
Как и в листинге 17-5, где мы использовали trpl::select для гонки фьючерсов, загружающих два URL-адреса, select всё равно завершается, как только a готов. Однако между вызовами slow в двух фьючерсах нет чередования. Фьючерс a выполняет всю свою работу, пока не будет ожидаться вызов trpl::sleep, затем фьючерс b выполняет всю свою работу, пока не будет ожидаться его собственный вызов trpl::sleep, и наконец фьючерс a завершается. Чтобы позволить обоим фьючерсам продвигаться между их медленными задачами, нам нужны точки await, чтобы мы могли передать управление обратно среде выполнения. Это означает, что нам нужно что-то, что мы можем ожидать!
Мы уже можем видеть этот вид передачи управления в листинге 17-15: если бы мы удалили trpl::sleep в конце фьючерса a, он завершился бы без какого-либо запуска фьючерса b. Давайте попробуем использовать функцию trpl::sleep в качестве отправной точки для того, чтобы позволить операциям переключаться с продвижения, как показано в листинге 17-16.
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let one_ms = Duration::from_millis(1);
let a = async {
println!("'a' started.");
slow("a", 30);
trpl::sleep(one_ms).await;
slow("a", 10);
trpl::sleep(one_ms).await;
slow("a", 20);
trpl::sleep(one_ms).await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
trpl::sleep(one_ms).await;
slow("b", 10);
trpl::sleep(one_ms).await;
slow("b", 15);
trpl::sleep(one_ms).await;
slow("b", 350);
trpl::sleep(one_ms).await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}trpl::sleep, чтобы позволить операциям переключаться с продвиженияМы добавили вызовы trpl::sleep с точками await между каждым вызовом slow. Теперь работа двух фьючерсов чередуется:
'a' started.
'a' ran for 30ms
'b' started.
'b' ran for 75ms
'a' ran for 10ms
'b' ran for 10ms
'a' ran for 20ms
'b' ran for 15ms
'a' finished.
Фьючерс a всё ещё выполняется немного перед передачей управления b, потому что он вызывает slow до первого вызова trpl::sleep, но после этого фьючерсы меняются туда-сюда каждый раз, когда один из них достигает точки await. В этом случае мы сделали это после каждого вызова slow, но мы могли бы разбить работу любым способом, который имеет наибольший смысл для нас.
Однако мы на самом деле не хотим спать здесь: мы хотим продвигаться как можно быстрее. Нам просто нужно передать управление обратно среде выполнения. Мы можем сделать это напрямую, используя функцию trpl::yield_now. В листинге 17-17 мы заменяем все эти вызовы trpl::sleep на trpl::yield_now.
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let a = async {
println!("'a' started.");
slow("a", 30);
trpl::yield_now().await;
slow("a", 10);
trpl::yield_now().await;
slow("a", 20);
trpl::yield_now().await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
trpl::yield_now().await;
slow("b", 10);
trpl::yield_now().await;
slow("b", 15);
trpl::yield_now().await;
slow("b", 350);
trpl::yield_now().await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}yield_now, чтобы позволить операциям переключаться с продвиженияЭтот код яснее передаёт реальное намерение и может быть значительно быстрее, чем использование sleep, потому что таймеры, такие как используемый sleep, часто имеют ограничения на гранулярность. Используемая нами версия sleep, например, всегда будет спать не менее миллисекунды, даже если мы передадим ей Duration в одну наносекунду. Опять же, современные компьютеры быстры: они могут сделать много за одну миллисекунду!
Это означает, что async может быть полезен даже для задач, привязанных к процессору, в зависимости от того, что ещё делает ваша программа, потому что он предоставляет полезный инструмент для структурирования связей между различными частями программы (но ценой накладных расходов асинхронного конечного автомата). Это форма кооперативной многозадачности, где каждый фьючерс имеет власть определять, когда он передаёт управление через точки await. Поэтому каждый фьючерс также несёт ответственность за то, чтобы не блокировать слишком долго. В некоторых встроенных операционных системах на основе Rust это единственный вид многозадачности!
В реальном коде вы, конечно, обычно не будете чередовать вызовы функций с точками await на каждой отдельной строке. Хотя уступка управления таким способом относительно недорога, она не бесплатна. Во многих случаях попытка разбить задачу, привязанную к процессору, может сделать её значительно медленнее, поэтому иногда лучше для общей производительности позволить операции ненадолго блокироваться. Всегда измеряйте, чтобы увидеть, каковы фактические узкие места производительности вашего кода. Однако важно помнить о лежащей в основе динамике, если вы видите, что много работы происходит последовательно, хотя вы ожидали, что она будет происходить конкурентно!
Создание наших собственных асинхронных абстракций
Мы также можем компоновать фьючерсы вместе, чтобы создавать новые паттерны. Например, мы можем построить функцию timeout из асинхронных строительных блоков, которые у нас уже есть. Когда мы закончим, результатом будет ещё один строительный блок, который мы могли бы использовать для создания ещё большего количества асинхронных абстракций.
Листинг 17-18 показывает, как мы ожидаем, что этот timeout будет работать с медленным фьючерсом.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}timeout для запуска медленной операции с ограничением по времениДавайте реализуем это! Для начала давайте подумаем об API для timeout:
- Он должен сам быть асинхронной функцией, чтобы мы могли его ожидать.
- Его первый параметр должен быть фьючерсом для запуска. Мы можем сделать его обобщённым, чтобы он работал с любым фьючерсом.
- Его второй параметр будет максимальным временем ожидания. Если мы используем
Duration, это облегчит передачу его вtrpl::sleep. - Он должен возвращать
Result. Если фьючерс завершается успешно,ResultбудетOkсо значением, произведённым фьючерсом. Если тайм-аут истекает первым,ResultбудетErrс продолжительностью, которую тайм-аут ожидал.
Листинг 17-19 показывает это объявление.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}
async fn timeout<F: Future>(
future_to_try: F,
max_time: Duration,
) -> Result<F::Output, Duration> {
// Здесь будет наша реализация!
}timeoutЭто удовлетворяет нашим целям для типов. Теперь давайте подумаем о поведении, которое нам нужно: мы хотим устроить гонку между переданным фьючерсом и продолжительностью. Мы можем использовать trpl::sleep, чтобы создать фьючерс-таймер из продолжительности, и использовать trpl::select, чтобы запустить этот таймер с фьючерсом, который передал вызывающий код.
В листинге 17-20 мы реализуем timeout, сопоставляя с результатом ожидания trpl::select.
extern crate trpl; // required for mdbook test
use std::time::Duration;
use trpl::Either;
// --snip--
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}
async fn timeout<F: Future>(
future_to_try: F,
max_time: Duration,
) -> Result<F::Output, Duration> {
match trpl::select(future_to_try, trpl::sleep(max_time)).await {
Either::Left(output) => Ok(output),
Either::Right(_) => Err(max_time),
}
}timeout с помощью select и sleepРеализация trpl::select не является справедливой: она всегда опрашивает аргументы в том порядке, в котором они переданы (другие реализации select будут случайным образом выбирать, какой аргумент опрашивать первым). Таким образом, мы передаём future_to_try в select первым, чтобы у него был шанс завершиться, даже если max_time — очень короткая продолжительность. Если future_to_try завершается первым, select вернёт Left с выводом от future_to_try. Если timer завершается первым, select вернёт Right с выводом таймера ().
Если future_to_try завершается успешно и мы получаем Left(output), мы возвращаем Ok(output). Если вместо этого истекает таймер сна и мы получаем Right(()), мы игнорируем () с помощью _ и возвращаем Err(max_time).
С этим у нас есть работающий timeout, построенный из двух других асинхронных помощников. Если мы запустим наш код, он выведет режим отказа после тайм-аута:
Failed after 2 seconds
Поскольку фьючерсы компонуются с другими фьючерсами, вы можете создавать действительно мощные инструменты, используя меньшие асинхронные строительные блоки. Например, вы можете использовать тот же подход, чтобы комбинировать тайм-ауты с повторными попытками, а затем использовать их с такими операциями, как сетевые вызовы (например, те, что в листинге 17-5).
На практике вы обычно будете работать напрямую с async и await, а во вторую очередь — с такими функциями, как select, и макросами, такими как макрос join!, чтобы управлять тем, как выполняются внешние фьючерсы.
Теперь мы увидели ряд способов работы с несколькими фьючерсами одновременно. Далее мы рассмотрим, как мы можем работать с несколькими фьючерсами в последовательности во времени с помощью стримов.
Стримы: фьючерсы в последовательности
Стримы: фьючерсы в последовательности
Вспомним, как мы использовали получатель для нашего асинхронного канала ранее в этой главе
в разделе «Передача сообщений». Асинхронный
метод recv порождает последовательность элементов во времени. Это пример
гораздо более общего паттерна, известного как стрим. Многие концепции естественно
представляются как стримы: элементы, становящиеся доступными в очереди, порции данных,
которые извлекаются постепенно из файловой системы, когда полный набор данных слишком
велик для памяти компьютера, или данные, поступающие по сети со временем.
Поскольку стримы — это фьючерсы, мы можем использовать их с любым другим видом фьючерса и
комбинировать их интересными способами. Например, мы можем пакетировать события, чтобы избежать
запуска слишком большого числа сетевых вызовов, устанавливать тайм-ауты для последовательностей длительных
операций или регулировать события пользовательского интерфейса, чтобы избежать ненужной работы.
Мы видели последовательность элементов в главе 13, когда рассматривали трейт Iterator
в разделе «Трейт Iterator и метод next», но между итераторами и
асинхронным получателем канала есть два различия. Первое различие — время: итераторы
синхронны, а получатель канала асинхронен. Второе различие — API. При работе напрямую с Iterator
мы вызываем его синхронный метод next. Со стримом trpl::Receiver конкретно
мы вместо этого вызывали асинхронный метод recv. В остальном эти API ощущаются очень похожими,
и это сходство не случайно. Стрим похож на асинхронную форму
итерации. Хотя trpl::Receiver конкретно ожидает получения
сообщений, общий API стримов гораздо шире: он предоставляет
следующий элемент так же, как Iterator, но асинхронно.
Сходство между итераторами и стримами в Rust означает, что мы можем на самом деле
создать стрим из любого итератора. Как и с итератором, мы можем работать с
стримом, вызывая его метод next и затем ожидая вывод, как в листинге
17-21, который пока не будет компилироваться.
extern crate trpl; // required for mdbook test
fn main() {
trpl::block_on(async {
let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
let iter = values.iter().map(|n| n * 2);
let mut stream = trpl::stream_from_iter(iter);
while let Some(value) = stream.next().await {
println!("The value was: {value}");
}
});
}Мы начинаем с массива чисел, который преобразуем в итератор, а затем
вызываем map, чтобы удвоить все значения. Затем мы преобразуем итератор в
стрим с помощью функции trpl::stream_from_iter. Затем мы перебираем в цикле
элементы стрима по мере их поступления с помощью цикла while let.
К сожалению, когда мы пытаемся запустить код, он не компилируется, а вместо этого
сообщает, что метод next недоступен:
error[E0599]: no method named `next` found for struct `tokio_stream::iter::Iter` in the current scope
--> src/main.rs:10:40
|
10 | while let Some(value) = stream.next().await {
| ^^^^
|
= help: items from traits can only be used if the trait is in scope
help: the following traits which provide `next` are implemented but not in scope; perhaps you want to import one of them
|
1 + use crate::trpl::StreamExt;
|
1 + use futures_util::stream::stream::StreamExt;
|
1 + use std::iter::Iterator;
|
1 + use std::str::pattern::Searcher;
|
help: there is a method `try_next` with a similar name
|
10 | while let Some(value) = stream.try_next().await {
| ~~~~~~~~
Как объясняет этот вывод, причина ошибки компилятора заключается в том, что нам нужен
правильный трейт в области видимости, чтобы иметь возможность использовать метод next. Учитывая наше обсуждение
до сих пор, можно разумно ожидать, что этим трейтом будет Stream, но на самом деле это
StreamExt. Сокращение от extension (расширение), Ext — это распространённый паттерн в
сообществе Rust для расширения одного трейта другим.
Трейт Stream определяет низкоуровневый интерфейс, который фактически объединяет
трейты Iterator и Future. StreamExt предоставляет набор API более высокого уровня
поверх Stream, включая метод next, а также другие служебные
методы, аналогичные тем, которые предоставляет трейт Iterator. Stream и
StreamExt ещё не являются частью стандартной библиотеки Rust, но большинство крейтов
экосистемы используют похожие определения.
Исправление ошибки компилятора — добавить инструкцию use для
trpl::StreamExt, как в листинге 17-22.
extern crate trpl; // required for mdbook test
use trpl::StreamExt;
fn main() {
trpl::block_on(async {
let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
// --snip--
let iter = values.iter().map(|n| n * 2);
let mut stream = trpl::stream_from_iter(iter);
while let Some(value) = stream.next().await {
println!("The value was: {value}");
}
});
}Со всеми этими частями, собранными вместе, этот код работает так, как мы хотим! Более того,
теперь, когда StreamExt в области видимости, мы можем использовать все его служебные
методы, так же как с итераторами.
Подробнее о трейтах для async
Подробнее о трейтах для async
На протяжении всей главы мы использовали трейты Future, Stream и StreamExt
различными способами. До сих пор, однако, мы избегали слишком глубокого погружения в
детали того, как они работают или как они сочетаются друг с другом, что в большинстве случаев
нормально для повседневной работы с Rust. Иногда, однако, вы столкнётесь с
ситуациями, где вам потребуется понять ещё несколько деталей этих трейтов,
вместе с типом Pin и трейтом Unpin. В этом разделе мы углубимся
ровно настолько, чтобы помочь в таких сценариях, оставив по-настоящему глубокое погружение
для другой документации.
Трейт Future
Начнём с более подробного рассмотрения того, как работает трейт Future. Вот как
Rust определяет его:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
pub trait Future {
type Output;
fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
}Это определение трейта включает кучу новых типов, а также некоторый синтаксис, который мы не видели раньше, поэтому давайте разберём определение по частям.
Во-первых, ассоциированный тип Output у Future говорит, во что разрешается фьючерс.
Это аналогично ассоциированному типу Item для трейта Iterator.
Во-вторых, Future имеет метод poll, который принимает специальную ссылку Pin
для своего параметра self и изменяемую ссылку на тип Context, и
возвращает Poll<Self::Output>. Мы поговорим подробнее о Pin и Context чуть
позже. Пока сосредоточимся на том, что возвращает метод — тип Poll:
#![allow(unused)]
fn main() {
pub enum Poll<T> {
Ready(T),
Pending,
}
}Этот тип Poll похож на Option. У него есть один вариант со значением,
Ready(T), и один без, Pending. Однако Poll означает нечто совершенно
иное, чем Option! Вариант Pending указывает, что у фьючерса ещё есть работа,
поэтому вызывающей стороне нужно будет проверить снова позже. Вариант Ready
указывает, что Future завершил свою работу и значение T доступно.
Примечание: редко возникает необходимость вызывать poll напрямую, но если вам всё же
нужно, имейте в виду, что с большинством фьючерсов вызывающая сторона не должна снова вызывать poll
после того, как фьючерс вернул Ready. Многие фьючерсы запаникуют, если их опросят снова после
того, как они стали готовы. Фьючерсы, которые безопасно опрашивать повторно, явно скажут об этом в
своей документации. Это похоже на то, как ведёт себя Iterator::next.
Когда вы видите код, использующий await, Rust под капотом компилирует его в код,
который вызывает poll. Если вы вернётесь к листингу 17-4, где мы напечатали
заголовок страницы для одного URL после его разрешения, Rust компилирует его во что-то
вроде (хотя и не точно) такого:
match page_title(url).poll() {
Ready(page_title) => match page_title {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
Pending => {
// Но что здесь должно быть?
}
}Что мы должны делать, когда фьючерс всё ещё Pending? Нам нужен какой-то способ попробовать
снова, и снова, и снова, пока фьючерс наконец не станет готов. Иными словами,
нам нужен цикл:
let mut page_title_fut = page_title(url);
loop {
match page_title_fut.poll() {
Ready(value) => match page_title {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
Pending => {
// continue
}
}
}Если бы Rust компилировал это ровно в такой код, то каждый await был бы
блокирующим — прямо противоположным тому, к чему мы стремились! Вместо этого Rust гарантирует,
что цикл может передать управление чему-то, что может приостановить работу над этим
фьючерсом, чтобы поработать над другими фьючерсами, а затем проверить этот снова позже. Как мы
видели, это что-то — асинхронная среда выполнения, и эта работа по планированию и координации
является одной из её главных задач.
В разделе «Отправка данных между двумя задачами с помощью передачи сообщений» мы описали ожидание на
rx.recv. Вызов recv возвращает фьючерс, и ожидание фьючерса опрашивает его.
Мы отметили, что среда выполнения приостановит фьючерс, пока он не станет готов с либо
Some(message), либо None, когда канал закроется. С нашим более глубоким
пониманием трейта Future, и конкретно Future::poll, мы можем
увидеть, как это работает. Среда выполнения знает, что фьючерс не готов, когда он возвращает
Poll::Pending. И наоборот, среда выполнения знает, что фьючерс готов и
продвигает его, когда poll возвращает Poll::Ready(Some(message)) или
Poll::Ready(None).
Точные детали того, как среда выполнения делает это, выходят за рамки этой книги, но ключ в том, чтобы увидеть базовую механику фьючерсов: среда выполнения опрашивает каждый фьючерс, за который она отвечает, отправляя фьючерс обратно спать, когда он ещё не готов.
Тип Pin и трейт Unpin
Ранее в листинге 17-13 мы использовали макрос trpl::join! для ожидания трёх
фьючерсов. Однако часто встречается коллекция, такая как вектор, содержащая
некоторое количество фьючерсов, которое не будет известно до времени выполнения. Давайте изменим листинг
17-13 на код в листинге 17-23, который помещает три фьючерса в вектор
и вызывает функцию trpl::join_all, которая пока не скомпилируется.
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = async move {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
let tx_fut = async move {
// --snip--
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
};
let futures: Vec<Box<dyn Future<Output = ()>>> =
vec![Box::new(tx1_fut), Box::new(rx_fut), Box::new(tx_fut)];
trpl::join_all(futures).await;
});
}Мы помещаем каждый фьючерс внутрь Box, чтобы превратить их в трейт-объекты, точно так же,
как мы делали в разделе «Возврат ошибок из run» в главе 12. (Мы рассмотрим
трейт-объекты подробно в главе 18.) Использование трейт-объектов позволяет нам трактовать каждый
из анонимных фьючерсов, созданных этими типами, как один и тот же тип, потому что все
они реализуют трейт Future.
Это может удивить. В конце концов, ни один из async-блоков ничего не возвращает,
поэтому каждый из них создаёт Future<Output = ()>. Помните, что Future — это
трейт, однако, и что компилятор создаёт уникальное перечисление для каждого async-блока,
даже когда они имеют идентичные типы вывода. Точно так же, как вы не можете поместить два
разных написанных вручную struct в Vec, вы не можете смешивать сгенерированные компилятором
перечисления.
Затем мы передаём коллекцию фьючерсов в функцию trpl::join_all и
ожидаем результат. Однако это не компилируется; вот соответствующая часть
сообщений об ошибках.
error[E0277]: `dyn Future<Output = ()>` cannot be unpinned
--> src/main.rs:48:33
|
48 | trpl::join_all(futures).await;
| ^^^^^ the trait `Unpin` is not implemented for `dyn Future<Output = ()>`
|
= note: consider using the `pin!` macro
consider using `Box::pin` if you need to access the pinned value outside of the current scope
= note: required for `Box<dyn Future<Output = ()>>` to implement `Future`
note: required by a bound in `futures_util::future::join_all::JoinAll`
--> file:///home/.cargo/registry/src/index.crates.io-1949cf8c6b5b557f/futures-util-0.3.30/src/future/join_all.rs:29:8
|
27 | pub struct JoinAll<F>
| ------- required by a bound in this struct
28 | where
29 | F: Future,
| ^^^^^^ required by this bound in `JoinAll`
Примечание в этом сообщении об ошибке говорит нам, что мы должны использовать макрос pin!, чтобы
закрепить значения, что означает помещение их внутрь типа Pin, который
гарантирует, что значения не будут перемещены в памяти. Сообщение об ошибке говорит, что закрепление
требуется, потому что dyn Future<Output = ()> должен реализовывать трейт Unpin,
а в настоящее время не реализует.
Функция trpl::join_all возвращает struct с именем JoinAll. Эта структура является
обобщённой по типу F, который ограничен реализацией трейта Future.
Прямое ожидание фьючерса с await неявно закрепляет фьючерс. Вот почему
нам не нужно использовать pin! везде, где мы хотим ожидать фьючерс.
Однако здесь мы не ожидаем фьючерс напрямую. Вместо этого мы конструируем новый
фьючерс, JoinAll, передавая коллекцию фьючерсов в функцию join_all.
Сигнатура join_all требует, чтобы типы элементов в
коллекции все реализовывали трейт Future, а Box<T> реализует Future
только если T, который он оборачивает, является фьючерсом, реализующим трейт Unpin.
Это много, чтобы усвоить! Чтобы действительно понять это, давайте углубимся немного дальше
в то, как на самом деле работает трейт Future, в частности вокруг закрепления. Взгляните
снова на определение трейта Future:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
pub trait Future {
type Output;
// Обязательный метод
fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
}Параметр cx и его тип Context — ключ к тому, как среда выполнения на самом деле
знает, когда проверять любой данный фьючерс, оставаясь при этом ленивой. Опять же, детали
того, как это работает, выходят за рамки этой главы, и вам обычно нужно думать об этом
только при написании собственной реализации Future. Вместо этого мы
сосредоточимся на типе для self, поскольку это первый раз, когда мы видим
метод, где self имеет аннотацию типа. Аннотация типа для self работает
как аннотации типов для других параметров функции, но с двумя ключевыми
отличиями:
- Она говорит Rust, каким типом должен быть
self, чтобы метод можно было вызвать. - Он не может быть просто любым типом. Он ограничен типом, для которого реализован метод,
ссылкой или умным указателем на этот тип, или
Pin, оборачивающим ссылку на этот тип.
Мы увидим больше об этом синтаксисе в главе 18. Пока
достаточно знать, что если мы хотим опросить фьючерс, чтобы проверить, является ли он
Pending или Ready(Output), нам нужна обёрнутая в Pin изменяемая ссылка на
тип.
Pin — это обёртка для pointer-подобных типов, таких как &, &mut, Box и Rc.
(Технически Pin работает с типами, которые реализуют трейты Deref или DerefMut,
но это фактически эквивалентно работе только со ссылками и
умными указателями.) Pin сам по себе не является указателем и не имеет никакого поведения
сам по себе, как Rc и Arc с подсчётом ссылок; это чисто инструмент, который
компилятор может использовать для обеспечения ограничений на использование указателей.
Вспомнив, что await реализован в терминах вызовов poll, начинает
объяснять сообщение об ошибке, которое мы видели ранее, но оно было в терминах Unpin, а не
Pin. Так как именно Pin связан с Unpin, и почему Future нужен
self в типе Pin для вызова poll?
Помните из ранее в этой главе, что серия точек await в фьючерсе компилируется в конечный автомат, и компилятор гарантирует, что этот конечный автомат следует всем обычным правилам Rust относительно безопасности, включая заимствование и владение. Чтобы это работало, Rust смотрит, какие данные нужны между одной точкой await и либо следующей точкой await, либо концом async-блока. Затем он создаёт соответствующий вариант в скомпилированном конечном автомате. Каждый вариант получает доступ, который ему нужен к данным, которые будут использоваться в этом разделе исходного кода, будь то путём взятия владения этими данными или путём получения изменяемой или неизменяемой ссылки на них.
Пока всё хорошо: если мы сделаем что-то не так с владением или ссылками в
данном async-блоке, проверка заимствований скажет нам об этом. Когда мы хотим переместить
фьючерс, который соответствует этому блоку — например, переместить его в Vec, чтобы
передать в join_all, — всё становится сложнее.
Когда мы перемещаем фьючерс — будь то путём помещения его в структуру данных для использования в качестве
итератора с join_all или путём возврата его из функции — это на самом деле означает
перемещение конечного автомата, который Rust создаёт для нас. И в отличие от большинства других типов в
Rust, фьючерсы, которые Rust создаёт для async-блоков, могут в конечном итоге иметь ссылки на
самих себя в полях любого данного варианта, как показано на упрощённой иллюстрации на рисунке 17-4.
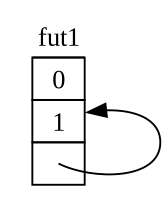
Однако по умолчанию любой объект, который имеет ссылку на себя, небезопасно перемещать, потому что ссылки всегда указывают на фактический адрес памяти того, на что они ссылаются (см. рисунок 17-5). Если вы переместите саму структуру данных, эти внутренние ссылки останутся указывающими на старое место. Однако это место в памяти теперь недействительно. Во-первых, его значение не будет обновлено при внесении изменений в структуру данных. Во-вторых — что более важно — компьютер теперь может свободно использовать эту память для других целей! Вы можете в конечном итоге прочитать совершенно не связанные данные позже.
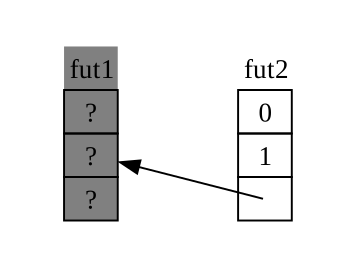
Теоретически компилятор Rust мог бы попытаться обновить каждую ссылку на объект всякий раз, когда он перемещается, но это может добавить много накладных расходов на производительность, особенно если целая сеть ссылок нуждается в обновлении. Если бы мы могли вместо этого убедиться, что рассматриваемая структура данных не перемещается в памяти, нам не пришлось бы обновлять какие-либо ссылки. Именно для этого и нужна проверка заимствований Rust: в безопасном коде она предотвращает перемещение любого элемента с активной ссылкой на него.
Pin строится на этом, чтобы дать нам именно ту гарантию, которая нам нужна. Когда мы закрепляем
значение, оборачивая указатель на это значение в Pin, оно больше не может перемещаться. Таким образом,
если у вас есть Pin<Box<SomeType>>, вы фактически закрепляете значение SomeType, а не
указатель Box. Рисунок 17-6 иллюстрирует этот процесс.
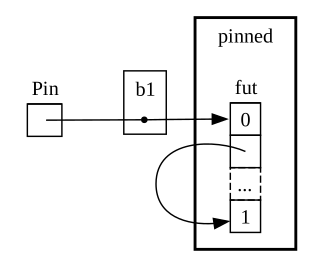
Box, который указывает на самоссылающийся тип фьючерсаФактически, указатель Box всё ещё может свободно перемещаться. Помните: мы заботимся о
том, чтобы данные, на которые в конечном итоге ссылаются, оставались на месте. Если указатель
перемещается, но данные, на которые он указывает, находятся в том же месте, как на рисунке
17-7, нет потенциальной проблемы. (В качестве самостоятельного упражнения посмотрите на документацию
для типов, а также модуль std::pin и попробуйте разобраться, как вы могли бы сделать
это с Pin, оборачивающим Box.) Ключ в том, что самоссылающийся тип
не может перемещаться, потому что он всё ещё закреплён.
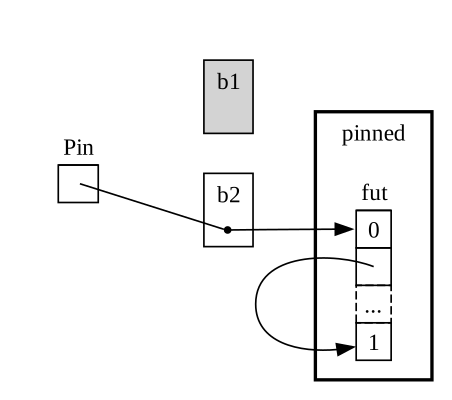
Box, который указывает на самоссылающийся тип фьючерсаОднако большинство типов совершенно безопасно перемещать, даже если они оказываются
за указателем Pin. Нам нужно думать о закреплении только тогда, когда элементы имеют
внутренние ссылки. Примитивные значения, такие как числа и булевы значения, безопасны,
потому что у них очевидно нет внутренних ссылок.
Также как и большинство типов, с которыми вы обычно работаете в Rust. Вы можете перемещать
Vec, например, без беспокойства. Учитывая то, что мы видели до сих пор, если
у вас есть Pin<Vec<String>>, вам придётся делать всё через безопасные, но
ограничительные API, предоставляемые Pin, хотя Vec<String> всегда безопасно
перемещать, если нет других ссылок на него. Нам нужен способ сообщить
компилятору, что в таких случаях можно безопасно перемещать элементы — и вот тут-то
и вступает в игру Unpin.
Unpin — это маркерный трейт, похожий на трейты Send и Sync, которые мы видели в
главе 16, и, таким образом, не имеет собственной функциональности. Маркерные трейты существуют только
чтобы сообщить компилятору, что безопасно использовать тип, реализующий данный трейт, в
определённом контексте. Unpin сообщает компилятору, что данный тип не
должен соблюдать какие-либо гарантии относительно того, можно ли безопасно перемещать рассматриваемое значение.
Так же, как с Send и Sync, компилятор автоматически реализует Unpin
для всех типов, где он может доказать, что это безопасно. Особый случай, снова аналогичный
Send и Sync, — это когда Unpin не реализован для типа. Нотация
для этого — impl !Unpin for SomeType, где
SomeType — имя типа, который действительно должен соблюдать
эти гарантии, чтобы быть безопасным всякий раз, когда указатель на этот тип используется в Pin.
Иными словами, есть две вещи, которые нужно иметь в виду о связи
между Pin и Unpin. Во-первых, Unpin — это «нормальный» случай, а !Unpin —
особый случай. Во-вторых, реализует ли тип Unpin или !Unpin, только
имеет значение, когда вы используете закреплённый указатель на этот тип, например Pin<&mut
SomeType>.
Чтобы сделать это конкретным, подумайте о String: у неё есть длина и символы
Unicode, которые её составляют. Мы можем обернуть String в Pin, как показано на рисунке
17-8. Однако String автоматически реализует Unpin, как и большинство других типов
в Rust.
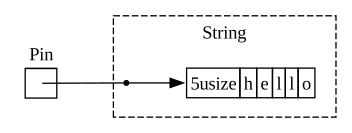
String; пунктирная линия указывает, что String реализует трейт Unpin и, следовательно, не закрепленаВ результате мы можем делать вещи, которые были бы незаконны, если бы String реализовывал
!Unpin, например заменять одну строку другой в точно том же
месте в памяти, как на рисунке 17-9. Это не нарушает контракт Pin,
потому что String не имеет внутренних ссылок, которые делают его небезопасным для перемещения.
Именно поэтому он реализует Unpin, а не !Unpin.
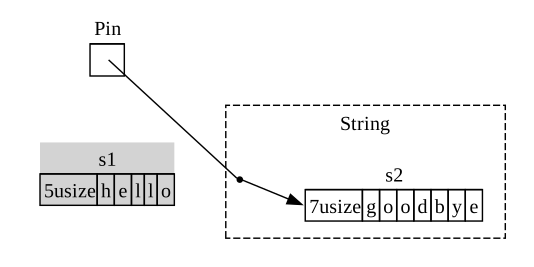
String совершенно другой String в памятиТеперь мы знаем достаточно, чтобы понять ошибки, о которых сообщалось для вызова join_all
из листинга 17-23. Изначально мы пытались переместить фьючерсы, созданные
async-блоками, в Vec<Box<dyn Future<Output = ()>>>, но, как мы видели,
эти фьючерсы могут иметь внутренние ссылки, поэтому они не автоматически
реализуют Unpin. Как только мы закрепим их, мы можем передать получившийся тип Pin в
Vec, будучи уверенными, что базовые данные в фьючерсе не будут
перемещены. Листинг 17-24 показывает, как исправить код, вызывая макрос pin!
там, где определяется каждый из трёх фьючерсов, и корректируя тип трейт-объекта.
extern crate trpl; // required for mdbook test
use std::pin::{Pin, pin};
// --snip--
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = pin!(async move {
// --snip--
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
});
let rx_fut = pin!(async {
// --snip--
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
});
let tx_fut = pin!(async move {
// --snip--
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
});
let futures: Vec<Pin<&mut dyn Future<Output = ()>>> =
vec![tx1_fut, rx_fut, tx_fut];
trpl::join_all(futures).await;
});
}Этот пример теперь компилируется и выполняется, и мы могли бы добавлять или удалять фьючерсы из вектора во время выполнения и объединять их все.
Pin и Unpin в основном важны для создания низкоуровневых библиотек или
при создании самой среды выполнения, а не для повседневного кода на Rust.
Однако когда вы видите эти трейты в сообщениях об ошибках, теперь у вас будет лучшее
представление о том, как исправить ваш код!
Примечание: эта комбинация Pin и Unpin позволяет безопасно
реализовывать целый класс сложных типов в Rust, которые иначе оказались бы
сложными, потому что они самоссылающиеся. Типы, требующие Pin, чаще всего появляются
в асинхронном Rust сегодня, но время от времени вы можете увидеть
их и в других контекстах.
Конкретные детали того, как работают Pin и Unpin, и правила, которые они должны
соблюдать, подробно описаны в документации API для std::pin, поэтому
если вам интересно узнать больше, это отличное место для начала.
Если вы хотите понять, как всё работает под капотом, ещё более подробно, см. главы 2 и 4 из Asynchronous Programming in Rust.
Трейт Stream
Теперь, когда у вас есть более глубокое понимание трейтов Future, Pin и Unpin, мы
можем обратить наше внимание на трейт Stream. Как вы узнали ранее в
главе, стримы (streams) похожи на асинхронные итераторы. В отличие от Iterator и
Future, однако, Stream на момент написания не имеет определения в стандартной библиотеке,
но есть очень распространённое определение из крейта futures,
используемое во всей экосистеме.
Давайте рассмотрим определения трейтов Iterator и Future перед
тем, как посмотреть, как трейт Stream мог бы объединить их вместе. Из Iterator у
нас есть идея последовательности: его метод next предоставляет
Option<Self::Item>. Из Future у нас есть идея готовности с течением времени:
его метод poll предоставляет Poll<Self::Output>. Чтобы представить последовательность
элементов, которые становятся готовыми с течением времени, мы определяем трейт Stream, который объединяет эти
функции вместе:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
trait Stream {
type Item;
fn poll_next(
self: Pin<&mut Self>,
cx: &mut Context<'_>
) -> Poll<Option<Self::Item>>;
}
}Трейт Stream определяет ассоциированный тип с именем Item для типа
элементов, производимых стримом. Это похоже на Iterator, где может быть
от нуля до многих элементов, и не похоже на Future, где всегда один
Output, даже если это единичный тип ().
Stream также определяет метод для получения этих элементов. Мы называем его poll_next, чтобы
было ясно, что он опрашивает так же, как Future::poll, и производит
последовательность элементов так же, как Iterator::next. Его тип возвращаемого значения
объединяет Poll с Option. Внешний тип — Poll, потому что его нужно
проверять на готовность, так же как фьючерс. Внутренний тип — Option,
потому что нужно сигнализировать, есть ли ещё сообщения, так же как итератор
делает.
Нечто очень похожее на это определение, вероятно, в конечном итоге станет частью стандартной библиотеки Rust. Тем временем оно является частью инструментария большинства сред выполнения, так что вы можете на него полагаться, и всё, что мы рассмотрим далее, должно в целом применяться!
В примерах, которые мы видели в разделе «Стримы: фьючерсы в последовательности», однако мы не использовали poll_next или Stream, а
вместо этого использовали next и StreamExt. Мы могли бы работать напрямую в терминах
API poll_next, вручную написав собственные конечные автоматы Stream, конечно,
точно так же, как мы могли бы работать с фьючерсом напрямую через их метод poll. Использование
await гораздо приятнее, однако, и трейт StreamExt предоставляет метод next,
чтобы мы могли делать именно это:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
trait Stream {
type Item;
fn poll_next(
self: Pin<&mut Self>,
cx: &mut Context<'_>,
) -> Poll<Option<Self::Item>>;
}
trait StreamExt: Stream {
async fn next(&mut self) -> Option<Self::Item>
where
Self: Unpin;
// другие методы...
}
}Примечание: фактическое определение, которое мы использовали ранее в главе, выглядит немного иначе, потому что оно поддерживает версии Rust, которые ещё не поддерживали использование асинхронных функций в трейтах. В результате оно выглядит так:
fn next(&mut self) -> Next<'_, Self> where Self: Unpin;Тип Next — это struct, который реализует Future и позволяет нам называть
время жизни ссылки на self через Next<'_, Self>, чтобы await
мог работать с этим методом.
Трейт StreamExt также является домом для всех интересных методов, доступных
для использования со стримами. StreamExt автоматически реализуется для каждого типа,
который реализует Stream, но эти трейты определены отдельно, чтобы позволить
сообществу итерировать по удобным API, не влияя на фундаментальный
трейт.
В версии StreamExt, используемой в крейте trpl, трейт не только
определяет метод next, но также предоставляет реализацию next по умолчанию,
которая правильно обрабатывает детали вызова Stream::poll_next. Это означает,
что даже когда вам нужно написать свой собственный тип стрима, вам нужно
реализовать только Stream, и тогда любой, кто использует ваш тип данных, может использовать
StreamExt и его методы с ним автоматически.
Это всё, что мы собираемся рассмотреть о низкоуровневых деталях этих трейтов. Чтобы завершить, давайте рассмотрим, как фьючерсы (включая стримы), задачи и потоки выполнения все сочетаются друг с другом!
Собираем всё вместе: фьючерсы, задачи и потоки
Собираем всё вместе: фьючерсы, задачи и потоки
Как мы видели в главе 16, потоки предоставляют один подход к конкурентности. В этой главе мы увидели другой подход: использование async с фьючерсами и стримами. Если вы задаётесь вопросом, когда выбрать один метод вместо другого, ответ таков: зависит! И во многих случаях выбор не между потоками или async, а скорее потоками и async.
Многие операционные системы предоставляли модели конкурентности на основе потоков на протяжении десятилетий, и многие языки программирования поддерживают их в результате. Однако эти модели не лишены компромиссов. Во многих операционных системах они используют довольно много памяти для каждого потока. Потоки также являются вариантом только тогда, когда ваша операционная система и аппаратное обеспечение их поддерживают. В отличие от распространённых настольных и мобильных компьютеров, некоторые встраиваемые системы вообще не имеют ОС, поэтому они также не имеют потоков.
Модель async предоставляет другой — и в конечном счёте дополняющий — набор
компромиссов. В модели async конкурентные операции не требуют собственных
потоков. Вместо этого они могут выполняться в задачах, как когда мы использовали trpl::spawn_task, чтобы
запустить работу из синхронной функции в разделе о стримах. Задача похожа на поток, но вместо того, чтобы управляться
операционной системой, она управляется кодом уровня библиотеки: средой выполнения.
Есть причина, по которой API для порождения потоков и порождения задач настолько похожи. Потоки действуют как граница для наборов синхронных операций; конкурентность возможна между потоками. Задачи действуют как граница для наборов асинхронных операций; конкурентность возможна как между, так и внутри задач, потому что задача может переключаться между фьючерсами в своём теле. Наконец, фьючерсы являются самой гранулярной единицей конкурентности в Rust, и каждый фьючерс может представлять дерево других фьючерсов. Среда выполнения — в частности, её исполнитель — управляет задачами, а задачи управляют фьючерсами. В этом смысле задачи похожи на лёгкие, управляемые средой выполнения потоки с дополнительными возможностями, которые появляются благодаря управлению средой выполнения, а не операционной системой.
Это не означает, что асинхронные задачи всегда лучше потоков (или наоборот).
Конкурентность с потоками в некотором смысле является более простой моделью программирования,
чем конкурентность с async. Это может быть как сильной, так и слабой стороной. Потоки в некотором смысле
«выстрелил и забыл»; у них нет нативного эквивалента фьючерса, поэтому они
просто выполняются до завершения, не прерываясь, кроме как самой операционной
системой.
И оказывается, что потоки и задачи часто работают
очень хорошо вместе, потому что задачи могут (по крайней мере, в некоторых средах выполнения) перемещаться
между потоками. Фактически, под капотом среда выполнения, которую мы
использовали — включая функции spawn_blocking и spawn_task — по умолчанию многопоточна! Многие среды выполнения используют подход, называемый перехватом работы (work stealing), чтобы
прозрачно перемещать задачи между потоками на основе того, как потоки
в настоящее время используются, чтобы улучшить общую производительность системы. Этот
подход фактически требует и потоков, и задач, и, следовательно, фьючерсов.
Размышляя о том, какой метод использовать когда, рассмотрите эти практические правила:
- Если работа очень параллелизуема (то есть привязана к CPU), например обработка кучи данных, где каждая часть может обрабатываться отдельно, потоки — лучший выбор.
- Если работа очень конкурентна (то есть привязана к вводу-выводу), например обработка сообщений из кучи разных источников, которые могут приходить через разные интервалы или с разной скоростью, async — лучший выбор.
И если вам нужны и параллелизм, и конкурентность, вам не нужно выбирать между потоками и async. Вы можете свободно использовать их вместе, позволяя каждому играть свою роль, в которой он лучше всего. Например, листинг 17-25 показывает довольно распространённый пример такого сочетания в реальном коде на Rust.
extern crate trpl; // for mdbook test
use std::{thread, time::Duration};
fn main() {
let (tx, mut rx) = trpl::channel();
thread::spawn(move || {
for i in 1..11 {
tx.send(i).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
trpl::block_on(async {
while let Some(message) = rx.recv().await {
println!("{message}");
}
});
}Мы начинаем с создания асинхронного канала, затем порождаем поток, который забирает
владение отправляющей стороной канала с помощью ключевого слова move. Внутри
потока мы отправляем числа от 1 до 10, засыпая на секунду между
каждым. Наконец, мы запускаем фьючерс, созданный асинхронным блоком, переданным в
trpl::block_on, точно так же, как мы делали на протяжении всей главы. В этом фьючерсе мы
ожидаем эти сообщения, как и в других примерах передачи сообщений, которые мы
видели.
Возвращаясь к сценарию, с которого мы открыли главу, представьте запуск набора задач кодирования видео с использованием выделенного потока (поскольку кодирование видео привязано к вычислениям), но уведомление пользовательского интерфейса о том, что эти операции завершены, через асинхронный канал. Существует бесчисленное множество примеров таких комбинаций в реальных случаях использования.
Итоги
Это не последний раз, когда вы увидите конкурентность в этой книге. Проект в главе 21 применит эти концепции в более реалистичной ситуации, чем более простые примеры, обсуждаемые здесь, и напрямую сравнит решение задач с использованием потоков против задач и фьючерсов.
Какой бы из этих подходов вы ни выбрали, Rust даёт вам инструменты, необходимые для написания безопасного, быстрого, конкурентного кода — будь то для высокопроизводительного веб-сервера или встраиваемой операционной системы.
Далее мы поговорим об идиоматичных способах моделирования задач и структурирования решений по мере роста ваших программ на Rust. Кроме того, мы обсудим, как идиомы Rust соотносятся с теми, которые вы могли знать из объектно-ориентированного программирования.
Возможности объектно-ориентированного программирования
Возможности объектно-ориентированного программирования
Объектно-ориентированное программирование (ООП) — это способ моделирования программ. Объекты как программная концепция были введены в языке программирования Simula в 1960-х годах. Эти объекты повлияли на архитектуру программирования Алана Кэя, в которой объекты передают друг другу сообщения. Чтобы описать эту архитектуру, он придумал термин объектно-ориентированное программирование в 1967 году. Существует множество конкурирующих определений, описывающих, что такое ООП, и по одним из этих определений Rust является объектно-ориентированным, а по другим — нет. В этой главе мы рассмотрим определённые характеристики, которые обычно считаются объектно-ориентированными, и то, как эти характеристики переводятся в идиоматический Rust. Затем мы покажем, как реализовать объектно-ориентированный паттерн проектирования в Rust, и обсудим компромиссы такого подхода по сравнению с реализацией решения с использованием некоторых сильных сторон Rust.
Характеристики объектно-ориентированных языков
Характеристики объектно-ориентированных языков
В сообществе программистов нет единого мнения о том, какие возможности должны быть у языка, чтобы считаться объектно-ориентированным. Rust находится под влиянием многих парадигм программирования, включая ООП; например, мы изучали возможности, пришедшие из функционального программирования, в главе 13. Вероятно, объектно-ориентированные языки разделяют некоторые общие характеристики — а именно объекты, инкапсуляцию и наследование. Давайте посмотрим, что означает каждая из этих характеристик и поддерживает ли её Rust.
Объекты содержат данные и поведение
Книга Design Patterns: Elements of Reusable Object-Oriented Software Эриха Гаммы, Ричарда Хелма, Ральфа Джонсона и Джона Влиссидеса (Addison-Wesley, 1994), в обиходе называемая книгой Банды четырёх, представляет собой каталог объектно-ориентированных шаблонов проектирования. Она определяет ООП следующим образом:
Объектно-ориентированные программы состоят из объектов. Объект объединяет в себе данные и процедуры, которые оперируют этими данными. Процедуры обычно называют методами или операциями.
Используя это определение, Rust является объектно-ориентированным: структуры и перечисления имеют данные, а блоки impl предоставляют методы для структур и перечислений. Хотя структуры и перечисления с методами не называются объектами, они предоставляют ту же функциональность, согласно определению объектов Бандой четырёх.
Инкапсуляция, скрывающая детали реализации
Ещё один аспект, обычно связанный с ООП, — это идея инкапсуляции, которая означает, что детали реализации объекта недоступны для кода, использующего этот объект. Следовательно, единственный способ взаимодействия с объектом — через его публичный API; код, использующий объект, не должен иметь возможности проникать во внутренности объекта и напрямую изменять данные или поведение. Это позволяет программисту изменять и рефакторить внутренности объекта, не нуждаясь в изменении кода, который использует объект.
Мы обсуждали, как управлять инкапсуляцией в главе 7: мы можем использовать ключевое слово pub, чтобы решить, какие модули, типы, функции и методы в нашем коде должны быть публичными, а всё остальное по умолчанию является приватным. Например, мы можем определить структуру AveragedCollection, которая имеет поле, содержащее вектор значений i32. Структура также может иметь поле, которое содержит среднее значение значений в векторе, что означает, что среднее не нужно вычислять по запросу каждый раз, когда оно кому-то нужно. Другими словами, AveragedCollection будет кэшировать вычисленное среднее для нас. Листинг 18-1 содержит определение структуры AveragedCollection.
pub struct AveragedCollection {
list: Vec<i32>,
average: f64,
}AveragedCollection, которая поддерживает список целых чисел и среднее значение элементов в коллекцииСтруктура помечена как pub, чтобы другой код мог её использовать, но поля внутри структуры остаются приватными. Это важно в данном случае, потому что мы хотим гарантировать, что всякий раз, когда значение добавляется или удаляется из списка, среднее также обновляется. Мы делаем это, реализуя методы add, remove и average для структуры, как показано в листинге 18-2.
pub struct AveragedCollection {
list: Vec<i32>,
average: f64,
}
impl AveragedCollection {
pub fn add(&mut self, value: i32) {
self.list.push(value);
self.update_average();
}
pub fn remove(&mut self) -> Option<i32> {
let result = self.list.pop();
match result {
Some(value) => {
self.update_average();
Some(value)
}
None => None,
}
}
pub fn average(&self) -> f64 {
self.average
}
fn update_average(&mut self) {
let total: i32 = self.list.iter().sum();
self.average = total as f64 / self.list.len() as f64;
}
}add, remove и average для AveragedCollectionПубличные методы add, remove и average — единственные способы доступа к данным в экземпляре AveragedCollection или их изменения. Когда элемент добавляется в list с помощью метода add или удаляется с помощью метода remove, реализации каждого из них вызывают приватный метод update_average, который также обрабатывает обновление поля average.
Мы оставляем поля list и average приватными, чтобы внешний код не мог напрямую добавлять или удалять элементы в поле list или из него; в противном случае поле average могло бы рассинхронизироваться при изменении list. Метод average возвращает значение в поле average, позволяя внешнему коду читать average, но не изменять его.
Поскольку мы инкапсулировали детали реализации структуры AveragedCollection, мы можем легко изменить аспекты, такие как структура данных, в будущем. Например, мы могли бы использовать HashSet<i32> вместо Vec<i32> для поля list. До тех пор, пока сигнатуры публичных методов add, remove и average остаются прежними, код, использующий AveragedCollection, не нужно было бы менять. Если бы мы сделали list публичным вместо этого, это не обязательно было бы так: HashSet<i32> и Vec<i32> имеют разные методы для добавления и удаления элементов, поэтому внешнему коду, вероятно, пришлось бы измениться, если бы он изменял list напрямую.
Если инкапсуляция является обязательным аспектом для того, чтобы язык считался объектно-ориентированным, то Rust соответствует этому требованию. Возможность использовать pub или не использовать его для разных частей кода обеспечивает инкапсуляцию деталей реализации.
Наследование как система типов и как совместное использование кода
Наследование — это механизм, с помощью которого объект может наследовать элементы из определения другого объекта, таким образом получая данные и поведение родительского объекта без необходимости определять их снова.
Если язык должен иметь наследование, чтобы быть объектно-ориентированным, то Rust не является таким языком. Нет способа определить структуру, которая наследует поля и реализации методов родительской структуры, без использования макроса.
Однако, если вы привыкли иметь наследование в своём наборе инструментов программирования, вы можете использовать другие решения в Rust, в зависимости от причины, по которой вы обращаетесь к наследованию.
Вы бы выбрали наследование по двум основным причинам. Одна из них — повторное использование кода: вы можете реализовать определённое поведение для одного типа, и наследование позволяет вам повторно использовать эту реализацию для другого типа. Вы можете сделать это ограниченным образом в коде на Rust, используя реализации методов трейтов по умолчанию, которые вы видели в листинге 10-14, когда мы добавили реализацию по умолчанию метода summarize для трейта Summary. Любой тип, реализующий трейт Summary, будет иметь метод summarize, доступный для него без какого-либо дополнительного кода. Это похоже на то, как родительский класс имеет реализацию метода, и наследующий дочерний класс также имеет реализацию метода. Мы также можем переопределить реализацию метода summarize по умолчанию, когда реализуем трейт Summary, что похоже на то, как дочерний класс переопределяет реализацию метода, унаследованного от родительского класса.
Другая причина использования наследования связана с системой типов: чтобы позволить дочернему типу использоваться в тех же местах, что и родительский тип. Это также называется полиморфизмом, что означает, что вы можете подставлять несколько объектов друг за друга во время выполнения, если они разделяют определённые характеристики.
Полиморфизм
Для многих людей полиморфизм является синонимом наследования. Но на самом деле это более общая концепция, которая относится к коду, который может работать с данными нескольких типов. Для наследования эти типы обычно являются подклассами.
Rust вместо этого использует обобщения для абстрагирования над различными возможными типами и ограничения трейтов для наложения ограничений на то, что эти типы должны предоставлять. Это иногда называют ограниченным параметрическим полиморфизмом.
Rust выбрал другой набор компромиссов, не предлагая наследование. Наследование часто подвержено риску совместного использования большего количества кода, чем необходимо. Подклассы не всегда должны разделять все характеристики своего родительского класса, но будут делать это при наследовании. Это может сделать дизайн программы менее гибким. Это также вводит возможность вызова методов для подклассов, которые не имеют смысла или вызывают ошибки, потому что методы не применяются к подклассу. Кроме того, некоторые языки позволяют только одиночное наследование (что означает, что подкласс может наследовать только от одного класса), что ещё больше ограничивает гибкость дизайна программы.
По этим причинам Rust использует другой подход — использование трейт-объектов вместо наследования для достижения полиморфизма во время выполнения. Давайте посмотрим, как работают трейт-объекты.
Использование трейт-объектов для абстрагирования над общим поведением
Использование трейт-объектов для абстрагирования над общим поведением
В главе 8 упоминалось, что одно из ограничений векторов — они могут
хранить элементы только одного типа. В листинге 8-9 было создано обходное решение, где
определялось перечисление SpreadsheetCell с вариантами для хранения целых чисел, чисел с плавающей точкой
и текста. Это означало, что можно было хранить различные типы данных в каждой ячейке и
при этом иметь вектор, представляющий строку ячеек. Это совершенно хорошее
решение, когда взаимозаменяемые элементы представляют собой фиксированный набор типов, известных
на момент компиляции кода.
Однако иногда требуется, чтобы пользователь библиотеки мог расширить набор
типов, допустимых в определённой ситуации. Чтобы показать, как этого можно достичь,
создадим пример инструмента графического пользовательского интерфейса (GUI), который перебирает
список элементов, вызывая для каждого метод draw, чтобы нарисовать его на
экране — распространённый приём для инструментов GUI. Создадим библиотечный крейт с именем
gui, содержащий структуру библиотеки GUI. Этот крейт может включать
некоторые типы для использования людьми, такие как Button или TextField. Кроме того,
пользователи gui захотят создавать свои собственные типы, которые можно нарисовать: например,
один программист может добавить Image, а другой — SelectBox.
На момент написания библиотеки нельзя знать и определить все типы,
которые могут захотеть создать другие программисты. Но известно, что gui должно отслеживать
множество значений различных типов и вызывать метод draw
для каждого из этих значений разных типов. Не нужно знать точно, что
произойдёт при вызове метода draw, нужно лишь знать, что у значения будет этот
метод, доступный для вызова.
Чтобы сделать это в языке с наследованием, можно определить класс с именем
Component, у которого есть метод с именем draw. Другие классы, такие как
Button, Image и SelectBox, наследовали бы от Component и таким образом
наследовали бы метод draw. Каждый из них мог бы переопределить метод draw, чтобы задать
своё собственное поведение, но фреймворк мог бы рассматривать все типы так, как если бы
они были экземплярами Component, и вызывать у них draw. Но поскольку в Rust
нет наследования, нужен другой способ структурировать библиотеку gui, чтобы
позволить пользователям создавать новые типы, совместимые с библиотекой.
Определение трейта для общего поведения
Чтобы реализовать поведение, которое должно быть у gui, определим трейт
с именем Draw, у которого будет один метод с именем draw. Затем можно определить
вектор, принимающий трейт-объект. Трейт-объект указывает как на экземпляр
типа, реализующего указанный трейт, так и на таблицу, используемую для поиска методов трейта
у этого типа во время выполнения. Трейт-объект создаётся путём указания некоторого
вида указателя, например ссылки или умного указателя Box<T>, затем ключевого слова
dyn и соответствующего трейта. (Причина, по которой трейт-объекты должны использовать указатель,
будет рассмотрена в разделе «Динамически размерные типы и трейт Sized» главы 20.) Трейт-объекты можно использовать
вместо обобщённого или конкретного типа. Везде, где используется трейт-объект,
система типов Rust гарантирует на этапе компиляции, что любое значение, используемое в
этом контексте, реализует трейт трейт-объекта. Следовательно, не
нужно знать все возможные типы на этапе компиляции.
Упоминалось, что в Rust воздерживаются от называния структур и перечислений
«объектами», чтобы отличать их от объектов других языков. В структуре или
перечислении данные в полях структуры и поведение в блоках impl
разделены, тогда как в других языках данные и поведение, объединённые в одно
понятие, часто называются объектом. Трейт-объекты отличаются от объектов в других
языках тем, что к трейт-объекту нельзя добавить данные. Трейт-объекты не так
широко полезны, как объекты в других языках: их конкретное назначение — позволять
абстрагирование над общим поведением.
В листинге 18-3 показано, как определить трейт с именем Draw с одним методом с именем
draw.
pub trait Draw {
fn draw(&self);
}DrawЭтот синтаксис должен выглядеть знакомым из обсуждений того, как определять трейты
в главе 10. Далее следует новый синтаксис: листинг 18-4 определяет структуру с именем
Screen, содержащую вектор с именем components. Этот вектор имеет тип
Box<dyn Draw>, что является трейт-объектом; это заменитель любого типа внутри
Box, который реализует трейт Draw.
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}Screen с полем components, содержащим вектор трейт-объектов, реализующих трейт DrawДля структуры Screen определим метод с именем run, который будет вызывать метод
draw для каждого из её components, как показано в листинге 18-5.
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}
impl Screen {
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}run у Screen, вызывающий метод draw для каждого компонентаЭто работает иначе, чем определение структуры, использующей обобщённый параметр
типа с ограничениями трейта. Обобщённый параметр типа может быть заменён
только одним конкретным типом за раз, тогда как трейт-объекты позволяют нескольким
конкретным типам заполнять трейт-объект во время выполнения. Например, можно было бы
определить структуру Screen, используя обобщённый тип и ограничение трейта,
как в листинге 18-6.
pub trait Draw {
fn draw(&self);
}
pub struct Screen<T: Draw> {
pub components: Vec<T>,
}
impl<T> Screen<T>
where
T: Draw,
{
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}Screen и её метода run с использованием обобщённых типов и ограничений трейтовЭто ограничивает нас экземпляром Screen, у которого список компонентов все
типа Button или все типа TextField. Если когда-либо будут только однородные
коллекции, предпочтительнее использовать обобщённые типы и ограничения трейтов, потому что
определения будут мономорфизированы на этапе компиляции для использования конкретных типов.
С другой стороны, при использовании метода с трейт-объектами один экземпляр Screen
может содержать Vec<T>, который содержит Box<Button> наряду с
Box<TextField>. Рассмотрим, как это работает, а затем обсудим
последствия для производительности во время выполнения.
Реализация трейта
Теперь добавим несколько типов, реализующих трейт Draw. Предоставим
тип Button. Опять же, фактическая реализация библиотеки GUI выходит за рамки
этой книги, поэтому метод draw не будет иметь полезной реализации в своём
теле. Чтобы представить, как могла бы выглядеть реализация, структура Button
могла бы иметь поля width, height и label, как показано в листинге 18-7.
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}
impl Screen {
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}
pub struct Button {
pub width: u32,
pub height: u32,
pub label: String,
}
impl Draw for Button {
fn draw(&self) {
// код для фактического отрисовывания кнопки
}
}Button, реализующая трейт DrawПоля width, height и label у Button будут отличаться от
полей других компонентов; например, тип TextField мог бы иметь те же
самые поля плюс поле placeholder. Каждый из типов, которые нужно нарисовать на
экране, будет реализовывать трейт Draw, но использовать разный код в
методе draw, чтобы определить, как нарисовать этот конкретный тип, как Button здесь
(без фактического кода GUI, как упоминалось). Тип Button, например,
мог бы иметь дополнительный блок impl, содержащий методы, связанные с тем, что
происходит при нажатии пользователем кнопки. Такие методы не будут применяться к
типам вроде TextField.
Если кто-то, использующий библиотеку, решит реализовать структуру SelectBox, имеющую
поля width, height и options, он также реализовал бы трейт Draw
для типа SelectBox, как показано в листинге 18-8.
use gui::Draw;
struct SelectBox {
width: u32,
height: u32,
options: Vec<String>,
}
impl Draw for SelectBox {
fn draw(&self) {
// код для фактического отрисовывания выпадающего списка
}
}
fn main() {}gui и реализующий трейт Draw для структуры SelectBoxПользователь библиотеки теперь может написать свою функцию main для создания экземпляра Screen.
В экземпляр Screen можно добавить SelectBox и Button,
поместив каждый в Box<T>, чтобы получить трейт-объекты. Затем можно вызвать метод
run для экземпляра Screen, который вызовет draw для каждого из
компонентов. Листинг 18-9 показывает эту реализацию.
use gui::Draw;
struct SelectBox {
width: u32,
height: u32,
options: Vec<String>,
}
impl Draw for SelectBox {
fn draw(&self) {
// код для фактического отрисовывания выпадающего списка
}
}
use gui::{Button, Screen};
fn main() {
let screen = Screen {
components: vec![
Box::new(SelectBox {
width: 75,
height: 10,
options: vec![
String::from("Yes"),
String::from("Maybe"),
String::from("No"),
],
}),
Box::new(Button {
width: 50,
height: 10,
label: String::from("OK"),
}),
],
};
screen.run();
}При написании библиотеки не было известно, что кто-то может добавить тип
SelectBox, но реализация Screen смогла работать с
новым типом и отрисовать его, потому что SelectBox реализует трейт Draw,
что означает, что он реализует метод draw.
Эта концепция — заботиться только о сообщениях, на которые
значение отвечает, а не о конкретном типе значения — похожа на концепцию утиной
типизации в динамически типизированных языках: если это ходит как утка и крякает как
утка, то это, должно быть, утка! В реализации run для Screen
в листинге 18-5 run не нужно знать, каков конкретный тип каждого
компонента. Он не проверяет, является ли компонент экземпляром Button
или SelectBox, он просто вызывает метод draw для компонента. Указав
Box<dyn Draw> в качестве типа значений в векторе components,
мы определили Screen так, чтобы ему нужны были значения, для которых можно вызвать метод draw.
Преимущество использования трейт-объектов и системы типов Rust для написания кода, похожего на код с утиной типизацией, состоит в том, что никогда не нужно проверять во время выполнения, реализует ли значение определённый метод, или беспокоиться о получении ошибок, если значение не реализует метод, но мы его всё равно вызываем. Rust не скомпилирует код, если значения не реализуют трейты, необходимые трейт-объектам.
Например, в листинге 18-10 показано, что произойдёт при попытке создать Screen
с компонентом String.
use gui::Screen;
fn main() {
let screen = Screen {
components: vec![Box::new(String::from("Hi"))],
};
screen.run();
}Будет получена эта ошибка, потому что String не реализует трейт Draw:
$ cargo run
Compiling gui v0.1.0 (file:///projects/gui)
error[E0277]: the trait bound `String: Draw` is not satisfied
--> src/main.rs:5:26
|
5 | components: vec![Box::new(String::from("Hi"))],
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ the trait `Draw` is not implemented for `String`
|
help: the trait `Draw` is implemented for `Button`
--> src/lib.rs:23:1
|
23 | impl Draw for Button {
| ^^^^^^^^^^^^^^^^^^^^
= note: required for the cast from `Box<String>` to `Box<dyn Draw>`
For more information about this error, try `rustc --explain E0277`.
error: could not compile `gui` (bin "gui") due to 1 previous error
Эта ошибка сообщает, что либо в Screen передаётся что-то, что
не должно было передаваться, и поэтому следует передать другой тип, либо нужно реализовать
Draw для String, чтобы Screen мог вызвать draw для него.
Выполнение динамической диспетчеризации
Вспомним обсуждение «Производительность кода, использующего обобщения» в главе 10 о процессе мономорфизации, выполняемом компилятором для обобщённых типов: компилятор генерирует необобщённые реализации функций и методов для каждого конкретного типа, используемого вместо обобщённого параметра типа. Код, получающийся в результате мономорфизации, выполняет статическую диспетчеризацию, при которой компилятор знает, какой метод вызывается на этапе компиляции. Это противоположно динамической диспетчеризации, при которой компилятор не может определить на этапе компиляции, какой метод вызывается. В случаях динамической диспетчеризации компилятор генерирует код, который во время выполнения будет знать, какой метод вызывать.
Когда используются трейт-объекты, Rust должен использовать динамическую диспетчеризацию. Компилятор не знает всех типов, которые могут быть использованы с кодом, использующим трейт-объекты, поэтому он не знает, какой метод, реализованный для какого типа, вызывать. Вместо этого во время выполнения Rust использует указатели внутри трейт-объекта, чтобы определить, какой метод вызывать. Этот поиск влечёт за собой затраты времени выполнения, которых нет при статической диспетчеризации. Динамическая диспетчеризация также не позволяет компилятору выбирать встраивание кода метода, что, в свою очередь, препятствует некоторым оптимизациям, и в Rust есть некоторые правила о том, где можно и где нельзя использовать динамическую диспетчеризацию, называемые dyn-совместимостью. Эти правила выходят за рамки данного обсуждения, но о них можно прочитать подробнее в справочнике. Однако была получена дополнительная гибкость в коде, который был написан в листинге 18-5 и поддерживался в листинге 18-9, так что это компромисс, который следует учитывать.
Реализация объектно-ориентированного шаблона проектирования
Реализация объектно-ориентированного шаблона проектирования
Шаблон состояния — это объектно-ориентированный шаблон проектирования. Суть шаблона в том, что определяется набор состояний, которые значение может иметь внутри себя. Состояния представлены набором объектов состояний, и поведение значения меняется в зависимости от его состояния. Мы поработаем над примером структуры записи в блоге, у которой есть поле для хранения её состояния, которое будет объектом состояния из набора «черновик», «на рассмотрении» или «опубликовано».
Объекты состояний разделяют функциональность: в Rust, конечно, используются структуры и трейты, а не объекты и наследование. Каждый объект состояния отвечает за своё собственное поведение и за управление тем, когда он должен перейти в другое состояние. Значение, содержащее объект состояния, ничего не знает о различном поведении состояний или о том, когда переходить между состояниями.
Преимущество использования шаблона состояния состоит в том, что при изменении бизнес- требований программы не нужно менять код значения, содержащего состояние, или код, использующий это значение. Понадобится только обновить код внутри одного из объектов состояний, чтобы изменить его правила или, возможно, добавить больше объектов состояний.
Сначала реализуем шаблон состояния более традиционным объектно-ориентированным способом. Затем используем подход, который немного более естественен для Rust. Приступим к поэтапной реализации рабочего процесса записи в блог с использованием шаблона состояния.
Итоговая функциональность будет выглядеть так:
- Запись в блоге начинается как пустой черновик.
- Когда черновик готов, запрашивается рецензирование записи.
- Когда запись одобрена, она публикуется.
- Только опубликованные записи в блоге возвращают содержимое для печати, чтобы неодобренные записи не могли быть случайно опубликованы.
Любые другие изменения, предпринятые для записи, не должны иметь эффекта. Например, если попытаться одобрить черновик записи в блоге до того, как запрошено рецензирование, запись должна остаться неопубликованным черновиком.
Попытка использования традиционного объектно-ориентированного стиля
Существует бесконечное множество способов структурировать код для решения одной и той же задачи, каждый с разными компромиссами. Реализация в этом разделе — скорее традиционный объектно-ориентированный стиль, который можно написать на Rust, но который не использует некоторые сильные стороны Rust. Позже будет продемонстрировано другое решение, которое по-прежнему использует объектно-ориентированный шаблон проектирования, но структурировано так, что может показаться менее привычным программистам с объектно-ориентированным опытом. Сравним два решения, чтобы на практике ощутить компромиссы проектирования кода на Rust иначе, чем кода на других языках.
Листинг 18-11 показывает этот рабочий процесс в виде кода: это пример использования
API, который будет реализован в библиотечном крейте с именем blog. Этот код пока не будет компилироваться,
потому что крейт blog ещё не реализован.
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
assert_eq!("", post.content());
post.request_review();
assert_eq!("", post.content());
post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}blogНужно позволить пользователю создать новую черновую запись в блоге с помощью Post::new. Нужно
позволить добавлять текст к записи в блоге. Если попытаться получить содержимое записи
сразу, до одобрения, не должно быть получено никакого текста, потому что запись
всё ещё черновик. Мы добавили assert_eq! в код для демонстрационных
целей. Отличным модульным тестом для этого было бы утверждение, что черновая запись в блоге
возвращает пустую строку из метода content, но мы не собираемся
писать тесты для этого примера.
Далее нужно включить возможность запроса рецензирования записи, и нужно, чтобы
content возвращал пустую строку в ожидании рецензирования. Когда запись
получает одобрение, она должна быть опубликована, то есть текст записи будет
возвращаться при вызове content.
Обратите внимание, что единственный тип, с которым мы взаимодействуем из крейта, — это Post.
Этот тип будет использовать шаблон состояния и хранить значение, которое будет
одним из трёх объектов состояний, представляющих различные состояния, в которых может находиться запись
— черновик, на рассмотрении или опубликовано. Переход из одного состояния в другое будет
управляться внутри типа Post. Состояния меняются в ответ на
методы, вызываемые пользователями библиотеки для экземпляра Post, но им не
нужно управлять изменениями состояния напрямую. Кроме того, пользователи не могут ошибиться
с состояниями, например, опубликовать запись до её рецензирования.
Определение Post и создание нового экземпляра
Начнём реализацию библиотеки! Известно, что нужна публичная структура Post, которая хранит
некоторое содержимое, поэтому начнём с определения структуры и связанной
публичной функции new для создания экземпляра Post, как показано в листинге 18-12. Также
сделаем приватный трейт State, который будет определять поведение, которое должны иметь все объекты состояний для Post.
Затем Post будет хранить трейт-объект Box<dyn State> внутри Option<T>
в приватном поле с именем state для хранения объекта состояния. Вскоре будет показано, почему
нужен Option<T>.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
}
trait State {}
struct Draft {}
impl State for Draft {}Post и функции new, создающей новый экземпляр Post, трейта State и структуры DraftТрейт State определяет поведение, общее для разных состояний записи.
Объекты состояний — это Draft, PendingReview и Published, и все они будут
реализовывать трейт State. Пока трейт не имеет методов, и
начнём с определения только состояния Draft, потому что это состояние, в котором
должна начинаться запись.
При создании нового Post его поле state устанавливается в значение Some, которое
содержит Box. Этот Box указывает на новый экземпляр структуры Draft. Это
гарантирует, что при каждом создании нового экземпляра Post он будет начинаться как
черновик. Поскольку поле state у Post приватное, нет способа
создать Post в каком-либо другом состоянии! В функции Post::new поле content
устанавливается в новую пустую String.
Сохранение текста содержимого записи
В листинге 18-11 было видно, что нужно иметь возможность вызвать метод с именем
add_text и передать ему &str, который затем добавляется как текстовое содержимое
записи в блоге. Это реализуется как метод, а не как публичное поле content,
чтобы позже можно было реализовать метод, который будет управлять тем, как
читаются данные поля content. Метод add_text довольно
прост, поэтому добавим реализацию в листинге 18-13 в блок impl Post.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
}
trait State {}
struct Draft {}
impl State for Draft {}add_text для добавления текста в content записиМетод add_text принимает изменяемую ссылку на self, потому что
изменяется экземпляр Post, для которого вызывается add_text. Затем вызывается
push_str для String в content и передаётся аргумент text для добавления к
сохранённому content. Это поведение не зависит от состояния, в котором находится запись,
поэтому оно не является частью шаблона состояния. Метод add_text не взаимодействует
с полем state вообще, но является частью поведения, которое нужно
поддерживать.
Обеспечение пустоты содержимого черновой записи
Даже после вызова add_text и добавления некоторого содержимого в запись
по-прежнему нужно, чтобы метод content возвращал пустой срез строки, потому что запись
всё ещё находится в состоянии черновика, как показано первым assert_eq! в листинге 18-11.
Пока реализуем метод content с самым простым вариантом, который
удовлетворит это требование: всегда возвращать пустой срез строки. Это будет изменено
позже, когда будет реализована возможность изменения состояния записи, чтобы она
могла быть опубликована. Пока записи могут находиться только в состоянии черновика, поэтому содержимое записи
должно всегда быть пустым. В листинге 18-14 показана эта заполняющая
реализация.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
}
trait State {}
struct Draft {}
impl State for Draft {}content для Post, всегда возвращающей пустой срез строкиС этим добавленным методом content всё в листинге 18-11 до первого
assert_eq! работает как задумано.
Запрос рецензирования, изменяющий состояние записи
Далее нужно добавить функциональность для запроса рецензирования записи, которая должна
изменить её состояние с Draft на PendingReview. В листинге 18-15 показан этот код.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
}request_review для Post и трейта StateУ Post появляется публичный метод с именем request_review, который принимает изменяемую
ссылку на self. Затем вызывается внутренний метод request_review для
текущего состояния Post, и этот второй метод request_review потребляет
текущее состояние и возвращает новое состояние.
Метод request_review добавляется в трейт State; все типы, реализующие трейт,
теперь должны будут реализовать метод request_review.
Обратите внимание, что в качестве первого параметра метода используется не self, &self или &mut self,
а self: Box<Self>. Этот синтаксис означает, что
метод действителен только при вызове у Box, содержащего тип. Этот синтаксис принимает
владение Box<Self>, делая недействительным старое состояние, так что значение состояния
Post может преобразоваться в новое состояние.
Чтобы потребить старое состояние, метод request_review должен принять владение
значением состояния. Здесь и пригодится Option в поле state у Post:
вызывается метод take, чтобы извлечь значение Some из поля state
и оставить на его месте None, потому что Rust не позволяет иметь
незаполненные поля в структурах. Это позволяет переместить значение state из
Post, а не заимствовать его. Затем значение state записи устанавливается в
результат этой операции.
Нужно установить state в None временно, а не устанавливать его напрямую
кодом вроде self.state = self.state.request_review();, чтобы получить владение
значением state. Это гарантирует, что Post не сможет использовать старое значение state
после того, как оно было преобразовано в новое состояние.
Метод request_review у Draft возвращает новый упакованный в Box экземпляр новой
структуры PendingReview, которая представляет состояние, когда запись ожидает
рецензирования. Структура PendingReview также реализует метод request_review,
но не выполняет никаких преобразований. Вместо этого она возвращает саму себя, потому что при
запросе рецензирования записи, уже находящейся в состоянии PendingReview, она должна остаться
в состоянии PendingReview.
Теперь можно начать видеть преимущества шаблона состояния: метод
request_review у Post одинаков независимо от значения state. Каждое
состояние отвечает за свои собственные правила.
Метод content у Post оставим как есть, возвращающим пустой срез строки.
Теперь Post может находиться в состоянии PendingReview так же, как и в
состоянии Draft, но нужно одинаковое поведение в состоянии PendingReview.
Листинг 18-11 теперь работает до второго вызова assert_eq!!
Добавление approve для изменения поведения content
Метод approve будет похож на метод request_review: он будет
устанавливать state в значение, которое текущее состояние говорит, что должно быть, когда это
состояние одобрено, как показано в листинге 18-16.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}approve для Post и трейта StateМетод approve добавляется в трейт State и добавляется новая структура, реализующая
State, — состояние Published.
Подобно тому, как работает request_review у PendingReview, если вызвать метод
approve у Draft, это не будет иметь эффекта, потому что approve
вернёт self. При вызове approve у PendingReview возвращается новый
упакованный в Box экземпляр структуры Published. Структура Published реализует
трейт State, и как для метода request_review, так и для метода approve
она возвращает саму себя, потому что запись должна оставаться в состоянии Published
в этих случаях.
Теперь нужно обновить метод content у Post. Нужно, чтобы значение,
возвращаемое из content, зависело от текущего состояния Post, поэтому
Post будет делегировать вызов методу content, определённому в его state,
как показано в листинге 18-17.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
self.state.as_ref().unwrap().content(self)
}
// --snip--
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}content у Post для делегирования методу content у StateПоскольку цель — держать все эти правила внутри структур, реализующих
State, вызывается метод content у значения в state, и передаётся
экземпляр записи (то есть self) в качестве аргумента. Затем возвращается значение,
возвращённое из использования метода content у значения state.
Метод as_ref вызывается у Option, потому что нужна ссылка на
значение внутри Option, а не владение значением. Поскольку state —
это Option<Box<dyn State>>, при вызове as_ref возвращается Option<&Box<dyn State>>. Если бы
as_ref не вызывался, была бы получена ошибка, потому что нельзя переместить
state из заимствованного &self параметра функции.
Затем вызывается метод unwrap, который, как известно, никогда не вызовет панику, потому что
методы у Post гарантируют, что state всегда будет содержать значение Some,
когда эти методы завершаются. Это один из случаев, о которых говорилось в
разделе «Когда у вас больше информации, чем у
компилятора» главы 9, когда
известно, что значение None невозможно, хотя компилятор не способен
это понять.
На этом этапе при вызове content у &Box<dyn State> разыменовывающее приведение
типов вступит в силу для & и Box, так что в конечном итоге метод content будет
вызван у типа, реализующего трейт State. Это означает,
что нужно добавить content в определение трейта State, и именно здесь
будет размещена логика того, какое содержимое возвращать в зависимости от того, какое состояние
есть, как показано в листинге 18-18.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
self.state.as_ref().unwrap().content(self)
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
fn content<'a>(&self, post: &'a Post) -> &'a str {
""
}
}
// --snip--
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
fn content<'a>(&self, post: &'a Post) -> &'a str {
&post.content
}
}content в трейт StateДобавим реализацию по умолчанию для метода content, возвращающую пустой
срез строки. Это означает, что не нужно реализовывать content у структур Draft
и PendingReview. Структура Published переопределит метод content
и вернёт значение в post.content. Хотя это удобно, наличие метода
content у State, определяющего содержимое Post, размывает
границы между ответственностью State и ответственностью Post.
Обратите внимание, что для этого метода нужны аннотации времени жизни, как обсуждалось в
главе 10. Принимается ссылка на post в качестве аргумента и возвращается
ссылка на часть этого post, поэтому время жизни возвращаемой ссылки связано
с временем жизни аргумента post.
И готово — всё в листинге 18-11 теперь работает! Шаблон состояния реализован
с правилами рабочего процесса записи в блоге. Логика, связанная с
правилами, находится в объектах состояний, а не разбросана по Post.
Почему не перечисление?
Возможно, возник вопрос, почему не использовалось перечисление с различными
возможными состояниями записи в качестве вариантов. Это, безусловно, возможное решение; попробуйте
и сравните конечные результаты, чтобы увидеть, что больше нравится! Один из недостатков использования
перечисления состоит в том, что каждое место, проверяющее значение перечисления, потребует
выражения match или аналогичного для обработки каждого возможного варианта. Это может стать
более повторяющимся, чем это решение с трейт-объектами.
Оценка шаблона состояния
Было показано, что Rust способен реализовать объектно-ориентированный шаблон состояния,
чтобы инкапсулировать различные виды поведения, которые должна иметь запись
в каждом состоянии. Методы у Post ничего не знают о различных поведениях.
Благодаря тому, как организован код, нужно посмотреть только в одно место, чтобы
узнать различные способы поведения опубликованной записи: реализацию
трейта State для структуры Published.
Если бы была создана альтернативная реализация без использования шаблона
состояния, можно было бы вместо этого использовать выражения match в методах у
Post или даже в коде main, который проверяет состояние записи и меняет поведение
в этих местах. Это означало бы, что нужно было бы смотреть в несколько мест, чтобы
понять все последствия того, что запись находится в опубликованном состоянии.
С шаблоном состояния методы Post и места использования Post не
нуждаются в выражениях match, а для добавления нового состояния нужно было бы только добавить
новую структуру и реализовать методы трейта для этой одной структуры в одном месте.
Реализация с использованием шаблона состояния легко расширяется для добавления функциональности. Чтобы увидеть простоту поддержки кода, использующего шаблон состояния, попробуйте несколько из этих предложений:
- Добавить метод
reject, который переводит состояние записи изPendingReviewобратно вDraft. - Требовать два вызова
approve, прежде чем состояние сможет измениться наPublished. - Разрешить пользователям добавлять текстовое содержимое только тогда, когда запись находится в состоянии
Draft. Подсказка: пусть объект состояния отвечает за то, что может измениться в содержимом, но не отвечает за изменениеPost.
Один из недостатков шаблона состояния состоит в том, что, поскольку состояния реализуют
переходы между состояниями, некоторые из состояний связаны друг с другом. Если
добавить ещё одно состояние между PendingReview и Published, например Scheduled,
пришлось бы изменить код в PendingReview для перехода в
Scheduled вместо этого. Было бы меньше работы, если бы PendingReview не нужно было
менять при добавлении нового состояния, но это означало бы переключение на
другой шаблон проектирования.
Ещё один недостаток — дублирование некоторой логики. Чтобы устранить часть
дублирования, можно попытаться сделать реализации по умолчанию для методов
request_review и approve в трейте State, возвращающие self.
Однако это не сработает: при использовании State в качестве трейт-объекта трейт
не знает, каким именно будет конкретный self, поэтому тип возвращаемого значения неизвестен
на этапе компиляции. (Это одно из правил dyn-совместимости, упомянутых
ранее.)
Другое дублирование включает похожие реализации методов request_review
и approve у Post. Оба метода используют Option::take с полем
state у Post, и если state равен Some, они делегируют
реализации того же метода у обёрнутого значения и устанавливают новое значение поля state
в результат. Если бы у Post было много методов, следующих этому
шаблону, можно было бы рассмотреть определение макроса для устранения повторения (см.
раздел «Макросы» главы 20).
Реализуя шаблон состояния в точности так, как он определён для объектно-ориентированных
языков, мы не используем сильные стороны Rust в полной мере. Рассмотрим некоторые изменения, которые можно внести в
крейт blog, чтобы сделать недопустимые состояния и переходы ошибками времени компиляции.
Кодирование состояний и поведения как типов
Будет показано, как переосмыслить шаблон состояния, чтобы получить другой набор компромиссов. Вместо того чтобы полностью инкапсулировать состояния и переходы так, чтобы внешний код ничего о них не знал, будем кодировать состояния в различные типы. Следовательно, система проверки типов Rust будет предотвращать попытки использовать черновые записи там, где разрешены только опубликованные записи, выдавая ошибку компилятора.
Рассмотрим первую часть main в листинге 18-11:
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
assert_eq!("", post.content());
post.request_review();
assert_eq!("", post.content());
post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}По-прежнему нужно включить создание новых записей в состоянии черновика с помощью Post::new
и возможность добавлять текст к содержимому записи. Но вместо того, чтобы у черновой записи
был метод content, возвращающий пустую строку, сделаем так,
чтобы у черновых записей вообще не было метода content. Таким образом, при попытке
получить содержимое черновой записи будет получена ошибка компилятора, сообщающая, что метод
не существует. В результате будет невозможно случайно
отобразить содержимое черновой записи в продакшене, потому что этот код даже не скомпилируется.
В листинге 18-19 показано определение структуры Post и структуры DraftPost,
а также методы у каждой.
pub struct Post {
content: String,
}
pub struct DraftPost {
content: String,
}
impl Post {
pub fn new() -> DraftPost {
DraftPost {
content: String::new(),
}
}
pub fn content(&self) -> &str {
&self.content
}
}
impl DraftPost {
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
}Post с методом content и DraftPost без метода contentОбе структуры, Post и DraftPost, имеют приватное поле content, в котором
хранится текст записи в блоге. У структур больше нет поля state, потому что
кодирование состояния перенесено в типы структур. Структура Post
будет представлять опубликованную запись, и у неё есть метод content, который
возвращает content.
По-прежнему есть функция Post::new, но вместо возврата экземпляра
Post она возвращает экземпляр DraftPost. Поскольку content приватное и
нет ни одной функции, возвращающей Post, сейчас невозможно создать
экземпляр Post.
У структуры DraftPost есть метод add_text, поэтому можно добавлять текст в
content, как и раньше, но обратите внимание, что у DraftPost не определён метод content!
Значит, теперь программа гарантирует, что все записи начинаются как черновики, а
содержимое черновиков недоступно для отображения. Любая попытка обойти
эти ограничения приведёт к ошибке компилятора.
Итак, как получить опубликованную запись? Нужно обеспечить правило, что черновая
запись должна быть рассмотрена и одобрена, прежде чем может быть опубликована. Запись в
состоянии ожидания рецензирования по-прежнему не должна отображать никакого содержимого. Реализуем
эти ограничения, добавив ещё одну структуру, PendingReviewPost, определив метод
request_review у DraftPost, возвращающий PendingReviewPost, и
определив метод approve у PendingReviewPost, возвращающий Post, как
показано в листинге 18-20.
pub struct Post {
content: String,
}
pub struct DraftPost {
content: String,
}
impl Post {
pub fn new() -> DraftPost {
DraftPost {
content: String::new(),
}
}
pub fn content(&self) -> &str {
&self.content
}
}
impl DraftPost {
// --snip--
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn request_review(self) -> PendingReviewPost {
PendingReviewPost {
content: self.content,
}
}
}
pub struct PendingReviewPost {
content: String,
}
impl PendingReviewPost {
pub fn approve(self) -> Post {
Post {
content: self.content,
}
}
}PendingReviewPost, создаваемый путём вызова request_review у DraftPost, и метод approve, превращающий PendingReviewPost в опубликованный PostМетоды request_review и approve принимают владение self, таким образом
потребляя экземпляры DraftPost и PendingReviewPost и преобразуя
их в PendingReviewPost и опубликованный Post соответственно. Таким образом,
не останется никаких оставшихся экземпляров DraftPost после вызова
request_review для них, и так далее. У структуры PendingReviewPost нет
метода content, поэтому попытка прочитать её содержимое
приведёт к ошибке компилятора, как и с DraftPost. Поскольку единственный способ получить
опубликованный экземпляр Post, у которого есть метод content, — это вызвать
метод approve у PendingReviewPost, а единственный способ получить
PendingReviewPost — вызвать метод request_review у DraftPost,
теперь рабочий процесс записи в блоге закодирован в системе типов.
Но также придётся внести некоторые небольшие изменения в main. Методы request_review и
approve возвращают новые экземпляры, а не изменяют структуру, для которой они
вызваны, поэтому нужно добавить больше затеняющих присваиваний let post =, чтобы сохранить
возвращённые экземпляры. Также больше нельзя иметь утверждения о том, что содержимое черновой и
ожидающей рецензирования записей пусто, и они не нужны: нельзя
скомпилировать код, который пытается использовать содержимое записей в этих состояниях. Обновлённый код в main
показан в листинге 18-21.
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
let post = post.request_review();
let post = post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}main для использования новой реализации рабочего процесса записи в блогеИзменения, которые потребовались в main для переназначения post, означают, что эта
реализация уже не совсем следует объектно-ориентированному шаблону состояния:
преобразования между состояниями больше не инкапсулированы полностью
внутри реализации Post. Однако выигрыш в том, что недопустимые состояния
теперь невозможны благодаря системе типов и проверке типов, которая происходит во
время компиляции! Это гарантирует, что определённые ошибки, такие как отображение содержимого
неопубликованной записи, будут обнаружены до того, как попадут в продакшен.
Попробуйте выполнить задачи, предложенные в начале этого раздела, для крейта blog в том виде,
в каком он находится после листинга 18-21, чтобы увидеть, что думаете о дизайне этой версии
кода. Обратите внимание, что некоторые из задач, возможно, уже выполнены в этом
дизайне.
Было показано, что хотя Rust способен реализовать объектно-ориентированные шаблоны проектирования, другие шаблоны, такие как кодирование состояния в систему типов, также доступны в Rust. У этих шаблонов разные компромиссы. Хотя объектно-ориентированные шаблоны могут быть очень знакомы, переосмысление задачи с использованием возможностей Rust может дать преимущества, такие как предотвращение некоторых ошибок на этапе компиляции. Объектно-ориентированные шаблоны не всегда будут лучшим решением в Rust из-за определённых возможностей, таких как владение, которых нет в объектно-ориентированных языках.
Итоги
Независимо от того, считается ли Rust объектно-ориентированным языком после прочтения этой главы, теперь известно, что можно использовать трейт-объекты для получения некоторых объектно-ориентированных возможностей в Rust. Динамическая диспетчеризация может дать коду некоторую гибкость в обмен на небольшую потерю производительности во время выполнения. Эту гибкость можно использовать для реализации объектно-ориентированных шаблонов, которые могут помочь в поддержке кода. В Rust также есть другие возможности, такие как владение, которых нет в объектно-ориентированных языках. Объектно-ориентированный шаблон не всегда будет лучшим способом использования сильных сторон Rust, но это доступная опция.
Далее рассмотрим шаблоны — ещё одну возможность Rust, обеспечивающую большую гибкость. Они кратко рассматривались на протяжении всей книги, но ещё не были показаны в полной мере. Приступим!
Шаблоны и сопоставление
Шаблоны и сопоставление
Шаблоны — это специальный синтаксис в Rust для сопоставления со структурой
типов, как сложных, так и простых. Использование шаблонов вместе с выражениями match
и другими конструкциями даёт больше контроля над потоком управления программы. Шаблон состоит из некоторой комбинации следующего:
- Литералы
- Деструктурированные массивы, перечисления, структуры или кортежи
- Переменные
- Подстановочные знаки
- Заполнители
Некоторые примеры шаблонов включают x, (a, 3) и Some(Color::Red). В
контекстах, где шаблоны допустимы, эти компоненты описывают форму
данных. Затем наша программа сопоставляет значения с шаблонами, чтобы определить, имеет ли
оно правильную форму данных для продолжения выполнения определённого фрагмента кода.
Чтобы использовать шаблон, мы сравниваем его с некоторым значением. Если шаблон соответствует
значению, мы используем части значения в нашем коде. Вспомните выражения match в
главе 6, которые использовали шаблоны, например, пример с автоматом по сортировке монет. Если
значение соответствует форме шаблона, мы можем использовать именованные части. Если
нет, код, связанный с шаблоном, не выполнится.
Эта глава — справочник по всему, что связано с шаблонами. Мы рассмотрим допустимые места использования шаблонов, разницу между опровержимыми и неопровержимыми шаблонами, а также различные виды синтаксиса шаблонов, которые вы можете встретить. К концу главы вы будете знать, как использовать шаблоны для ясного выражения многих концепций.
Все места, где можно использовать шаблоны
Все места, где можно использовать шаблоны
Шаблоны встречаются в ряде мест в Rust, и вы использовали их много раз, даже не осознавая этого! В этом разделе обсуждаются все места, где шаблоны допустимы.
Ветви match
Как обсуждалось в шестой главе, мы используем шаблоны в ветвях выражений match.
Формально выражения match определяются как ключевое слово match, значение для
сопоставления и одна или несколько ветвей match, состоящих из шаблона и
выражения для выполнения, если значение соответствует шаблону этой ветви, вот так:
match VALUE {
PATTERN => EXPRESSION,
PATTERN => EXPRESSION,
PATTERN => EXPRESSION,
}Например, вот выражение match из листинга 6-5, которое сопоставляется со
значением Option<i32> в переменной x:
match x {
None => None,
Some(i) => Some(i + 1),
}Шаблоны в этом выражении match — это None и Some(i) слева от каждой
стрелки.
Одно требование к выражениям match состоит в том, что они должны быть исчерпывающими в
том смысле, что все возможности для значения в выражении match должны
быть учтены. Один из способов убедиться, что вы охватили все возможности, —
иметь шаблон, охватывающий все остальные случаи, для последней ветви: например, имя переменной,
соответствующее любому значению, никогда не может потерпеть неудачу и, таким образом, охватывает все оставшиеся случаи.
Конкретный шаблон _ соответствует чему угодно, но он никогда не связывается с
переменной, поэтому он часто используется в последней ветви match. Шаблон _ может быть
полезен, когда вы хотите игнорировать любое значение, не указанное, например. Мы
рассмотрим шаблон _ более подробно в разделе «Игнорирование значений в
шаблоне» далее в этой главе.
Операторы let
До этой главы мы явно обсуждали использование шаблонов только с
match и if let, но на самом деле мы использовали шаблоны и в других местах,
включая операторы let. Например, рассмотрим это простое
присваивание переменной с помощью let:
#![allow(unused)]
fn main() {
let x = 5;
}Каждый раз, когда вы использовали такой оператор let, вы использовали шаблоны,
хотя, возможно, и не осознавали этого! Более формально оператор let выглядит
так:
let PATTERN = EXPRESSION;
В операторах вроде let x = 5; с именем переменной на месте PATTERN
имя переменной — это просто особенно простая форма шаблона. Rust сравнивает
выражение с шаблоном и присваивает любые найденные имена. Так, в
примере let x = 5; x — это шаблон, означающий «связать то, что совпадает здесь, с
переменной x». Поскольку имя x — это весь шаблон, этот шаблон
фактически означает «связать всё с переменной x, каким бы ни было значение».
Чтобы яснее увидеть аспект сопоставления с образцом у let, рассмотрим листинг
19-1, который использует шаблон с let для деструктуризации кортежа.
fn main() {
let (x, y, z) = (1, 2, 3);
}Здесь мы сопоставляем кортеж с шаблоном. Rust сравнивает значение (1, 2, 3)
с шаблоном (x, y, z) и видит, что значение соответствует шаблону — то есть
он видит, что количество элементов одинаково в обоих — поэтому Rust связывает 1 с
x, 2 с y и 3 с z. Вы можете думать об этом шаблоне кортежа как о вложении
трёх отдельных шаблонов переменных внутри него.
Если количество элементов в шаблоне не совпадает с количеством элементов в кортеже, общий тип не совпадёт, и мы получим ошибку компилятора. Например, листинг 19-2 показывает попытку деструктурировать кортеж с тремя элементами в две переменные, что не сработает.
fn main() {
let (x, y) = (1, 2, 3);
}Попытка скомпилировать этот код приводит к этой ошибке типа:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error[E0308]: mismatched types
--> src/main.rs:2:9
|
2 | let (x, y) = (1, 2, 3);
| ^^^^^^ --------- this expression has type `({integer}, {integer}, {integer})`
| |
| expected a tuple with 3 elements, found one with 2 elements
|
= note: expected tuple `({integer}, {integer}, {integer})`
found tuple `(_, _)`
For more information about this error, try `rustc --explain E0308`.
error: could not compile `patterns` (bin "patterns") due to 1 previous error
Чтобы исправить ошибку, мы могли бы проигнорировать одно или несколько значений в кортеже, используя
_ или .., как вы увидите в разделе «Игнорирование значений в
шаблоне». Если проблема
в том, что у нас слишком много переменных в шаблоне, решение состоит в том, чтобы привести
типы в соответствие, удалив переменные так, чтобы количество переменных равнялось
количеству элементов в кортеже.
Условные выражения if let
В шестой главе мы обсуждали, как использовать выражения if let в основном как более короткий
способ написать эквивалент match, который соответствует только одному случаю.
Опционально if let может иметь соответствующий else, содержащий код для выполнения, если
шаблон в if let не совпадает.
Листинг 19-3 показывает, что также возможно смешивать и сочетать if let, else if и else if let. Это даёт нам больше гибкости, чем
выражение match, в котором мы можем выразить только одно значение для сравнения с
шаблонами. Кроме того, Rust не требует, чтобы условия в серии if let, else if и else if let были связаны друг с другом.
Код в листинге 19-3 определяет, какой цвет сделать фон, на основе серии проверок нескольких условий. Для этого примера мы создали переменные с жёстко заданными значениями, которые реальная программа могла бы получить от пользовательского ввода.
fn main() {
let favorite_color: Option<&str> = None;
let is_tuesday = false;
let age: Result<u8, _> = "34".parse();
if let Some(color) = favorite_color {
println!("Using your favorite color, {color}, as the background");
} else if is_tuesday {
println!("Tuesday is green day!");
} else if let Ok(age) = age {
if age > 30 {
println!("Using purple as the background color");
} else {
println!("Using orange as the background color");
}
} else {
println!("Using blue as the background color");
}
}if let, else if, else if let и elseЕсли пользователь указывает любимый цвет, этот цвет используется в качестве фона. Если любимый цвет не указан и сегодня вторник, цвет фона — зелёный. В противном случае, если пользователь указывает свой возраст в виде строки и мы можем разобрать его как число успешно, цвет — либо фиолетовый, либо оранжевый в зависимости от значения числа. Если ни одно из этих условий не применимо, цвет фона — синий.
Эта условная структура позволяет нам поддерживать сложные требования. С
жёстко заданными значениями, которые у нас здесь есть, этот пример выведет Using purple as the background color.
Вы можете видеть, что if let также может вводить новые переменные, которые затеняют существующие
переменные так же, как это могут делать ветви match: строка if let Ok(age) = age
вводит новую переменную age, которая содержит значение внутри варианта Ok,
затеняя существующую переменную age. Это означает, что нам нужно поместить условие if age > 30
внутри этого блока: мы не можем объединить эти два условия в if let Ok(age) = age && age > 30. Новая age, которую мы хотим сравнить с 30, не
действительна до тех пор, пока не начнётся новая область видимости с фигурной скобки.
Недостаток использования выражений if let состоит в том, что компилятор не проверяет
исчерпывающест��, тогда как с выражениями match он это делает. Если бы мы пропустили
последний блок else и, следовательно, не обработали некоторые случаи, компилятор
не предупредил бы нас о возможной логической ошибке.
Условные циклы while let
По конструкции похожий на if let, условный цикл while let позволяет
циклу while выполняться до тех пор, пока шаблон продолжает совпадать. В листинге
19-4 мы показываем цикл while let, который ожидает сообщения, отправленные между потоками,
но в этом случае проверяет Result вместо Option.
fn main() {
let (tx, rx) = std::sync::mpsc::channel();
std::thread::spawn(move || {
for val in [1, 2, 3] {
tx.send(val).unwrap();
}
});
while let Ok(value) = rx.recv() {
println!("{value}");
}
}while let для печати значений до тех пор, пока rx.recv() возвращает OkЭтот пример печатает 1, 2, а затем 3. Метод recv берёт первое
сообщение из принимающей стороны канала и возвращает Ok(value). Когда
мы впервые увидели recv в шестнадцатой главе, мы разворачивали ошибку напрямую, или
мы взаимодействовали с ней как с итератором, используя цикл for. Как показывает листинг 19-4,
однако, мы также можем использовать while let, потому что метод recv возвращает Ok
каждый раз, когда приходит сообщение, пока существует отправитель, а затем выдаёт
Err, как только отправитель отключается.
Циклы for
В цикле for значение, которое непосредственно следует за ключевым словом for, является
шаблоном. Например, в for x in y x — это шаблон. Листинг 19-5
демонстрирует, как использовать шаблон в цикле for для деструктуризации, или разбора
на части, кортежа как части цикла for.
fn main() {
let v = vec!['a', 'b', 'c'];
for (index, value) in v.iter().enumerate() {
println!("{value} is at index {index}");
}
}for для деструктуризации кортежаКод в листинге 19-5 выведет следующее:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.52s
Running `target/debug/patterns`
a is at index 0
b is at index 1
c is at index 2
Мы адаптируем итератор с помощью метода enumerate, чтобы он выдавал значение
и индекс для этого значения, помещённые в кортеж. Первое выдаваемое значение —
это кортеж (0, 'a'). Когда это значение сопоставляется с шаблоном (index, value), index будет 0, а value будет 'a', печатая первую строку
вывода.
Параметры функций
Параметры функций также могут быть шаблонами. Код в листинге 19-6, который
объявляет функцию с именем foo, принимающую один параметр с именем x типа
i32, к настоящему времени должен выглядеть знакомым.
fn foo(x: i32) {
// здесь код
}
fn main() {}Часть x — это шаблон! Как мы делали с let, мы могли бы сопоставить кортеж в
аргументах функции с шаблоном. Листинг 19-7 разделяет значения в кортеже,
когда мы передаём его в функцию.
fn print_coordinates(&(x, y): &(i32, i32)) {
println!("Current location: ({x}, {y})");
}
fn main() {
let point = (3, 5);
print_coordinates(&point);
}Этот код печатает Current location: (3, 5). Значения &(3, 5) соответствуют
шаблону &(x, y), поэтому x — это значение 3, а y — значение 5.
Мы также можем использовать шаблоны в списках параметров замыканий так же, как в списках параметров функций, потому что замыкания похожи на функции, как обсуждалось в тринадцатой главе.
На этом этапе вы видели несколько способов использования шаблонов, но шаблоны не работают одинаково во всех местах, где мы можем их использовать. В некоторых местах шаблоны должны быть неопровержимыми; в других обстоятельствах они могут быть опровержимыми. Мы обсудим эти две концепции далее.
Опровержимость: может ли шаблон не совпасть
Опровержимость: может ли шаблон не совпасть
Шаблоны бывают двух форм: опровержимые и неопровержимые. Шаблоны, которые совпадут
для любого возможного переданного значения, неопровержимы. Примером может быть x в
операторе let x = 5;, потому что x совпадает с чем угодно и, следовательно, не может не
совпасть. Шаблоны, которые могут не совпасть для некоторого возможного значения,
опровержимы. Примером может быть Some(x) в выражении if let Some(x) = a_value, потому что если значение в переменной a_value равно None, а не
Some, шаблон Some(x) не совпадёт.
Параметры функций, операторы let и циклы for могут принимать только
неопровержимые шаблоны, потому что программа не может сделать ничего осмысленного, когда
значения не совпадают. Выражения if let и while let и
оператор let...else принимают опровержимые и неопровержимые шаблоны, но
компилятор предупреждает против неопровержимых шаблонов, потому что по определению они
предназначены для обработки возможной неудачи: функциональность условия заключается в
его способности действовать по-разному в зависимости от успеха или неудачи.
В целом, вам не нужно беспокоиться о различии между опровержимыми и неопровержимыми шаблонами; однако вам нужно быть знакомым с концепцией опровержимости, чтобы вы могли отреагировать, когда увидите её в сообщении об ошибке. В этих случаях вам нужно будет изменить либо шаблон, либо конструкцию, которую вы используете с шаблоном, в зависимости от предполагаемого поведения кода.
Давайте посмотрим на пример того, что происходит, когда мы пытаемся использовать опровержимый шаблон
там, где Rust требует неопровержимый шаблон, и наоборот. Листинг 19-8 показывает
оператор let, но для шаблона мы указали Some(x), опровержимый
шаблон. Как и следовало ожидать, этот код не скомпилируется.
fn main() {
let some_option_value: Option<i32> = None;
let Some(x) = some_option_value;
}letЕсли some_option_value было бы значением None, оно не совпало бы с шаблоном
Some(x), что означает, что шаблон опровержим. Однако оператор let может
принимать только неопровержимый шаблон, потому что нет ничего допустимого, что код может
сделать со значением None. Во время компиляции Rust пожалуется, что мы пытались
использовать опровержимый шаблон там, где требуется неопровержимый:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error[E0005]: refutable pattern in local binding
--> src/main.rs:3:9
|
3 | let Some(x) = some_option_value;
| ^^^^^^^ pattern `None` not covered
|
= note: `let` bindings require an "irrefutable pattern", like a `struct` or an `enum` with only one variant
= note: for more information, visit https://doc.rust-lang.org/book/ch19-02-refutability.html
= note: the matched value is of type `Option<i32>`
help: you might want to use `let...else` to handle the variant that isn't matched
|
3 | let Some(x) = some_option_value else { todo!() };
| ++++++++++++++++
For more information about this error, try `rustc --explain E0005`.
error: could not compile `patterns` (bin "patterns") due to 1 previous error
Поскольку мы не покрыли (и не могли покрыть!) каждое допустимое значение с помощью
шаблона Some(x), Rust справедливо выдаёт ошибку компилятора.
Если у нас есть опровержимый шаблон там, где нужен неопровержимый, мы можем
исправить это, изменив код, использующий шаблон: вместо использования let мы
можем использовать let...else. Тогда, если шаблон не совпадёт, код в фигурных
скобках обработает значение. Листинг 19-9 показывает, как исправить код в
листинге 19-8.
fn main() {
let some_option_value: Option<i32> = None;
let Some(x) = some_option_value else {
return;
};
}let...else и блока с опровержимыми шаблонами вместо letМы дали коду выход! Этот код совершенно корректен, хотя это означает, что мы
не можем использовать неопровержимый шаблон без получения предупреждения. Если мы дадим
let...else шаблон, который всегда совпадает, например x, как показано в листинге
19-10, компилятор выдаст предупреждение.
fn main() {
let x = 5 else {
return;
};
}let...elseRust жалуется, что не имеет смысла использовать let...else с
неопровержимым шаблоном, потому что else никогда не будет достигнут:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
warning: unreachable `else` clause
--> src/main.rs:2:15
|
2 | let x = 5 else {
| --------- ^^^^
| |
| assigning to binding pattern will always succeed
|
= note: this pattern always matches, so the else clause is unreachable
= note: `#[warn(irrefutable_let_patterns)]` on by default
warning: `patterns` (bin "patterns") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.39s
Running `target/debug/patterns`
По этой причине ветви match должны использовать опровержимые шаблоны, за
исключением последней ветви, которая должна совпадать с любыми оставшимися значениями с помощью неопровержимого шаблона. Rust
позволяет нам использовать неопровержимый шаблон в match только с одной ветвью, но
этот синтаксис не особенно полезен и мог бы быть заменён более простым
оператором let.
Теперь, когда вы знаете, где использовать шаблоны, и разницу между опровержимыми и неопровержимыми шаблонами, давайте рассмотрим весь синтаксис, который мы можем использовать для создания шаблонов.
Синтаксис шаблонов
Синтаксис шаблонов
В этом разделе мы соберём весь синтаксис, допустимый в шаблонах, и обсудим, почему и когда может понадобиться использовать каждый из них.
Сопоставление с литералами
Как вы видели в главе 6, шаблоны можно сопоставлять с литералами напрямую. Следующий код приводит несколько примеров:
fn main() {
let x = 1;
match x {
1 => println!("one"),
2 => println!("two"),
3 => println!("three"),
_ => println!("anything"),
}
}Этот код печатает one, потому что значение в x равно 1. Этот синтаксис полезен,
когда нужно, чтобы код выполнил действие при получении конкретного значения.
Сопоставление с именованными переменными
Именованные переменные — это неопровержимые шаблоны, которые соответствуют любому значению, и мы использовали
их много раз в этой книге. Однако есть complication при использовании
именованных переменных в выражениях match, if let или while let. Поскольку каждое
из этих видов выражений начинает новую область видимости, переменные, объявленные как часть
шаблона внутри этих выражений, затеняют те, что имеют то же имя за пределами
этих конструкций, как и все переменные. В листинге 19-11 мы объявляем
переменную с именем x со значением Some(5) и переменную y со значением
10. Затем мы создаём выражение match для значения x. Посмотрите на
шаблоны в ветвях match и println! в конце, и попробуйте понять,
что напечатает код, прежде чем запустить его или читать дальше.
fn main() {
let x = Some(5);
let y = 10;
match x {
Some(50) => println!("Got 50"),
Some(y) => println!("Matched, y = {y}"),
_ => println!("Default case, x = {x:?}"),
}
println!("at the end: x = {x:?}, y = {y}");
}match с ветвью, которая вводит новую переменную, затеняющую существующую переменную yДавайте пройдёмся по тому, что происходит при выполнении выражения match. Шаблон
в первой ветви match не соответствует определённому значению x, поэтому код
продолжается.
Шаблон во второй ветви match вводит новую переменную с именем y, которая
будет соответствовать любому значению внутри Some. Поскольку мы находимся в новой области видимости внутри
выражения match, это новая переменная y, а не y, которую мы объявили в
начале со значением 10. Эта новая привязка y будет соответствовать любому значению
внутри Some, которое у нас есть в x. Следовательно, эта новая y связывается с
внутренним значением Some в x. Это значение равно 5, поэтому выполняется выражение для
этой ветви и печатается Matched, y = 5.
Если бы x был значением None вместо Some(5), шаблоны в первых
двух ветвях не совпали бы, поэтому значение совпало бы с
подчёркиванием. Мы не ввели переменную x в шаблоне
ветви с подчёркиванием, поэтому x в выражении — это всё ещё внешний x, который не
был затенён. В этом гипотетическом случае match напечатал бы Default case, x = None.
Когда выражение match завершается, его область видимости заканчивается, как и область видимости
внутренней y. Последний println! выводит at the end: x = Some(5), y = 10.
Чтобы создать выражение match, которое сравнивает значения внешних x и
y, а не вводит новую переменную, затеняющую существующую переменную y,
нам нужно использовать условное условие match. Мы поговорим
об условиях match позже в разделе «Добавление условий с помощью условий
match».
Сопоставление с несколькими шаблонами
В выражениях match можно сопоставлять несколько шаблонов с помощью синтаксиса |,
который является оператором или для шаблонов. Например, в следующем коде мы сопоставляем
значение x с ветвями match, первая из которых имеет вариант или,
что означает, что если значение x совпадает с любым из значений в этой ветви, то
выполнится код этой ветви:
fn main() {
let x = 1;
match x {
1 | 2 => println!("one or two"),
3 => println!("three"),
_ => println!("anything"),
}
}Этот код печатает one or two.
Сопоставление с диапазонами значений с помощью ..=
Синтаксис ..= позволяет сопоставлять с включающим диапазоном значений. В
следующем коде, когда шаблон совпадает с любым из значений в заданном
диапазоне, выполнится эта ветвь:
fn main() {
let x = 5;
match x {
1..=5 => println!("one through five"),
_ => println!("something else"),
}
}Если x равен 1, 2, 3, 4 или 5, совпадёт первая ветвь. Этот синтаксис
удобнее для нескольких значений match, чем использование оператора | для
выражения той же идеи; если бы мы использовали |, нам пришлось бы указать 1 | 2 | 3 | 4 | 5. Указание диапазона намного короче, особенно если мы хотим сопоставить,
скажем, любое число от 1 до 1000!
Компилятор проверяет, что диапазон не пуст, во время компиляции, и поскольку
единственные типы, для которых Rust может определить, пуст ли диапазон, — это char и
числовые значения, диапазоны допускаются только с числовыми значениями или значениями char.
Вот пример с использованием диапазонов значений char:
fn main() {
let x = 'c';
match x {
'a'..='j' => println!("early ASCII letter"),
'k'..='z' => println!("late ASCII letter"),
_ => println!("something else"),
}
}Rust может определить, что 'c' находится в диапазоне первого шаблона, и печатает early ASCII letter.
Деструктуризация для разделения значений
Мы также можем использовать шаблоны для деструктуризации структур, перечислений и кортежей, чтобы использовать разные части этих значений. Давайте пройдёмся по каждому значению.
Структуры
Листинг 19-12 показывает структуру Point с двумя полями, x и y, которую мы можем
разобрать с помощью шаблона в инструкции let.
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
let Point { x: a, y: b } = p;
assert_eq!(0, a);
assert_eq!(7, b);
}Этот код создаёт переменные a и b, которые соответствуют значениям полей x
и y структуры p. Этот пример показывает, что имена переменных
в шаблоне не обязательно должны совпадать с именами полей структуры.
Однако обычно имена переменных совпадают с именами полей, чтобы было
легче запомнить, какие переменные пришли из каких полей. Из-за этого
обычного использования и потому, что запись let Point { x: x, y: y } = p; содержит
много дублирования, в Rust есть сокращённая запись для шаблонов, соответствующих полям структуры:
достаточно перечислить имя поля структуры, и созданные из шаблона переменные
будут иметь те же имена. Листинг 19-13 ведёт себя так же, как код в листинге 19-12, но переменные, созданные в
шаблоне let, — это x и y вместо a и b.
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
let Point { x, y } = p;
assert_eq!(0, x);
assert_eq!(7, y);
}Этот код создаёт переменные x и y, которые соответствуют полям x и y
переменной p. В результате переменные x и y содержат значения
из структуры p.
Мы также можем деструктурировать с литеральными значениями как часть шаблона структуры, а не создавать переменные для всех полей. Это позволяет нам проверить некоторые поля на конкретные значения, создав при этом переменные для деструктуризации остальных полей.
В листинге 19-14 у нас есть выражение match, которое разделяет значения Point
на три случая: точки, которые лежат непосредственно на оси x (что верно, когда
y = 0), на оси y (x = 0) или ни на одной из осей.
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
match p {
Point { x, y: 0 } => println!("On the x axis at {x}"),
Point { x: 0, y } => println!("On the y axis at {y}"),
Point { x, y } => {
println!("On neither axis: ({x}, {y})");
}
}
}Первая ветвь совпадёт с любой точкой, лежащей на оси x, указав, что
поле y совпадает, если его значение совпадает с литералом 0. Шаблон по-прежнему
создаёт переменную x, которую мы можем использовать в коде для этой ветви.
Аналогично, вторая ветвь совпадает с любой точкой на оси y, указав, что
поле x совпадает, если его значение равно 0, и создаёт переменную y для
значения поля y. Третья ветвь не указывает никаких литералов, поэтому она
совпадает с любой другой Point и создаёт переменные для обоих полей x и y.
В этом примере значение p совпадает со второй ветвью благодаря тому, что x
содержит 0, поэтому этот код напечатает On the y axis at 7.
Помните, что выражение match прекращает проверку ветвей, как только находит
первый совпадающий шаблон, поэтому даже несмотря на то, что Point { x: 0, y: 0 } находится на оси x
и на оси y, этот код напечатал бы только On the x axis at 0.
Перечисления
Мы деструктурировали перечисления в этой книге (например, листинг 6-5 в главе 6),
но пока явно не обсуждали, что шаблон для деструктуризации перечисления
соответствует способу определения данных, хранящихся внутри перечисления. В качестве
примера, в листинге 19-15 мы используем перечисление Message из листинга 6-2 и пишем
match с шаблонами, которые деструктурируют каждое внутреннее значение.
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {
let msg = Message::ChangeColor(0, 160, 255);
match msg {
Message::Quit => {
println!("The Quit variant has no data to destructure.");
}
Message::Move { x, y } => {
println!("Move in the x direction {x} and in the y direction {y}");
}
Message::Write(text) => {
println!("Text message: {text}");
}
Message::ChangeColor(r, g, b) => {
println!("Change color to red {r}, green {g}, and blue {b}");
}
}
}Этот код напечатает Change color to red 0, green 160, and blue 255. Попробуйте
изменить значение msg, чтобы увидеть код из других ветвей в действии.
Для вариантов перечисления без каких-либо данных, таких как Message::Quit, мы не можем деструктурировать
значение дальше. Мы можем сопоставлять только с литеральным значением Message::Quit,
и в этом шаблоне нет переменных.
Для вариантов перечисления, похожих на структуры, таких как Message::Move, мы можем использовать шаблон,
аналогичный шаблону, который мы указываем для сопоставления со структурами. После имени варианта мы
ставим фигурные скобки и затем перечисляем поля с переменными, чтобы разобрать
части для использования в коде этой ветви. Здесь мы используем сокращённую
форму, как в листинге 19-13.
Для вариантов перечисления, похожих на кортежи, таких как Message::Write, который содержит кортеж с одним
элементом, и Message::ChangeColor, который содержит кортеж с тремя элементами,
шаблон аналогичен шаблону, который мы указываем для сопоставления с кортежами. Количество
переменных в шаблоне должно совпадать с количеством элементов в варианте, с которым мы
сопоставляем.
Вложенные структуры и перечисления
До сих пор все наши примеры сопоставляли структуры или перечисления на один уровень вглубь,
но сопоставление может работать и с вложенными элементами! Например, мы можем переработать
код в листинге 19-15, чтобы поддерживать цвета RGB и HSV в сообщении ChangeColor,
как показано в листинге 19-16.
enum Color {
Rgb(i32, i32, i32),
Hsv(i32, i32, i32),
}
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(Color),
}
fn main() {
let msg = Message::ChangeColor(Color::Hsv(0, 160, 255));
match msg {
Message::ChangeColor(Color::Rgb(r, g, b)) => {
println!("Change color to red {r}, green {g}, and blue {b}");
}
Message::ChangeColor(Color::Hsv(h, s, v)) => {
println!("Change color to hue {h}, saturation {s}, value {v}");
}
_ => (),
}
}Шаблон первой ветви в выражении match соответствует варианту перечисления
Message::ChangeColor, который содержит вариант Color::Rgb; затем
шаблон связывается с тремя внутренними значениями i32. Шаблон второй
ветви также соответствует варианту перечисления Message::ChangeColor, но внутреннее перечисление
вместо этого совпадает с Color::Hsv. Мы можем указать эти сложные условия в одном
выражении match, даже если задействованы два перечисления.
Структуры и кортежи
Мы можем смешивать, комбинировать и вкладывать шаблоны деструктуризации ещё более сложными способами. Следующий пример показывает сложную деструктуризацию, где мы вкладываем структуры и кортежи внутрь кортежа и деструктурируем все примитивные значения:
fn main() {
struct Point {
x: i32,
y: i32,
}
let ((feet, inches), Point { x, y }) = ((3, 10), Point { x: 3, y: -10 });
}Этот код позволяет разбить сложные типы на их составные части, чтобы мы могли использовать интересующие нас значения отдельно.
Деструктуризация с помощью шаблонов — удобный способ использовать части значений, такие как значение из каждого поля структуры, отдельно друг от друга.
Игнорирование значений в шаблоне
Вы видели, что иногда полезно игнорировать значения в шаблоне, например
в последней ветви match, чтобы получить catch-all, который на самом деле ничего не
делает, но учитывает все оставшиеся возможные значения. Есть несколько
способов игнорировать целые значения или части значений в шаблоне: используя шаблон _
(который вы уже видели), используя шаблон _ внутри другого шаблона,
используя имя, начинающееся с подчёркивания, или используя .. для игнорирования оставшихся
частей значения. Давайте рассмотрим, как и зачем использовать каждый из этих шаблонов.
Целое значение с помощью _
Мы использовали подчёркивание как шаблон-подстановку, который будет соответствовать любому значению, но
не связывается со значением. Это особенно полезно в качестве последней ветви в match
выражении, но мы также можем использовать его в любом шаблоне, включая параметры
функции, как показано в листинге 19-17.
fn foo(_: i32, y: i32) {
println!("This code only uses the y parameter: {y}");
}
fn main() {
foo(3, 4);
}_ в сигнатуре функцииЭтот код полностью проигнорирует значение 3, переданное в качестве первого аргумента,
и напечатает This code only uses the y parameter: 4.
В большинстве случаев, когда больше не нужен определённый параметр функции, сигнатуру меняют так, чтобы она не включала неиспользуемый параметр. Игнорирование параметра функции может быть особенно полезно в случаях, когда, например, реализуется трейт, где нужна определённая сигнатура типа, но тело функции в реализации не нуждается в одном из параметров. Тогда удаётся избежать предупреждения компилятора о неиспользуемых параметрах функции, которое появилось бы, если бы использовалось имя.
Части значения с помощью вложенного _
Мы также можем использовать _ внутри другого шаблона, чтобы игнорировать только часть значения,
например, когда мы хотим проверить только часть значения, но не использовать
другие части в соответствующем коде, который хотим выполнить. Листинг 19-18 показывает код,
отвечающий за управление значением настройки. Бизнес-требования таковы, что
пользователю не должно быть разрешено перезаписывать существующую настройку,
но он может сбросить настройку и присвоить ей значение, если она в настоящее время не установлена.
fn main() {
let mut setting_value = Some(5);
let new_setting_value = Some(10);
match (setting_value, new_setting_value) {
(Some(_), Some(_)) => {
println!("Can't overwrite an existing customized value");
}
_ => {
setting_value = new_setting_value;
}
}
println!("setting is {setting_value:?}");
}Some, когда нам не нужно использовать значение внутри SomeЭтот код напечатает Can't overwrite an existing customized value, а затем
setting is Some(5). В первой ветви match нам не нужно сопоставлять или использовать
значения внутри любого из вариантов Some, но нам нужно проверить случай,
когда setting_value и new_setting_value являются вариантом Some. В этом
случае мы печатаем причину, по которой не изменяем setting_value, и оно не
изменяется.
Во всех остальных случаях (если либо setting_value, либо new_setting_value равно None)
выраженных шаблоном _ во второй ветви, мы хотим позволить
new_setting_value стать setting_value.
Мы также можем использовать подчёркивания в нескольких местах внутри одного шаблона, чтобы игнорировать конкретные значения. Листинг 19-19 показывает пример игнорирования второго и четвёртого значений в кортеже из пяти элементов.
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(first, _, third, _, fifth) => {
println!("Some numbers: {first}, {third}, {fifth}");
}
}
}Этот код напечатает Some numbers: 2, 8, 32, а значения 4 и 16 будут
проигнорированы.
Неиспользуемая переменная с именем, начинающимся с _
Если создать переменную, но нигде её не использовать, Rust обычно выдаёт предупреждение, потому что неиспользуемая переменная может быть ошибкой. Однако иногда полезно иметь возможность создать переменную, которую пока не будете использовать, например, при прототипировании или только начиная проект. В этой ситуации можно сказать Rust не предупреждать о неиспользуемой переменной, начав имя переменной с подчёркивания. В листинге 19-20 мы создаём две неиспользуемые переменные, но при компиляции этого кода мы должны получить предупреждение только об одной из них.
fn main() {
let _x = 5;
let y = 10;
}Здесь мы получаем предупреждение о неиспользовании переменной y, но не получаем
предупреждения о неиспользовании _x.
Обратите внимание, что есть тонкая разница между использованием только _ и использованием имени,
начинающегося с подчёркивания. Синтаксис _x всё равно связывает значение с
переменной, тогда как _ вообще не связывает. Чтобы показать случай, где это
различие важно, листинг 19-21 даст нам ошибку.
fn main() {
let s = Some(String::from("Hello!"));
if let Some(_s) = s {
println!("found a string");
}
println!("{s:?}");
}Мы получим ошибку, потому что значение s всё равно будет перемещено в _s,
что не позволяет нам снова использовать s. Однако использование подчёркивания самого по себе
никогда не связывается со значением. Листинг 19-22 скомпилируется без ошибок,
потому что s не перемещается в _.
fn main() {
let s = Some(String::from("Hello!"));
if let Some(_) = s {
println!("found a string");
}
println!("{s:?}");
}Этот код работает нормально, потому что мы никогда не связываем s с чем-либо; он не перемещается.
Оставшиеся части значения с помощью ..
Для значений, которые имеют много частей, мы можем использовать синтаксис .., чтобы использовать конкретные
части и игнорировать остальные, избегая необходимости перечислять подчёркивания для каждого
игнорируемого значения. Шаблон .. игнорирует любые части значения, которые мы не
явно сопоставили в остальной части шаблона. В листинге 19-23 у нас есть
структура Point, содержащая координату в трёхмерном пространстве. В
выражении match мы хотим работать только с координатой x и игнорировать
значения в полях y и z.
fn main() {
struct Point {
x: i32,
y: i32,
z: i32,
}
let origin = Point { x: 0, y: 0, z: 0 };
match origin {
Point { x, .. } => println!("x is {x}"),
}
}Point, кроме x, с помощью ..Мы перечисляем значение x, а затем просто включаем шаблон ... Это быстрее,
чем перечислять y: _ и z: _, особенно когда мы работаем со
структурами, у которых много полей в ситуациях, где актуальны только одно или два поля.
Синтаксис .. раскроется в столько значений, сколько ему нужно. Листинг 19-24
показывает, как использовать .. с кортежем.
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(first, .., last) => {
println!("Some numbers: {first}, {last}");
}
}
}В этом коде первое и последнее значения сопоставляются с first и last.
.. будет соответствовать и игнорировать всё в середине.
Однако использование .. должно быть однозначным. Если неясно, какие значения
предназначены для сопоставления, а какие следует игнорировать, Rust выдаст ошибку.
Листинг 19-25 показывает пример неоднозначного использования .., поэтому он не будет
компилироваться.
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(.., second, ..) => {
println!("Some numbers: {second}")
},
}
}.. неоднозначным способомКогда мы компилируем этот пример, мы получаем эту ошибку:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error: `..` can only be used once per tuple pattern
--> src/main.rs:5:22
|
5 | (.., second, ..) => {
| -- ^^ can only be used once per tuple pattern
| |
| previously used here
error: could not compile `patterns` (bin "patterns") due to 1 previous error
Невозможно определить для Rust, сколько значений в кортеже игнорировать
перед сопоставлением значения с second, а затем сколько ещё значений
игнорировать после этого. Этот код мог бы означать, что мы хотим игнорировать 2, связать
second с 4, а затем игнорировать 8, 16 и 32; или что мы хотим игнорировать
2 и 4, связать second с 8, а затем игнорировать 16 и 32; и так далее.
Имя переменной second ничего особенного не значит для Rust, поэтому мы получаем
ошибку компилятора, потому что использование .. в двух местах таким образом неоднозначно.
Добавление условий с помощью условий match
Условие match — это дополнительное условие if, указанное после шаблона в
ветви match, которое также должно совпасть, чтобы эта ветвь была выбрана. Условия match
полезны для выражения более сложных идей, чем позволяет один шаблон. Обратите внимание,
однако, что они доступны только в выражениях match, а не в if let или
while let.
Условие может использовать переменные, созданные в шаблоне. Листинг 19-26 показывает
match, где первая ветвь имеет шаблон Some(x) и также имеет условие
match if x % 2 == 0 (которое будет true, если число чётное).
fn main() {
let num = Some(4);
match num {
Some(x) if x % 2 == 0 => println!("The number {x} is even"),
Some(x) => println!("The number {x} is odd"),
None => (),
}
}Этот пример напечатает The number 4 is even. Когда num сравнивается с
шаблоном в первой ветви, он совпадает, потому что Some(4) совпадает с Some(x). Затем
условие match проверяет, равен ли остаток от деления x на 2
0, и поскольку это так, выбирается первая ветвь.
Если бы num был Some(5), условие match в первой ветви было бы
false, потому что остаток от деления 5 на 2 равен 1, что не
равно 0. Затем Rust перешёл бы ко второй ветви, которая совпала бы, потому что
вторая ветвь не имеет условия match и поэтому совпадает с любым вариантом Some.
Нет способа выразить условие if x % 2 == 0 внутри шаблона, поэтому
условие match даёт нам возможность выразить эту логику. Обратной стороной
этой дополнительной выразительности является то, что компилятор не пытается проверить
исчерпывающность, когда задействованы выражения условий match.
При обсуждении листинга 19-11 мы упоминали, что могли бы использовать условия match, чтобы
решить нашу проблему затенения шаблона. Напомним, что мы создали новую переменную
внутри шаблона в выражении match вместо использования переменной
вне match. Эта новая переменная означала, что мы не могли проверить значение
внешней переменной. Листинг 19-27 показывает, как можно использовать условие match, чтобы исправить
эту проблему.
fn main() {
let x = Some(5);
let y = 10;
match x {
Some(50) => println!("Got 50"),
Some(n) if n == y => println!("Matched, n = {n}"),
_ => println!("Default case, x = {x:?}"),
}
println!("at the end: x = {x:?}, y = {y}");
}Этот код теперь напечатает Default case, x = Some(5). Шаблон во второй
ветви match не вводит новую переменную y, которая затенила бы внешнюю y,
что означает, что мы можем использовать внешнюю y в условии match. Вместо указания
шаблона как Some(y), который затенил бы внешнюю y, мы указываем
Some(n). Это создаёт новую переменную n, которая ничего не затеняет, потому что
вне match нет переменной n.
Условие match if n == y не является шаблоном и поэтому не вводит новые
переменные. Эта y является внешней y, а не новой y, которая её затеняет, и
мы можем искать значение, имеющее то же значение, что и внешняя y, сравнивая
n с y.
Вы также можете использовать оператор или | в условии match, чтобы указать несколько
шаблонов; условие match будет применяться ко всем шаблонам. Листинг
19-28 показывает приоритет при объединении шаблона, использующего |, с условием
match. Важная часть этого примера в том, что условие match if y
применяется к 4, 5, и 6, хотя может показаться, что if y применяется только
к 6.
fn main() {
let x = 4;
let y = false;
match x {
4 | 5 | 6 if y => println!("yes"),
_ => println!("no"),
}
}Условие match гласит, что ветвь совпадает только если значение x
равно 4, 5 или 6 и если y равно true. При выполнении этого кода
шаблон первой ветви совпадает, потому что x равно 4, но условие match if y
равно false, поэтому первая ветвь не выбирается. Код переходит ко второй
ветви, которая совпадает, и эта программа печатает no. Причина в том, что
условие if применяется ко всему шаблону 4 | 5 | 6, а не только к последнему
значению 6. Другими словами, приоритет условия match по отношению к
шаблону ведёт себя так:
(4 | 5 | 6) if y => ...
а не так:
4 | 5 | (6 if y) => ...
После запуска кода поведение приоритета становится очевидным: если бы условие match
применялось только к последнему значению в списке значений, указанных с помощью
оператора |, ветвь совпала бы, и программа напечатала бы
yes.
Использование привязок @
Оператор at @ позволяет создать переменную, которая содержит значение в то же
время, когда мы проверяем это значение на соответствие шаблону. В листинге 19-29 мы хотим
проверить, что поле id сообщения Message::Hello находится в диапазоне 3..=7. Мы также
хотим связать значение с переменной id, чтобы использовать её в коде,
связанном с этой ветвью.
fn main() {
enum Message {
Hello { id: i32 },
}
let msg = Message::Hello { id: 5 };
match msg {
Message::Hello { id: id @ 3..=7 } => {
println!("Found an id in range: {id}")
}
Message::Hello { id: 10..=12 } => {
println!("Found an id in another range")
}
Message::Hello { id } => println!("Found some other id: {id}"),
}
}@ для привязки к значению в шаблоне и его проверкиЭтот пример напечатает Found an id in range: 5. Указав id @ перед
диапазоном 3..=7, мы захватываем значение, совпавшее с диапазоном, в
переменную с именем id, одновременно проверяя, что значение соответствует шаблону диапазона.
Во второй ветви, где в шаблоне указан только диапазон, код,
связанный с ветвью, не имеет переменной, содержащей фактическое значение
поля id. Значение поля id могло быть 10, 11 или 12, но
код, связанный с этим шаблоном, не знает, какое именно. Код шаблона
не может использовать значение из поля id, потому что мы не сохранили
значение id в переменной.
В последней ветви, где мы указали переменную без диапазона, у нас
есть значение, доступное для использования в коде ветви в переменной с именем id. Причина
в том, что мы использовали сокращённую запись полей структуры. Но мы не применили
никакой проверки к значению в поле id в этой ветви, как мы это делали с
первыми двумя ветвями: любое значение совпало бы с этим шаблоном.
Использование @ позволяет проверить значение и сохранить его в переменной в одном шаблоне.
Итоги
Шаблоны Rust очень полезны для различения разных видов
данных. При использовании в выражениях match Rust гарантирует, что ваши шаблоны покрывают
все возможные значения, иначе программа не скомпилируется. Шаблоны в инструкциях
let и параметрах функций делают эти конструкции более полезными, позволяя
деструктурировать значения на более мелкие части и присваивать эти части
переменным. Мы можем создавать простые или сложные шаблоны в соответствии с нашими потребностями.
Далее, в предпоследней главе книги, мы рассмотрим некоторые продвинутые аспекты различных возможностей Rust.
Продвинутые возможности
Продвинутые возможности
К настоящему моменту вы изучили наиболее часто используемые части языка программирования Rust. Прежде чем мы сделаем ещё один проект в главе 21, мы рассмотрим несколько аспектов языка, с которыми вы можете время от времени сталкиваться, но, возможно, не использовать каждый день. Вы можете использовать эту главу как справочник, когда столкнётесь с чем-то незнакомым. Возможности, рассматриваемые здесь, полезны в очень специфических ситуациях. Хотя вы можете не прибегать к ним часто, мы хотим убедиться, что вы понимаете все возможности, которые предлагает Rust.
В этой главе мы рассмотрим:
- Небезопасный Rust: как отказаться от некоторых гарантий Rust и взять на себя ответственность за ручное поддержание этих гарантий
- Продвинутые трейты: ассоциированные типы, параметры типа по умолчанию, полный синтаксис, супертрейты и паттерн newtype в отношении трейтов
- Продвинутые типы: подробнее о паттерне newtype, псевдонимах типов, типе never и динамически размещаемых типах
- Продвинутые функции и замыкания: указатели на функции и возврат замыканий
- Макросы: способы определять код, который определяет ещё больше кода во время компиляции
Это целая панорама возможностей Rust, в которой каждый найдёт что-то для себя! Давайте погрузимся!
Небезопасный Rust
Небезопасный Rust
Весь код, который мы обсуждали до сих пор, имел гарантии безопасности памяти Rust, проверяемые во время компиляции. Однако в Rust есть второй скрытый внутри него язык, который не обеспечивает эти гарантии безопасности памяти: он называется небезопасным Rust и работает так же, как обычный Rust, но даёт нам дополнительные сверхспособности.
Небезопасный Rust существует потому, что по своей природе статический анализ консервативен. Когда компилятор пытается определить, поддерживает ли код гарантии, лучше, чтобы он отклонил некоторые допустимые программы, чем принял некоторые недопустимые. Хотя код может быть в порядке, если у компилятора Rust недостаточно информации, чтобы быть уверенным, он отклонит код. В таких случаях вы можете использовать небезопасный код, чтобы сказать компилятору: «Доверься мне, я знаю, что делаю». Однако будьте предупреждены: вы используете небезопасный Rust на свой страх и риск: если вы неправильно используете небезопасный код, могут возникнуть проблемы из-за небезопасности памяти, такие как разыменование нулевого указателя.
Другая причина, по которой у Rust есть небезопасное альтер эго, заключается в том, что лежащее в основе компьютерное оборудование по своей сути небезопасно. Если бы Rust не позволял выполнять небезопасные операции, вы не смогли бы выполнять определённые задачи. Rust должен позволять вам заниматься низкоуровневым системным программированием, например, напрямую взаимодействовать с операционной системой или даже писать собственную операционную систему. Работа с низкоуровневым системным программированием — одна из целей языка. Давайте исследуем, что мы можем делать с небезопасным Rust и как это делать.
Выполнение небезопасных сверхспособностей
Чтобы переключиться на небезопасный Rust, используйте ключевое слово unsafe, а затем начните новый блок, который содержит небезопасный код. В небезопасном Rust вы можете выполнять пять действий, которые не можете в безопасном Rust, и мы называем их небезопасными сверхспособностями. Эти сверхспособности включают возможность:
- Разыменовывать сырой указатель.
- Вызывать небезопасную функцию или метод.
- Получать доступ к изменяемой статической переменной или изменять её.
- Реализовывать небезопасный трейт.
- Получать доступ к полям
union.
Важно понимать, что unsafe не отключает проверку заимствований и не отключает какие-либо другие проверки безопасности Rust: если вы используете ссылку в небезопасном коде, она всё равно будет проверена. Ключевое слово unsafe только даёт вам доступ к этим пяти возможностям, которые затем не проверяются компилятором на безопасность памяти. Внутри небезопасного блока вы всё равно получите некоторую степень безопасности.
Кроме того, unsafe не означает, что код внутри блока обязательно опасен или что у него точно будут проблемы с безопасностью памяти: смысл в том, что как программист вы обеспечите, чтобы код внутри блока unsafe обращался к памяти допустимым образом.
Люди подвержены ошибкам, и ошибки будут происходить, но, требуя, чтобы эти пять небезопасных операций находились внутри блоков, помеченных unsafe, вы будете знать, что любые ошибки, связанные с безопасностью памяти, должны находиться внутри блока unsafe. Держите блоки unsafe маленькими; вы будете благодарны позже, когда будете исследовать ошибки памяти.
Чтобы максимально изолировать небезопасный код, лучше всего заключить такой код в безопасную абстракцию и предоставить безопасный API, который мы обсудим позже в этой главе, когда будем рассматривать небезопасные функции и методы. Части стандартной библиотеки реализованы как безопасные абстракции над проверенным небезопасным кодом. Обёртывание небезопасного кода в безопасную абстракцию предотвращает утечку использования unsafe во все места, где вы или ваши пользователи можете захотеть использовать функциональность, реализованную с помощью небезопасного кода, потому что использование безопасной абстракции безопасно.
Давайте рассмотрим каждую из пяти небезопасных сверхспособностей по очереди. Мы также рассмотрим некоторые абстракции, которые обеспечивают безопасный интерфейс к небезопасному коду.
Разыменование сырого указателя
В главе 4, в разделе «Висячие ссылки», мы упоминали, что компилятор гарантирует, что ссылки всегда действительны. В небезопасном Rust есть два новых типа, называемых сырыми указателями, которые похожи на ссылки. Как и ссылки, сырые указатели могут быть неизменяемыми или изменяемыми и записываются как *const T и *mut T соответственно. Звёздочка — это не оператор разыменования; это часть имени типа. В контексте сырых указателей неизменяемый означает, что указателю нельзя напрямую присвоить значение после разыменования.
В отличие от ссылок и умных указателей, сырые указатели:
- Могут игнорировать правила заимствования, имея одновременно неизменяемые и изменяемые указатели или несколько изменяемых указателей на одно и то же место.
- Не гарантируют, что указывают на действительную память.
- Могут быть нулевыми.
- Не реализуют автоматическую очистку.
Отказавшись от того, чтобы Rust обеспечивал эти гарантии, вы можете отказаться от гарантированной безопасности в обмен на большую производительность или возможность взаимодействия с другим языком или оборудованием, где гарантии Rust не применяются.
Листинг 20-1 показывает, как создать неизменяемый и изменяемый сырые указатели.
fn main() {
let mut num = 5;
let r1 = &raw const num;
let r2 = &raw mut num;
}Обратите внимание, что мы не включаем ключевое слово unsafe в этот код. Мы можем создавать сырые указатели в безопасном коде; мы просто не можем разыменовывать сырые указатели вне небезопасного блока, как вы увидите чуть позже.
Мы создали сырые указатели с помощью операторов сырого заимствования: &raw const num создаёт неизменяемый сырой указатель *const i32, а &raw mut num создаёт изменяемый сырой указатель *mut i32. Поскольку мы создали их непосредственно из локальной переменной, мы знаем, что эти конкретные сырые указатели действительны, но мы не можем сделать такое предположение о любом сыром указателе.
Чтобы продемонстрировать это, далее мы создадим сырой указатель, в действительности которого мы не можем быть так уверены, используя ключевое слово as для приведения значения вместо использования оператора сырого заимствования. Листинг 20-2 показывает, как создать сырой указатель на произвольное место в памяти. Попытка использовать произвольную память не определена: по этому адресу могут быть данные, а могут и не быть, компилятор может оптимизировать код так, что обращения к памяти не будет, или программа может завершиться с ошибкой сегментации. Обычно нет веской причины писать такой код, особенно в случаях, когда вы можете использовать оператор сырого заимствования, но это возможно.
fn main() {
let address = 0x012345usize;
let r = address as *const i32;
}Вспомните, что мы можем создавать сырые указатели в безопасном коде, но мы не можем разыменовывать сырые указатели и читать данные, на которые они указывают. В листинге 20-3 мы используем оператор разыменования * с сырым указателем, что требует блока unsafe.
fn main() {
let mut num = 5;
let r1 = &raw const num;
let r2 = &raw mut num;
unsafe {
println!("r1 is: {}", *r1);
println!("r2 is: {}", *r2);
}
}unsafeСоздание указателя не причиняет вреда; только когда мы пытаемся получить доступ к значению, на которое он указывает, мы можем столкнуться с недопустимым значением.
Обратите также внимание, что в листингах 20-1 и 20-3 мы создали сырые указатели *const i32 и *mut i32, которые оба указывали на одно и то же место в памяти, где хранится num. Если бы вместо этого мы попытались создать неизменяемую и изменяемую ссылки на num, код не скомпилировался бы, потому что правила владения Rust не допускают изменяемую ссылку одновременно с любыми неизменяемыми ссылками. С сырыми указателями мы можем создать изменяемый указатель и неизменяемый указатель на одно и то же место и изменять данные через изменяемый указатель, потенциально создавая гонку данных. Будьте осторожны!
Со всеми этими опасностями, почему вы когда-либо стали бы использовать сырые указатели? Один из основных случаев использования — при взаимодействии с кодом на C, как вы увидите в следующем разделе. Другой случай — при построении безопасных абстракций, которые не понимает проверка заимствований. Мы представим небезопасные функции, а затем рассмотрим пример безопасной абстракции, которая использует небезопасный код.
Вызов небезопасной функции или метода
Второй тип операции, которую вы можете выполнять в небезопасном блоке, — вызов небезопасных функций. Небезопасные функции и методы выглядят точно так же, как обычные функции и методы, но у них есть дополнительное unsafe перед остальной частью определения. Ключевое слово unsafe в этом контексте указывает, что функция имеет требования, которые мы должны выполнить, когда вызываем эту функцию, потому что Rust не может гарантировать, что мы выполнили эти требования. Вызывая небезопасную функцию внутри блока unsafe, мы говорим, что прочитали документацию этой функции и берём на себя ответственность за выполнение контрактов функции.
Вот небезопасная функция с именем dangerous, которая ничего не делает в своём теле:
fn main() {
unsafe fn dangerous() {}
unsafe {
dangerous();
}
}Мы должны вызвать функцию dangerous внутри отдельного блока unsafe. Если мы попытаемся вызвать dangerous без блока unsafe, мы получим ошибку:
$ cargo run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
error[E0133]: call to unsafe function `dangerous` is unsafe and requires unsafe block
--> src/main.rs:4:5
|
4 | dangerous();
| ^^^^^^^^^^^ call to unsafe function
|
= note: consult the function's documentation for information on how to avoid undefined behavior
For more information about this error, try `rustc --explain E0133`.
error: could not compile `unsafe-example` (bin "unsafe-example") due to 1 previous error
С блоком unsafe мы заверяем Rust, что прочитали документацию функции, понимаем, как её правильно использовать, и проверили, что выполняем контракт функции.
Чтобы выполнять небезопасные операции в теле unsafe функции, вам всё равно нужно использовать блок unsafe, как и внутри обычной функции, и компилятор предупредит вас, если вы забудете. Это помогает нам держать блоки unsafe как можно меньше, так как небезопасные операции могут быть не нужны на протяжении всего тела функции.
Создание безопасной абстракции над небезопасным кодом
То, что функция содержит небезопасный код, не означает, что нам нужно помечать всю функцию как небезопасную. На самом деле, обёртывание небезопасного кода в безопасную функцию — это распространённая абстракция. В качестве примера давайте изучим функцию split_at_mut из стандартной библиотеки, которая требует некоторого небезопасного кода. Мы исследуем, как мы могли бы её реализовать. Этот безопасный метод определён для изменяемых срезов: он принимает один срез и делает из него два, разделяя срез по индексу, данному в качестве аргумента. Листинг 20-4 показывает, как использовать split_at_mut.
fn main() {
let mut v = vec![1, 2, 3, 4, 5, 6];
let r = &mut v[..];
let (a, b) = r.split_at_mut(3);
assert_eq!(a, &mut [1, 2, 3]);
assert_eq!(b, &mut [4, 5, 6]);
}split_at_mutМы не можем реализовать эту функцию, используя только безопасный Rust. Попытка может выглядеть примерно как в листинге 20-5, который не скомпилируется. Для простоты мы реализуем split_at_mut как функцию, а не как метод, и только для срезов значений i32, а не для обобщённого типа T.
fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
let len = values.len();
assert!(mid <= len);
(&mut values[..mid], &mut values[mid..])
}
fn main() {
let mut vector = vec![1, 2, 3, 4, 5, 6];
let (left, right) = split_at_mut(&mut vector, 3);
}split_at_mut с использованием только безопасного RustЭта функция сначала получает общую длину среза. Затем она утверждает, что индекс, заданный в качестве параметра, находится в пределах среза, проверяя, что он меньше или равен длине. Утверждение означает, что если мы передадим индекс, который больше длины, для разделения среза, функция запаникует до того, как попытается использовать этот индекс.
Затем мы возвращаем два изменяемых среза в кортеже: один от начала исходного среза до индекса mid, а другой от mid до конца среза.
Когда мы пытаемся скомпилировать код в листинге 20-5, мы получаем ошибку:
$ cargo run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
error[E0499]: cannot borrow `*values` as mutable more than once at a time
--> src/main.rs:6:31
|
1 | fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
| - let's call the lifetime of this reference `'1`
...
6 | (&mut values[..mid], &mut values[mid..])
| --------------------------^^^^^^--------
| | | |
| | | second mutable borrow occurs here
| | first mutable borrow occurs here
| returning this value requires that `*values` is borrowed for `'1`
|
= help: use `.split_at_mut(position)` to obtain two mutable non-overlapping sub-slices
For more information about this error, try `rustc --explain E0499`.
error: could not compile `unsafe-example` (bin "unsafe-example") due to 1 previous error
Проверка заимствований Rust не может понять, что мы заимствуем разные части среза; она знает только, что мы заимствуем из одного среза дважды. Заимствование разных частей среза принципиально допустимо, потому что два среза не перекрываются, но Rust недостаточно умён, чтобы это знать. Когда мы знаем, что код в порядке, а Rust — нет, настало время обратиться к небезопасному коду.
Листинг 20-6 показывает, как использовать блок unsafe, сырой указатель и некоторые вызовы небезопасных функций, чтобы реализация split_at_mut работала.
use std::slice;
fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
let len = values.len();
let ptr = values.as_mut_ptr();
assert!(mid <= len);
unsafe {
(
slice::from_raw_parts_mut(ptr, mid),
slice::from_raw_parts_mut(ptr.add(mid), len - mid),
)
}
}
fn main() {
let mut vector = vec![1, 2, 3, 4, 5, 6];
let (left, right) = split_at_mut(&mut vector, 3);
}split_at_mutВспомните из раздела «Тип срез» главы 4, что срез — это указатель на некоторые данные и длина среза. Мы используем метод len, чтобы получить длину среза, и метод as_mut_ptr, чтобы получить доступ к сырому указателю среза. В этом случае, поскольку у нас есть изменяемый срез значений i32, as_mut_ptr возвращает сырой указатель с типом *mut i32, который мы сохранили в переменной ptr.
Мы сохраняем утверждение, что индекс mid находится в пределах среза. Затем мы переходим к небезопасному коду: функция slice::from_raw_parts_mut принимает сырой указатель и длину и создаёт срез. Мы используем эту функцию, чтобы создать срез, который начинается с ptr и имеет длину mid элементов. Затем мы вызываем метод add для ptr с mid в качестве аргумента, чтобы получить сырой указатель, который начинается с mid, и мы создаём срез, используя этот указатель и оставшееся количество элементов после mid в качестве длины.
Функция slice::from_raw_parts_mut небезопасна, потому что она принимает сырой указатель и должна доверять тому, что этот указатель действителен. Метод add для сырых указателей также небезопасен, потому что он должен доверять тому, что местоположение смещения также является действительным указателем. Поэтому нам пришлось поместить блок unsafe вокруг наших вызовов slice::from_raw_parts_mut и add, чтобы мы могли их вызвать. Глядя на код и добавляя утверждение, что mid должен быть меньше или равен len, мы можем сказать, что все сырые указатели, используемые внутри блока unsafe, будут действительными указателями на данные внутри среза. Это приемлемое и уместное использование unsafe.
Обратите внимание, что нам не нужно помечать результирующую функцию split_at_mut как unsafe, и мы можем вызывать эту функцию из безопасного Rust. Мы создали безопасную абстракцию над небезопасным кодом с помощью реализации функции, которая использует небезопасный код безопасным образом, потому что она создаёт только действительные указатели из данных, к которым эта функция имеет доступ.
В отличие от этого, использование slice::from_raw_parts_mut в листинге 20-7, вероятно, приведёт к аварийному завершению при использовании среза. Этот код принимает произвольное место в памяти и создаёт срез длиной 10 000 элементов.
fn main() {
use std::slice;
let address = 0x01234usize;
let r = address as *mut i32;
let values: &[i32] = unsafe { slice::from_raw_parts_mut(r, 10000) };
}Мы не владеем памятью по этому произвольному адресу, и нет гарантии, что срез, созданный этим кодом, содержит действительные значения i32. Попытка использовать values так, как если бы это был действительный срез, приводит к неопределённому поведению.
Использование extern функций для вызова внешнего кода
Иногда вашему коду Rust может понадобиться взаимодействовать с кодом, написанным на другом языке. Для этого в Rust есть ключевое слово extern, которое облегчает создание и использование интерфейса внешних функций (FFI) — способа, которым язык программирования определяет функции и позволяет другому (внешнему) языку программирования вызывать эти функции.
Листинг 20-8 демонстрирует, как настроить интеграцию с функцией abs из стандартной библиотеки C. Функции, объявленные внутри блоков extern, как правило, небезопасно вызывать из кода Rust, поэтому блоки extern также должны быть помечены unsafe. Причина в том, что другие языки не применяют правила и гарантии Rust, и Rust не может их проверить, поэтому ответственность ложится на программиста по обеспечению безопасности.
unsafe extern "C" {
fn abs(input: i32) -> i32;
}
fn main() {
unsafe {
println!("Absolute value of -3 according to C: {}", abs(-3));
}
}extern функции, определённой на другом языкеВнутри блока unsafe extern "C" мы перечисляем имена и сигнатуры внешних функций из другого языка, которые хотим вызывать. Часть "C" определяет, какой двоичный интерфейс приложения (ABI) использует внешняя функция: ABI определяет, как вызывать функцию на уровне ассемблера. ABI "C" является наиболее распространённым и следует ABI языка программирования C. Информация обо всех ABI, которые поддерживает Rust, доступна в справочнике Rust.
Каждый элемент, объявленный внутри блока unsafe extern, неявно небезопасен. Однако некоторые функции FFI безопасны для вызова. Например, функция abs из стандартной библиотеки C не имеет соображений безопасности памяти, и мы знаем, что её можно вызывать с любым i32. В таких случаях мы можем использовать ключевое слово safe, чтобы сказать, что эта конкретная функция безопасна для вызова, даже если она находится в блоке unsafe extern. Как только мы сделаем это изменение, её вызов больше не требует блока unsafe, как показано в листинге 20-9.
unsafe extern "C" {
safe fn abs(input: i32) -> i32;
}
fn main() {
println!("Absolute value of -3 according to C: {}", abs(-3));
}safe внутри блока unsafe extern и её безопасный вызовПомечивание функции как safe не делает её по своей сути безопасной! Вместо этого это как обещание, которое вы даёте Rust, что она безопасна. По-прежнему ваша ответственность — убедиться, что это обещание выполняется!
Вызов функций Rust из других языков
Мы также можем использовать extern, чтобы создать интерфейс, позволяющий другим языкам вызывать функции Rust. Вместо создания целого блока extern мы добавляем ключевое слово extern и указываем ABI для использования непосредственно перед ключевым словом fn для соответствующей функции. Нам также нужно добавить аннотацию #[unsafe(no_mangle)], чтобы сообщить компилятору Rust не искажать имя этой функции. Искажение имён — это когда компилятор изменяет имя, которое мы дали функции, на другое имя, которое содержит больше информации для других частей процесса компиляции, но менее читаемо для человека. Каждый компилятор языка программирования искажает имена немного по-разному, поэтому, чтобы функцию Rust можно было назвать из других языков, мы должны отключить искажение имён компилятора Rust. Это небезопасно, потому что без встроенного искажения могут возникнуть коллизии имён между библиотеками, поэтому наша ответственность — убедиться, что выбранное нами имя безопасно экспортировать без искажения.
В следующем примере мы делаем функцию call_from_c доступной из кода C после её компиляции в разделяемую библиотеку и связывания из C:
#[unsafe(no_mangle)]
pub extern "C" fn call_from_c() {
println!("Just called a Rust function from C!");
}
Это использование extern требует unsafe только в атрибуте, а не в блоке extern.
Доступ к изменяемой статической переменной или её изменение
В этой книге мы ещё не говорили о глобальных переменных, которые Rust поддерживает, но которые могут быть проблематичными с правилами владения Rust. Если два потока обращаются к одной и той же изменяемой глобальной переменной, это может вызвать гонку данных.
В Rust глобальные переменные называются статическими переменными. Листинг 20-10 показывает пример объявления и использования статической переменной со срезом строки в качестве значения.
static HELLO_WORLD: &str = "Hello, world!";
fn main() {
println!("value is: {HELLO_WORLD}");
}Статические переменные похожи на константы, которые мы обсуждали в разделе «Объявление констант» главы 3. Имена статических переменных по соглашению пишутся в SCREAMING_SNAKE_CASE. Статические переменные могут хранить только ссылки со временем жизни 'static, что означает, что компилятор Rust может определить время жизни, и нам не требуется аннотировать его явно. Доступ к неизменяемой статической переменной безопасен.
Тонкое различие между константами и неизменяемыми статическими переменными заключается в том, что значения в статической переменной имеют фиксированный адрес в памяти. Использование значения всегда будет обращаться к одним и тем же данным. Константы, с другой стороны, могут дублировать свои данные при каждом использовании. Другое различие заключается в том, что статические переменные могут быть изменяемыми. Доступ к изменяемым статическим переменным и их изменение небезопасны. Листинг 20-11 показывает, как объявить, получить доступ и изменить изменяемую статическую переменную с именем COUNTER.
static mut COUNTER: u32 = 0;
/// SAFETY: Вызов этой функции более чем из одного потока одновременно приводит к неопределённому
/// поведению, поэтому вы *обязаны* гарантировать, что вызываете её только из одного потока
/// за раз.
unsafe fn add_to_count(inc: u32) {
unsafe {
COUNTER += inc;
}
}
fn main() {
unsafe {
// SAFETY: Это вызывается только из одного потока в `main`.
add_to_count(3);
println!("COUNTER: {}", *(&raw const COUNTER));
}
}Как и с обычными переменными, мы указываем изменяемость с помощью ключевого слова mut. Любой код, который читает из COUNTER или пишет в него, должен находиться внутри блока unsafe. Код в листинге 20-11 компилируется и печатает COUNTER: 3, как мы и ожидали, потому что он однопоточный. Если бы несколько потоков обращались к COUNTER, это, вероятно, привело бы к гонкам данных, поэтому это неопределённое поведение. Следовательно, нам нужно пометить всю функцию как unsafe и документировать ограничение безопасности, чтобы любой, кто вызывает функцию, знал, что ему разрешено и что не разрешено делать безопасно.
Всякий раз, когда мы пишем небезопасную функцию, идиоматично писать комментарий, начинающийся с SAFETY, и объяснять, что вызывающему нужно сделать, чтобы безопасно вызвать функцию. Точно так же, когда мы выполняем небезопасную операцию, идиоматично писать комментарий, начинающийся с SAFETY, чтобы объяснить, как соблюдаются правила безопасности.
Кроме того, компилятор по умолчанию запрещает любую попытку создать ссылки на изменяемую статическую переменную с помощью линта компилятора. Вы должны либо явно отказаться от защит этого линта, добавив аннотацию #[allow(static_mut_refs)], либо получить доступ к изменяемой статической переменной через сырой указатель, созданный с помощью одного из операторов сырого заимствования. Это включает случаи, когда ссылка создаётся невидимо, как при её использовании в println! в этом листинге. Требование создавать ссылки на изменяемые статические переменные через сырые указатели помогает сделать требования безопасности при их использовании более очевидными.
С изменяемыми данными, которые глобально доступны, трудно гарантировать отсутствие гонок данных, поэтому Rust считает изменяемые статические переменные небезопасными. Где возможно, предпочтительнее использовать методы конкурентности и потокобезопасные умные указатели, которые мы обсуждали в главе 16, чтобы компилятор проверял, что доступ к данным из разных потоков выполняется безопасно.
Реализация небезопасного трейта
Мы можем использовать unsafe для реализации небезопасного трейта. Трейт небезопасен, когда хотя бы один из его методов имеет инвариант, который компилятор не может проверить. Мы объявляем, что трейт unsafe, добавляя ключевое слово unsafe перед trait, и также помечаем реализацию трейта как unsafe, как показано в листинге 20-12.
unsafe trait Foo {
// здесь методы
}
unsafe impl Foo for i32 {
// здесь реализации методов
}
fn main() {}Используя unsafe impl, мы обещаем, что будем соблюдать инварианты, которые компилятор не может проверить.
В качестве примера вспомните маркерные трейты Send и Sync, которые мы обсуждали в разделе «Расширяемая конкурентность с Send и Sync» главы 16: компилятор реализует эти трейты автоматически, если наши типы полностью состоят из других типов, реализующих Send и Sync. Если мы реализуем тип, содержащий тип, который не реализует Send или Sync, такой как сырые указатели, и хотим пометить этот тип как Send или Sync, мы должны использовать unsafe. Rust не может проверить, что наш тип поддерживает гарантии, что его можно безопасно передавать между потоками или получать к нему доступ из нескольких потоков; следовательно, нам нужно выполнить эти проверки вручную и указать это с помощью unsafe.
Доступ к полям объединения
Последнее действие, которое работает только с unsafe, — доступ к полям объединения. Объединение (union) похоже на struct, но только одно объявленное поле используется в конкретном экземпляре в один момент времени. Объединения в основном используются для взаимодействия с объединениями в коде C. Доступ к полям объединения небезопасен, потому что Rust не может гарантировать тип данных, которые в настоящее время хранятся в экземпляре объединения. Вы можете узнать больше об объединениях в справочнике Rust.
Использование Miri для проверки небезопасного кода
При написании небезопасного кода вы можете захотеть проверить, что написанное вами на самом деле безопасно и правильно. Один из лучших способов сделать это — использовать Miri, официальный инструмент Rust для обнаружения неопределённого поведения. В то время как проверка заимствований — это статический инструмент, который работает во время компиляции, Miri — это динамический инструмент, который работает во время выполнения. Он проверяет ваш код, запуская вашу программу или её набор тестов, и обнаруживает, когда вы нарушаете правила, которые он понимает о том, как должен работать Rust.
Использование Miri требует ночной сборки Rust (о которой мы говорим подробнее в Приложении G: Как создаётся Rust и «Ночной Rust»). Вы можете установить как ночную версию Rust, так и инструмент Miri, набрав rustup +nightly component add miri. Это не меняет версию Rust, которую использует ваш проект; это только добавляет инструмент в вашу систему, чтобы вы могли использовать его, когда захотите. Вы можете запустить Miri для проекта, набрав cargo +nightly miri run или cargo +nightly miri test.
В качестве примера того, насколько это может быть полезно, рассмотрим, что происходит, когда мы запускаем его против листинга 20-7.
$ cargo +nightly miri run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.17s
Running `file:///home/.rustup/toolchains/nightly/bin/cargo-miri runner target/miri/debug/unsafe-example`
warning: integer-to-pointer cast
--> src/main.rs:5:13
|
5 | let r = address as *mut i32;
| ^^^^^^^^^^^^^^^^^^^ integer-to-pointer cast
|
= help: this program is using integer-to-pointer casts or (equivalently) `ptr::with_exposed_provenance`, which means that Miri might miss pointer bugs in this program
= help: see https://doc.rust-lang.org/nightly/std/ptr/fn.with_exposed_provenance.html for more details on that operation
= help: to ensure that Miri does not miss bugs in your program, use Strict Provenance APIs (https://doc.rust-lang.org/nightly/std/ptr/index.html#strict-provenance, https://crates.io/crates/sptr) instead
= help: you can then set `MIRIFLAGS=-Zmiri-strict-provenance` to ensure you are not relying on `with_exposed_provenance` semantics
= help: alternatively, `MIRIFLAGS=-Zmiri-permissive-provenance` disables this warning
error: Undefined Behavior: constructing invalid value of type &mut [i32]: encountered a dangling reference (0x1234[noalloc] has no provenance)
--> src/main.rs:7:35
|
7 | let values: &[i32] = unsafe { slice::from_raw_parts_mut(r, 10000) };
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ Undefined Behavior occurred here
|
= help: this indicates a bug in the program: it performed an invalid operation, and caused Undefined Behavior
= help: see https://doc.rust-lang.org/nightly/reference/behavior-considered-undefined.html for further information
note: some details are omitted, run with `MIRIFLAGS=-Zmiri-backtrace=full` for a verbose backtrace
error: aborting due to 1 previous error; 1 warning emitted
Miri правильно предупреждает нас, что мы приводим целое число к указателю, что может быть проблемой, но Miri не может определить, существует ли проблема, потому что он не знает, как возник указатель. Затем Miri возвращает ошибку в месте, где листинг 20-7 имеет неопределённое поведение, потому что у нас есть висячий указатель. Благодаря Miri мы теперь знаем, что есть риск неопределённого поведения, и мы можем подумать о том, как сделать код безопасным. В некоторых случаях Miri может даже давать рекомендации о том, как исправить ошибки.
Miri не ловит всё, что вы можете сделать неправильно при написании небезопасного кода. Miri — это инструмент динамического анализа, поэтому он ловит проблемы только с кодом, который фактически выполняется. Это означает, что вам нужно будет использовать его в сочетании с хорошими методами тестирования, чтобы повысить вашу уверенность в написанном небезопасном коде. Miri также не охватывает все возможные способы, которыми ваш код может быть некорректным.
Другими словами: если Miri обнаружит проблему, вы знаете, что есть ошибка, но только потому, что Miri не обнаруживает ошибку, не означает, что проблемы нет. Однако он может поймать многое. Попробуйте запустить его на других примерах небезопасного кода в этой главе и посмотрите, что он скажет!
Вы можете узнать больше о Miri в его репозитории на GitHub.
Правильное использование небезопасного кода
Использование unsafe для одной из пяти только что обсуждённых сверхспособностей не является неправильным или даже не одобряется, но правильнее использовать unsafe сложнее, потому что компилятор не может помочь поддерживать безопасность памяти. Когда у вас есть причина использовать небезопасный код, вы можете это сделать, и наличие явной аннотации unsafe облегчает отслеживание источника проблем, когда они возникают. Всякий раз, когда вы пишете небезопасный код, вы можете использовать Miri, чтобы помочь вам быть более уверенным, что написанный вами код поддерживает правила Rust.
Для гораздо более глубокого изучения того, как эффективно работать с небезопасным Rust, прочитайте официальное руководство Rust по unsafe — Rustonomicon.
Продвинутые трейты
Продвинутые трейты
Мы впервые рассмотрели трейты в разделе «Определение общего поведения с помощью трейтов» главы 10, но не обсуждали более продвинутые детали. Теперь, когда вы знаете больше о Rust, мы можем углубиться в суть.
Определение трейтов с ассоциированными типами
Ассоциированные типы связывают заполнитель типа с трейтом так, что определения методов трейта могут использовать эти типы-заполнители в своих сигнатурах. Реализующий трейт укажет конкретный тип, который будет использоваться вместо типа-заполнителя для конкретной реализации. Таким образом, мы можем определить трейт, который использует некоторые типы, не зная точно, что это за типы, до тех пор, пока трейт не будет реализован.
Мы описали большинство продвинутых возможностей в этой главе как редко используемые. Ассоциированные типы находятся где-то посередине: они используются реже, чем возможности, объяснённые в остальной части книги, но чаще, чем многие другие возможности, обсуждаемые в этой главе.
Одним из примеров трейта с ассоциированным типом является трейт Iterator, который предоставляет стандартная библиотека. Ассоциированный тип называется Item и обозначает тип значений, по которым итерирует тип, реализующий трейт Iterator. Определение трейта Iterator выглядит как показано в листинге 20-13.
pub trait Iterator {
type Item;
fn next(&mut self) -> Option<Self::Item>;
}Iterator, который имеет ассоциированный тип ItemТип Item — это заполнитель, и определение метода next показывает, что он будет возвращать значения типа Option<Self::Item>. Реализующие трейт Iterator укажут конкретный тип для Item, и метод next вернёт Option, содержащий значение этого конкретного типа.
Ассоциированные типы могут показаться похожими на обобщения, поскольку последние позволяют нам определять функцию, не указывая, с какими типами она может работать. Чтобы изучить разницу между этими двумя концепциями, мы рассмотрим реализацию трейта Iterator для типа с именем Counter, который указывает, что тип Item — u32:
struct Counter {
count: u32,
}
impl Counter {
fn new() -> Counter {
Counter { count: 0 }
}
}
impl Iterator for Counter {
type Item = u32;
fn next(&mut self) -> Option<Self::Item> {
// --snip--
if self.count < 5 {
self.count += 1;
Some(self.count)
} else {
None
}
}
}Этот синтаксис кажется сопоставимым с синтаксисом обобщений. Итак, почему бы просто не определить трейт Iterator с обобщениями, как показано в листинге 20-14?
pub trait Iterator<T> {
fn next(&mut self) -> Option<T>;
}Iterator с использованием обобщенийРазница в том, что при использовании обобщений, как в листинге 20-14, мы должны аннотировать типы в каждой реализации; поскольку мы также можем реализовать Iterator<String> for Counter или любой другой тип, у нас может быть несколько реализаций Iterator для Counter. Другими словами, когда трейт имеет обобщённый параметр, он может быть реализован для типа несколько раз, изменяя конкретные типы обобщённых параметров типа каждый раз. Когда мы используем метод next для Counter, нам пришлось бы предоставить аннотации типов, чтобы указать, какую реализацию Iterator мы хотим использовать.
С ассоциированными типами нам не нужно аннотировать типы, потому что мы не можем реализовать трейт для типа несколько раз. В листинге 20-13 с определением, использующим ассоциированные типы, мы можем выбрать, каким будет тип Item, только один раз, потому что может быть только одна impl Iterator for Counter. Нам не нужно указывать, что мы хотим итератор значений u32, везде, где мы вызываем next для Counter.
Ассоциированные типы также становятся частью контракта трейта: реализующие трейт должны предоставить тип, который будет заменять заполнитель ассоциированного типа. Ассоциированные типы часто имеют имя, описывающее, как будет использоваться тип, и документирование ассоциированного типа в документации API является хорошей практикой.
Использование параметров обобщённого типа по умолчанию и перегрузки операторов
Когда мы используем параметры обобщённого типа, мы можем указать конкретный тип по умолчанию для обобщённого типа. Это устраняет необходимость для реализующих трейт указывать конкретный тип, если тип по умолчанию подходит. Вы указываете тип по умолчанию при объявлении обобщённого типа с синтаксисом <PlaceholderType=ConcreteType>.
Отличным примером ситуации, где эта техника полезна, является перегрузка операторов, в которой вы настраиваете поведение оператора (такого как +) в определённых ситуациях.
Rust не позволяет вам создавать собственные операторы или перегружать произвольные операторы. Но вы можете перегружать операции и соответствующие трейты, перечисленные в std::ops, реализуя трейты, связанные с оператором. Например, в листинге 20-15 мы перегружаем оператор +, чтобы складывать два экземпляра Point. Мы делаем это, реализуя трейт Add для структуры Point.
use std::ops::Add;
#[derive(Debug, Copy, Clone, PartialEq)]
struct Point {
x: i32,
y: i32,
}
impl Add for Point {
type Output = Point;
fn add(self, other: Point) -> Point {
Point {
x: self.x + other.x,
y: self.y + other.y,
}
}
}
fn main() {
assert_eq!(
Point { x: 1, y: 0 } + Point { x: 2, y: 3 },
Point { x: 3, y: 3 }
);
}Add для перегрузки оператора + для экземпляров PointМетод add складывает значения x двух экземпляров Point и значения y двух экземпляров Point, чтобы создать новый Point. Трейт Add имеет ассоциированный тип с именем Output, который определяет тип, возвращаемый методом add.
Обобщённый тип по умолчанию в этом коде находится внутри трейта Add. Вот его определение:
#![allow(unused)]
fn main() {
trait Add<Rhs=Self> {
type Output;
fn add(self, rhs: Rhs) -> Self::Output;
}
}Этот код должен выглядеть в целом знакомым: трейт с одним методом и ассоциированным типом. Новая часть — Rhs=Self: этот синтаксис называется параметрами типа по умолчанию. Обобщённый параметр типа Rhs (сокращение от «right-hand side» — правая сторона) определяет тип параметра rhs в методе add. Если мы не указываем конкретный тип для Rhs при реализации трейта Add, тип Rhs будет по умолчанию равен Self, который будет типом, для которого мы реализуем Add.
Когда мы реализовали Add для Point, мы использовали значение по умолчанию для Rhs, потому что хотели складывать два экземпляра Point. Давайте рассмотрим пример реализации трейта Add, где мы хотим настроить тип Rhs вместо использования значения по умолчанию.
У нас есть две структуры, Millimeters и Meters, содержащие значения в разных единицах измерения. Это тонкое обёртывание существующего типа в другую структуру известно как паттерн newtype, который мы описываем более подробно в разделе «Реализация внешних трейтов с помощью паттерна newtype». Мы хотим складывать значения в миллиметрах со значениями в метрах и иметь реализацию Add, которая правильно выполняет преобразование. Мы можем реализовать Add для Millimeters с Meters в качестве Rhs, как показано в листинге 20-16.
use std::ops::Add;
struct Millimeters(u32);
struct Meters(u32);
impl Add<Meters> for Millimeters {
type Output = Millimeters;
fn add(self, other: Meters) -> Millimeters {
Millimeters(self.0 + (other.0 * 1000))
}
}Add для Millimeters для сложения Millimeters и MetersЧтобы складывать Millimeters и Meters, мы указываем impl Add<Meters>, чтобы установить значение параметра типа Rhs вместо использования значения по умолчанию Self.
Вы будете использовать параметры типа по умолчанию двумя основными способами:
- Чтобы расширить тип без нарушения существующего кода
- Чтобы разрешить настройку в конкретных случаях, которые большинству пользователей не понадобятся
Трейт Add из стандартной библиотеки является примером второй цели: обычно вы складываете два однотипных значения, но трейт Add предоставляет возможность настройки за пределами этого. Использование параметра типа по умолчанию в определении трейта Add означает, что вам не нужно указывать дополнительный параметр в большинстве случаев. Другими словами, немного шаблонного кода реализации не требуется, что облегчает использование трейта.
Первая цель похожа на вторую, но в обратном порядке: если вы хотите добавить параметр типа к существующему трейту, вы можете дать ему значение по умолчанию, чтобы разрешить расширение функциональности трейта без нарушения существующего кода реализации.
Устранение неоднозначности между методами с одинаковыми именами
Ничто в Rust не мешает трейту иметь метод с тем же именем, что и метод другого трейта, и Rust не мешает вам реализовать оба трейта для одного типа. Также возможно реализовать метод непосредственно для типа с тем же именем, что и методы из трейтов.
При вызове методов с одинаковыми именами вам нужно указать Rust, какой из них вы хотите использовать. Рассмотрим код в листинге 20-17, где мы определили два трейта, Pilot и Wizard, оба с методом fly. Затем мы реализуем оба трейта для типа Human, у которого уже есть метод с именем fly, реализованный непосредственно для него. Каждый метод fly делает что-то разное.
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {}fly и реализованы для типа Human, а метод fly реализован непосредственно для Human.Когда мы вызываем fly для экземпляра Human, компилятор по умолчанию вызывает метод, реализованный непосредственно для типа, как показано в листинге 20-18.
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {
let person = Human;
person.fly();
}fly для экземпляра HumanЗапуск этого кода напечатает *waving arms furiously*, показывая, что Rust вызвал метод fly, реализованный непосредственно для Human.
Чтобы вызвать методы fly из трейта Pilot или трейта Wizard, нам нужно использовать более явный синтаксис, чтобы указать, какой метод fly мы имеем в виду. Листинг 20-19 демонстрирует этот синтаксис.
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {
let person = Human;
Pilot::fly(&person);
Wizard::fly(&person);
person.fly();
}fly из какого трейта мы хотим вызватьУказание имени трейта перед именем метода проясняет для Rust, какую реализацию fly мы хотим вызвать. Мы также могли бы написать Human::fly(&person), что эквивалентно person.fly(), который мы использовали в листинге 20-19, но это немного длиннее писать, если нам не нужно устранять неоднозначность.
Запуск этого кода печатает следующее:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.46s
Running `target/debug/traits-example`
This is your captain speaking.
Up!
*waving arms furiously*
Поскольку метод fly принимает параметр self, если бы у нас было два типа, которые оба реализуют один трейт, Rust мог бы определить, какую реализацию трейта использовать, основываясь на типе self.
Однако ассоциированные функции, которые не являются методами, не имеют параметра self. Когда есть несколько типов или трейтов, которые определяют функции, не являющиеся методами, с одинаковым именем функции, Rust не всегда знает, какой тип вы имеете в виду, если вы не используете полный синтаксис. Например, в листинге 20-20 мы создаём трейт для приюта для животных, который хочет назвать всех щенков Спот. Мы создаём трейт Animal с ассоциированной функцией, не являющейся методом, baby_name. Трейт Animal реализован для структуры Dog, для которой мы также напрямую предоставляем ассоциированную функцию, не являющуюся методом, baby_name.
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", Dog::baby_name());
}Мы реализуем код для именования всех щенков Спот в ассоциированной функции baby_name, которая определена для Dog. Тип Dog также реализует трейт Animal, который описывает характеристики, присущие всем животным. Щенков называют puppies, и это выражено в реализации трейта Animal для Dog в функции baby_name, ассоциированной с трейтом Animal.
В main мы вызываем функцию Dog::baby_name, которая напрямую вызывает ассоциированную функцию, определённую для Dog. Этот код печатает следующее:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.54s
Running `target/debug/traits-example`
A baby dog is called a Spot
Этот вывод не то, что мы хотели. Мы хотим вызвать функцию baby_name, которая является частью трейта Animal, который мы реализовали для Dog, чтобы код напечатал A baby dog is called a puppy. Техника указания имени трейта, которую мы использовали в листинге 20-19, здесь не помогает; если мы изменим main на код в листинге 20-21, мы получим ошибку компиляции.
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", Animal::baby_name());
}baby_name из трейта Animal, но Rust не знает, какую реализацию использоватьПоскольку Animal::baby_name не имеет параметра self, и могут быть другие типы, реализующие трейт Animal, Rust не может определить, какую реализацию Animal::baby_name мы хотим. Мы получим эту ошибку компилятора:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
error[E0790]: cannot call associated function on trait without specifying the corresponding `impl` type
--> src/main.rs:20:43
|
2 | fn baby_name() -> String;
| ------------------------- `Animal::baby_name` defined here
...
20 | println!("A baby dog is called a {}", Animal::baby_name());
| ^^^^^^^^^^^^^^^^^^^ cannot call associated function of trait
|
help: use the fully-qualified path to the only available implementation
|
20 | println!("A baby dog is called a {}", <Dog as Animal>::baby_name());
| +++++++ +
For more information about this error, try `rustc --explain E0790`.
error: could not compile `traits-example` (bin "traits-example") due to 1 previous error
Чтобы устранить неоднозначность и сказать Rust, что мы хотим использовать реализацию Animal для Dog, а не реализацию Animal для какого-то другого типа, нам нужно использовать полный синтаксис. Листинг 20-22 демонстрирует, как использовать полный синтаксис.
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", <Dog as Animal>::baby_name());
}baby_name из трейта Animal, реализованную для DogМы предоставляем Rust аннотацию типа внутри угловых скобок, которая указывает, что мы хотим вызвать метод baby_name из трейта Animal, реализованный для Dog, говоря, что мы хотим рассматривать тип Dog как Animal для этого вызова функции. Этот код теперь напечатает то, что мы хотим:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
Running `target/debug/traits-example`
A baby dog is called a puppy
В общем, полный синтаксис определяется следующим образом:
<Type as Trait>::function(receiver_if_method, next_arg, ...);Для ассоциированных функций, не являющихся методами, не было бы receiver: там был бы только список других аргументов. Вы можете использовать полный синтаксис везде, где вызываете функции или методы. Однако вам разрешено опускать любую часть этого синтаксиса, которую Rust может вывести из другой информации в программе. Вам нужно использовать этот более подробный синтаксис только в случаях, когда есть несколько реализаций с одинаковым именем, и Rust нужна помощь, чтобы определить, какую реализацию вы хотите вызвать.
Использование супертрейтов
Иногда вы можете написать определение трейта, которое зависит от другого трейта: чтобы тип реализовал первый трейт, вы хотите потребовать, чтобы этот тип также реализовывал второй трейт. Вы сделали бы это, чтобы определение вашего трейта могло использовать ассоциированные элементы второго трейта. Трейт, на который опирается определение вашего трейта, называется супертрейтом вашего трейта.
Например, допустим, мы хотим создать трейт OutlinePrint с методом outline_print, который печатает заданное значение, отформатированное так, чтобы оно было обрамлено звёздочками. То есть, для структуры Point, которая реализует трейт Display стандартной библиотеки, дающий (x, y), когда мы вызываем outline_print для экземпляра Point, у которого 1 для x и 3 для y, он должен напечатать следующее:
**********
* *
* (1, 3) *
* *
**********
В реализации метода outline_print мы хотим использовать функциональность трейта Display. Поэтому нам нужно указать, что трейт OutlinePrint будет работать только для типов, которые также реализуют Display и предоставляют функциональность, необходимую OutlinePrint. Мы можем сделать это в определении трейта, указав OutlinePrint: Display. Эта техника похожа на добавление ограничения трейта к трейту. Листинг 20-23 показывает реализацию трейта OutlinePrint.
use std::fmt;
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
fn main() {}OutlinePrint, который требует функциональность из DisplayПоскольку мы указали, что OutlinePrint требует трейт Display, мы можем использовать функцию to_string, которая автоматически реализуется для любого типа, реализующего Display. Если бы мы попытались использовать to_string без добавления двоеточия и указания трейта Display после имени трейта, мы получили бы ошибку, говорящую, что метод с именем to_string не найден для типа &Self в текущей области видимости.
Давайте посмотрим, что произойдёт, когда мы попытаемся реализовать OutlinePrint для типа, который не реализует Display, такого как структура Point:
use std::fmt;
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
struct Point {
x: i32,
y: i32,
}
impl OutlinePrint for Point {}
fn main() {
let p = Point { x: 1, y: 3 };
p.outline_print();
}Мы получаем ошибку, говорящую, что Display требуется, но не реализован:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
error[E0277]: `Point` doesn't implement `std::fmt::Display`
--> src/main.rs:20:23
|
20 | impl OutlinePrint for Point {}
| ^^^^^ unsatisfied trait bound
|
help: the trait `std::fmt::Display` is not implemented for `Point`
--> src/main.rs:15:1
|
15 | struct Point {
| ^^^^^^^^^^^^
note: required by a bound in `OutlinePrint`
--> src/main.rs:3:21
|
3 | trait OutlinePrint: fmt::Display {
| ^^^^^^^^^^^^ required by this bound in `OutlinePrint`
error[E0277]: `Point` doesn't implement `std::fmt::Display`
--> src/main.rs:24:7
|
24 | p.outline_print();
| ^^^^^^^^^^^^^ unsatisfied trait bound
|
help: the trait `std::fmt::Display` is not implemented for `Point`
--> src/main.rs:15:1
|
15 | struct Point {
| ^^^^^^^^^^^^
note: required by a bound in `OutlinePrint::outline_print`
--> src/main.rs:3:21
|
3 | trait OutlinePrint: fmt::Display {
| ^^^^^^^^^^^^ required by this bound in `OutlinePrint::outline_print`
4 | fn outline_print(&self) {
| ------------- required by a bound in this associated function
For more information about this error, try `rustc --explain E0277`.
error: could not compile `traits-example` (bin "traits-example") due to 2 previous errors
Чтобы исправить это, мы реализуем Display для Point и удовлетворяем ограничению, которое требует OutlinePrint, вот так:
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
struct Point {
x: i32,
y: i32,
}
impl OutlinePrint for Point {}
use std::fmt;
impl fmt::Display for Point {
fn fmt(&self, f: &mut fmt::Formatter) -> fmt::Result {
write!(f, "({}, {})", self.x, self.y)
}
}
fn main() {
let p = Point { x: 1, y: 3 };
p.outline_print();
}Затем реализация трейта OutlinePrint для Point успешно скомпилируется, и мы сможем вызвать outline_print для экземпляра Point, чтобы отобразить его в обрамлении из звёздочек.
Реализация внешних трейтов с помощью паттерна newtype
В разделе «Реализация трейта для типа» главы 10 мы упоминали правило сиротства, которое гласит, что нам разрешено реализовывать трейт для типа, только если либо трейт, либо тип, либо оба локальны для нашего крейта. Можно обойти это ограничение с помощью паттерна newtype, который включает создание нового типа в кортежной структуре. (Мы рассматривали кортежные структуры в разделе «Создание разных типов с помощью кортежных структур» главы 5.) Кортежная структура будет иметь одно поле и будет тонкой обёрткой вокруг типа, для которого мы хотим реализовать трейт. Затем тип-обёртка локальный для нашего крейта, и мы можем реализовать трейт для обёртки. Newtype — это термин, происходящий из языка программирования Haskell. Использование этого паттерна не влечёт за собой накладных расходов во время выполнения, а тип-обёртка устраняется во время компиляции.
В качестве примера допустим, мы хотим реализовать Display для Vec<T>, что правило сиротства не позволяет нам сделать напрямую, потому что трейт Display и тип Vec<T> определены вне нашего крейта. Мы можем создать структуру Wrapper, которая содержит экземпляр Vec<T>; затем мы можем реализовать Display для Wrapper и использовать значение Vec<T>, как показано в листинге 20-24.
use std::fmt;
struct Wrapper(Vec<String>);
impl fmt::Display for Wrapper {
fn fmt(&self, f: &mut fmt::Formatter) -> fmt::Result {
write!(f, "[{}]", self.0.join(", "))
}
}
fn main() {
let w = Wrapper(vec![String::from("hello"), String::from("world")]);
println!("w = {w}");
}Wrapper вокруг Vec<String> для реализации DisplayРеализация Display использует self.0 для доступа к внутреннему Vec<T>, потому что Wrapper — это кортежная структура, а Vec<T> — это элемент с индексом 0 в кортеже. Затем мы можем использовать функциональность трейта Display для Wrapper.
Недостаток использования этой техники заключается в том, что Wrapper — это новый тип, поэтому у него нет методов значения, которое он содержит. Нам пришлось бы реализовать все методы Vec<T> непосредственно для Wrapper, чтобы методы делегировали self.0, что позволило бы нам обращаться с Wrapper точно так же, как с Vec<T>. Если мы хотим, чтобы новый тип имел каждый метод, который есть у внутреннего типа, реализация трейта Deref для Wrapper для возврата внутреннего типа была бы решением (мы обсуждали реализацию трейта Deref в разделе «Обращение с умными указателями как с обычными ссылками» главы 15). Если мы не хотели, чтобы тип Wrapper имел все методы внутреннего типа — например, чтобы ограничить поведение типа Wrapper — нам пришлось бы реализовать только те методы, которые мы действительно хотим, вручную.
Этот паттерн newtype также полезен, даже когда трейты не задействованы. Давайте переключим внимание и рассмотрим некоторые продвинутые способы взаимодействия с системой типов Rust.
Продвинутые типы
Продвинутые типы
В системе типов Rust есть некоторые возможности, которые мы до сих пор упоминали, но ещё
не обсуждали. Мы начнём с обсуждения newtype-паттерна в целом, рассматривая, почему
они полезны как типы. Затем мы перейдём к псевдонимам типов — возможности,
похожей на newtype, но с несколько иной семантикой. Мы также обсудим
тип ! и динамически размерные типы.
Безопасность типов и абстракция с помощью newtype-паттерна
Этот раздел предполагает, что вы прочитали более ранний раздел «Реализация внешних трейтов с помощью паттерна newtype». Newtype-паттерн
также полезен для задач, помимо тех, которые мы обсуждали до сих пор, включая
статическое обеспечение того, чтобы значения никогда не путались, и указание единиц
измерения значения. Вы видели пример использования newtype для указания единиц в листинге
20-16: вспомните, что структуры Millimeters и Meters оборачивали значения u32
в newtype. Если бы мы написали функцию с параметром типа Millimeters, мы
не смогли бы скомпилировать программу, которая случайно попыталась бы вызвать эту
функцию со значением типа Meters или простым u32.
Мы также можем использовать newtype-паттерн, чтобы абстрагироваться от некоторых деталей реализации типа: новый тип может предоставлять публичный API, отличный от API приватного внутреннего типа.
Newtype также могут скрывать внутреннюю реализацию. Например, мы могли бы предоставить
тип People для обёртывания HashMap<i32, String>, который хранит ID человека,
связанный с его именем. Код, использующий People, взаимодействовал бы только с
публичным API, который мы предоставляем, например, с методом для добавления строки имени в
коллекцию People; этому коду не нужно было бы знать, что мы присваиваем i32 ID именам
внутренне. Newtype-паттерн — это лёгкий способ достичь инкапсуляции,
чтобы скрыть детали реализации, которые мы обсуждали в разделе «Инкапсуляция, скрывающая детали реализации»
главы 18.
Синонимы типов и псевдонимы типов
Rust предоставляет возможность объявить псевдоним типа, чтобы дать существующему типу
другое имя. Для этого мы используем ключевое слово type. Например, мы можем создать
псевдоним Kilometers для i32 вот так:
fn main() {
type Kilometers = i32;
let x: i32 = 5;
let y: Kilometers = 5;
println!("x + y = {}", x + y);
}Теперь псевдоним Kilometers — это синоним для i32; в отличие от типов Millimeters
и Meters, которые мы создали в листинге 20-16, Kilometers не является отдельным,
новым типом. Значения типа Kilometers будут трактоваться так же, как
значения типа i32:
fn main() {
type Kilometers = i32;
let x: i32 = 5;
let y: Kilometers = 5;
println!("x + y = {}", x + y);
}Поскольку Kilometers и i32 — один и тот же тип, мы можем складывать значения обоих
типов и передавать значения Kilometers в функции, принимающие параметры i32.
Однако, используя этот метод, мы не получаем преимуществ проверки типов,
которые мы получаем от newtype-паттерна, обсуждавшегося ранее. Иными словами, если мы
где-то перепутаем значения Kilometers и i32, компилятор не выдаст нам
ошибку.
Основной случай использования синонимов типов — сокращение повторений. Например, у нас может быть длинный тип, вроде такого:
Box<dyn Fn() + Send + 'static>Записывать этот длинный тип в сигнатурах функций и в аннотациях типов по всему коду может быть утомительно и чревато ошибками. Представьте себе проект, полный такого кода, как в листинге 20-25.
fn main() {
let f: Box<dyn Fn() + Send + 'static> = Box::new(|| println!("hi"));
fn takes_long_type(f: Box<dyn Fn() + Send + 'static>) {
// --snip--
}
fn returns_long_type() -> Box<dyn Fn() + Send + 'static> {
// --snip--
Box::new(|| ())
}
}Псевдоним типа делает этот код более управляемым, сокращая повторение. В
листинге 20-26 мы ввели псевдоним с именем Thunk для многословного типа и
можем заменить все использования типа более коротким псевдонимом Thunk.
fn main() {
type Thunk = Box<dyn Fn() + Send + 'static>;
let f: Thunk = Box::new(|| println!("hi"));
fn takes_long_type(f: Thunk) {
// --snip--
}
fn returns_long_type() -> Thunk {
// --snip--
Box::new(|| ())
}
}Thunk для сокращения повторенияЭтот код гораздо легче читать и писать! Выбор осмысленного имени для псевдонима типа может также помочь передать ваше намерение (thunk — это слово для кода, который должен быть вычислен позже, так что это подходящее имя для замыкания, которое сохраняется).
Псевдонимы типов также обычно используются с типом Result<T, E> для сокращения
повторений. Рассмотрим модуль std::io в стандартной библиотеке. Операции ввода-вывода
часто возвращают Result<T, E> для обработки ситуаций, когда операции
не удаются. В этой библиотеке есть структура std::io::Error, которая представляет все
возможные ошибки ввода-вывода. Многие функции в std::io будут возвращать
Result<T, E>, где E — это std::io::Error, например, эти функции в
трейте Write:
use std::fmt;
use std::io::Error;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize, Error>;
fn flush(&mut self) -> Result<(), Error>;
fn write_all(&mut self, buf: &[u8]) -> Result<(), Error>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<(), Error>;
}Result<..., Error> повторяется очень часто. Поэтому в std::io есть это объявление
псевдонима типа:
use std::fmt;
type Result<T> = std::result::Result<T, std::io::Error>;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize>;
fn flush(&mut self) -> Result<()>;
fn write_all(&mut self, buf: &[u8]) -> Result<()>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<()>;
}Поскольку это объявление находится в модуле std::io, мы можем использовать полностью
квалифицированный псевдоним std::io::Result<T>; то есть Result<T, E> с E,
заполненным как std::io::Error. Сигнатуры функций трейта Write в итоге
выглядят так:
use std::fmt;
type Result<T> = std::result::Result<T, std::io::Error>;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize>;
fn flush(&mut self) -> Result<()>;
fn write_all(&mut self, buf: &[u8]) -> Result<()>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<()>;
}Псевдоним типа помогает двумя способами: он делает код проще для написания и даёт
нам согласованный интерфейс во всём std::io. Поскольку это псевдоним, это
просто ещё один Result<T, E>, что означает, что мы можем использовать любые методы, работающие с
Result<T, E>, с ним, а также специальный синтаксис, такой как оператор ?.
Тип «никогда», который никогда не возвращается
В Rust есть специальный тип с именем !, известный в терминологии теории типов как
пустой тип, потому что у него нет значений. Мы предпочитаем называть его типом «никогда»,
потому что он занимает место возвращаемого типа, когда функция никогда не
возвращается. Вот пример:
fn bar() -> ! {
// --snip--
panic!();
}Этот код читается как «функция bar возвращает никогда». Функции, которые возвращают
никогда, называются дивергентными функциями. Мы не можем создавать значения типа !,
поэтому bar никогда не сможет вернуться.
Но какая польза от типа, для которого вы никогда не можете создать значения? Вспомните код из листинга 2-5, часть игры по угадыванию чисел; мы воспроизвели его часть здесь в листинге 20-27.
use std::cmp::Ordering;
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
loop {
println!("Please input your guess.");
let mut guess = String::new();
// --snip--
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = match guess.trim().parse() {
Ok(num) => num,
Err(_) => continue,
};
println!("You guessed: {guess}");
// --snip--
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break;
}
}
}
}match с ветвью, которая заканчивается continueВ то время мы пропустили некоторые детали в этом коде. В разделе «Конструкция
потока управления match»
главы 6 мы обсуждали, что ветви match должны все возвращать один и тот же
тип. Так, например, следующий код не работает:
fn main() {
let guess = "3";
let guess = match guess.trim().parse() {
Ok(_) => 5,
Err(_) => "hello",
};
}Тип guess в этом коде должен был бы быть целым числом и строкой,
а Rust требует, чтобы у guess был только один тип. Итак, что возвращает continue?
Как нам было разрешено вернуть u32 из одной ветви и иметь другую ветвь,
которая заканчивается continue, в листинге 20-27?
Как вы, возможно, догадались, continue имеет значение !. То есть, когда Rust
вычисляет тип guess, он смотрит на обе ветви match, первая со
значением u32, а вторая со значением !. Поскольку ! никогда не может иметь
значение, Rust решает, что тип guess — u32.
Формальный способ описания этого поведения состоит в том, что выражения типа ! могут
быть приведены к любому другому типу. Нам разрешено закончить эту ветвь match
выражением continue, потому что continue не возвращает значение; вместо этого он перемещает управление
обратно в начало цикла, поэтому в случае Err мы никогда не присваиваем значение
guess.
Тип «никогда» также полезен с макросом panic!. Вспомните функцию unwrap,
которую мы вызываем для значений Option<T>, чтобы получить значение или запаниковать с
таким определением:
enum Option<T> {
Some(T),
None,
}
use crate::Option::*;
impl<T> Option<T> {
pub fn unwrap(self) -> T {
match self {
Some(val) => val,
None => panic!("called `Option::unwrap()` on a `None` value"),
}
}
}В этом коде происходит то же самое, что и в match в листинге 20-27: Rust
видит, что val имеет тип T, а panic! имеет тип !, так что результат
всего выражения match — T. Этот код работает, потому что panic!
не производит значение; он завершает программу. В случае None мы не будем
возвращать значение из unwrap, поэтому этот код действителен.
Последнее выражение, которое имеет тип !, — это цикл:
fn main() {
print!("forever ");
loop {
print!("and ever ");
}
}Здесь цикл никогда не заканчивается, поэтому ! — это значение выражения. Однако это
не было бы верно, если бы мы включили break, потому что цикл завершился бы,
когда дошёл бы до break.
Динамически размерные типы и трейт Sized
Rust нужно знать определённые детали о своих типах, такие как сколько места выделить для значения определённого типа. Это оставляет один уголок его системы типов немного запутанным поначалу: концепция динамически sized типов. Иногда называемые DST или unsized типами, эти типы позволяют нам писать код, используя значения, размер которых мы можем знать только во время выполнения.
Давайте углубимся в детали динамически sized типа с именем str, который
мы использовали на протяжении всей книги. Правильно, не &str, а str сам по себе
является DST. Во многих случаях, например, при сохранении текста, введённого пользователем,
мы не можем знать, насколько длинной будет строка, до времени выполнения. Это означает, что мы не можем создать
переменную типа str, и мы не можем принять аргумент типа str. Рассмотрим
следующий код, который не работает:
fn main() {
let s1: str = "Hello there!";
let s2: str = "How's it going?";
}Rust нужно знать, сколько памяти выделить для любого значения определённого
типа, и все значения типа должны использовать одинаковое количество памяти. Если бы Rust
позволил нам написать этот код, эти два значения str должны были бы занимать
одинаковое количество места. Но они имеют разную длину: s1 нужно 12 байт
памяти, а s2 нужно 15. Вот почему невозможно создать переменную,
содержащую динамически sized тип.
Итак, что мы делаем? В этом случае вы уже знаете ответ: мы делаем тип
s1 и s2 строковым срезом (&str), а не str. Вспомните из
раздела «Строковые срезы» главы 4, что
структура данных среза хранит только начальную позицию и длину
среза. Итак, хотя &T — это одно значение, которое хранит адрес памяти
того, где находится T, строковый срез — это два значения: адрес
str и его длина. Таким образом, мы можем знать размер значения строкового среза во
время компиляции: это удвоенная длина usize. То есть мы всегда знаем
размер строкового среза, независимо от того, насколько длинной является строка, на которую он ссылается. В
общем, это способ, которым динамически размерные типы используются в Rust:
у них есть дополнительный бит метаданных, который хранит размер динамической
информации. Золотое правило динамически sized типов состоит в том, что мы должны всегда
помещать значения динамически sized типов за указателем какого-либо вида.
Мы можем комбинировать str со всеми видами указателей: например, Box<str> или
Rc<str>. Фактически, вы видели это раньше, но с другим динамически
sized типом: трейтами. Каждый трейт — это динамически sized тип, на который мы можем ссылаться,
используя имя трейта. В разделе «Использование трейт-объектов для абстрагирования над
общим поведением» главы 18 мы упомянули, что для использования трейтов как трейт-объектов,
мы должны поместить их за указателем, таким как &dyn Trait или Box<dyn Trait> (Rc<dyn Trait> тоже работал бы).
Для работы с DST Rust предоставляет трейт Sized, чтобы определить, известен ли
размер типа во время компиляции. Этот трейт автоматически реализуется
для всего, чей размер известен во время компиляции. Кроме того, Rust
неявно добавляет ограничение на Sized к каждой обобщённой функции. То есть
определение обобщённой функции, вроде этого:
fn generic<T>(t: T) {
// --snip--
}фактически трактуется так, как если бы мы написали это:
fn generic<T: Sized>(t: T) {
// --snip--
}По умолчанию обобщённые функции будут работать только с типами, которые имеют известный размер во время компиляции. Однако вы можете использовать следующий специальный синтаксис, чтобы ослабить это ограничение:
fn generic<T: ?Sized>(t: &T) {
// --snip--
}Ограничение трейта ?Sized означает «T может быть или не быть Sized», и эта
нотация переопределяет значение по умолчанию, что обобщённые типы должны иметь известный размер во
время компиляции. Синтаксис ?Trait с этим значением доступен только для
Sized, а не для любых других трейтов.
Также обратите внимание, что мы изменили тип параметра t с T на &T.
Поскольку тип может не быть Sized, нам нужно использовать его за указателем какого-либо вида.
В этом случае мы выбрали ссылку.
Далее мы поговорим о функциях и замыканиях!
Продвинутые функции и замыкания
Продвинутые функции и замыкания
В этом разделе рассматриваются некоторые продвинутые возможности, связанные с функциями и замыканиями, включая указатели на функции и возврат замыканий.
Указатели на функции
Мы говорили о том, как передавать замыкания в функции; вы также можете передавать обычные
функции в функции! Этот приём полезен, когда вы хотите передать
уже определённую функцию вместо определения нового замыкания. Функции
приводятся к типу fn (со строчной буквой f), не путать с
трейтом замыкания Fn. Тип fn называется указателем на функцию. Передача
функций с помощью указателей на функции позволяет использовать функции в качестве аргументов
других функций.
Синтаксис указания того, что параметр является указателем на функцию, похож на
синтаксис замыканий, как показано в листинге 20-28, где мы определили функцию
add_one, которая добавляет 1 к своему параметру. Функция do_twice принимает два
параметра: указатель на функцию для любой функции, принимающей параметр i32
и возвращающей i32, и одно значение i32. Функция do_twice вызывает
функцию f дважды, передавая ей значение arg, затем складывает результаты двух вызовов
функции. Функция main вызывает do_twice с аргументами
add_one и 5.
fn add_one(x: i32) -> i32 {
x + 1
}
fn do_twice(f: fn(i32) -> i32, arg: i32) -> i32 {
f(arg) + f(arg)
}
fn main() {
let answer = do_twice(add_one, 5);
println!("The answer is: {answer}");
}fn для принятия указателя на функцию в качестве аргументаЭтот код выводит The answer is: 12. Мы указываем, что параметр f в
do_twice является fn, принимающим один параметр типа i32 и возвращающим
i32. Затем мы можем вызвать f в теле do_twice. В main мы можем передать
имя функции add_one в качестве первого аргумента do_twice.
В отличие от замыканий, fn — это тип, а не трейт, поэтому мы указываем fn в качестве
типа параметра напрямую, а не объявляем обобщённый параметр типа с одним
из трейтов Fn в качестве ограничения трейта.
Указатели на функции реализуют все три трейта замыканий (Fn, FnMut и
FnOnce), что означает, что вы всегда можете передать указатель на функцию в качестве аргумента
функции, которая ожидает замыкание. Лучше всего писать функции с использованием обобщённого
типа и одного из трейтов замыканий, чтобы ваши функции могли принимать как
функции, так и замыкания.
Тем не менее, один пример, когда вы хотите принимать только fn, а не
замыкания, — это взаимодействие с внешним кодом, в котором нет замыканий: функции C
могут принимать функции в качестве аргументов, но в C нет замыканий.
В качестве примера того, где вы можете использовать либо замыкание, определённое inline, либо именованную
функцию, давайте рассмотрим использование метода map, предоставляемого трейтом Iterator
в стандартной библиотеке. Чтобы использовать метод map для преобразования вектора
чисел в вектор строк, мы могли бы использовать замыкание, как в листинге 20-29.
fn main() {
let list_of_numbers = vec![1, 2, 3];
let list_of_strings: Vec<String> =
list_of_numbers.iter().map(|i| i.to_string()).collect();
}map для преобразования чисел в строкиИли мы могли бы назвать функцию в качестве аргумента map вместо замыкания.
В листинге 20-30 показано, как это выглядело бы.
fn main() {
let list_of_numbers = vec![1, 2, 3];
let list_of_strings: Vec<String> =
list_of_numbers.iter().map(ToString::to_string).collect();
}String::to_string с методом map для преобразования чисел в строкиОбратите внимание, что мы должны использовать полный синтаксис, о котором говорили в
разделе «Продвинутые трейты», потому что доступно
несколько функций с именем to_string.
Здесь мы используем функцию to_string, определённую в трейте ToString,
которую стандартная библиотека реализовала для любого типа, реализующего
Display.
Вспомните из раздела «Значения перечисления» в главе 6, что имя каждого варианта перечисления, который мы определяем, также становится функцией-инициализатором. Мы можем использовать эти функции-инициализаторы как указатели на функции, реализующие трейты замыканий, что означает, что мы можем указать функции-инициализаторы в качестве аргументов для методов, принимающих замыкания, как показано в листинге 20-31.
fn main() {
enum Status {
Value(u32),
Stop,
}
let list_of_statuses: Vec<Status> = (0u32..20).map(Status::Value).collect();
}map для создания экземпляра Status из чиселЗдесь мы создаём экземпляры Status::Value, используя каждое значение u32 в диапазоне,
для которого вызывается map, с помощью функции-инициализатора Status::Value.
Некоторые люди предпочитают этот стиль, а некоторые предпочитают использовать замыкания. Они
компилируются в один и тот же код, поэтому используйте тот стиль, который вам понятнее.
Возврат замыканий
Замыкания представлены трейтами, что означает, что вы не можете возвращать замыкания
напрямую. В большинстве случаев, когда вы хотите вернуть трейт, вы можете вместо этого
использовать конкретный тип, реализующий трейт, в качестве возвращаемого значения
функции. Однако обычно вы не можете сделать это с замыканиями, потому что у них
нет конкретного типа, который можно вернуть; например, вам не разрешается использовать указатель на функцию
fn в качестве возвращаемого типа, если замыкание захватывает какие-либо значения из своей
области видимости.
Вместо этого вы обычно будете использовать синтаксис impl Trait, который мы изучили в
главе 10. Вы можете вернуть любой тип функции, используя Fn, FnOnce и FnMut.
Например, код в листинге 20-32 скомпилируется без проблем.
#![allow(unused)]
fn main() {
fn returns_closure() -> impl Fn(i32) -> i32 {
|x| x + 1
}
}impl TraitОднако, как мы отметили в разделе «Вывод и аннотирование типов замыканий» в главе 13, каждое замыкание также является своим собственным отдельным типом. Если вам нужно работать с несколькими функциями, которые имеют одинаковую сигнатуру, но разные реализации, вам нужно будет использовать для них трейт-объект. Рассмотрим, что произойдёт, если вы напишете код, подобный показанному в листинге 20-33.
fn main() {
let handlers = vec![returns_closure(), returns_initialized_closure(123)];
for handler in handlers {
let output = handler(5);
println!("{output}");
}
}
fn returns_closure() -> impl Fn(i32) -> i32 {
|x| x + 1
}
fn returns_initialized_closure(init: i32) -> impl Fn(i32) -> i32 {
move |x| x + init
}Vec<T> из замыканий, определяемых функциями, возвращающими типы impl FnЗдесь у нас две функции, returns_closure и returns_initialized_closure,
которые обе возвращают impl Fn(i32) -> i32. Обратите внимание, что возвращаемые ими
замыкания различаются, хотя и реализуют один и тот же тип. Если мы попытаемся
скомпилировать это, Rust сообщит нам, что это не сработает:
$ cargo build
Compiling functions-example v0.1.0 (file:///projects/functions-example)
error[E0308]: mismatched types
--> src/main.rs:2:44
|
2 | let handlers = vec![returns_closure(), returns_initialized_closure(123)];
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ expected opaque type, found a different opaque type
...
9 | fn returns_closure() -> impl Fn(i32) -> i32 {
| ------------------- the expected opaque type
...
13 | fn returns_initialized_closure(init: i32) -> impl Fn(i32) -> i32 {
| ------------------- the found opaque type
|
= note: expected opaque type `impl Fn(i32) -> i32`
found opaque type `impl Fn(i32) -> i32`
= note: distinct uses of `impl Trait` result in different opaque types
For more information about this error, try `rustc --explain E0308`.
error: could not compile `functions-example` (bin "functions-example") due to 1 previous error
Сообщение об ошибке говорит нам, что всякий раз, когда мы возвращаем impl Trait, Rust
создаёт уникальный непрозрачный тип — тип, детали которого мы не можем видеть,
что Rust конструирует для нас, и не можем угадать тип, который Rust сгенерирует, чтобы
написать самим. Таким образом, хотя эти функции возвращают замыкания, реализующие
один и тот же трейт, Fn(i32) -> i32, непрозрачные типы, которые Rust генерирует для каждого из них,
различны. (Это похоже на то, как Rust создаёт разные конкретные типы для
различных async-блоков, даже если у них один и тот же выходной тип, как мы видели в
«Тип Pin и трейт Unpin» в
главе 17.) Мы уже несколько раз видели решение этой проблемы: мы можем
использовать трейт-объект, как в листинге 20-34.
fn main() {
let handlers = vec![returns_closure(), returns_initialized_closure(123)];
for handler in handlers {
let output = handler(5);
println!("{output}");
}
}
fn returns_closure() -> Box<dyn Fn(i32) -> i32> {
Box::new(|x| x + 1)
}
fn returns_initialized_closure(init: i32) -> Box<dyn Fn(i32) -> i32> {
Box::new(move |x| x + init)
}Vec<T> из замыканий, определяемых функциями, возвращающими Box<dyn Fn>, чтобы они имели один и тот же типЭтот код скомпилируется без проблем. Подробнее о трейт-объектах см. в разделе «Использование трейт-объектов для абстрагирования над общим поведением» в главе 18.
Далее давайте рассмотрим макросы!
Макросы
Макросы
На протяжении всей книги мы использовали макросы, такие как println!, но мы ещё полностью не исследовали, что такое макрос и как он работает. Термин макрос относится к семейству возможностей Rust — декларативные макросы с macro_rules! и три вида процедурных макросов:
- Пользовательские макросы
#[derive], которые определяют код, добавляемый атрибутомderive, используемым для структур и перечислений - Атрибутоподобные макросы, которые определяют пользовательские атрибуты, применимые к любому элементу
- Функционально-подобные макросы, которые выглядят как вызовы функций, но работают с токенами, указанными в качестве аргумента
Мы поговорим о каждом из них по очереди, но сначала давайте посмотрим, зачем нам вообще нужны макросы, если у нас уже есть функции.
Разница между макросами и функциями
По сути, макросы — это способ написания кода, который пишет другой код, известный как метапрограммирование. В Приложении C мы обсуждаем атрибут derive, который генерирует реализацию различных трейтов для вас. Мы также использовали макросы println! и vec! на протяжении всей книги. Все эти макросы разворачиваются, создавая больше кода, чем вы написали бы вручную.
Метапрограммирование полезно для уменьшения количества кода, который вам приходится писать и поддерживать, что также является одной из ролей функций. Однако у макросов есть некоторые дополнительные возможности, которых у функций нет.
Сигнатура функции должна объявлять количество и тип параметров, которые есть у функции. Макросы, с другой стороны, могут принимать переменное количество параметров: мы можем вызвать println!("hello") с одним аргументом или println!("hello {}", name) с двумя аргументами. Кроме того, макросы разворачиваются до того, как компилятор интерпретирует значение кода, поэтому макрос может, например, реализовать трейт для заданного типа. Функция не может этого сделать, потому что она вызывается во время выполнения, а трейт должен быть реализован во время компиляции.
Недостаток реализации макроса вместо функции заключается в том, что определения макросов сложнее определений функций, потому что вы пишете код на Rust, который пишет код на Rust. Из-за этой косвенности определения макросов, как правило, труднее читать, понимать и поддерживать, чем определения функций.
Ещё одно важное различие между макросами и функциями заключается в том, что вы должны определять макросы или вводить их в область видимости до того, как вы их вызываете в файле, в отличие от функций, которые можно определять где угодно и вызывать где угодно.
Декларативные макросы для общего метапрограммирования
Наиболее широко используемая форма макросов в Rust — декларативный макрос. Их также иногда называют «макросами по примеру», «макросами macro_rules!» или просто «макросами». По своей сути декларативные макросы позволяют писать нечто похожее на выражение match в Rust. Как обсуждалось в главе 6, выражения match — это управляющие структуры, которые принимают выражение, сравнивают результирующее значение выражения с шаблонами и затем выполняют код, связанный с совпавшим шаблоном. Макросы также сравнивают значение с шаблонами, связанными с конкретным кодом: в этой ситуации значение — это буквальный исходный код на Rust, переданный макросу; шаблоны сравниваются со структурой этого исходного кода; и код, связанный с каждым шаблоном, при совпадении заменяет код, переданный макросу. Всё это происходит во время компиляции.
Чтобы определить макрос, вы используете конструкцию macro_rules!. Давайте исследуем, как использовать macro_rules!, посмотрев, как определён макрос vec!. В главе 8 рассказывалось, как мы можем использовать макрос vec! для создания нового вектора с конкретными значениями. Например, следующий макрос создаёт новый вектор, содержащий три целых числа:
#![allow(unused)]
fn main() {
let v: Vec<u32> = vec![1, 2, 3];
}Мы также могли бы использовать макрос vec!, чтобы создать вектор из двух целых чисел или вектор из пяти строковых срезов. Мы не смогли бы использовать функцию, чтобы сделать то же самое, потому что не знали бы количество или тип значений заранее.
Листинг 20-35 показывает несколько упрощённое определение макроса vec!.
#[macro_export]
macro_rules! vec {
( $( $x:expr ),* ) => {
{
let mut temp_vec = Vec::new();
$(
temp_vec.push($x);
)*
temp_vec
}
};
}vec!Примечание: Фактическое определение макроса vec! в стандартной библиотеке включает код для предварительного выделения правильного объёма памяти. Этот код является оптимизацией, которую мы здесь не включаем, чтобы сделать пример проще.
Аннотация #[macro_export] указывает, что этот макрос должен быть доступен всякий раз, когда крейт, в котором определён макрос, вводится в область видимости. Без этой аннотации макрос не может быть введён в область видимости.
Затем мы начинаем определение макроса с macro_rules! и имени макроса, который мы определяем, без восклицательного знака. Имя, в данном случае vec, сопровождается фигурными скобками, обозначающими тело определения макроса.
Структура в теле vec! похожа на структуру выражения match. Здесь у нас есть одно плечо с шаблоном ( $( $x:expr ),* ), за которым следует => и блок кода, связанный с этим шаблоном. Если шаблон совпадает, будет сгенерирован связанный блок кода. Учитывая, что это единственный шаблон в этом макросе, есть только один допустимый способ совпадения; любой другой шаблон приведёт к ошибке. Более сложные макросы будут иметь более одного плеча.
Допустимый синтаксис шаблонов в определениях макросов отличается от синтаксиса шаблонов, рассмотренного в главе 19, потому что шаблоны макросов сравниваются со структурой кода на Rust, а не со значениями. Давайте разберём, что означают части шаблона в листинге 20-29; полный синтаксис шаблонов макросов см. в Справочнике по Rust.
Сначала мы используем набор круглых скобок, чтобы охватить весь шаблон. Мы используем знак доллара ($), чтобы объявить переменную в системе макросов, которая будет содержать код на Rust, соответствующий шаблону. Знак доллара даёт понять, что это переменная макроса, в отличие от обычной переменной Rust. Затем идёт набор круглых скобок, которые захватывают значения, соответствующие шаблону внутри круглых скобок, для использования в заменяющем коде. Внутри $() находится $x:expr, который соответствует любому выражению Rust и даёт выражению имя $x.
Запятая после $() указывает, что между каждым экземпляром кода, соответствующего коду в $(), должен появляться литеральный символ-разделитель-запятая. Символ * указывает, что шаблон соответствует нулю или более экземпляров того, что предшествует *.
Когда мы вызываем этот макрос с vec![1, 2, 3];, шаблон $x совпадает три раза с тремя выражениями 1, 2 и 3.
Теперь давайте посмотрим на шаблон в теле кода, связанного с этим плечом: temp_vec.push() внутри $()* генерируется для каждой части, соответствующей $() в шаблоне, ноль или более раз в зависимости от того, сколько раз шаблон совпадает. $x заменяется каждым совпавшим выражением. Когда мы вызываем этот макрос с vec![1, 2, 3];, сгенерированный код, заменяющий этот вызов макроса, будет следующим:
{
let mut temp_vec = Vec::new();
temp_vec.push(1);
temp_vec.push(2);
temp_vec.push(3);
temp_vec
}Мы определили макрос, который может принимать любое количество аргументов любого типа и генерировать код для создания вектора, содержащего указанные элементы.
Чтобы узнать больше о том, как писать макросы, обратитесь к онлайн-документации или другим ресурсам, например к «The Little Book of Rust Macros», начатой Дэниелом Кипом и продолженной Лукасом Виртом.
Процедурные макросы для генерации кода из атрибутов
Вторая форма макросов — процедурный макрос, который действует больше как функция (и является разновидностью процедуры). Процедурные макросы принимают некоторый код на вход, оперируют этим кодом и производят некоторый код на выходе, вместо того чтобы сопоставлять шаблоны и заменять код другим кодом, как это делают декларативные макросы. Три вида процедурных макросов — пользовательские derive, атрибутоподобные и функционально-подобные, и все они работают схожим образом.
При создании процедурных макросов определения должны находиться в собственном крейте со специальным типом крейта. Это по сложным техническим причинам, которые мы надеемся устранить в будущем. В листинге 20-36 мы показываем, как определить процедурный макрос, где some_attribute — это заполнитель для использования конкретной разновидности макроса.
use proc_macro::TokenStream;
#[some_attribute]
pub fn some_name(input: TokenStream) -> TokenStream {
}Функция, определяющая процедурный макрос, принимает TokenStream на вход и производит TokenStream на выходе. Тип TokenStream определён крейтом proc_macro, который поставляется с Rust и представляет последовательность токенов. Это ядро макроса: исходный код, с которым работает макрос, составляет входной TokenStream, а код, который производит макрос, — это выходной TokenStream. У функции также есть прикреплённый к ней атрибут, который указывает, какой вид процедурного макроса мы создаём. Мы можем иметь несколько видов процедурных макросов в одном крейте.
Давайте рассмотрим разные виды процедурных макросов. Мы начнём с пользовательского макроса derive, а затем объясним небольшие различия, которые делают другие формы разными.
Пользовательские макросы derive
Давайте создадим крейт под названием hello_macro, который определяет трейт под названием HelloMacro с одной ассоциированной функцией под названием hello_macro. Вместо того чтобы заставлять наших пользователей реализовывать трейт HelloMacro для каждого из их типов, мы предоставим процедурный макрос, чтобы пользователи могли аннотировать свой тип с помощью #[derive(HelloMacro)], чтобы получить реализацию по умолчанию функции hello_macro. Реализация по умолчанию будет печатать Hello, Macro! My name is TypeName!, где TypeName — имя типа, для которого был определён этот трейт. Другими словами, мы напишем крейт, который позволяет другому программисту писать код, как в листинге 20-37, используя наш крейт.
use hello_macro::HelloMacro;
use hello_macro_derive::HelloMacro;
#[derive(HelloMacro)]
struct Pancakes;
fn main() {
Pancakes::hello_macro();
}Этот код напечатает Hello, Macro! My name is Pancakes!, когда мы закончим. Первый шаг — создать новый библиотечный крейт, вот так:
$ cargo new hello_macro --lib
Затем в листинге 20-38 мы определим трейт HelloMacro и его ассоциированную функцию.
pub trait HelloMacro {
fn hello_macro();
}deriveУ нас есть трейт и его функция. На этом этапе пользователь нашего крейта мог бы реализовать трейт для достижения желаемой функциональности, как в листинге 20-39.
use hello_macro::HelloMacro;
struct Pancakes;
impl HelloMacro for Pancakes {
fn hello_macro() {
println!("Hello, Macro! My name is Pancakes!");
}
}
fn main() {
Pancakes::hello_macro();
}HelloMacroОднако им пришлось бы писать блок реализации для каждого типа, который они хотели бы использовать с hello_macro; мы хотим избавить их от этой работы.
Кроме того, мы пока не можем предоставить функции hello_macro реализацию по умолчанию, которая напечатает имя типа, для которого реализован трейт: в Rust нет возможностей рефлексии, поэтому он не может найти имя типа во время выполнения. Нам нужен макрос для генерации кода во время компиляции.
Следующий шаг — определить процедурный макрос. На момент написания этой книги процедурные макросы должны находиться в собственном крейте. В конечном счёте это ограничение может быть снято. Соглашение о структурировании крейтов и крейтов-макросов следующее: для крейта с именем foo крейт пользовательского процедурного макроса derive называется foo_derive. Давайте запустим новый крейт под названием hello_macro_derive внутри нашего проекта hello_macro:
$ cargo new hello_macro_derive --lib
Наши два крейта тесно связаны, поэтому мы создаём крейт процедурного макроса внутри директории нашего крейта hello_macro. Если мы изменим определение трейта в hello_macro, нам придётся изменить реализацию процедурного макроса в hello_macro_derive тоже. Два крейта нужно будет публиковать отдельно, и программистам, использующим эти крейты, нужно будет добавить оба в качестве зависимостей и ввести оба в область видимости. Мы могли бы вместо этого сделать так, чтобы крейт hello_macro использовал hello_macro_derive как зависимость и реэкспортировал код процедурного макроса. Однако то, как мы структурировали проект, позволяет программистам использовать hello_macro, даже если они не хотят функциональность derive.
Нам нужно объявить крейт hello_macro_derive как крейт процедурного макроса. Нам также понадобится функциональность из крейтов syn и quote, как вы скоро увидите, поэтому нам нужно добавить их в качестве зависимостей. Добавьте следующее в файл Cargo.toml для hello_macro_derive:
[lib]
proc-macro = true
[dependencies]
syn = "2.0"
quote = "1.0"
Чтобы начать определять процедурный макрос, поместите код из листинга 20-40 в ваш файл src/lib.rs для крейта hello_macro_derive. Обратите внимание, что этот код не скомпилируется, пока мы не добавим определение для функции impl_hello_macro.
use proc_macro::TokenStream;
use quote::quote;
#[proc_macro_derive(HelloMacro)]
pub fn hello_macro_derive(input: TokenStream) -> TokenStream {
// Строим представление кода Rust в виде синтаксического дерева
// которое мы можем обрабатывать.
let ast = syn::parse(input).unwrap();
// Строим реализацию трейта.
impl_hello_macro(&ast)
}Обратите внимание, что мы разделили код на функцию hello_macro_derive, которая отвечает за разбор TokenStream, и функцию impl_hello_macro, которая отвечает за преобразование синтаксического дерева: это делает написание процедурного макроса более удобным. Код во внешней функции (в данном случае hello_macro_derive) будет одинаковым почти для каждого крейта процедурного макроса, который вы увидите или создадите. Код, который вы указываете в теле внутренней функции (в данном случае impl_hello_macro), будет отличаться в зависимости от назначения вашего процедурного макроса.
Мы представили три новых крейта: proc_macro, syn и quote. Крейт proc_macro поставляется с Rust, поэтому нам не нужно было добавлять его в зависимости в Cargo.toml. Крейт proc_macro — это API компилятора, который позволяет нам читать и манипулировать кодом на Rust из нашего кода.
Крейт syn разбирает код на Rust из строки в структуру данных, с которой мы можем выполнять операции. Крейт quote превращает структуры данных syn обратно в код на Rust. Эти крейты значительно упрощают разбор любого вида кода на Rust, с которым мы могли бы захотеть работать: написание полного парсера для кода на Rust — непростая задача.
Функция hello_macro_derive будет вызываться, когда пользователь нашей библиотеки указывает #[derive(HelloMacro)] для типа. Это возможно, потому что мы аннотировали функцию hello_macro_derive здесь с помощью proc_macro_derive и указали имя HelloMacro, которое соответствует имени нашего трейта; это соглашение, которого придерживается большинство процедурных макросов.
Функция hello_macro_derive сначала преобразует input из TokenStream в структуру данных, которую мы затем можем интерпретировать и выполнять операции над ней. Здесь в игру вступает syn. Функция parse в syn принимает TokenStream и возвращает структуру DeriveInput, представляющую разобранный код на Rust. Листинг 20-41 показывает соответствующие части структуры DeriveInput, которые мы получаем при разборе строки struct Pancakes;.
DeriveInput {
// --snip--
ident: Ident {
ident: "Pancakes",
span: #0 bytes(95..103)
},
data: Struct(
DataStruct {
struct_token: Struct,
fields: Unit,
semi_token: Some(
Semi
)
}
)
}DeriveInput, который мы получаем при разборе кода с атрибутом макроса из листинга 20-37Поля этой структуры показывают, что код на Rust, который мы разобрали, — это unit-структура с ident (identifier, то есть именем) Pancakes. В этой структуре есть больше полей для описания всевозможного кода на Rust; см. документацию syn для DeriveInput для получения дополнительной информации.
Скоро мы определим функцию impl_hello_macro, где мы будем строить новый код на Rust, который хотим включить. Но прежде чем мы это сделаем, обратите внимание, что вывод для нашего макроса derive также является TokenStream. Возвращаемый TokenStream добавляется к коду, который пишут пользователи нашего крейта, поэтому, когда они компилируют свой крейт, они получат дополнительную функциональность, которую мы предоставляем в изменённом TokenStream.
Возможно, вы заметили, что мы вызываем unwrap, чтобы заставить функцию hello_macro_derive вызвать панику, если вызов функции syn::parse завершится неудачей. Это необходимо, чтобы наш процедурный макрос паниковал при ошибках, потому что функции proc_macro_derive должны возвращать TokenStream, а не Result, чтобы соответствовать API процедурных макросов. Мы упростили этот пример, используя unwrap; в production-коде вы должны предоставлять более конкретные сообщения об ошибках о том, что пошло не так, используя panic! или expect.
Теперь, когда у нас есть код для преобразования аннотированного кода на Rust из TokenStream в экземпляр DeriveInput, давайте сгенерируем код, реализующий трейт HelloMacro для аннотированного типа, как показано в листинге 20-42.
use proc_macro::TokenStream;
use quote::quote;
#[proc_macro_derive(HelloMacro)]
pub fn hello_macro_derive(input: TokenStream) -> TokenStream {
// Строим представление кода Rust в виде синтаксического дерева
// которое мы можем обрабатывать
let ast = syn::parse(input).unwrap();
// Строим реализацию трейта
impl_hello_macro(&ast)
}
fn impl_hello_macro(ast: &syn::DeriveInput) -> TokenStream {
let name = &ast.ident;
let generated = quote! {
impl HelloMacro for #name {
fn hello_macro() {
println!("Hello, Macro! My name is {}!", stringify!(#name));
}
}
};
generated.into()
}HelloMacro с использованием разобранного кода на RustМы получаем экземпляр структуры Ident, содержащий имя (идентификатор) аннотированного типа, используя ast.ident. Структура в листинге 20-41 показывает, что когда мы запускаем функцию impl_hello_macro на коде из листинга 20-37, ident, который мы получим, будет иметь поле ident со значением "Pancakes". Таким образом, переменная name в листинге 20-42 будет содержать экземпляр структуры Ident, который при печати будет строкой "Pancakes", именем структуры из листинга 20-37.
Макрос quote! позволяет нам определить код на Rust, который мы хотим вернуть. Компилятор ожидает нечто отличное от прямого результата выполнения макроса quote!, поэтому нам нужно преобразовать его в TokenStream. Мы делаем это, вызывая метод into, который потребляет это промежуточное представление и возвращает значение требуемого типа TokenStream.
Макрос quote! также предоставляет некоторые очень крутые механизмы шаблонизации: мы можем ввести #name, и quote! заменит его значением в переменной name. Вы даже можете сделать некоторое повторение, аналогичное тому, как работают обычные макросы. Ознакомьтесь с документацией крейта quote для подробного введения.
Мы хотим, чтобы наш процедурный макрос генерировал реализацию нашего трейта HelloMacro для типа, который аннотировал пользователь, что мы можем получить, используя #name. Реализация трейта имеет одну функцию hello_macro, тело которой содержит функциональность, которую мы хотим предоставить: печать Hello, Macro! My name is, а затем имя аннотированного типа.
Используемый здесь макрос stringify! встроен в Rust. Он принимает выражение Rust, например 1 + 2, и во время компиляции превращает выражение в строковый литерал, например "1 + 2". Это отличается от format! или println!, которые являются макросами, вычисляющими выражение и затем превращающими результат в String. Есть вероятность, что ввод #name может быть выражением для печати буквально, поэтому мы используем stringify!. Использование stringify! также экономит выделение памяти за счёт преобразования #name в строковый литерал во время компиляции.
На этом этапе cargo build должен успешно завершиться как в hello_macro, так и в hello_macro_derive. Давайте подключим эти крейты к коду из листинга 20-37, чтобы увидеть процедурный макрос в действии! Создайте новый бинарный проект в вашей директории projects, используя cargo new pancakes. Нам нужно добавить hello_macro и hello_macro_derive как зависимости в Cargo.toml крейта pancakes. Если вы публикуете ваши версии hello_macro и hello_macro_derive на crates.io, они были бы обычными зависимостями; если нет, вы можете указать их как path-зависимости следующим образом:
[dependencies]
hello_macro = { path = "../hello_macro" }
hello_macro_derive = { path = "../hello_macro/hello_macro_derive" }
Поместите код из листинга 20-37 в src/main.rs и запустите cargo run: он должен напечатать Hello, Macro! My name is Pancakes!. Реализация трейта HelloMacro из процедурного макроса была включена без необходимости крейту pancakes реализовывать её; #[derive(HelloMacro)] добавил реализацию трейта.
Далее давайте исследуем, чем другие виды процедурных макросов отличаются от пользовательских макросов derive.
Атрибутоподобные макросы
Атрибутоподобные макросы похожи на пользовательские макросы derive, но вместо генерации кода для атрибута derive они позволяют создавать новые атрибуты. Они также более гибкие: derive работает только для структур и перечислений; атрибуты можно применять и к другим элементам, например к функциям. Вот пример использования атрибутоподобного макроса. Допустим, у вас есть атрибут под названием route, который аннотирует функции при использовании веб-фреймворка:
#[route(GET, "/")]
fn index() {Этот атрибут #[route] был бы определён фреймворком как процедурный макрос. Сигнатура функции определения макроса выглядела бы так:
#[proc_macro_attribute]
pub fn route(attr: TokenStream, item: TokenStream) -> TokenStream {Здесь у нас два параметра типа TokenStream. Первый — для содержимого атрибута: части GET, "/". Второй — тело элемента, к которому прикреплён атрибут: в данном случае fn index() {} и остальное тело функции.
Помимо этого, атрибутоподобные макросы работают так же, как пользовательские макросы derive: вы создаёте крейт с типом крейта proc-macro и реализуете функцию, которая генерирует нужный вам код!
Функционально-подобные макросы
Функционально-подобные макросы определяют макросы, которые выглядят как вызовы функций. Подобно макросам macro_rules!, они более гибкие, чем функции; например, они могут принимать неизвестное количество аргументов. Однако макросы macro_rules! можно определять только с использованием match-подобного синтаксиса, который мы обсуждали в разделе «Декларативные макросы для общего метапрограммирования» ранее. Функционально-подобные макросы принимают параметр TokenStream, и их определение манипулирует этим TokenStream с использованием кода на Rust, как это делают два других вида процедурных макросов. Пример функционально-подобного макроса — макрос sql!, который мог бы вызываться так:
let sql = sql!(SELECT * FROM posts WHERE id=1);Этот макрос разбирал бы SQL-выражение внутри него и проверял, что оно синтаксически корректно, что является гораздо более сложной обработкой, чем может сделать макрос macro_rules!. Макрос sql! был бы определён так:
#[proc_macro]
pub fn sql(input: TokenStream) -> TokenStream {Это определение похоже на сигнатуру пользовательского макроса derive: мы получаем токены, которые находятся внутри круглых скобок, и возвращаем код, который хотели сгенерировать.
Итоги
Ух! Теперь у вас в наборе инструментов есть некоторые возможности Rust, которые вы, вероятно, не будете использовать часто, но вы будете знать, что они доступны в очень специфических обстоятельствах. Мы представили несколько сложных тем, чтобы, когда вы столкнётесь с ними в подсказках сообщений об ошибках или в чужом коде, вы могли распознать эти концепции и синтаксис. Используйте эту главу как справочник, который направит вас к решениям.
Далее мы применим на практике всё, что обсуждали на протяжении всей книги, и сделаем ещё один проект!
Финальный проект: создание многопоточного веб-сервера
Финальный проект: создание многопоточного веб-сервера
Это был долгий путь, но мы дошли до конца книги. В этой главе мы вместе создадим ещё один проект, чтобы продемонстрировать некоторые концепции, которые мы рассмотрели в последних главах, а также повторить некоторые более ранние уроки.
В качестве финального проекта мы создадим веб-сервер, который говорит «Hello!» и выглядит как на рисунке 21-1 в веб-браузере.
Вот наш план по созданию веб-сервера:
- Немного узнать о TCP и HTTP.
- Слушать TCP-соединения на сокете.
- Разбирать небольшое количество HTTP-запросов.
- Создавать правильный HTTP-ответ.
- Улучшить пропускную способность нашего сервера с помощью пула потоков.
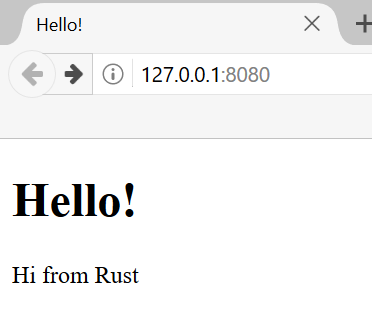
Рисунок 21-1: Наш финальный совместный проект
Прежде чем мы начнём, следует упомянуть две детали. Во-первых, метод, который мы будем использовать, не будет лучшим способом создания веб-сервера на Rust. Участники сообщества опубликовали ряд готовых к производству крейтов, доступных на crates.io, которые предоставляют более полные реализации веб-серверов и пулов потоков, чем мы построим. Однако наше намерение в этой главе — помочь вам учиться, а не выбрать лёгкий путь. Поскольку Rust — это системный язык программирования, мы можем выбирать уровень абстракции, с которым хотим работать, и можем спускаться на более низкий уровень, чем это возможно или практично в других языках.
Во-вторых, мы не будем использовать async и await здесь. Создание пула потоков — достаточно большая задача сама по себе, без добавления создания асинхронного рантайма! Однако мы отметим, как async и await могли бы быть применимы к некоторым из тех же проблем, которые мы увидим в этой главе. В конечном счёте, как мы отмечали в главе 17, многие асинхронные рантаймы используют пулы потоков для управления своей работой.
Таким образом, мы напишем базовый HTTP-сервер и пул потоков вручную, чтобы вы могли изучить общие идеи и методы, лежащие в основе крейтов, которые вы, возможно, будете использовать в будущем.
Создание однопоточного веб-сервера
Создание однопоточного веб-сервера
Мы начнём с того, что заставим работать однопоточный веб-сервер. Прежде чем начать, давайте кратко рассмотрим протоколы, участвующие в создании веб-серверов. Детали этих протоколов выходят за рамки этой книги, но краткий обзор даст вам необходимую информацию.
Два основных протокола, участвующих в веб-серверах, — это протокол передачи гипертекста (HTTP) и протокол управления передачей (TCP). Оба протокола являются протоколами запрос-ответ, что означает, что клиент инициирует запросы, а сервер слушает запросы и предоставляет ответ клиенту. Содержимое этих запросов и ответов определяется протоколами.
TCP — это протокол более низкого уровня, который описывает детали того, как информация передаётся от одного сервера к другому, но не определяет, что это за информация. HTTP строится поверх TCP, определяя содержимое запросов и ответов. Технически возможно использовать HTTP с другими протоколами, но в подавляющем большинстве случаев HTTP отправляет свои данные через TCP. Мы будем работать с необработанными байтами TCP- и HTTP-запросов и ответов.
Прослушивание TCP-соединения
Нашему веб-серверу нужно прослушивать TCP-соединение, поэтому это первая часть, над которой мы будем работать. Стандартная библиотека предлагает модуль std::net, который позволяет нам это делать. Давайте создадим новый проект обычным образом:
$ cargo new hello
Created binary (application) `hello` project
$ cd hello
Теперь введите код из листинга 21-1 в src/main.rs для начала. Этот код будет слушать локальный адрес 127.0.0.1:7878 на предмет входящих TCP-потоков. Когда он получает входящий поток, он печатает Connection established!.
use std::net::TcpListener;
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
println!("Connection established!");
}
}Используя TcpListener, мы можем прослушивать TCP-соединения по адресу 127.0.0.1:7878. В адресе часть перед двоеточием — это IP-адрес, представляющий ваш компьютер (это одинаково на каждом компьютере и не представляет конкретно компьютер авторов), а 7878 — это порт. Мы выбрали этот порт по двум причинам: HTTP обычно не принимается на этом порту, поэтому наш сервер вряд ли будет конфликтовать с любым другим веб-сервером, который может быть запущен на вашей машине, и 7878 — это rust, набранный на телефоне.
Функция bind в этом сценарии работает как функция new в том смысле, что она возвращает новый экземпляр TcpListener. Функция называется bind, потому что в сетевых технологиях подключение к порту для прослушивания известно как «привязка к порту».
Функция bind возвращает Result<T, E>, что указывает на возможность неудачной привязки, например, если мы запустили два экземпляра нашей программы и, таким образом, имели две программы, прослушивающие один и тот же порт. Поскольку мы пишем базовый сервер только в учебных целях, мы не будем беспокоиться об обработке подобных ошибок; вместо этого мы используем unwrap, чтобы остановить программу в случае ошибок.
Метод incoming на TcpListener возвращает итератор, который даёт нам последовательность потоков (точнее, потоков типа TcpStream). Один поток представляет открытое соединение между клиентом и сервером. Соединение — это название полного процесса запроса и ответа, в котором клиент подключается к серверу, сервер генерирует ответ, и сервер закрывает соединение. Таким образом, мы будем читать из TcpStream, чтобы увидеть, что отправил клиент, а затем записывать наш ответ в поток, чтобы отправить данные обратно клиенту. В целом, этот цикл for будет обрабатывать каждое соединение по очереди и создавать серию потоков для нас для обработки.
На данный момент наша обработка потока состоит из вызова unwrap, чтобы завершить нашу программу, если поток содержит какие-либо ошибки; если ошибок нет, программа печатает сообщение. Мы добавим больше функциональности для случая успеха в следующем листинге. Причина, по которой мы можем получать ошибки от метода incoming, когда клиент подключается к серверу, заключается в том, что мы на самом деле не перебираем соединения. Вместо этого мы перебираем попытки соединения. Соединение может быть неуспешным по ряду причин, многие из которых зависят от операционной системы. Например, многие операционные системы имеют ограничение на количество одновременно открытых соединений, которые они могут поддерживать; новые попытки соединения сверх этого числа будут производить ошибку до тех пор, пока некоторые из открытых соединений не будут закрыты.
Давайте попробуем запустить этот код! Вызовите cargo run в терминале, а затем загрузите 127.0.0.1:7878 в веб-браузере. Браузер должен показать сообщение об ошибке, такое как «Connection reset», потому что сервер в настоящее время не отправляет никаких данных. Но когда вы посмотрите на свой терминал, вы должны увидеть несколько сообщений, которые были напечатаны, когда браузер подключился к серверу!
Running `target/debug/hello`
Connection established!
Connection established!
Connection established!
Иногда вы увидите несколько сообщений, напечатанных для одного запроса браузера; причина может быть в том, что браузер делает запрос страницы, а также запрос других ресурсов, таких как значок favicon.ico, который появляется на вкладке браузера.
Также может быть, что браузер пытается подключиться к серверу несколько раз, потому что сервер не отвечает никакими данными. Когда stream выходит из области видимости и отбрасывается в конце цикла, соединение закрывается в рамках реализации drop. Браузеры иногда справляются с закрытыми соединениями, повторяя попытки, потому что проблема может быть временной.
Браузеры также иногда открывают несколько соединений к серверу, не отправляя никаких запросов, чтобы, если они действительно позже отправят запросы, эти запросы могли происходить быстрее. Когда это происходит, наш сервер увидит каждое соединение, независимо от того, есть ли какие-либо запросы по этому соединению. Многие версии браузеров на основе Chrome делают это, например; вы можете отключить эту оптимизацию, используя режим приватного просмотра или другой браузер.
Важным фактором является то, что мы успешно получили дескриптор TCP-соединения!
Не забудьте остановить программу, нажав ctrl-C, когда вы закончите запускать конкретную версию кода. Затем перезапустите программу, вызвав команду cargo run после того, как вы внесли каждый набор изменений в код, чтобы убедиться, что вы запускаете самую новую версию кода.
Чтение запроса
Давайте реализуем функциональность чтения запроса от браузера! Чтобы разделить заботы о первом получении соединения и затем выполнении какого-либо действия с соединением, мы начнём новую функцию для обработки соединений. В этой новой функции handle_connection мы будем читать данные из TCP-потока и печатать их, чтобы мы могли видеть данные, отправляемые от браузера. Измените код так, чтобы он выглядел как в листинге 21-2.
use std::{
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
println!("Request: {http_request:#?}");
}TcpStream и печать данныхМы вводим в область видимости std::io::BufReader и std::io::prelude, чтобы получить доступ к трейтам и типам, которые позволяют нам читать из потока и писать в него. В цикле for в функции main вместо печати сообщения о том, что мы установили соединение, мы теперь вызываем новую функцию handle_connection и передаём ей stream.
В функции handle_connection мы создаём новый экземпляр BufReader, который оборачивает ссылку на stream. BufReader добавляет буферизацию, управляя вызовами методов трейта std::io::Read за нас.
Мы создаём переменную с именем http_request для сбора строк запроса, который браузер отправляет нашему серверу. Мы указываем, что хотим собрать эти строки в вектор, добавив аннотацию типа Vec<_>.
BufReader реализует трейт std::io::BufRead, который предоставляет метод lines. Метод lines возвращает итератор из Result<String, std::io::Error>, разбивая поток данных каждый раз, когда он видит байт новой строки. Чтобы получить каждую String, мы применяем map и unwrap к каждому Result. Result может быть ошибкой, если данные не являются допустимым UTF-8 или если была проблема при чтении из потока. Опять же, производственная программа должна обрабатывать эти ошибки более изящно, но мы выбираем остановку программы в случае ошибки для простоты.
Браузер сигнализирует об окончании HTTP-запроса, отправляя два символа новой строки подряд, поэтому чтобы получить один запрос из потока, мы берём строки, пока не получим строку, которая является пустой строкой. Как только мы собрали строки в вектор, мы печатаем их с использованием красивого отладочного форматирования, чтобы мы могли взглянуть на инструкции, которые веб-браузер отправляет нашему серверу.
Давайте попробуем этот код! Запустите программу и снова сделайте запрос в веб-браузере. Обратите внимание, что мы по-прежнему получим страницу с ошибкой в браузере, но вывод нашей программы в терминале теперь будет выглядеть примерно так:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.42s
Running `target/debug/hello`
Request: [
"GET / HTTP/1.1",
"Host: 127.0.0.1:7878",
"User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.15; rv:99.0) Gecko/20100101 Firefox/99.0",
"Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
"Accept-Language: en-US,en;q=0.5",
"Accept-Encoding: gzip, deflate, br",
"DNT: 1",
"Connection: keep-alive",
"Upgrade-Insecure-Requests: 1",
"Sec-Fetch-Dest: document",
"Sec-Fetch-Mode: navigate",
"Sec-Fetch-Site: none",
"Sec-Fetch-User: ?1",
"Cache-Control: max-age=0",
]
В зависимости от вашего браузера вы можете получить несколько иной вывод. Теперь, когда мы печатаем данные запроса, мы можем увидеть, почему мы получаем несколько соединений от одного запроса браузера, посмотрев на путь после GET в первой строке запроса. Если повторные соединения все запрашивают /, мы знаем, что браузер пытается получить / повторно, потому что он не получает ответа от нашей программы.
Давайте разберём эти данные запроса, чтобы понять, что браузер просит у нашей программы.
Более подробный взгляд на HTTP-запрос
HTTP — это текстовый протокол, и запрос имеет следующий формат:
Метод Request-URI HTTP-Version CRLF
заголовки CRLF
тело-сообщения
Первая строка — это строка запроса, которая содержит информацию о том, что запрашивает клиент. Первая часть строки запроса указывает используемый метод, такой как GET или POST, который описывает, как клиент делает этот запрос. Наш клиент использовал запрос GET, что означает, что он запрашивает информацию.
Следующая часть строки запроса — это /, которая указывает универсальный идентификатор ресурса (URI), который запрашивает клиент: URI почти, но не совсем, совпадает с универсальным локатором ресурса (URL). Различие между URI и URL не важно для наших целей в этой главе, но спецификация HTTP использует термин URI, поэтому мы можем мысленно заменить URL на URI здесь.
Последняя часть — это версия HTTP, которую использует клиент, и затем строка запроса заканчивается последовательностью CRLF. (CRLF означает возврат каретки и перевод строки, которые являются терминами из дней пишущих машинок!) Последовательность CRLF также может быть записана как \r\n, где \r — это возврат каретки, а \n — это перевод строки. Последовательность CRLF отделяет строку запроса от остальных данных запроса. Обратите внимание, что когда CRLF печатается, мы видим начало новой строки, а не \r\n.
Глядя на данные строки запроса, которые мы получили при запуске нашей программы, мы видим, что GET — это метод, / — это URI запроса, а HTTP/1.1 — это версия.
После строки запроса остальные строки, начинающиеся с Host: и далее, — это заголовки. Запросы GET не имеют тела.
Попробуйте сделать запрос из другого браузера или запросить другой адрес, например 127.0.0.1:7878/test, чтобы увидеть, как изменяются данные запроса.
Теперь, когда мы знаем, что запрашивает браузер, давайте отправим обратно некоторые данные!
Запись ответа
Мы собираемся реализовать отправку данных в ответ на запрос клиента. Ответы имеют следующий формат:
HTTP-Version Status-Code Reason-Phrase CRLF
заголовки CRLF
тело-сообщения
Первая строка — это строка статуса, которая содержит версию HTTP, используемую в ответе, числовой код состояния, который обобщает результат запроса, и фразу причины, которая обеспечивает текстовое описание кода состояния. После последовательности CRLF идут любые заголовки, ещё одна последовательность CRLF и тело ответа.
Вот пример ответа, который использует версию HTTP 1.1 и имеет код состояния 200, фразу причины OK, без заголовков и без тела:
HTTP/1.1 200 OK\r\n\r\n
Код состояния 200 — это стандартный успешный ответ. Текст — это крошечный успешный HTTP-ответ. Давайте запишем это в поток как наш ответ на успешный запрос! Из функции handle_connection удалите println!, который печатал данные запроса, и замените его кодом из листинга 21-3.
use std::{
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
let response = "HTTP/1.1 200 OK\r\n\r\n";
stream.write_all(response.as_bytes()).unwrap();
}Первая новая строка определяет переменную response, которая содержит данные сообщения об успехе. Затем мы вызываем as_bytes для нашего response, чтобы преобразовать строковые данные в байты. Метод write_all на stream принимает &[u8] и отправляет эти байты напрямую по соединению. Поскольку операция write_all может завершиться неудачно, мы используем unwrap для любого результата ошибки, как и раньше. Опять же, в реальном приложении вы бы добавили здесь обработку ошибок.
С этими изменениями давайте запустим наш код и сделаем запрос. Мы больше не печатаем никаких данных в терминал, поэтому мы не увидим никакого вывода, кроме вывода от Cargo. Когда вы загрузите 127.0.0.1:7878 в веб-браузере, вы должны получить пустую страницу вместо ошибки. Вы только что вручную закодировали получение HTTP-запроса и отправку ответа!
Возврат настоящего HTML
Давайте реализуем функциональность возврата чего-то большего, чем пустая страница. Создайте новый файл hello.html в корне каталога вашего проекта, а не в каталоге src. Вы можете ввести любой HTML, который захотите; листинг 21-4 показывает одну из возможностей.
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>Hello!</title>
</head>
<body>
<h1>Hello!</h1>
<p>Hi from Rust</p>
</body>
</html>
Это минимальный HTML5-документ с заголовком и некоторым текстом. Чтобы возвращать это с сервера при получении запроса, мы изменим handle_connection, как показано в листинге 21-5, чтобы прочитать HTML-файл, добавить его в ответ как тело и отправить.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
// --snip--
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Мы добавили fs в выражение use, чтобы ввести в область видимости модуль файловой системы стандартной библиотеки. Код для чтения содержимого файла в строку должен выглядеть знакомо; мы использовали его, когда читали содержимое файла для нашего проекта ввода-вывода в листинге 12-4.
Затем мы используем format!, чтобы добавить содержимое файла в качестве тела успешного ответа. Чтобы обеспечить действительный HTTP-ответ, мы добавляем заголовок Content-Length, который устанавливается равным размеру нашего тела ответа — в данном случае размеру hello.html.
Запустите этот код с помощью cargo run и загрузите 127.0.0.1:7878 в браузере; вы должны увидеть ваш HTML отрендеренным!
В настоящее время мы игнорируем данные запроса в http_request и просто безоговорочно отправляем обратно содержимое HTML-файла. Это означает, что если вы попытаетесь запросить 127.0.0.1:7878/something-else в браузере, вы всё равно получите обратно тот же самый HTML-ответ. На данный момент наш сервер очень ограничен и не делает того, что делают большинство веб-серверов. Мы хотим настроить наши ответы в зависимости от запроса и отправлять обратно HTML-файл только для правильно сформированного запроса к /.
Проверка запроса и выборочный ответ
Прямо сейчас наш веб-сервер будет возвращать HTML в файле независимо от того, что запросил клиент. Давайте добавим функциональность, чтобы проверить, что браузер запрашивает /, перед возвратом HTML-файла, и возвращать ошибку, если браузер запрашивает что-либо другое. Для этого нам нужно изменить handle_connection, как показано в листинге 21-6. Этот новый код проверяет содержимое полученного запроса на соответствие тому, что, как мы знаем, выглядит запрос к /, и добавляет блоки if и else для разной обработки запросов.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
// --snip--
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
if request_line == "GET / HTTP/1.1" {
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
} else {
// какой-то другой запрос
}
}Мы собираемся смотреть только на первую строку HTTP-запроса, поэтому вместо того, чтобы читать весь запрос в вектор, мы вызываем next, чтобы получить первый элемент из итератора. Первый unwrap заботится об Option и останавливает программу, если в итераторе нет элементов. Второй unwrap обрабатывает Result и имеет тот же эффект, что и unwrap, который был в map, добавленном в листинге 21-2.
Затем мы проверяем request_line, чтобы увидеть, равна ли она строке запроса GET-запроса к пути /. Если равна, блок if возвращает содержимое нашего HTML-файла.
Если request_line не равна GET-запросу к пути /, это означает, что мы получили какой-то другой запрос. Мы добавим код в блок else через мгновение, чтобы ответить на все другие запросы.
Запустите этот код сейчас и запросите 127.0.0.1:7878; вы должны получить HTML из hello.html. Если вы сделаете любой другой запрос, например 127.0.0.1:7878/something-else, вы получите ошибку соединения, подобную тем, которые вы видели при запуске кода в листинге 21-1 и листинге 21-2.
Теперь давайте добавим код из листинга 21-7 в блок else, чтобы вернуть ответ с кодом состояния 404, который сигнализирует, что содержимое для запроса не найдено. Мы также вернём немного HTML для страницы, которая будет отображена в браузере, указывая ответ конечному пользователю.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
if request_line == "GET / HTTP/1.1" {
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
// --snip--
} else {
let status_line = "HTTP/1.1 404 NOT FOUND";
let contents = fs::read_to_string("404.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
}
}Здесь наш ответ имеет строку статуса с кодом состояния 404 и фразой причины NOT FOUND. Тело ответа будет HTML в файле 404.html. Вам нужно будет создать файл 404.html рядом с hello.html для страницы ошибки; опять же, не стесняйтесь использовать любой HTML, который захотите, или используйте пример HTML в листинге 21-8.
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>Hello!</title>
</head>
<body>
<h1>Oops!</h1>
<p>Sorry, I don't know what you're asking for.</p>
</body>
</html>
С этими изменениями снова запустите ваш сервер. Запрос 127.0.0.1:7878 должен вернуть содержимое hello.html, а любой другой запрос, например 127.0.0.1:7878/foo, должен вернуть HTML ошибки из 404.html.
Рефакторинг
На данный момент блоки if и else имеют много повторений: они оба читают файлы и записывают содержимое файлов в поток. Единственные различия — это строка статуса и имя файла. Давайте сделаем код более кратким, вынеся эти различия в отдельные строки if и else, которые будут присваивать значения строки статуса и имени файла переменным; затем мы можем использовать эти переменные безусловно в коде для чтения файла и записи ответа. Листинг 21-9 показывает результирующий код после замены больших блоков if и else.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
// --snip--
fn handle_connection(mut stream: TcpStream) {
// --snip--
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = if request_line == "GET / HTTP/1.1" {
("HTTP/1.1 200 OK", "hello.html")
} else {
("HTTP/1.1 404 NOT FOUND", "404.html")
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}if и else, чтобы они содержали только код, отличающийся в этих двух случаяхТеперь блоки if и else возвращают только соответствующие значения для строки статуса и имени файла в кортеже; затем мы используем деструктуризацию, чтобы присвоить эти два значения status_line и filename с помощью шаблона в инструкции let, как обсуждалось в главе 19.
Ранее дублированный код теперь находится вне блоков if и else и использует переменные status_line и filename. Это облегчает понимание разницы между двумя случаями, а также означает, что у нас есть только одно место для обновления кода, если мы хотим изменить способ чтения файлов и записи ответов. Поведение кода в листинге 21-9 будет таким же, как в листинге 21-7.
Отлично! Теперь у нас есть простой веб-сервер примерно в 40 строках кода на Rust, который отвечает на один запрос страницей контента и отвечает на все другие запросы 404-ответом.
В настоящее время наш сервер работает в одном потоке, что означает, что он может обслуживать только один запрос за раз. Давайте рассмотрим, как это может быть проблемой, смоделировав несколько медленных запросов. Затем мы исправим это, чтобы наш сервер мог обрабатывать несколько запросов одновременно.
От однопоточного к многопоточному серверу
От однопоточного к многопоточному серверу
Сейчас сервер обрабатывает каждый запрос по очереди, что означает, что он не обработает второе соединение, пока не завершится обработка первого соединения. Если сервер получает всё больше и больше запросов, такое последовательное выполнение становится всё менее и менее оптимальным. Если сервер получает запрос, обработка которого занимает много времени, последующие запросы должны будут ждать, пока длинный запрос не завершится, даже если новые запросы могут быть обработаны быстро. Нам нужно это исправить, но сначала мы рассмотрим проблему в действии.
Имитация медленного запроса
Мы рассмотрим, как медленно обрабатываемый запрос может повлиять на другие запросы к нашей текущей реализации сервера. Листинг 21-10 реализует обработку запроса к /sleep с имитацией медленного ответа, которая заставит сервер заснуть на пять секунд перед ответом.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
// --snip--
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
// --snip--
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
// --snip--
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Мы переключились с if на match, поскольку теперь у нас три случая. Нам нужно
явно сопоставлять со срезом request_line, чтобы сопоставлять с
строковыми литеральными значениями; match не выполняет автоматическое заимствование и
разыменование, как это делает метод равенства.
Первая ветвь такая же, как блок if из листинга 21-9. Вторая ветвь
соответствует запросу к /sleep. Когда этот запрос получен, сервер будет
спать пять секунд перед отображением успешной HTML-страницы. Третья ветвь
такая же, как блок else из листинга 21-9.
Видно, насколько примитивен наш сервер: настоящие библиотеки обрабатывали бы распознавание нескольких запросов гораздо менее многословным способом!
Запустите сервер с помощью cargo run. Затем откройте два окна браузера: одно для
http://127.0.0.1:7878, а другое для http://127.0.0.1:7878/sleep. Если
ввести URI / несколько раз, как и раньше, он ответит быстро. Но если
ввести /sleep, а затем загрузить /, вы увидите, что / ждёт, пока sleep
проспит все свои пять секунд перед загрузкой.
Есть несколько методов, которые мы могли бы использовать, чтобы избежать накопления запросов за медленным запросом, включая использование async, как мы делали в главе 17; тот, который мы реализуем, — это пул потоков.
Повышение пропускной способности с помощью пула потоков
Пул потоков — это группа порождённых потоков, которые готовы и ожидают обработки задачи. Когда программа получает новую задачу, она назначает один из потоков в пуле задаче, и этот поток обработает задачу. Оставшиеся потоки в пуле доступны для обработки любых других задач, которые поступят, пока первый поток обрабатывает. Когда первый поток завершает обработку своей задачи, он возвращается в пул простаивающих потоков, готовый обработать новую задачу. Пул потоков позволяет обрабатывать соединения одновременно, повышая пропускную способность сервера.
Мы ограничим количество потоков в пуле небольшим числом, чтобы защитить нас от DoS-атак; если бы наша программа создавала новый поток для каждого запроса по мере поступления, кто-то, сделавший 10 миллионов запросов к нашему серверу, мог бы нанести ущерб, израсходовав все ресурсы сервера и остановив обработку запросов до полной остановки.
Вместо порождения неограниченного числа потоков мы будем иметь фиксированное количество
потоков, ожидающих в пуле. Поступающие запросы отправляются в пул на
обработку. Пул будет поддерживать очередь входящих запросов. Каждый из
потоков в пуле извлекает запрос из этой очереди, обрабатывает запрос,
а затем запрашивает у очереди ещё один запрос. С такой конструкцией мы можем обрабатывать
до N запросов одновременно, где N — количество потоков. Если каждый
поток отвечает на длительный запрос, последующие запросы всё ещё могут
накапливаться в очереди, но мы увеличили количество длительных запросов,
которые можем обработать, прежде чем достигнем этой точки.
Этот приём — лишь один из многих способов повысить пропускную способность веб-сервера. Другие варианты, которые можно исследовать, — модель fork/join, однопоточная модель асинхронного ввода-вывода и многопоточная модель асинхронного ввода-вывода. Если интересна эта тема, можно почитать больше о других решениях и попробовать реализовать их; с таким низкоуровневым языком, как Rust, все эти варианты возможны.
Прежде чем начать реализацию пула потоков, давайте поговорим о том, как должно выглядеть использование пула. Когда пытаешься проектировать код, написание клиентского интерфейса первым может помочь направить проект. Напишите API кода так, чтобы он был структурирован так, как вы хотите его вызывать; затем реализуйте функциональность внутри этой структуры, а не реализуйте функциональность, а затем проектируйте публичный API.
Подобно тому, как мы использовали разработку через тестирование в проекте в главе 12, здесь мы будем использовать разработку через компилятор. Мы напишем код, который вызывает функции, которые мы хотим, а затем посмотрим на ошибки компилятора, чтобы определить, что мы должны изменить дальше, чтобы код заработал. Прежде чем это сделать, однако, мы рассмотрим приём, который мы не будем использовать в качестве отправной точки.
Порождение потока для каждого запроса
Сначала давайте рассмотрим, как мог бы выглядеть наш код, если бы он создавал новый поток для каждого соединения. Как упоминалось ранее, это не наш окончательный план из-за проблем с потенциальным порождением неограниченного числа потоков, но это отправная точка, чтобы сначала получить работающий многопоточный сервер. Затем мы добавим пул потоков в качестве улучшения, и контраст между двумя решениями будет проще.
Листинг 21-11 показывает изменения, которые нужно внести в main, чтобы порождать новый поток
для обработки каждого потока в цикле for.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
thread::spawn(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Как вы узнали в главе 16, thread::spawn создаст новый поток и затем
запустит код в замыкании в новом потоке. Если запустить этот код и загрузить
/sleep в браузере, а затем / в двух других вкладках браузера, вы действительно увидите,
что запросы к / не должны ждать завершения /sleep. Однако, как
мы упоминали, это в конечном итоге перегрузит систему, потому что вы будете создавать
новые потоки без каких-либо ограничений.
Вы также можете вспомнить из главы 17, что это как раз та ситуация, где async и await действительно блистают! Держите это в уме, пока мы строим пул потоков, и подумайте о том, как всё выглядело бы иначе или так же с async.
Создание конечного числа потоков
Мы хотим, чтобы наш пул потоков работал похожим, привычным образом, чтобы переход
с потоков на пул потоков не требовал больших изменений в коде, использующем наш API.
Листинг 21-12 показывает гипотетический интерфейс для структуры ThreadPool,
которую мы хотим использовать вместо thread::spawn.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming() {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}ThreadPoolМы используем ThreadPool::new для создания нового пула потоков с настраиваемым количеством
потоков, в данном случае четырьмя. Затем в цикле for pool.execute имеет
интерфейс, похожий на thread::spawn, в том смысле, что он принимает замыкание, которое пул
должен выполнить для каждого потока. Нам нужно реализовать pool.execute так, чтобы
он принимал замыкание и передавал его потоку в пуле для выполнения. Этот код пока
не компилируется, но мы попробуем, чтобы компилятор направил нас в том, как его исправить.
Построение ThreadPool с помощью разработки через компилятор
Внесите изменения из листинга 21-12 в src/main.rs, а затем давайте используем
ошибки компилятора от cargo check для управления нашей разработкой. Вот первая
ошибка, которую мы получаем:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0433]: cannot find type `ThreadPool` in this scope
--> src/main.rs:11:16
|
11 | let pool = ThreadPool::new(4);
| ^^^^^^^^^^ use of undeclared type `ThreadPool`
For more information about this error, try `rustc --explain E0433`.
error: could not compile `hello` (bin "hello") due to 1 previous error
Отлично! Эта ошибка сообщает нам, что нам нужен тип или модуль ThreadPool, поэтому мы
создадим его сейчас. Наша реализация ThreadPool будет независима от того, какую работу
выполняет наш веб-сервер. Поэтому давайте переключим крейт hello с
бинарного крейта на библиотечный крейт, чтобы разместить нашу реализацию ThreadPool. После
того как мы переключимся на библиотечный крейт, мы также могли бы использовать отдельную библиотеку
пула потоков для любой работы, которую мы хотим выполнять с помощью пула потоков, не только для обслуживания
веб-запросов.
Создайте файл src/lib.rs, содержащий следующее, что является простейшим
определением структуры ThreadPool, которое мы можем иметь пока:
pub struct ThreadPool;Затем отредактируйте файл main.rs, чтобы ввести ThreadPool в область видимости из библиотечного
крейта, добавив следующий код в начало src/main.rs:
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming() {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Этот код всё ещё не будет работать, но давайте проверим его снова, чтобы получить следующую ошибку, которую нам нужно устранить:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0599]: no associated function or constant named `new` found for struct `ThreadPool` in the current scope
--> src/main.rs:12:28
|
12 | let pool = ThreadPool::new(4);
| ^^^ associated function or constant not found in `ThreadPool`
For more information about this error, try `rustc --explain E0599`.
error: could not compile `hello` (bin "hello") due to 1 previous error
Эта ошибка указывает, что далее нам нужно создать связанную функцию с именем
new для ThreadPool. Мы также знаем, что new должен иметь один параметр,
который может принимать 4 в качестве аргумента, и должен возвращать экземпляр ThreadPool.
Давайте реализуем простейшую функцию new, которая будет иметь эти
характеристики:
pub struct ThreadPool;
impl ThreadPool {
pub fn new(size: usize) -> ThreadPool {
ThreadPool
}
}Мы выбрали usize в качестве типа параметра size, потому что знаем, что
отрицательное количество потоков не имеет смысла. Мы также знаем, что будем использовать это
4 как количество элементов в коллекции потоков, для чего и предназначен тип
usize, как обсуждалось в разделе «Целочисленные типы» в главе 3.
Давайте проверим код снова:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0599]: no method named `execute` found for struct `ThreadPool` in the current scope
--> src/main.rs:17:14
|
17 | pool.execute(|| {
| -----^^^^^^^ method not found in `ThreadPool`
For more information about this error, try `rustc --explain E0599`.
error: could not compile `hello` (bin "hello") due to 1 previous error
Теперь ошибка возникает, потому что у нас нет метода execute у ThreadPool.
Вспомните из раздела «Создание конечного числа
потоков», что мы
решили, что наш пул потоков должен иметь интерфейс, похожий на thread::spawn. Кроме
того, мы реализуем функцию execute так, чтобы она принимала замыкание,
которое ей дано, и передавала его простаивающему потоку в пуле для выполнения.
Мы определим метод execute у ThreadPool, который принимает замыкание в качестве
параметра. Вспомните из раздела «Перемещение захваченных значений из
замыканий» в главе 13, что мы можем
принимать замыкания в качестве параметров с тремя различными трейтами: Fn, FnMut и
FnOnce. Нам нужно решить, какой вид замыкания использовать здесь. Мы знаем, что в итоге
сделаем что-то похожее на реализацию thread::spawn из стандартной библиотеки, поэтому можем посмотреть, какие ограничения
имеет сигнатура thread::spawn на своём параметре. Документация показывает нам следующее:
pub fn spawn<F, T>(f: F) -> JoinHandle<T>
where
F: FnOnce() -> T,
F: Send + 'static,
T: Send + 'static,Здесь нас интересует параметр типа F; параметр типа T
связан с возвращаемым значением, и нас это не интересует. Мы
видим, что spawn использует FnOnce в качестве ограничения трейта для F. Это, вероятно,
то, что нам тоже нужно, потому что мы в конечном итоге передадим аргумент, полученный в
execute, в spawn. Мы можем быть ещё более уверены, что FnOnce — это трейт, который
нам нужен, потому что поток для выполнения запроса выполнит замыкание этого
запроса только один раз, что соответствует Once в FnOnce.
Параметр типа F также имеет ограничение трейта Send и ограничение времени жизни
'static, которые полезны в нашей ситуации: нам нужен Send для передачи
замыкания из одного потока в другой, а 'static — потому что мы не знаем, сколько времени
поток потратит на выполнение. Давайте создадим метод execute у
ThreadPool, который будет принимать обобщённый параметр типа F с этими ограничениями:
pub struct ThreadPool;
impl ThreadPool {
// --snip--
pub fn new(size: usize) -> ThreadPool {
ThreadPool
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}Мы по-прежнему используем () после FnOnce, потому что этот FnOnce представляет замыкание,
которое не принимает параметров и возвращает единичный тип (). Как и в определениях функций,
тип возвращаемого значения можно опустить из сигнатуры, но даже если у нас
нет параметров, нам всё равно нужны круглые скобки.
Опять же, это простейшая реализация метода execute: он
ничего не делает, но мы лишь пытаемся заставить наш код скомпилироваться. Давайте проверим его снова:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.24s
Он компилируется! Но обратите внимание, что если попробовать cargo run и сделать запрос в
браузере, вы увидите ошибки в браузере, которые мы видели в начале
главы. Наша библиотека на самом деле ещё не вызывает замыкание, переданное в execute!
Примечание: поговорка, которую можно услышать о языках со строгими компиляторами, таких как Haskell и Rust: «Если код компилируется, он работает». Но эта поговорка не универсально верна. Наш проект компилируется, но не делает абсолютно ничего! Если бы мы строили настоящий, полный проект, это было бы хорошее время начать писать модульные тесты, чтобы проверить, что код компилируется и имеет поведение, которое мы хотим.
Подумайте: что было бы иначе, если бы мы собирались выполнять фьючерс вместо замыкания?
Проверка количества потоков в new
Мы ничего не делаем с параметрами new и execute. Давайте
реализуем тела этих функций с желаемым поведением. Для начала
подумаем о new. Ранее мы выбрали беззнаковый тип для параметра size, потому что пул с
отрицательным количеством потоков не имеет смысла. Однако пул с нулём потоков тоже
не имеет смысла, а ноль — вполне допустимый usize. Мы добавим код, чтобы проверить, что
size больше нуля, прежде чем вернуть экземпляр ThreadPool, и заставим программу
паниковать, если она получит ноль, используя макрос assert!, как показано в листинге 21-13.
pub struct ThreadPool;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
ThreadPool
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}ThreadPool::new для паники, если size равен нулюМы также добавили документацию для нашего ThreadPool с помощью doc-комментариев.
Обратите внимание, что мы следовали хорошим практикам документирования, добавив раздел, в котором
указываются ситуации, в которых наша функция может запаниковать, как обсуждалось в
главе 14. Попробуйте запустить cargo doc --open и щёлкнуть на структуре ThreadPool,
чтобы увидеть, как выглядит сгенерированная документация для new!
Вместо добавления макроса assert!, как мы сделали здесь, мы могли бы изменить new
на build и вернуть Result, как мы делали с Config::build в проекте ввода-вывода
в листинге 12-9. Но мы решили в данном случае, что попытка создать
пул потоков без потоков должна быть невосстановимой ошибкой. Если вы
чувствуете амбиции, попробуйте написать функцию с именем build со следующей
сигнатурой, чтобы сравнить её с функцией new:
pub fn build(size: usize) -> Result<ThreadPool, PoolCreationError> {Создание места для хранения потоков
Теперь, когда у нас есть способ узнать, что у нас есть допустимое количество потоков для хранения в
пуле, мы можем создать эти потоки и сохранить их в структуре ThreadPool
перед возвратом структуры. Но как «сохранить» поток? Давайте ещё раз
взглянем на сигнатуру thread::spawn:
pub fn spawn<F, T>(f: F) -> JoinHandle<T>
where
F: FnOnce() -> T,
F: Send + 'static,
T: Send + 'static,Функция spawn возвращает JoinHandle<T>, где T — тип, который возвращает
замыкание. Давайте попробуем использовать JoinHandle и посмотрим, что получится. В нашем
случае замыкания, которые мы передаём в пул потоков, будут обрабатывать соединение
и ничего не возвращать, поэтому T будет единичным типом ().
Код в листинге 21-14 скомпилируется, но пока не создаёт никаких потоков.
Мы изменили определение ThreadPool, чтобы оно содержало вектор
экземпляров thread::JoinHandle<()>, инициализировали вектор с ёмкостью
size, настроили цикл for, который выполнит некоторый код для создания потоков, и
вернули экземпляр ThreadPool, содержащий их.
use std::thread;
pub struct ThreadPool {
threads: Vec<thread::JoinHandle<()>>,
}
impl ThreadPool {
// --snip--
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let mut threads = Vec::with_capacity(size);
for _ in 0..size {
// создаём несколько потоков и сохраняем их в векторе
}
ThreadPool { threads }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}ThreadPool для хранения потоковМы ввели std::thread в область видимости в библиотечном крейте, потому что
используем thread::JoinHandle в качестве типа элементов вектора в
ThreadPool.
Получив допустимый размер, наш ThreadPool создаёт новый вектор, который может
содержать size элементов. Функция with_capacity выполняет ту же задачу, что и
Vec::new, но с важным отличием: она предварительно выделяет место в
векторе. Поскольку мы знаем, что нам нужно сохранить size элементов в векторе, эта
предварительная аллокация немного эффективнее, чем использование Vec::new,
которое изменяет размер по мере вставки элементов.
Когда вы снова запустите cargo check, он должен завершиться успешно.
Отправка кода из ThreadPool в поток
Мы оставили комментарий в цикле for в листинге 21-14 относительно создания
потоков. Здесь мы рассмотрим, как на самом деле создавать потоки. Стандартная
библиотека предоставляет thread::spawn как способ создания потоков, и
thread::spawn ожидает получить некоторый код, который поток должен запустить сразу после
создания. Однако в нашем случае мы хотим создать потоки и заставить
их ждать кода, который мы отправим позже. Реализация потоков в стандартной библиотеке
не включает никакого способа сделать это; нам нужно реализовать это вручную.
Мы реализуем это поведение, введя новую структуру данных между
ThreadPool и потоками, которая будет управлять этим новым поведением. Мы назовём
эту структуру данных Worker, что является распространённым термином в реализациях
пулов. Worker забирает код, который нужно выполнить, и выполняет
код в своём потоке.
Представьте людей, работающих на кухне ресторана: работники ждут, пока поступят заказы от клиентов, а затем они отвечают за приём этих заказов и их выполнение.
Вместо хранения вектора экземпляров JoinHandle<()> в пуле потоков
мы будем хранить экземпляры структуры Worker. Каждый Worker будет хранить один
экземпляр JoinHandle<()>. Затем мы реализуем метод у Worker, который
будет принимать замыкание кода для выполнения и отправлять его в уже запущенный поток для
выполнения. Мы также дадим каждому Worker id, чтобы можно было различать
разные экземпляры Worker в пуле при журналировании или
отладке.
Вот новый процесс, который будет происходить при создании ThreadPool. Мы
реализуем код, который отправляет замыкание в поток, после того как настроим Worker
таким образом:
- Определить структуру
Worker, которая хранитidиJoinHandle<()>. - Изменить
ThreadPool, чтобы он хранил вектор экземпляровWorker. - Определить функцию
Worker::new, которая принимает номерidи возвращает экземплярWorker, содержащийidи поток, порождённый с пустым замыканием. - В
ThreadPool::newиспользовать счётчик циклаforдля генерацииid, создать новыйWorkerс этимidи сохранитьWorkerв векторе.
Если готовы к вызову, попробуйте реализовать эти изменения самостоятельно, прежде чем смотреть на код в листинге 21-15.
Готовы? Вот листинг 21-15 с одним из способов внесения предыдущих изменений.
use std::thread;
pub struct ThreadPool {
workers: Vec<Worker>,
}
impl ThreadPool {
// --snip--
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id));
}
ThreadPool { workers }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize) -> Worker {
let thread = thread::spawn(|| {});
Worker { id, thread }
}
}ThreadPool для хранения экземпляров Worker вместо хранения потоков напрямуюМы изменили имя поля у ThreadPool с threads на workers,
потому что теперь оно хранит экземпляры Worker вместо экземпляров JoinHandle<()>.
Мы используем счётчик в цикле for в качестве аргумента для
Worker::new и сохраняем каждый новый Worker в векторе с именем workers.
Внешнему коду (как нашему серверу в src/main.rs) не нужно знать детали
реализации, касающиеся использования структуры Worker внутри ThreadPool,
поэтому мы делаем структуру Worker и её функцию new приватными. Функция
Worker::new использует id, который мы ей даём, и сохраняет экземпляр JoinHandle<()>,
который создаётся порождением нового потока с использованием пустого замыкания.
Примечание: если операционная система не может создать поток, потому что не хватает
системных ресурсов, thread::spawn запаникует. Это вызовет панику
всего нашего сервера, даже если создание некоторых потоков может
успешно завершиться. Для простоты такое поведение приемлемо, но в производственной
реализации пула потоков, скорее всего, захотелось бы использовать
std::thread::Builder и его
spawn метод, который возвращает Result вместо этого.
Этот код скомпилируется и сохранит указанное в качестве аргумента ThreadPool::new
количество экземпляров Worker. Но мы по-прежнему не обрабатываем
замыкание, которое получаем в execute. Давайте посмотрим, как это сделать дальше.
Отправка запросов в потоки через каналы
Следующая проблема, которую мы решим, заключается в том, что замыкания, переданные в thread::spawn,
абсолютно ничего не делают. Сейчас мы получаем замыкание, которое хотим выполнить, в
методе execute. Но нам нужно дать thread::spawn замыкание для запуска, когда мы
создаём каждый Worker во время создания ThreadPool.
Мы хотим, чтобы только что созданные нами структуры Worker получали код для выполнения из
очереди, хранящейся в ThreadPool, и отправляли этот код в свой поток для выполнения.
Каналы, о которых мы узнали в главе 16 — простой способ связи между
двумя потоками — идеально подошли бы для этого случая использования. Мы будем использовать канал в качестве
очереди задач, и execute будет отправлять задачу из ThreadPool в
экземпляры Worker, которые отправят задачу в свой поток. Вот план:
ThreadPoolсоздаст канал и сохранит отправителя.- Каждый
Workerбудет хранить получателя. - Мы создадим новую структуру
Job, которая будет хранить замыкания, которые мы хотим отправить по каналу. - Метод
executeбудет отправлять задачу, которую хочет выполнить, через отправителя. - В своём потоке
Workerбудет перебирать получателя в цикле и выполнять замыкания любых полученных задач.
Давайте начнём с создания канала в ThreadPool::new и сохранения отправителя
в экземпляре ThreadPool, как показано в листинге 21-16. Структура Job
пока ничего не хранит, но будет типом элемента, который мы отправляем по
каналу.
use std::{sync::mpsc, thread};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --snip--
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id));
}
ThreadPool { workers, sender }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize) -> Worker {
let thread = thread::spawn(|| {});
Worker { id, thread }
}
}ThreadPool для хранения отправителя канала, который передаёт экземпляры JobВ ThreadPool::new мы создаём наш новый канал и заставляем пул хранить
отправителя. Это успешно скомпилируется.
Давайте попробуем передать получателя канала в каждый Worker, когда
пул потоков создаёт канал. Мы знаем, что хотим использовать получателя в потоке,
который порождают экземпляры Worker, поэтому мы будем ссылаться на параметр receiver в
замыкании. Код в листинге 21-17 пока не скомпилируется.
use std::{sync::mpsc, thread};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --snip--
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, receiver));
}
ThreadPool { workers, sender }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
// --snip--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: mpsc::Receiver<Job>) -> Worker {
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}WorkerМы сделали некоторые небольшие и простые изменения: мы передаём получателя в
Worker::new, а затем используем его внутри замыкания.
Когда мы попытаемся проверить этот код, мы получим эту ошибку:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0382]: use of moved value: `receiver`
--> src/lib.rs:26:42
|
21 | let (sender, receiver) = mpsc::channel();
| -------- move occurs because `receiver` has type `std::sync::mpsc::Receiver<Job>`, which does not implement the `Copy` trait
...
25 | for id in 0..size {
| ----------------- inside of this loop
26 | workers.push(Worker::new(id, receiver));
| ^^^^^^^^ value moved here, in previous iteration of loop
|
note: consider changing this parameter type in method `new` to borrow instead if owning the value isn't necessary
--> src/lib.rs:47:33
|
47 | fn new(id: usize, receiver: mpsc::Receiver<Job>) -> Worker {
| --- in this method ^^^^^^^^^^^^^^^^^^^ this parameter takes ownership of the value
For more information about this error, try `rustc --explain E0382`.
error: could not compile `hello` (lib) due to 1 previous error
Код пытается передать receiver нескольким экземплярам Worker. Это
не сработает, как вы помните из главы 16: реализация каналов, которую
предоставляет Rust, — это multiple producer, single consumer (множественные производители, единственный потребитель). Это означает, что мы не можем
просто клонировать потребляющий конец канала, чтобы исправить этот код. Мы также не
хотим отправлять сообщение несколько раз нескольким потребителям; мы хотим один список
сообщений с несколькими экземплярами Worker, так чтобы каждое сообщение
обрабатывалось один раз.
Кроме того, извлечение задачи из очереди канала включает изменение
receiver, поэтому потокам нужен безопасный способ совместного использования и изменения receiver;
в противном случае мы могли бы получить гонки данных (как обсуждалось в главе 16).
Вспомните потокобезопасные умные указатели, обсуждавшиеся в главе 16: чтобы совместно использовать
владение между несколькими потоками и позволить потокам изменять значение, нам
нужно использовать Arc<Mutex<T>>. Тип Arc позволит нескольким экземплярам Worker
владеть получателем, а Mutex обеспечит, что только один Worker получит задачу из
получателя за раз. Листинг 21-18 показывает изменения, которые нужно внести.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
// --snip--
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --snip--
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
// --snip--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
// --snip--
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}Worker с помощью Arc и MutexВ ThreadPool::new мы помещаем получателя в Arc и Mutex. Для каждого
нового Worker мы клонируем Arc, чтобы увеличить счётчик ссылок, так что
экземпляры Worker могут совместно владеть получателем.
С этими изменениями код компилируется! Мы приближаемся!
Реализация метода execute
Давайте наконец реализуем метод execute у ThreadPool. Мы также изменим
Job со структуры на псевдоним типа для трейт-объекта, который хранит тип
замыкания, которое получает execute. Как обсуждалось в разделе «Синонимы типов и псевдонимы
типов» в главе 20, псевдонимы типов
позволяют нам сделать длинные типы короче для удобства использования. Посмотрите на листинг 21-19.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
// --snip--
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
// --snip--
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
// --snip--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}Job для Box, который хранит каждое замыкание, и последующая отправка задачи по каналуПосле создания нового экземпляра Job с использованием замыкания, которое мы получаем в execute, мы
отправляем эту задачу по отправляющему концу канала. Мы вызываем unwrap на
send на случай, если отправка завершится неудачей. Это может произойти, например, если мы
остановим выполнение всех наших потоков, что означает, что принимающий конец перестал
получать новые сообщения. На данный момент мы не можем остановить наши потоки от
выполнения: наши потоки продолжают выполняться, пока существует пул. Причина, по которой мы используем unwrap, в том, что мы знаем, что сценарий отказа не произойдёт, но
компилятор этого не знает.
Но мы ещё не совсем закончили! В Worker наше замыкание, передаваемое в
thread::spawn, по-прежнему только ссылается на принимающий конец канала.
Вместо этого нам нужно, чтобы замыкание бесконечно зацикливалось, запрашивая у принимающего конца
канала задачу и выполняя задачу, когда она получена. Давайте внесём изменение,
показанное в листинге 21-20, в Worker::new.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
// --snip--
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}WorkerЗдесь мы сначала вызываем lock у receiver, чтобы получить мьютекс, а затем
вызываем unwrap, чтобы вызвать панику при любых ошибках. Получение блокировки может завершиться неудачей, если мьютекс
находится в отравленном состоянии, что может произойти, если какой-либо другой поток запаниковал, удерживая
блокировку, вместо того чтобы освободить её. В этой ситуации вызов
unwrap, чтобы этот поток запаниковал, — правильное действие. Не стесняйтесь
заменить этот unwrap на expect с сообщением об ошибке, которое имеет смысл
для вас.
Если мы получаем блокировку мьютекса, мы вызываем recv, чтобы получить Job из
канала. Последний unwrap также проходит мимо любых ошибок здесь, которые могут возникнуть,
если поток, удерживающий отправителя, завершился, аналогично тому, как метод send
возвращает Err, если получатель завершился.
Вызов recv блокируется, поэтому, если задачи ещё нет, текущий поток
будет ждать, пока задача не станет доступной. Mutex<T> гарантирует, что только один
поток Worker за раз пытается запросить задачу.
Наш пул потоков теперь находится в рабочем состоянии! Запустите cargo run и сделайте несколько
запросов:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
warning: field `workers` is never read
--> src/lib.rs:7:5
|
6 | pub struct ThreadPool {
| ---------- field in this struct
7 | workers: Vec<Worker>,
| ^^^^^^^
|
= note: `#[warn(dead_code)]` on by default
warning: fields `id` and `thread` are never read
--> src/lib.rs:48:5
|
47 | struct Worker {
| ------ fields in this struct
48 | id: usize,
| ^^
49 | thread: thread::JoinHandle<()>,
| ^^^^^^
warning: `hello` (lib) generated 2 warnings
Finished `dev` profile [unoptimized + debuginfo] target(s) in 4.91s
Running `target/debug/hello`
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Worker 1 got a job; executing.
Worker 3 got a job; executing.
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Worker 1 got a job; executing.
Worker 3 got a job; executing.
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Успех! Теперь у нас есть пул потоков, который выполняет соединения асинхронно. Создаётся никогда не более четырёх потоков, поэтому наша система не будет перегружена, если сервер получит много запросов. Если мы сделаем запрос к /sleep, сервер сможет обслуживать другие запросы, запустив их в другом потоке.
Примечание: если открыть /sleep в нескольких окнах браузера одновременно, они могут загружаться по одному с интервалом в пять секунд. Некоторые веб-браузеры выполняют несколько экземпляров одного и того же запроса последовательно по причинам кэширования. Это ограничение не вызвано нашим веб-сервером.
Хорошее время, чтобы остановиться и подумать о том, как код в листингах 21-18, 21-19 и 21-20 отличался бы, если бы мы использовали фьючерсы вместо замыкания для выполняемой работы. Какие типы изменились бы? Как бы отличались сигнатуры методов, если вообще отличались бы? Какие части кода остались бы прежними?
После изучения цикла while let в главе 17 и главе 19, вы
можете задаться вопросом, почему мы не написали код потока Worker так, как показано в
листинге 21-21.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
// --snip--
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
while let Ok(job) = receiver.lock().unwrap().recv() {
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}Worker::new с использованием while letЭтот код компилируется и выполняется, но не приводит к желаемому поведению
потоков: медленный запрос по-прежнему будет заставлять другие запросы ждать
обработки. Причина несколько тонкая: у структуры Mutex нет публичного
метода unlock, потому что владение блокировкой основано на времени жизни
MutexGuard<T> внутри LockResult<MutexGuard<T>>, который возвращает метод lock.
Во время компиляции проверка заимствований может затем обеспечить соблюдение правила,
что к ресурсу, защищённому Mutex, нельзя получить доступ, если мы не удерживаем
блокировку. Однако эта реализация также может привести к тому, что блокировка будет удерживаться
дольше, чем предполагалось, если мы не будем внимательны ко времени жизни
MutexGuard<T>.
Код в листинге 21-20, использующий let job = receiver.lock().unwrap().recv().unwrap();, работает, потому что с let любые
временные значения, используемые в выражении в правой части знака
равно, немедленно уничтожаются, когда инструкция let завершается. Однако while let (и if let и
match) не уничтожает временные значения до конца
связанного блока. В листинге 21-21 блокировка остаётся удерживаемой на протяжении
вызова job(), что означает, что другие экземпляры Worker не могут получать задачи.
Корректное завершение работы и очистка
Корректное завершение работы и очистка
Код в листинге 21-20 отвечает на запросы асинхронно через
использование пула потоков, как мы и задумывали. Мы получаем несколько предупреждений о полях workers,
id и thread, которые мы не используем напрямую, что напоминает нам,
что мы ничего не очищаем. Когда мы используем менее элегантный
метод ctrl-C для остановки главного потока, все остальные потоки
также немедленно останавливаются, даже если они находятся в середине обслуживания
запроса.
Далее мы реализуем трейт Drop, чтобы вызвать join для каждого из
потоков в пуле, чтобы они могли завершить запросы, над которыми работают,
прежде чем закрыться. Затем мы реализуем способ сообщить потокам, что им следует
прекратить принимать новые запросы и завершиться. Чтобы увидеть этот код в действии, мы
изменим наш сервер так, чтобы он принимал только два запроса, прежде чем плавно завершить работу
своего пула потоков.
Одна вещь, которую следует заметить по ходу дела: ничто из этого не влияет на части кода, которые отвечают за выполнение замыканий, поэтому всё здесь было бы тем же, если бы мы использовали пул потоков для асинхронной среды выполнения.
Реализация трейта Drop для ThreadPool
Давайте начнём с реализации Drop для нашего пула потоков. Когда пул
удаляется, все наши потоки должны присоединиться, чтобы убедиться, что они завершили свою работу.
В листинге 21-22 показана первая попытка реализации Drop; этот код ещё не
совсем работает.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
for worker in &mut self.workers {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}Сначала мы перебираем каждого из workers пула потоков. Мы используем &mut для этого,
потому что self — изменяемая ссылка, и нам также нужно иметь возможность изменять
worker. Для каждого worker мы выводим сообщение о том, что этот конкретный
экземпляр Worker завершается, а затем вызываем join для потока этого экземпляра Worker.
Если вызов join завершается неудачей, мы используем unwrap, чтобы заставить Rust
запаниковать и перейти к неграциозному завершению.
Вот ошибка, которую мы получаем при компиляции этого кода:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0507]: cannot move out of `worker.thread` which is behind a mutable reference
--> src/lib.rs:52:13
|
52 | worker.thread.join().unwrap();
| ^^^^^^^^^^^^^ ------ `worker.thread` moved due to this method call
| |
| move occurs because `worker.thread` has type `JoinHandle<()>`, which does not implement the `Copy` trait
|
note: `JoinHandle::<T>::join` takes ownership of the receiver `self`, which moves `worker.thread`
--> /rustc/2d8144b7880597b6e6d3dfd63a9a9efae3f533d3/library/std/src/thread/join_handle.rs:149:16
For more information about this error, try `rustc --explain E0507`.
error: could not compile `hello` (lib) due to 1 previous error
Ошибка сообщает нам, что мы не можем вызвать join, потому что у нас есть только изменяемое заимствование
каждого worker, а join становится владельцем своего аргумента. Чтобы решить эту
проблему, нам нужно вынести поток из экземпляра Worker, которому принадлежит
thread, чтобы join мог потребить поток. Один из способов сделать это — использовать
тот же подход, который мы использовали в листинге 18-15. Если бы Worker содержал
Option<thread::JoinHandle<()>>, мы могли бы вызвать метод take для
Option, чтобы вынести значение из варианта Some и оставить на его месте вариант None.
Другими словами, Worker, который выполняется, имел бы вариант Some
в thread, а когда мы хотели бы очистить Worker, мы бы заменили
Some на None, чтобы у Worker не было потока для выполнения.
Однако единственный раз, когда это возникло бы, — это при удалении
Worker. Взамен нам пришлось бы иметь дело с
Option<thread::JoinHandle<()>> везде, где мы обращались бы к worker.thread.
Идиоматический Rust довольно часто использует Option, но когда вы обнаруживаете, что оборачиваете
что-то, что, как вы знаете, всегда будет присутствовать, в Option в качестве обходного решения,
стоит поискать альтернативные подходы, чтобы сделать ваш код
чище и менее подверженным ошибкам.
В этом случае существует лучшая альтернатива: метод Vec::drain. Он принимает
параметр диапазона, чтобы указать, какие элементы удалить из вектора, и возвращает
итератор по этим элементам. Передача синтаксиса диапазона .. удалит каждое
значение из вектора.
Итак, нам нужно обновить реализацию drop для ThreadPool вот так:
#![allow(unused)]
fn main() {
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}
}Это устраняет ошибку компилятора и не требует никаких других изменений в нашем
коде. Обратите внимание, что, поскольку drop может быть вызван при панике, unwrap
также может запаниковать и вызвать двойную панику, которая немедленно аварийно завершает
программу и прекращает любую очистку в процессе. Это нормально для примера программы,
но не рекомендуется для производственного кода.
Сигнализация потокам о необходимости прекратить прослушивание заданий
Со всеми внесёнными изменениями наш код компилируется без предупреждений.
Однако плохая новость в том, что этот код пока не функционирует так, как мы хотим.
Ключ — в логике замыканий, выполняемых потоками экземпляров Worker:
на данный момент мы вызываем join, но это не остановит потоки,
потому что они loop вечно в поисках заданий. Если мы попытаемся удалить наш
ThreadPool с текущей реализацией drop, главный поток
заблокируется навсегда, ожидая завершения первого потока.
Чтобы решить эту проблему, нам нужно изменить реализацию drop для ThreadPool
и затем изменить цикл в Worker.
Сначала мы изменим реализацию drop для ThreadPool, чтобы явно удалить
sender перед ожиданием завершения потоков. Листинг 21-23 показывает
изменения в ThreadPool для явного удаления sender. В отличие от потока,
здесь нам нужно использовать Option, чтобы иметь возможность вынести sender из
ThreadPool с помощью Option::take.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
// --snip--
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
// --snip--
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}sender перед присоединением потоков WorkerУдаление sender закрывает канал, что означает, что больше сообщений не будет
отправлено. Когда это происходит, все вызовы recv, которые делают экземпляры Worker
в бесконечном цикле, вернут ошибку. В листинге 21-24 мы изменяем
цикл Worker, чтобы плавно выйти из цикла в этом случае, что означает, что потоки
завершатся, когда реализация drop для ThreadPool вызовет join для них.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let message = receiver.lock().unwrap().recv();
match message {
Ok(job) => {
println!("Worker {id} got a job; executing.");
job();
}
Err(_) => {
println!("Worker {id} disconnected; shutting down.");
break;
}
}
}
});
Worker { id, thread }
}
}recv возвращает ошибкуЧтобы увидеть этот код в действии, давайте изменим main, чтобы принимать только два запроса
перед плавным завершением работы сервера, как показано в листинге 21-25.
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming().take(2) {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
println!("Shutting down.");
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}В реальном веб-сервере вы бы не хотели, чтобы он завершал работу после обслуживания только двух запросов. Этот код просто демонстрирует, что плавное завершение работы и очистка работают.
Метод take определён в трейте Iterator и ограничивает итерацию
первыми двумя элементами максимум. ThreadPool выйдет из области видимости в
конце main, и реализация drop будет выполнена.
Запустите сервер с помощью cargo run и сделайте три запроса. Третий запрос
должен вернуть ошибку, и в вашем терминале вы должны увидеть вывод, аналогичный этому:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.41s
Running `target/debug/hello`
Worker 0 got a job; executing.
Shutting down.
Shutting down worker 0
Worker 3 got a job; executing.
Worker 1 disconnected; shutting down.
Worker 2 disconnected; shutting down.
Worker 3 disconnected; shutting down.
Worker 0 disconnected; shutting down.
Shutting down worker 1
Shutting down worker 2
Shutting down worker 3
Вы можете увидеть другой порядок выводимых ID и сообщений Worker. По сообщениям мы можем
увидеть, как работает этот код: экземпляры Worker 0 и 3 получили
первые два запроса. Сервер перестал принимать соединения после второго
соединения, и реализация Drop для ThreadPool начала выполняться
до того, как Worker 3 даже начал свою работу. Удаление sender отключает все
экземпляры Worker и сообщает им о необходимости завершиться. Каждый экземпляр Worker
выводит сообщение, когда отключается, а затем пул потоков вызывает join, чтобы
дождаться завершения каждого потока Worker.
Обратите внимание на один интересный аспект этого конкретного выполнения: ThreadPool
удалил sender, и прежде чем какой-либо Worker получил ошибку, мы попытались
присоединить Worker 0. Worker 0 ещё не получил ошибку от recv, поэтому главный
поток заблокировался, ожидая завершения Worker 0. Тем временем Worker 3
получил задание, а затем все потоки получили ошибку. Когда Worker 0 завершился,
главный поток подождал остальные экземпляры Worker, чтобы они завершились. На тот
момент они все вышли из своих циклов и остановились.
Поздравляем! Теперь мы завершили наш проект; у нас есть базовый веб-сервер, который использует пул потоков для асинхронного ответа. Мы можем выполнить плавное завершение работы сервера, которое очищает все потоки в пуле.
Вот полный код для справки:
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming().take(2) {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
println!("Shutting down.");
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — количество потоков в пуле.
///
/// # Panics
///
/// Функция `new` вызовет панику, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in &mut self.workers {
println!("Shutting down worker {}", worker.id);
if let Some(thread) = worker.thread.take() {
thread.join().unwrap();
}
}
}
}
struct Worker {
id: usize,
thread: Option<thread::JoinHandle<()>>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let message = receiver.lock().unwrap().recv();
match message {
Ok(job) => {
println!("Worker {id} got a job; executing.");
job();
}
Err(_) => {
println!("Worker {id} disconnected; shutting down.");
break;
}
}
}
});
Worker {
id,
thread: Some(thread),
}
}
}Здесь можно сделать больше! Если вы хотите продолжить улучшать этот проект, вот несколько идей:
- Добавить больше документации к
ThreadPoolи его публичным методам. - Добавить тесты функциональности библиотеки.
- Заменить вызовы
unwrapна более надёжную обработку ошибок. - Использовать
ThreadPoolдля выполнения какой-либо задачи, отличной от обслуживания веб-запросов. - Найти крейт пула потоков на crates.io и реализовать аналогичный веб-сервер с использованием этого крейта. Затем сравните его API и надёжность с пулом потоков, который мы реализовали.
Итоги
Отлично! Вы дошли до конца книги! Мы хотим поблагодарить вас за то, что вы присоединились к нам в этом путешествии по Rust. Теперь вы готовы реализовывать собственные проекты на Rust и помогать другим людям с их проектами. Помните, что существует гостеприимное сообщество других Rustaceans, которые с радостью помогут вам с любыми проблемами, с которыми вы столкнётесь на своём пути в Rust.
Приложения
Приложения
Следующие разделы содержат справочный материал, который может оказаться полезным в вашем путешествии по Rust.
A - Ключевые слова
Приложение A: Ключевые слова
Следующие списки содержат ключевые слова, зарезервированные для текущего или будущего использования языком Rust. Таким образом, их нельзя использовать в качестве идентификаторов (кроме случая сырых идентификаторов, который обсуждается в разделе «Сырые идентификаторы»). Идентификаторы — это имена функций, переменных, параметров, полей структур, модулей, крейтов, констант, макросов, статических значений, атрибутов, типов, трейтов или времён жизни.
Ключевые слова, используемые в настоящее время
Ниже приведён список ключевых слов, используемых в настоящее время, с описанием их функциональности.
as: Выполняет примитивное приведение типов, устраняет неоднозначность конкретного трейта, содержащего элемент, или переименовывает элементы в операторахuse.async: ВозвращаетFutureвместо блокировки текущего потока.await: Приостанавливает выполнение до готовности результатаFuture.break: Немедленно выходит из цикла.const: Определяет константные элементы или константные сырые указатели.continue: Переходит к следующей итерации цикла.crate: В пути модуля ссылается на корень крейта.dyn: Динамическая диспетчеризация для трейт-объекта.else: Ветвь по умолчанию для конструкций потока управленияifиif let.enum: Определяет перечисление.extern: Связывает внешнюю функцию или переменную.false: Логический литерал «ложь».fn: Определяет функцию или тип указателя на функцию.for: Перебирает элементы итератора, реализует трейт или задаёт время жизни более высокого ранга.if: Ветвление на основе результата условного выражения.impl: Реализует собственную или трейтовую функциональность.in: Часть синтаксиса циклаfor.let: Связывает переменную.loop: Безусловный цикл.match: Сопоставляет значение с шаблонами.mod: Определяет модуль.move: Заставляет замыкание принимать владение всеми захваченными значениями.mut: Обозначает изменяемость в ссылках, сырых указателях или привязках шаблонов.pub: Обозначает публичную видимость полей структур, блоковimplили модулей.ref: Привязка по ссылке.return: Возврат из функции.Self: Псевдоним типа для типа, который определяется или реализуется.self: Субъект метода или текущий модуль.static: Глобальная переменная или время жизни, длящееся всё время выполнения программы.struct: Определяет структуру.super: Родительский модуль текущего модуля.trait: Определяет трейт.true: Логический литерал «истина».type: Определяет псевдоним типа или ассоциированный тип.union: Определяет объединение; является ключевым словом только при использовании в объявлении объединения.unsafe: Обозначает небезопасный код, функции, трейты или реализации.use: Вводит символы в область видимости.where: Обозначает клаузы, ограничивающие тип.while: Условный цикл на основе результата выражения.
Ключевые слова, зарезервированные для будущего использования
Следующие ключевые слова ещё не имеют никакой функциональности, но зарезервированы языком Rust для потенциального будущего использования:
abstractbecomeboxdofinalgenmacrooverrideprivtrytypeofunsizedvirtualyield
Сырые идентификаторы
Сырые идентификаторы — это синтаксис, позволяющий использовать ключевые слова там, где они
обычно не разрешены. Сырой идентификатор используется путём добавления префикса r# перед ключевым словом.
Например, match — это ключевое слово. Если попытаться скомпилировать следующую функцию,
использующую match в качестве имени:
Имя файла: src/main.rs
fn match(needle: &str, haystack: &str) -> bool {
haystack.contains(needle)
}будет получена следующая ошибка:
error: expected identifier, found keyword `match`
--> src/main.rs:4:4
|
4 | fn match(needle: &str, haystack: &str) -> bool {
| ^^^^^ expected identifier, found keyword
Ошибка показывает, что ключевое слово match нельзя использовать в качестве идентификатора
функции. Чтобы использовать match в качестве имени функции, нужно применить синтаксис сырого
идентификатора, вот так:
Имя файла: src/main.rs
fn r#match(needle: &str, haystack: &str) -> bool {
haystack.contains(needle)
}
fn main() {
assert!(r#match("foo", "foobar"));
}Этот код скомпилируется без ошибок. Обратите внимание на префикс r# в имени функции
как в её определении, так и в месте вызова в main.
Сырые идентификаторы позволяют использовать любое выбранное слово в качестве идентификатора, даже если
это слово оказалось зарезервированным ключевым словом. Это даёт больше свободы в выборе
имён идентификаторов, а также позволяет интегрироваться с программами, написанными на
языке, где эти слова не являются ключевыми. Кроме того, сырые идентификаторы позволяют
использовать библиотеки, написанные на другой редакции Rust, отличной от редакции вашего крейта.
Например, try не является ключевым словом в редакции 2015, но является в редакциях 2018, 2021
и 2024. Если вы зависите от библиотеки, написанной с использованием редакции 2015
и имеющей функцию try, вам потребуется использовать синтаксис сырого идентификатора,
в данном случае r#try, чтобы вызвать эту функцию из кода на более поздних редакциях.
См. Приложение E для получения дополнительной информации о редакциях.
B - Операторы и символы
Приложение B: Операторы и символы
Это приложение содержит глоссарий синтаксиса Rust, включая операторы и другие символы, которые встречаются сами по себе или в контексте путей, обобщённых типов, ограничений трейтов, макросов, атрибутов, комментариев, кортежей и скобок.
Операторы
Таблица B-1 содержит операторы в Rust, пример того, как оператор может встретиться в контексте, краткое объяснение и информацию о том, является ли оператор перегружаемым. Если оператор перегружаем, указан соответствующий трейт для перегрузки этого оператора.
Таблица B-1: Операторы
| Оператор | Пример | Объяснение | Перегружаемый? |
|---|---|---|---|
! | ident!(...), ident!{...}, ident![...] | Раскрытие макроса | |
! | !expr | Побитовое или логическое дополнение | Not |
!= | expr != expr | Сравнение на неравенство | PartialEq |
% | expr % expr | Арифметический остаток | Rem |
%= | var %= expr | Арифметический остаток с присваиванием | RemAssign |
& | &expr, &mut expr | Заимствование | |
& | &type, &mut type, &'a type, &'a mut type | Тип заимствованного указателя | |
& | expr & expr | Побитовое И | BitAnd |
&= | var &= expr | Побитовое И с присваиванием | BitAndAssign |
&& | expr && expr | Логическое И с коротким замыканием | |
* | expr * expr | Арифметическое умножение | Mul |
*= | var *= expr | Арифметическое умножение с присваиванием | MulAssign |
* | *expr | Разыменование | Deref |
* | *const type, *mut type | Сырой указатель | |
+ | trait + trait, 'a + trait | Составное ограничение типа | |
+ | expr + expr | Арифметическое сложение | Add |
+= | var += expr | Арифметическое сложение с присваиванием | AddAssign |
, | expr, expr | Разделитель аргументов и элементов | |
- | - expr | Арифметическое отрицание | Neg |
- | expr - expr | Арифметическое вычитание | Sub |
-= | var -= expr | Арифметическое вычитание с присваиванием | SubAssign |
-> | fn(...) -> type, |…| -> type | Тип возврата функции и замыкания | |
. | expr.ident | Доступ к полю | |
. | expr.ident(expr, ...) | Вызов метода | |
. | expr.0, expr.1, и так далее | Индексация кортежа | |
.. | .., expr.., ..expr, expr..expr | Литерал диапазона, исключающего правую границу | PartialOrd |
..= | ..=expr, expr..=expr | Литерал диапазона, включающего правую границу | PartialOrd |
.. | ..expr | Синтаксис обновления литерала структуры | |
.. | variant(x, ..), struct_type { x, .. } | Привязка шаблона «и остальное» | |
... | expr...expr | (Устарело, используйте ..=) В шаблоне: шаблон диапазона, включающего границы | |
/ | expr / expr | Арифметическое деление | Div |
/= | var /= expr | Арифметическое деление с присваиванием | DivAssign |
: | pat: type, ident: type | Ограничения | |
: | ident: expr | Инициализатор поля структуры | |
: | 'a: loop {...} | Метка цикла | |
; | expr; | Терминатор оператора и элемента | |
; | [...; len] | Часть синтаксиса массива фиксированного размера | |
<< | expr << expr | Сдвиг влево | Shl |
<<= | var <<= expr | Сдвиг влево с присваиванием | ShlAssign |
< | expr < expr | Сравнение «меньше» | PartialOrd |
<= | expr <= expr | Сравнение «меньше или равно» | PartialOrd |
= | var = expr, ident = type | Присваивание/эквивалентность | |
== | expr == expr | Сравнение на равенство | PartialEq |
=> | pat => expr | Часть синтаксиса ветви match | |
> | expr > expr | Сравнение «больше» | PartialOrd |
>= | expr >= expr | Сравнение «больше или равно» | PartialOrd |
>> | expr >> expr | Сдвиг вправо | Shr |
>>= | var >>= expr | Сдвиг вправо с присваиванием | ShrAssign |
@ | ident @ pat | Привязка шаблона | |
^ | expr ^ expr | Побитовое исключающее ИЛИ | BitXor |
^= | var ^= expr | Побитовое исключающее ИЛИ с присваиванием | BitXorAssign |
| | pat | pat | Альтернативы в шаблоне | |
| | expr | expr | Побитовое ИЛИ | BitOr |
|= | var |= expr | Побитовое ИЛИ с присваиванием | BitOrAssign |
|| | expr || expr | Логическое ИЛИ с коротким замыканием | |
? | expr? | Распространение ошибки |
Символы, не являющиеся операторами
Следующие таблицы содержат все символы, которые не функционируют как операторы; то есть они не ведут себя как вызов функции или метода.
Таблица B-2 показывает символы, которые встречаются сами по себе и допустимы в различных местах.
Таблица B-2: Отдельный синтаксис
| Символ | Объяснение |
|---|---|
'ident | Именованное время жизни или метка цикла |
Цифры, за которыми сразу следуют u8, i32, f64, usize и так далее | Числовой литерал конкретного типа |
"..." | Строковый литерал |
r"...", r#"..."#, r##"..."##, и так далее | Сырой строковый литерал; управляющие символы не обрабатываются |
b"..." | Байтовый строковый литерал; создаёт массив байтов вместо строки |
br"...", br#"..."#, br##"..."##, и так далее | Сырой байтовый строковый литерал; комбинация сырого и байтового строкового литерала |
'...' | Символьный литерал |
b'...' | ASCII-байтовый литерал |
|…| expr | Замыкание |
! | Всегда пустой нижний тип для функций, которые не возвращают управление |
_ | Привязка шаблона «игнорируется»; также используется для удобочитаемости целочисленных литералов |
Таблица B-3 показывает символы, которые встречаются в контексте пути через иерархию модулей к элементу.
Таблица B-3: Синтаксис, связанный с путями
| Символ | Объяснение |
|---|---|
ident::ident | Путь пространства имён |
::path | Путь относительно корня крейта (то есть явный абсолютный путь) |
self::path | Путь относительно текущего модуля (то есть явный относительный путь) |
super::path | Путь относительно родителя текущего модуля |
type::ident, <type as trait>::ident | Ассоциированные константы, функции и типы |
<type>::... | Ассоциированный элемент для типа, который нельзя напрямую назвать (например, <&T>::..., <[T]>::... и так далее) |
trait::method(...) | Устранение неоднозначности вызова метода путём указания трейта, который его определяет |
type::method(...) | Устранение неоднозначности вызова метода путём указания типа, для которого он определён |
<type as trait>::method(...) | Устранение неоднозначности вызова метода путём указания трейта и типа |
Таблица B-4 показывает символы, которые встречаются в контексте использования обобщённых параметров типа.
Таблица B-4: Обобщённые типы
| Символ | Объяснение |
|---|---|
path<...> | Задаёт параметры обобщённого типа в типе (например, Vec<u8>) |
path::<...>, method::<...> | Задаёт параметры обобщённого типа, функции или метода в выражении; часто называется turbofish (например, "42".parse::<i32>()) |
fn ident<...> ... | Определяет обобщённую функцию |
struct ident<...> ... | Определяет обобщённую структуру |
enum ident<...> ... | Определяет обобщённое перечисление |
impl<...> ... | Определяет обобщённую реализацию |
for<...> type | Ограничения времени жизни более высокого ранга |
type<ident=type> | Обобщённый тип, в котором одному или нескольким ассоциированным типам назначены конкретные значения (например, Iterator<Item=T>) |
Таблица B-5 показывает символы, которые встречаются в контексте ограничения обобщённых параметров типа ограничениями трейтов.
Таблица B-5: Ограничения трейтов
| Символ | Объяснение |
|---|---|
T: U | Обобщённый параметр T ограничен типами, реализующими U |
T: 'a | Обобщённый тип T должен пережить время жизни 'a (то есть тип не может транзитивно содержать ссылки со временем жизни короче 'a) |
T: 'static | Обобщённый тип T не содержит заимствованных ссылок, кроме ссылок со временем жизни 'static |
'b: 'a | Обобщённое время жизни 'b должно пережить время жизни 'a |
T: ?Sized | Разрешает обобщённому параметру типа быть динамически изменяемым по размеру типом |
'a + trait, trait + trait | Составное ограничение типа |
Таблица B-6 показывает символы, которые встречаются в контексте вызова или определения макросов и указания атрибутов элемента.
Таблица B-6: Макросы и атрибуты
| Символ | Объяснение |
|---|---|
#[meta] | Внешний атрибут |
#![meta] | Внутренний атрибут |
$ident | Подстановка макроса |
$ident:kind | Метапеременная макроса |
$(...)... | Повторение макроса |
ident!(...), ident!{...}, ident![...] | Вызов макроса |
Таблица B-7 показывает символы, которые создают комментарии.
Таблица B-7: Комментарии
| Символ | Объяснение |
|---|---|
// | Строчный комментарий |
//! | Внутренний строчный документационный комментарий |
/// | Внешний строчный документационный комментарий |
/*...*/ | Блочный комментарий |
/*!...*/ | Внутренний блочный документационный комментарий |
/**...*/ | Внешний блочный документационный комментарий |
Таблица B-8 показывает контексты, в которых используются круглые скобки.
Таблица B-8: Круглые скобки
| Символ | Объяснение |
|---|---|
() | Пустой кортеж (он же unit), как литерал, так и тип |
(expr) | Выражение в скобках |
(expr,) | Выражение кортежа из одного элемента |
(type,) | Тип кортежа из одного элемента |
(expr, ...) | Выражение кортежа |
(type, ...) | Тип кортежа |
expr(expr, ...) | Выражение вызова функции; также используется для инициализации кортежных struct и вариантов кортежных enum |
Таблица B-9 показывает контексты, в которых используются фигурные скобки.
Таблица B-9: Фигурные скобки
| Контекст | Объяснение |
|---|---|
{...} | Блочное выражение |
Type {...} | Литерал структуры |
Таблица B-10 показывает контексты, в которых используются квадратные скобки.
Таблица B-10: Квадратные скобки
| Контекст | Объяснение |
|---|---|
[...] | Литерал массива |
[expr; len] | Литерал массива, содержащий len копий expr |
[type; len] | Тип массива, содержащий len экземпляров type |
expr[expr] | Индексация коллекции; перегружаемо (Index, IndexMut) |
expr[..], expr[a..], expr[..b], expr[a..b] | Индексация коллекции, имитирующая срез коллекции, с использованием Range, RangeFrom, RangeTo или RangeFull в качестве «индекса» |
C - Выводимые трейты
Приложение C: Выводимые трейты
В различных местах книги обсуждался атрибут derive, который
можно применять к определению структуры или перечисления. Атрибут derive генерирует
код, реализующий трейт с собственной реализацией по умолчанию для
типа, аннотированного синтаксисом derive.
В этом приложении приводится справочник всех трейтов в стандартной
библиотеке, которые можно использовать с derive. Каждый раздел охватывает:
- Какие операторы и методы включает производный трейт
- Что делает реализация трейта, предоставляемая
derive - Что означает реализация трейта для типа
- Условия, при которых разрешено или не разрешено реализовывать трейт
- Примеры операций, требующих этот трейт
Если требуется поведение, отличное от предоставляемого атрибутом derive,
следует обратиться к документации стандартной библиотеки
для каждого трейта, чтобы узнать подробности о ручной реализации.
Перечисленные здесь трейты — единственные, определённые стандартной библиотекой, которые
можно реализовать для своих типов с помощью derive. Другие трейты, определённые в
стандартной библиотеке, не имеют разумного поведения по умолчанию, поэтому их реализация
остаётся на усмотрение разработчика в соответствии с тем, чего он пытается достичь.
Примером трейта, который нельзя вывести, является Display, отвечающий
за форматирование для конечных пользователей. Всегда следует продумывать подходящий способ
отображения типа конечному пользователю. Какие части типа конечный пользователь должен
видеть? Какие части покажутся ему релевантными? Какой формат данных
будет для него наиболее удобным? Компилятор Rust не обладает этим пониманием, поэтому
не может предоставить подходящее поведение по умолчанию.
Список производных трейтов, приведённый в этом приложении, не является исчерпывающим:
библиотеки могут реализовывать derive для собственных трейтов, делая список
трейтов, которые можно использовать с derive, поистине открытым. Реализация derive
включает использование процедурного макроса, который рассматривается в разделе «Пользовательские макросы derive» главы 20.
Debug для вывода программиста
Трейт Debug включает отладочное форматирование в строках формата, которое
указывается добавлением :? внутри заполнителей {}.
Трейт Debug позволяет выводить экземпляры типа в целях отладки,
чтобы вы и другие программисты, использующие ваш тип, могли исследовать экземпляр
в определённой точке выполнения программы.
Трейт Debug требуется, например, при использовании макроса assert_eq!.
Этот макрос выводит значения экземпляров, переданных в качестве аргументов, если
проверка на равенство не удалась, чтобы программисты могли увидеть, почему два экземпляра
не равны.
PartialEq и Eq для сравнения на равенство
Трейт PartialEq позволяет сравнивать экземпляры типа для проверки на
равенство и включает использование операторов == и !=.
Вывод PartialEq реализует метод eq. Когда PartialEq выводится для
структур, два экземпляра равны только если все поля равны, и
экземпляры не равны, если любое из полей не равно. Когда выводится для перечислений,
каждый вариант равен самому себе и не равен другим вариантам.
Трейт PartialEq требуется, например, при использовании
макроса assert_eq!, которому нужна возможность сравнивать два экземпляра типа
на равенство.
Трейт Eq не имеет методов. Его назначение — сигнализировать, что для каждого значения
аннотированного типа значение равно самому себе. Трейт Eq можно применять
только к типам, которые также реализуют PartialEq, хотя не все типы,
реализующие PartialEq, могут реализовать Eq. Один из примеров — типы
чисел с плавающей точкой: реализация чисел с плавающей точкой утверждает, что два
экземпляра значения «не-число» (NaN) не равны друг другу.
Примером необходимости Eq является использование ключей в HashMap<K, V>, чтобы
HashMap<K, V> мог определить, являются ли два ключа одинаковыми.
PartialOrd и Ord для сравнения порядка
Трейт PartialOrd позволяет сравнивать экземпляры типа для целей сортировки.
Тип, реализующий PartialOrd, можно использовать с операторами <, >,
<= и >=. Трейт PartialOrd можно применять только к типам,
которые также реализуют PartialEq.
Вывод PartialOrd реализует метод partial_cmp, который возвращает
Option<Ordering>, значение None в случае, когда заданные значения не создают
упорядочение. Примером значения, которое не создаёт упорядочение, хотя
большинство значений этого типа можно сравнивать, является значение с плавающей точкой NaN.
Вызов partial_cmp с любым числом с плавающей точкой и значением
NaN с плавающей точкой вернёт None.
Когда PartialOrd выводится для структур, он сравнивает два экземпляра путём сравнения
значения в каждом поле в порядке их появления в определении структуры.
Когда PartialOrd выводится для перечислений, варианты перечисления, объявленные раньше в
определении перечисления, считаются меньшими, чем варианты, объявленные позже.
Трейт PartialOrd требуется, например, для метода gen_range
из крейта rand, который генерирует случайное значение в диапазоне, заданном
выражением диапазона.
Трейт Ord позволяет утверждать, что для любых двух значений аннотированного
типа существует допустимое упорядочение. Трейт Ord реализует метод cmp,
который возвращает Ordering, а не Option<Ordering>, поскольку допустимое
упорядочение всегда возможно. Трейт Ord можно применять только к типам,
которые также реализуют PartialOrd и Eq (а Eq требует PartialEq). Когда
Ord выводится для структур и перечислений, cmp ведёт себя так же, как производная
реализация partial_cmp для PartialOrd.
Примером необходимости Ord является хранение значений в BTreeSet<T>,
структуре данных, которая хранит данные на основе порядка сортировки значений.
Clone и Copy для дублирования значений
Трейт Clone позволяет явно создавать глубокую копию значения, и
процесс дублирования может включать выполнение произвольного кода и копирование данных в куче.
См. раздел «Взаимодействие переменных и данных при клонировании» главы 4 для получения дополнительной информации о Clone.
Вывод Clone реализует метод clone, который при реализации для
всего типа вызывает clone для каждой из частей типа. Это означает, что все
поля или значения в типе также должны реализовывать Clone для вывода Clone.
Примером необходимости Clone является вызов метода to_vec для
среза. Срез не владеет экземплярами типа, которые он содержит, но вектор,
возвращаемый to_vec, должен владеть своими экземплярами, поэтому to_vec вызывает
clone для каждого элемента. Таким образом, тип, хранящийся в срезе, должен реализовывать Clone.
Трейт Copy позволяет дублировать значение только путём копирования битов, хранящихся в
стеке; произвольный код не требуется. См. раздел «Данные только в стеке:
Copy» главы 4 для получения дополнительной
информации о Copy.
Трейт Copy не определяет никаких методов, чтобы программисты не могли
переопределить эти методы и нарушить предположение о том, что произвольный код
не выполняется. Таким образом, все программисты могут предполагать, что копирование значения будет
очень быстрым.
Можно выводить Copy для любого типа, все части которого реализуют Copy. Тип, который
реализует Copy, также должен реализовывать Clone, поскольку тип, реализующий
Copy, имеет тривиальную реализацию Clone, которая выполняет ту же задачу, что и
Copy.
Трейт Copy требуется редко; типы, реализующие Copy, имеют
доступные оптимизации, означающие, что не нужно вызывать clone, что делает
код более кратким.
Всё, что возможно с Copy, также можно выполнить с Clone, но код
может быть медленнее или требовать использования clone в некоторых местах.
Hash для отображения значения в значение фиксированного размера
Трейт Hash позволяет взять экземпляр типа произвольного размера и
отобразить этот экземпляр в значение фиксированного размера с помощью хеш-функции. Вывод
Hash реализует метод hash. Производная реализация метода hash
объединяет результат вызова hash для каждой из частей типа,
что означает, что все поля или значения также должны реализовывать Hash для вывода Hash.
Примером необходимости Hash является хранение ключей в HashMap<K, V>
для эффективного хранения данных.
Default для значений по умолчанию
Трейт Default позволяет создать значение по умолчанию для типа. Вывод
Default реализует функцию default. Производная реализация функции
default вызывает функцию default для каждой части типа,
что означает, что все поля или значения в типе также должны реализовывать Default для
вывода Default.
Функция Default::default обычно используется в сочетании с синтаксисом обновления структуры,
рассмотренным в разделе «Создание экземпляров из других экземпляров с помощью
синтаксиса обновления структуры» главы 5. Можно настроить несколько полей структуры и
затем установить и использовать значение по умолчанию для остальных полей, используя
..Default::default().
Трейт Default требуется при использовании метода unwrap_or_default для
экземпляров Option<T>, например. Если Option<T> равно None, метод
unwrap_or_default вернёт результат Default::default для типа
T, хранящегося в Option<T>.
D - Полезные инструменты разработки
Приложение D: Полезные инструменты разработки
В этом приложении мы поговорим о некоторых полезных инструментах разработки, которые предоставляет проект Rust. Мы рассмотрим автоматическое форматирование, быстрые способы применения исправлений предупреждений, линтер и интеграцию с IDE.
Автоматическое форматирование с помощью rustfmt
Инструмент rustfmt переформатирует код в соответствии с общепринятым стилем оформления кода. Многие совместные проекты используют rustfmt, чтобы избежать споров о том, какой стиль использовать при написании кода на Rust: каждый форматирует свой код с помощью этого инструмента.
Установки Rust по умолчанию включают rustfmt, поэтому программы rustfmt и cargo-fmt уже должны быть в системе. Эти две команды аналогичны rustc и cargo в том смысле, что rustfmt обеспечивает более тонкий контроль, а cargo-fmt понимает соглашения проекта, использующего Cargo. Чтобы отформатировать любой проект Cargo, введите следующую команду:
$ cargo fmt
Выполнение этой команды переформатирует весь код Rust в текущем крейте. Это должно изменить только стиль кода, но не его семантику. Для получения дополнительной информации о rustfmt см. его документацию.
Исправление кода с помощью rustfix
Инструмент rustfix включён в установки Rust и может автоматически исправлять предупреждения компилятора, которые имеют чёткий способ решения проблемы, вероятно, именно тот, который нужен. Ранее уже встречались предупреждения компилятора. Например, рассмотрим этот код:
Имя файла: src/main.rs
fn main() {
let mut x = 42;
println!("{x}");
}Здесь мы определяем переменную x как изменяемую, но фактически никогда её не изменяем. Rust предупреждает об этом:
$ cargo build
Compiling myprogram v0.1.0 (file:///projects/myprogram)
warning: variable does not need to be mutable
--> src/main.rs:2:9
|
2 | let mut x = 0;
| ----^
| |
| help: remove this `mut`
|
= note: `#[warn(unused_mut)]` on by default
Предупреждение предлагает удалить ключевое слово mut. Мы можем автоматически применить это предложение с помощью инструмента rustfix, выполнив команду cargo fix:
$ cargo fix
Checking myprogram v0.1.0 (file:///projects/myprogram)
Fixing src/main.rs (1 fix)
Finished dev [unoptimized + debuginfo] target(s) in 0.59s
Если снова посмотреть на src/main.rs, можно увидеть, что cargo fix изменил код:
Имя файла: src/main.rs
fn main() {
let x = 42;
println!("{x}");
}Переменная x теперь неизменяемая, и предупреждение больше не появляется.
Также можно использовать команду cargo fix для перехода кода между различными редакциями Rust. Редакции рассматриваются в Приложении E.
Больше линтов с Clippy
Инструмент Clippy — это набор линтов для анализа кода, позволяющих выявить распространённые ошибки и улучшить код на Rust. Clippy входит в стандартные установки Rust.
Чтобы запустить линты Clippy для любого проекта Cargo, введите следующую команду:
$ cargo clippy
Например, предположим, что написана программа, использующая приближение математической константы, такой как пи, как в этой программе:
fn main() {
let x = 3.1415;
let r = 8.0;
println!("the area of the circle is {}", x * r * r);
}Запуск cargo clippy для этого проекта приведёт к следующей ошибке:
error: approximate value of `f{32, 64}::consts::PI` found
--> src/main.rs:2:13
|
2 | let x = 3.1415;
| ^^^^^^
|
= note: `#[deny(clippy::approx_constant)]` on by default
= help: consider using the constant directly
= help: for further information visit https://rust-lang.github.io/rust-clippy/master/index.html#approx_constant
Эта ошибка сообщает, что в Rust уже определена более точная константа PI, и программа была бы более корректной, если бы использовалась эта константа. Затем следует изменить код, чтобы использовать константу PI.
Следующий код не вызывает никаких ошибок или предупреждений от Clippy:
fn main() {
let x = std::f64::consts::PI;
let r = 8.0;
println!("the area of the circle is {}", x * r * r);
}Для получения дополнительной информации о Clippy см. его документацию.
Интеграция с IDE с помощью rust-analyzer
Для помощи с интеграцией с IDE сообщество Rust рекомендует использовать
rust-analyzer. Этот инструмент представляет собой набор утилит, ориентированных на компилятор, которые общаются по Language Server Protocol — спецификации для взаимодействия IDE и языков программирования друг с другом. Различные клиенты могут использовать rust-analyzer, например, плагин Rust Analyzer для Visual Studio Code.
Посетите домашнюю страницу проекта rust-analyzer для получения инструкций по установке, затем установите поддержку языкового сервера в вашей конкретной IDE. Ваша IDE получит такие возможности, как автодополнение, переход к определению и встроенные ошибки.
E - Редакции
Приложение E: Редакции
В главе 1 вы увидели, что cargo new добавляет немного метаданных в ваш
файл Cargo.toml о издании. Это приложение рассказывает о том, что это значит!
Язык Rust и компилятор имеют шестинедельный цикл выпуска, что означает, что пользователи получают постоянный поток новых функций. Другие языки программирования выпускают более крупные изменения реже; Rust выпускает меньшие обновления чаще. Через некоторое время все эти крошечные изменения накапливаются. Но от выпуска к выпуску может быть трудно оглянуться назад и сказать: «Вау, между Rust 1.10 и Rust 1.31 Rust сильно изменился!»
Примерно каждые три года команда Rust выпускает новое издание Rust. Каждое издание объединяет функции, которые были реализованы, в чёткий пакет с полностью обновлённой документацией и инструментами. Новые издания поставляются как часть обычного шестинедельного процесса выпуска.
Издания служат разным целям для разных людей:
- Для активных пользователей Rust новое издание объединяет инкрементальные изменения в понятный пакет.
- Для не-пользователей новое издание сигнализирует, что были реализованы некоторые крупные достижения, что может заставить взглянуть на Rust снова.
- Для тех, кто разрабатывает Rust, новое издание предоставляет объединяющую точку для проекта в целом.
На момент написания этой книги доступны четыре издания Rust: Rust 2015, Rust 2018, Rust 2021 и Rust 2024. Эта книга написана с использованием идиом издания Rust 2024.
Ключ edition в Cargo.toml указывает, какое издание компилятор должен
использовать для вашего кода. Если ключ отсутствует, Rust использует 2015 в качестве значения
издания по причинам обратной совместимости.
Каждый проект может выбрать издание, отличное от издания по умолчанию 2015. Издания могут содержать несовместимые изменения, такие как включение нового ключевого слова, которое конфликтует с идентификаторами в коде. Однако, если вы не выберете эти изменения, ваш код будет продолжать компилироваться даже при обновлении версии компилятора Rust, которую вы используете.
Все версии компилятора Rust поддерживают любое издание, которое существовало до выпуска этого компилятора, и они могут связывать крейты любых поддерживаемых изданий вместе. Изменения издания влияют только на то, как компилятор изначально анализирует код. Поэтому, если вы используете Rust 2015 и одна из ваших зависимостей использует Rust 2018, ваш проект будет компилироваться и сможет использовать эту зависимость. Обратная ситуация, когда ваш проект использует Rust 2018, а зависимость использует Rust 2015, также работает.
Чтобы было ясно: большинство функций будут доступны во всех изданиях. Разработчики, использующие любое издание Rust, будут продолжать видеть улучшения по мере выпуска новых стабильных версий. Однако в некоторых случаях, в основном при добавлении новых ключевых слов, некоторые новые функции могут быть доступны только в более поздних изданиях. Вам нужно будет переключить издания, если вы хотите воспользоваться такими функциями.
Для получения более подробной информации см. The Rust Edition Guide. Это
полная книга, которая перечисляет различия между изданиями и объясняет, как
автоматически обновить ваш код до нового издания с помощью cargo fix.
F - Переводы книги
Приложение F: Переводы книги
Ресурсы на языках, отличных от английского. Большинство из них всё ещё в процессе; см. метку Translations, чтобы помочь или сообщить о новом переводе!
- Português (BR)
- Português (PT)
- 简体中文: KaiserY/trpl-zh-cn, gnu4cn/rust-lang-Zh_CN
- 正體中文
- Українська
- Español, alternate, Español por RustLangES
- Русский
- 한국어
- 日本語
- Français
- Polski
- Cebuano
- Tagalog
- Esperanto
- ελληνική
- Svenska
- Farsi, Persian (FA)
- Deutsch
- हिंदी
- ไทย
- Danske
- O’zbek
- Tiếng Việt
- Italiano
- বাংলা
G - Как создаётся Rust и «Nightly Rust»
Приложение G - Как создаётся Rust и «Nightly Rust»
Это приложение рассказывает о том, как создаётся Rust и как это влияет на вас как на разработчика Rust.
Стабильность без застоя
Как язык, Rust очень заботится о стабильности вашего кода. Мы хотим, чтобы Rust был прочным фундаментом, на котором можно строить, и если бы всё постоянно менялось, это было бы невозможно. В то же время, если мы не можем экспериментировать с новыми возможностями, мы можем не обнаружить важные недостатки до их выпуска, когда мы уже не сможем ничего изменить.
Наше решение этой проблемы — то, что мы называем «стабильность без застоя», и наш руководящий принцип таков: вы никогда не должны бояться обновляться до новой версии стабильного Rust. Каждое обновление должно быть безболезненным, но также должно приносить новые возможности, меньше ошибок и более быстрое время компиляции.
Ту-ту! Каналы выпуска и поезда
Разработка Rust работает по расписанию поездов. То есть вся разработка ведётся в основной ветке репозитория Rust. Выпуски следуют модели поездов программного обеспечения, которая использовалась в Cisco IOS и других программных проектах. Существует три канала выпуска для Rust:
- Nightly
- Beta
- Stable
Большинство разработчиков Rust в основном используют стабильный канал, но те, кто хочет опробовать экспериментальные новые возможности, могут использовать nightly или beta.
Вот пример того, как работает процесс разработки и выпуска: предположим, что команда Rust работает над выпуском Rust 1.5. Этот выпуск состоялся в декабре 2015 года, но он даст нам реалистичные номера версий. В Rust добавляется новая возможность: новый коммит попадает в основную ветку. Каждую ночь создаётся новая nightly-версия Rust. Каждый день — день выпуска, и эти выпуски создаются нашей инфраструктурой выпуска автоматически. Таким образом, по мере течения времени наши выпуски выглядят так, раз в ночь:
nightly: * - - * - - *
Каждые шесть недель наступает время готовить новый выпуск! Ветка beta репозитория Rust ответвляется от основной ветки, используемой nightly. Теперь есть два выпуска:
nightly: * - - * - - *
|
beta: *
Большинство пользователей Rust не используют beta-выпуски активно, но тестируют против beta в своей CI-системе, чтобы помочь Rust обнаружить возможные регрессии. Тем временем nightly-выпуск всё ещё выходит каждую ночь:
nightly: * - - * - - * - - * - - *
|
beta: *
Допустим, обнаружена регрессия. Хорошо, что у нас было время протестировать beta-выпуск до того, как регрессия просочилась в стабильный выпуск! Исправление применяется к основной ветке, так что nightly исправляется, а затем исправление переносится в ветку beta, и создаётся новый beta-выпуск:
nightly: * - - * - - * - - * - - * - - *
|
beta: * - - - - - - - - *
Через шесть недель после создания первой beta наступает время стабильного выпуска! Ветка stable создаётся из ветки beta:
nightly: * - - * - - * - - * - - * - - * - * - *
|
beta: * - - - - - - - - *
|
stable: *
Ура! Rust 1.5 готов! Однако мы забыли одну вещь: поскольку прошло шесть недель, нам также нужна новая beta следующей версии Rust, 1.6. Поэтому после того, как stable ответвляется от beta, следующая версия beta снова ответвляется от nightly:
nightly: * - - * - - * - - * - - * - - * - * - *
| |
beta: * - - - - - - - - * *
|
stable: *
Это называется «моделью поездов», потому что каждые шесть недель выпуск «отправляется со станции», но всё ещё должен пройти путь через beta-канал, прежде чем прибудет как стабильный выпуск.
Rust выпускается каждые шесть недель, как часы. Если вы знаете дату одного выпуска Rust, вы можете знать дату следующего: это шесть недель спустя. Приятный аспект запланированных выпусков каждые шесть недель заключается в том, что следующий поезд скоро придёт. Если какая-то возможность пропускает конкретный выпуск, нет нужды беспокоиться: другой произойдёт через короткое время! Это помогает снизить давление, чтобы протащить возможно неотполированные возможности ближе к крайнему сроку выпуска.
Благодаря этому процессу вы всегда можете проверить следующую сборку Rust и убедиться сами, что обновиться легко: если beta-выпуск не работает как ожидалось, вы можете сообщить об этом команде, и это будет исправлено до того, как произойдёт следующий стабильный выпуск! Поломки в beta-выпуске относительно редки, но rustc всё ещё является программным обеспечением, и ошибки существуют.
Время поддержки
Проект Rust поддерживает самую последнюю стабильную версию. Когда выпускается новая стабильная версия, старая версия достигает конца своего жизненного цикла (EOL). Это означает, что каждая версия поддерживается в течение шести недель.
Нестабильные возможности
Есть ещё одна загвоздка с этой моделью выпуска: нестабильные возможности. Rust использует технику, называемую «флагами возможностей», чтобы определить, какие возможности включены в данном выпуске. Если новая возможность находится в активной разработке, она попадает в основную ветку и, следовательно, в nightly, но за флагом возможности. Если вы, как пользователь, хотите опробовать незавершённую возможность, вы можете это сделать, но вы должны использовать nightly-выпуск Rust и аннотировать свой исходный код соответствующим флагом для включения.
Если вы используете beta- или stable-выпуск Rust, вы не можете использовать никакие флаги возможностей. Это ключ, который позволяет нам получить практическое использование новых возможностей до того, как мы объявим их стабильными навсегда. Те, кто хочет включить передовой край, могут это сделать, а те, кто хочет прочного опыта, могут оставаться на stable и знать, что их код не сломается. Стабильность без застоя.
Эта книга содержит информацию только о стабильных возможностях, так как возможности в процессе разработки всё ещё меняются и, несомненно, будут отличаться между моментом написания этой книги и моментом, когда они будут включены в стабильных сборках. Вы можете найти документацию для возможностей только для nightly онлайн.
Rustup и роль Rust Nightly
Rustup упрощает переключение между различными каналами выпуска Rust, глобально или для каждого проекта. По умолчанию у вас установлен стабильный Rust. Чтобы установить nightly, например:
$ rustup toolchain install nightly
Вы также можете увидеть все toolchain'ы (выпуски Rust и связанные компоненты), которые у вас установлены, с помощью rustup. Вот пример на компьютере с Windows одного из ваших авторов:
> rustup toolchain list
stable-x86_64-pc-windows-msvc (default)
beta-x86_64-pc-windows-msvc
nightly-x86_64-pc-windows-msvc
Как видите, stable toolchain является по умолчанию. Большинство пользователей Rust используют stable большую часть времени. Вы можете захотеть использовать stable большую часть времени, но использовать nightly для конкретного проекта, потому что вам важна передовая возможность. Для этого вы можете использовать rustup override в директории этого проекта, чтобы установить nightly toolchain как тот, который rustup должен использовать, когда вы находитесь в этой директории:
$ cd ~/projects/needs-nightly
$ rustup override set nightly
Теперь каждый раз, когда вы вызываете rustc или cargo внутри ~/projects/needs-nightly, rustup будет убеждаться, что вы используете nightly Rust, а не ваш по умолчанию stable Rust. Это удобно, когда у вас много проектов на Rust!
Процесс RFC и команды
Итак, как вы узнаёте об этих новых возможностях? Модель разработки Rust следует процессу Request For Comments (RFC). Если вы хотите улучшения в Rust, вы можете написать предложение, называемое RFC.
Любой может писать RFC для улучшения Rust, и предложения рассматриваются и обсуждаются командой Rust, которая состоит из многих тематических подкоманд. Полный список команд есть на сайте Rust, который включает команды для каждой области проекта: дизайн языка, реализация компилятора, инфраструктура, документация и многое другое. Соответствующая команда читает предложение и комментарии, пишет свои собственные комментарии и в конце концов достигается консенсус принять или отклонить возможность.
Если возможность принята, в репозитории Rust открывается issue, и кто-то может её реализовать. Человек, который её реализует, вполне может не быть человеком, который изначально предложил возможность! Когда реализация готова, она попадает в основную ветку за флагом возможности, как мы обсуждали в разделе «Нестабильные возможности».
Через некоторое время, когда разработчики Rust, использующие nightly-выпуски, смогли опробовать новую возможность, члены команды обсудят возможность, как она работает в nightly, и решат, должна ли она попасть в стабильный Rust или нет. Если решение — двигаться вперёд, флаг возможности удаляется, и возможность теперь считается стабильной! Она едет на поездах в новый стабильный выпуск Rust.