Что такое владение?
Владение — это набор правил, которые управляют тем, как программа на Rust управляет памятью. Все программы должны управлять тем, как они используют память компьютера во время работы. В некоторых языках есть сборка мусора, которая регулярно ищет неиспользуемую память во время работы программы; в других языках программист должен явно выделять и освобождать память. Rust использует третий подход: память управляется через систему владения с набором правил, которые проверяет компилятор. Если какое-либо из правил нарушается, программа не скомпилируется. Ни одна из возможностей владения не замедлит работу программы во время её выполнения.
Поскольку владение является новой концепцией для многих программистов, требуется некоторое время, чтобы к нему привыкнуть. Хорошая новость в том, что чем больше опыта вы приобретаете с Rust и правилами системы владения, тем легче вам будет естественным образом разрабатывать код, который безопасен и эффективен. Продолжайте в том же духе!
Когда вы поймёте владение, у вас будет прочная основа для понимания особенностей, которые делают Rust уникальным. В этой главе вы изучите владение, работая с некоторыми примерами, которые фокусируются на очень распространённой структуре данных: строках.
Стек и куча
Многие языки программирования не требуют, чтобы вы часто думали о стеке и куче. Но в системном языке программирования, таком как Rust, то, находится ли значение в стеке или в куче, влияет на то, как ведёт себя язык и почему вам приходится принимать определённые решения. Части владения будут описаны в связи со стеком и кучей позже в этой главе, поэтому вот краткое объяснение в качестве подготовки.
И стек, и куча являются частями памяти, доступными вашему коду для использования во время выполнения, но они структурированы по-разному. Стек хранит значения в том порядке, в котором он их получает, и удаляет значения в обратном порядке. Это называется последним пришёл — первым вышел (LIFO). Представьте стопку тарелок: когда вы добавляете тарелки, вы кладёте их наверх стопки, а когда вам нужна тарелка, вы берёте её сверху. Добавление или удаление тарелок из середины или снизу не сработало бы так хорошо! Добавление данных называется заталкиванием в стек, а удаление данных — выталкиванием из стека. Все данные, хранящиеся в стеке, должны иметь известный, фиксированный размер. Данные с неизвестным во время компиляции размером или размером, который может измениться, должны храниться в куче.
Куча менее организована: когда вы помещаете данные в кучу, вы запрашиваете определённое количество места. Распределитель памяти находит пустое место в куче, достаточно большое, помечает его как используемое и возвращает указатель, который является адресом этого места. Этот процесс называется выделением в куче и иногда сокращается просто как выделение (заталкивание значений в стек не считается выделением). Поскольку указатель на кучу имеет известный, фиксированный размер, вы можете хранить указатель в стеке, но когда вам нужны фактические данные, вы должны проследовать по указателю. Представьте, что вас усаживают в ресторане. Когда вы входите, вы называете количество человек в вашей группе, и хостес находит пустой столик, подходящий для всех, и провожает вас туда. Если кто-то из вашей группы приходит поздно, они могут спросить, где вас посадили, чтобы найти вас.
Заталкивание в стек быстрее, чем выделение в куче, потому что распределителю никогда не нужно искать место для хранения новых данных; это место всегда на вершине стека. Для сравнения, выделение места в куче требует больше работы, потому что распределитель должен сначала найти достаточно большое пространство для хранения данных, а затем выполнить учёт, чтобы подготовиться к следующему выделению.
Доступ к данным в куче обычно медленнее, чем доступ к данным в стеке, потому что вам нужно проследовать по указателю, чтобы добраться до них. Современные процессоры работают быстрее, если они меньше прыгают по памяти. Продолжая аналогию, рассмотрим официанта в ресторане, принимающего заказы от многих столиков. Наиболее эффективно принять все заказы за одним столиком, прежде чем переходить к следующему. Принятие заказа от столика A, затем заказа от столика B, затем снова от A и затем снова от B было бы гораздо более медленным процессом. По той же причине процессор обычно может выполнять свою работу лучше, если он работает с данными, которые близки к другим данным (как в стеке), а не дальше (как может быть в куче).
Когда ваш код вызывает функцию, значения, переданные в функцию (включая, возможно, указатели на данные в куче), и локальные переменные функции заталкиваются в стек. Когда функция завершается, эти значения выталкиваются из стека.
Отслеживание того, какие части кода используют какие данные в куче, минимизация объёма дублирующихся данных в куче и очистка неиспользуемых данных в куче, чтобы не закончилось место — всё это проблемы, которые решает владение. Как только вы поймёте владение, вам не нужно будет часто думать о стеке и куче. Но знание того, что основная цель владения — управление данными в куче, может помочь объяснить, почему оно работает так, как работает.
Правила владения
Сначала давайте посмотрим на правила владения. Держите эти правила в уме, пока мы работаем с примерами, которые их иллюстрируют:
- Каждое значение в Rust имеет владельца.
- В каждый момент времени может быть только один владелец.
- Когда владелец выходит из области видимости, значение будет удалено.
Область видимости переменной
Теперь, когда мы прошли базовый синтаксис Rust, мы не будем включать весь код fn main() { в примеры, поэтому, если вы следите за книгой, убедитесь, что вы вручную помещаете следующие примеры внутрь функции main. В результате наши примеры будут немного более краткими, что позволит нам сосредоточиться на фактических деталях, а не на шаблонном коде.
В качестве первого примера владения мы рассмотрим область видимости некоторых переменных. Область видимости — это диапазон в программе, для которого элемент является действительным. Возьмём следующую переменную:
#![allow(unused)]
fn main() {
let s = "hello";
}
Переменная s ссылается на строковый литерал, где значение строки жёстко закодировано в тексте нашей программы. Переменная действительна с момента её объявления до конца текущей области видимости. В листинге 4-1 показана программа с комментариями, аннотирующими, где переменная s была бы действительной.
fn main() {
    {                      // s не действительна здесь, так как она ещё не объявлена
        let s = "hello";   // s действительна с этого момента

        // делаем что-то с s
    }                      // эта область видимости теперь закончилась, и s больше не действительна
}Другими словами, здесь есть два важных момента времени:
- Когда
sвходит в область видимости, она действительна. - Она остаётся действительной, пока не выйдет из области видимости.
На данный момент связь между областями видимости и тем, когда переменные действительны, аналогична той, что в других языках программирования. Теперь мы будем строить на основе этого понимания, вводя тип String.
Тип String
Чтобы проиллюстрировать правила владения, нам нужен тип данных, который сложнее тех, что мы рассмотрели в разделе «Типы данных» главы 3. Рассмотренные ранее типы имеют известный размер, могут храниться в стеке и выталкиваться из стека, когда их область видимости заканчивается, и могут быстро и тривиально копироваться для создания нового независимого экземпляра, если другой части кода нужно использовать то же значение в другой области видимости. Но мы хотим рассмотреть данные, которые хранятся в куче, и изучить, как Rust узнаёт, когда очищать эти данные, и тип String — отличный пример.
Мы сосредоточимся на частях String, которые связаны с владением. Эти аспекты также применимы к другим сложным типам данных, будь то предоставленные стандартной библиотекой или созданные вами. Мы обсудим аспекты String, не связанные с владением, в главе 8.
Мы уже видели строковые литералы, где строковое значение жёстко закодировано в нашей программе. Строковые литералы удобны, но они не подходят для каждой ситуации, в которой мы можем захотеть использовать текст. Одна из причин — они неизменяемы. Другая — не каждое строковое значение может быть известно при написании кода: например, что если мы хотим взять пользовательский ввод и сохранить его? Именно для таких ситуаций в Rust есть тип String. Этот тип управляет данными, размещёнными в куче, и, таким образом, может хранить объём текста, неизвестный нам во время компиляции. Вы можете создать String из строкового литерала, используя функцию from, вот так:
#![allow(unused)]
fn main() {
let s = String::from("hello");
}
Оператор двойного двоеточия :: позволяет нам поместить эту конкретную функцию from в пространство имён под типом String, а не использовать какое-то имя вроде string_from. Мы обсудим этот синтаксис подробнее в разделе «Методы» главы 5 и когда будем говорить о пространствах имён с модулями в разделе «Пути для ссылки на элемент в дереве модулей» главы 7.
Этот вид строки можно изменять:
fn main() {
    let mut s = String::from("hello");

    s.push_str(", world!"); // push_str() добавляет литерал к String

    println!("{s}"); // это напечатает `hello, world!`
}
Итак, в чём разница? Почему String можно изменять, а литералы — нет? Разница в том, как эти два типа работают с памятью.
Память и выделение
В случае строкового литерала мы знаем содержимое во время компиляции, поэтому текст жёстко закодирован непосредственно в конечный исполняемый файл. Вот почему строковые литералы быстры и эффективны. Но эти свойства происходят только из неизменяемости строкового литерала. К сожалению, мы не можем поместить блок памяти в бинарный файл для каждого фрагмента текста, размер которого неизвестен во время компиляции и может меняться во время работы программы.
С типом String, чтобы поддерживать изменяемый, расширяемый фрагмент текста, нам нужно выделить в куче количество памяти, неизвестное во время компиляции, для хранения содержимого. Это означает:
- Память должна быть запрошена у распределителя памяти во время выполнения.
- Нам нужен способ вернуть эту память распределителю, когда мы закончим с нашей
String.
Первую часть выполняем мы: когда мы вызываем String::from, его реализация запрашивает необходимую память. Это практически универсально в языках программирования.
Однако вторая часть отличается. В языках со сборщиком мусора (GC) сборщик мусора отслеживает и очищает память, которая больше не используется, и нам не нужно об этом думать. В большинстве языков без сборщика мусора наша ответственность — определить, когда память больше не используется, и вызвать код для её явного освобождения, точно так же, как мы это делали для её запроса. Правильно делать это исторически было сложной задачей программирования. Если мы забудем, мы будем тратить память впустую. Если мы сделаем это слишком рано, у нас будет недействительная переменная. Если мы сделаем это дважды, это тоже ошибка. Нам нужно соединить ровно один allocate ровно с одним free.
Rust выбирает другой путь: память автоматически возвращается, как только переменная, которая ею владеет, выходит из области видимости. Вот версия нашего примера области видимости из листинга 4-1, использующая String вместо строкового литерала:
fn main() {
    {
        let s = String::from("hello"); // s действительна с этого момента

        // делаем что-то с s
    }                                  // эта область видимости теперь закончилась, и s больше не
                                       // действительна
}
Есть естественный момент, когда мы можем вернуть память, необходимую нашей String, распределителю: когда s выходит из области видимости. Когда переменная выходит из области видимости, Rust вызывает для нас специальную функцию. Эта функция называется drop, и именно в ней автор String может разместить код для возврата памяти. Rust вызывает drop автоматически на закрывающей фигурной скобке.
Примечание: В C++ этот шаблон освобождения ресурсов в конце времени жизни элемента иногда называют Получение ресурса есть инициализация (Resource Acquisition Is Initialization, RAII). Функция drop в Rust будет знакома вам, если вы использовали шаблоны RAII.
Этот шаблон оказывает глубокое влияние на то, как пишется код на Rust. Сейчас это может показаться простым, но поведение кода может быть неожиданным в более сложных ситуациях, когда мы хотим, чтобы несколько переменных использовали данные, которые мы выделили в куче. Давайте рассмотрим некоторые из этих ситуаций прямо сейчас.
Взаимодействие переменных и данных при перемещении
Несколько переменных могут взаимодействовать с одними и теми же данными в Rust по-разному. В листинге 4-2 показан пример с целым числом.
fn main() {
    let x = 5;
    let y = x;
}x переменной yМы, вероятно, можем догадаться, что здесь происходит: «Связать значение 5 с x; затем сделать копию значения в x и связать её с y». Теперь у нас есть две переменные, x и y, и обе равны 5. Это действительно то, что происходит, потому что целые числа — это простые значения с известным, фиксированным размером, и эти два значения 5 заталкиваются в стек.
Теперь давайте посмотрим на версию со String:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;
}
Это выглядит очень похоже, поэтому мы могли бы предположить, что способ работы будет таким же: то есть вторая строка сделает копию значения в s1 и свяжет её с s2. Но это не совсем то, что происходит.
Взгляните на рисунок 4-1, чтобы увидеть, что происходит со String под капотом. String состоит из трёх частей, показанных слева: указатель на память, которая содержит содержимое строки, длина и ёмкость. Эта группа данных хранится в стеке. Справа — память в куче, которая содержит содержимое.
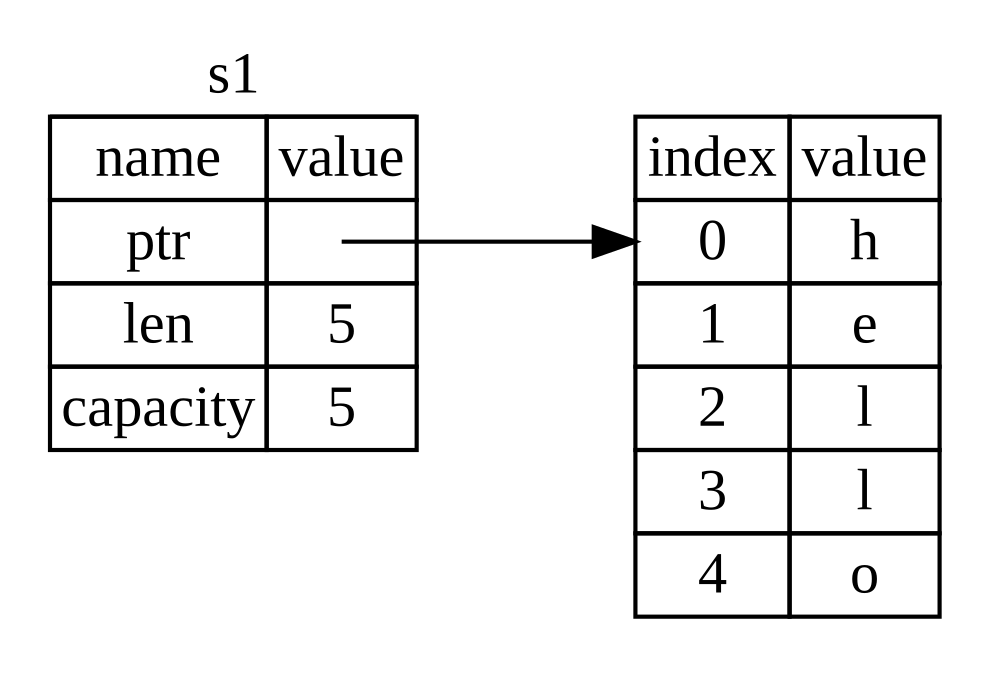
Рисунок 4-1: Представление в памяти String
содержащей значение "hello", связанной с s1
Длина — это сколько памяти в байтах содержимое String в настоящее время использует. Ёмкость — это общий объём памяти в байтах, который String получил от распределителя. Разница между длиной и ёмкостью важна, но не в этом контексте, поэтому пока можно игнорировать ёмкость.
Когда мы присваиваем s1 к s2, данные String копируются, что означает, что мы копируем указатель, длину и ёмкость, которые находятся в стеке. Мы не копируем данные в куче, на которые указывает указатель. Другими словами, представление данных в памяти выглядит как на рисунке 4-2.
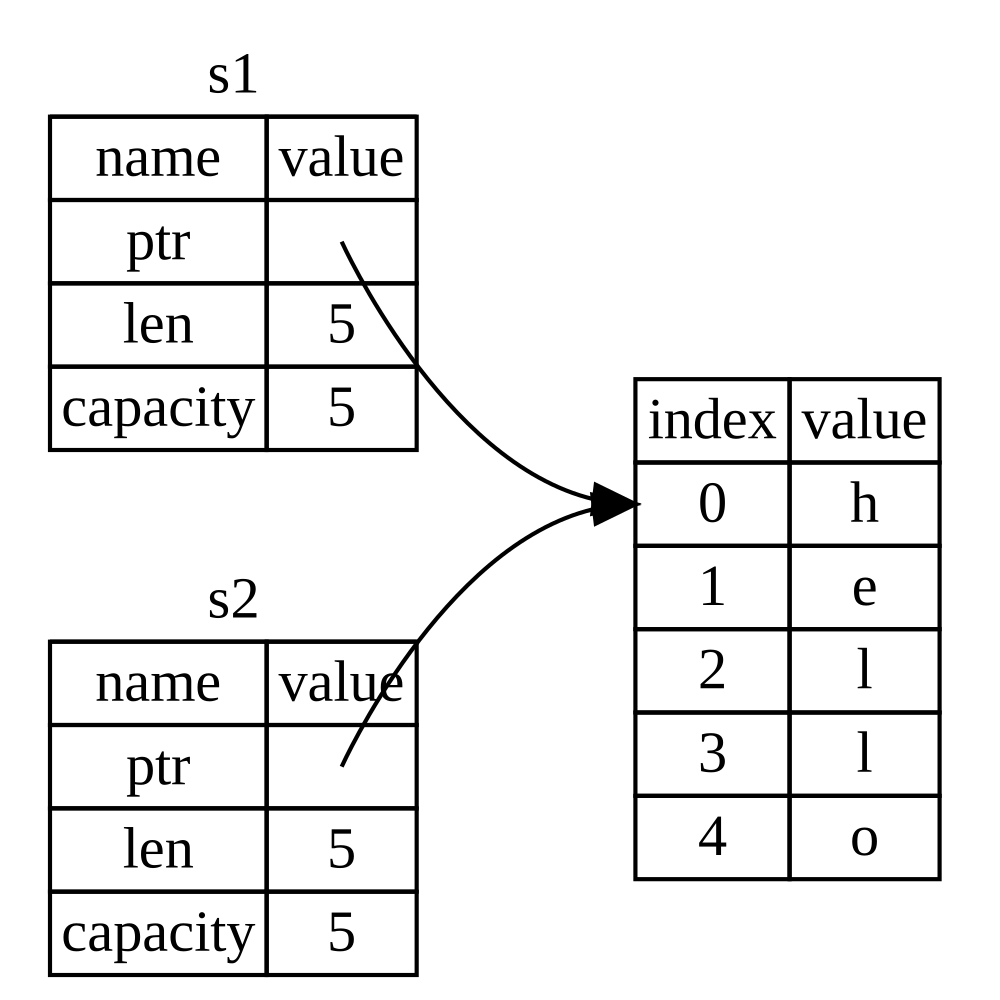
Рисунок 4-2: Представление в памяти переменной
s2, которая имеет копию указателя, длины и ёмкости s1
Представление не выглядит как на рисунке 4-3, который показывает, как выглядела бы память, если бы Rust вместо этого скопировал и данные в куче. Если бы Rust сделал это, операция s2 = s1 могла бы быть очень дорогой с точки зрения производительности во время выполнения, если бы данные в куче были большими.
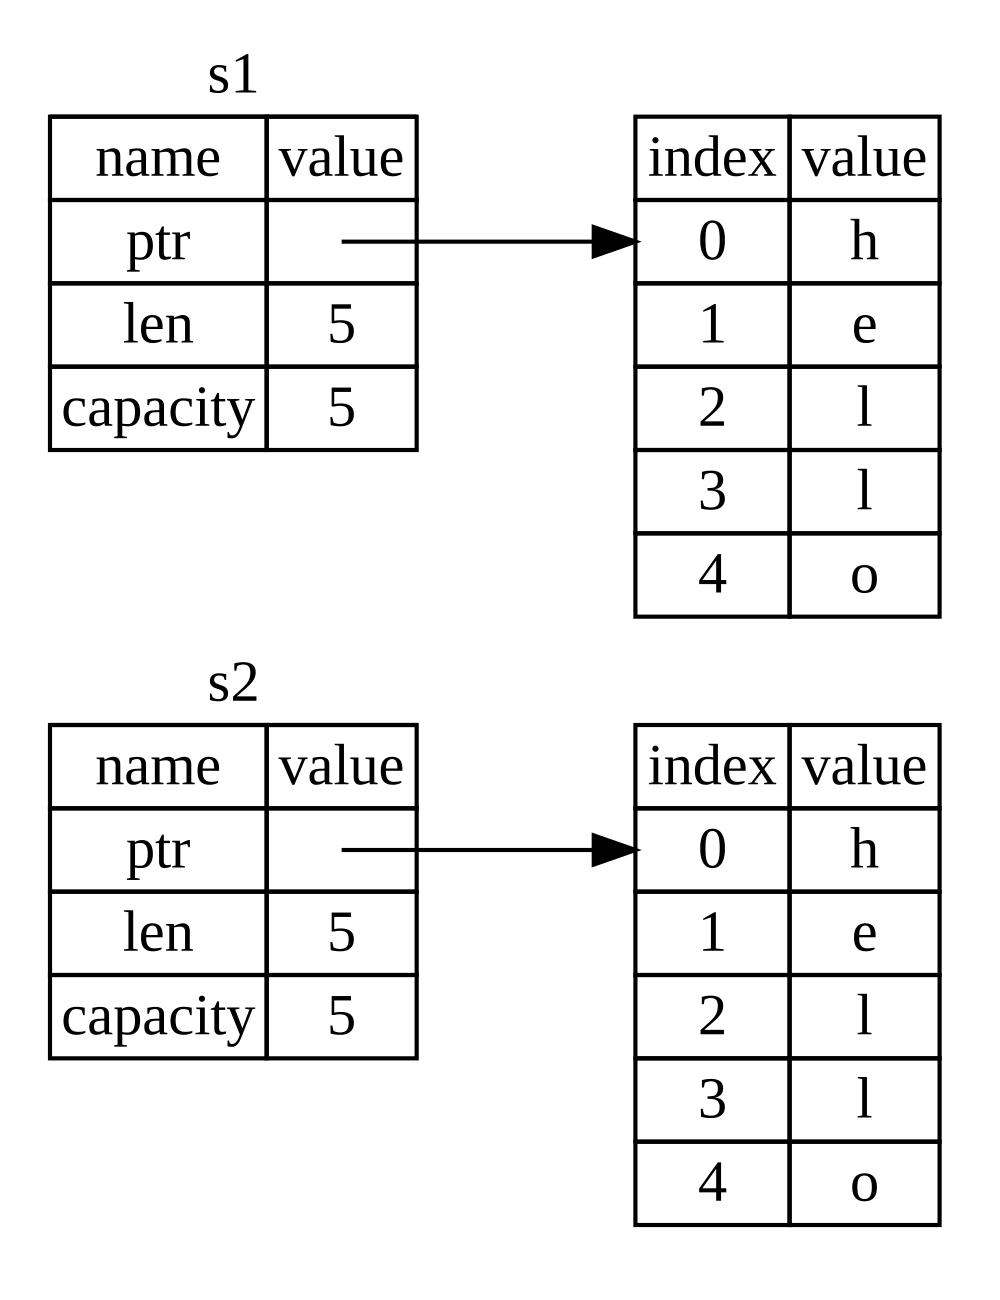
Рисунок 4-3: Другая возможность для того, что s2 = s1
мог бы сделать, если бы Rust также скопировал данные в куче
Ранее мы говорили, что когда переменная выходит из области видимости, Rust автоматически вызывает функцию drop и очищает память в куче для этой переменной. Но рисунок 4-2 показывает, что оба указателя на данные указывают на одно и то же место. Это проблема: когда s2 и s1 выйдут из области видимости, они обе попытаются освободить одну и ту же память. Это известно как ошибка двойного освобождения и является одной из ошибок безопасности памяти, которые мы упоминали ранее. Освобождение памяти дважды может привести к повреждению памяти, что потенциально может привести к уязвимостям безопасности.
Чтобы обеспечить безопасность памяти, после строки let s2 = s1; Rust считает s1 больше не действительной. Поэтому Rust не нужно ничего освобождать, когда s1 выходит из области видимости. Посмотрите, что происходит, когда вы пытаетесь использовать s1 после создания s2; это не сработает:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;

    println!("{s1}, world!");
}
Вы получите ошибку, подобную этой, потому что Rust предотвращает использование недействительной ссылки:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0382]: borrow of moved value: `s1`
 --> src/main.rs:5:16
  |
2 |     let s1 = String::from("hello");
  |         -- move occurs because `s1` has type `String`, which does not implement the `Copy` trait
3 |     let s2 = s1;
  |              -- value moved here
4 |
5 |     println!("{s1}, world!");
  |                ^^ value borrowed here after move
  |
help: consider cloning the value if the performance cost is acceptable
  |
3 |     let s2 = s1.clone();
  |                ++++++++

For more information about this error, try `rustc --explain E0382`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Если вы слышали термины поверхностное копирование и глубокое копирование при работе с другими языками, концепция копирования указателя, длины и ёмкости без копирования данных, вероятно, звучит как поверхностное копирование. Но поскольку Rust также делает первую переменную недействительной, вместо того чтобы называться поверхностным копированием, это известно как перемещение. В этом примере мы бы сказали, что s1 была перемещена в s2. Итак, что на самом деле происходит, показано на рисунке 4-4.
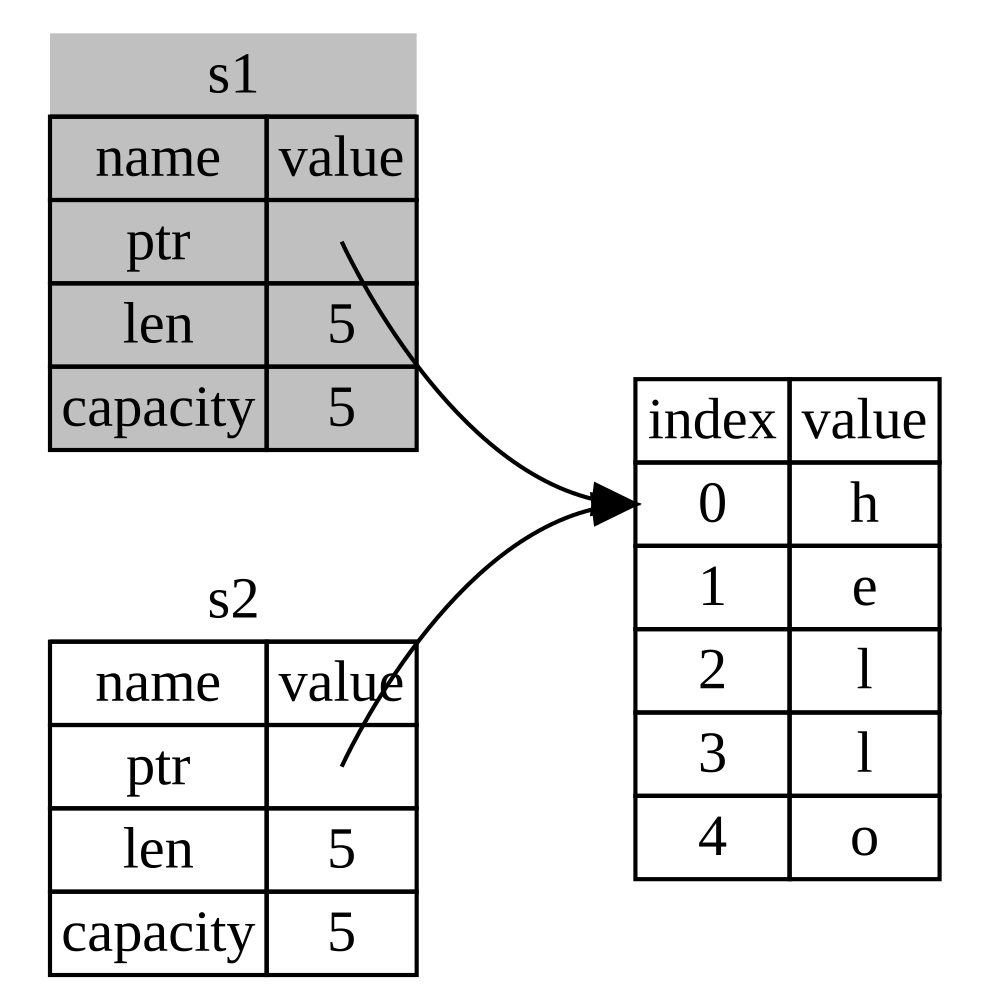
Рисунок 4-4: Представление в памяти после того, как s1
была сделана недействительной
Это решает нашу проблему! Когда действительна только s2, когда она выходит из области видимости, только она освободит память, и мы закончили.
Кроме того, есть выбор дизайна, который подразумевается этим: Rust никогда не будет автоматически создавать «глубокие» копии ваших данных. Следовательно, любое автоматическое копирование можно считать недорогим с точки зрения производительности во время выполнения.
Область видимости и присваивание
Обратное верно для отношения между областью видимости, владением и освобождением памяти через функцию drop. Когда вы присваиваете совершенно новое значение существующей переменной, Rust вызовет drop и немедленно освободит память исходного значения. Рассмотрим этот код, например:
fn main() {
    let mut s = String::from("hello");
    s = String::from("ahoy");

    println!("{s}, world!");
}
Сначала мы объявляем переменную s и связываем её с String со значением "hello". Затем мы сразу создаём новую String со значением "ahoy" и присваиваем её s. В этот момент на исходное значение в куче вообще ничего не ссылается. Рисунок 4-5 иллюстрирует данные стека и кучи теперь:
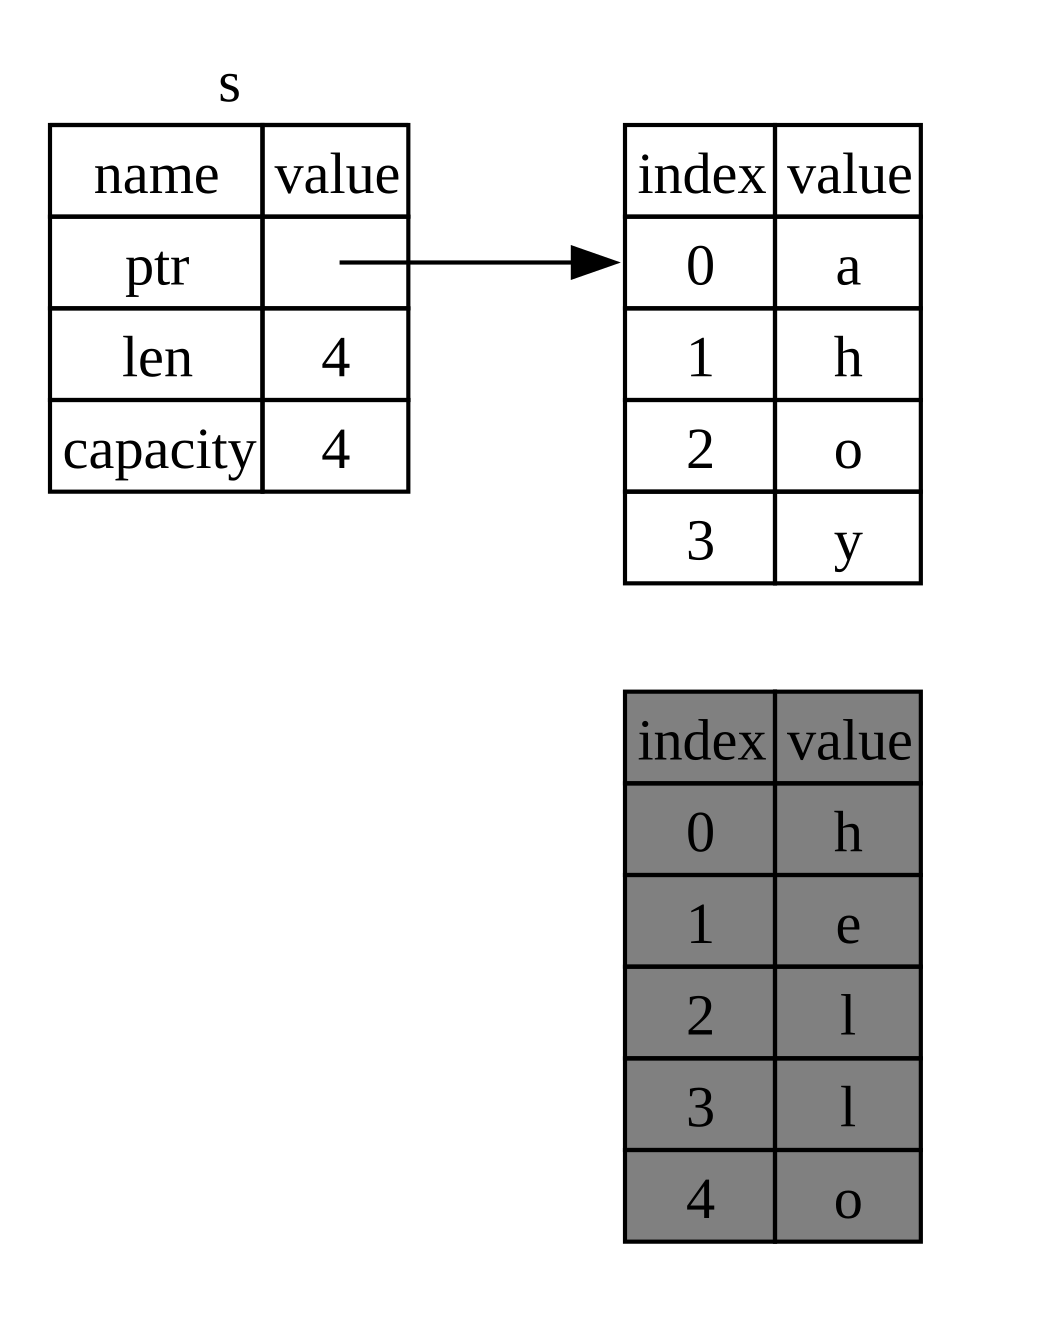
Рисунок 4-5: Представление в памяти после того, как исходное значение было полностью заменено
Таким образом, исходная строка сразу выходит из области видимости. Rust запустит функцию drop для неё, и её память будет немедленно освобождена. Когда мы печатаем значение в конце, это будет "ahoy, world!".
Взаимодействие переменных и данных при клонировании
Если мы действительно хотим глубоко скопировать данные String в куче, а не только данные стека, мы можем использовать распространённый метод, называемый clone. Мы обсудим синтаксис методов в главе 5, но поскольку методы являются распространённой особенностью многих языков программирования, вы, вероятно, видели их раньше.
Вот пример метода clone в действии:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1.clone();

    println!("s1 = {s1}, s2 = {s2}");
}
Это работает просто отлично и явно производит поведение, показанное на рисунке 4-3, где данные в куче действительно копируются.
Когда вы видите вызов clone, вы знаете, что выполняется какой-то произвольный код, и этот код может быть дорогим. Это визуальный индикатор того, что происходит что-то другое.
Данные только в стеке: Copy
Есть ещё одна морщина, о которой мы ещё не говорили. Этот код, использующий целые числа — часть которого была показана в листинге 4-2 — работает и является допустимым:
fn main() {
    let x = 5;
    let y = x;

    println!("x = {x}, y = {y}");
}
Но этот код, кажется, противоречит тому, что мы только что узнали: у нас нет вызова clone, но x всё ещё действительна и не была перемещена в y.
Причина в том, что типы, такие как целые числа, которые имеют известный размер во время компиляции, хранятся полностью в стеке, поэтому копии фактических значений создаются быстро. Это означает, что нет причин, по которым мы хотели бы предотвратить x от того, чтобы быть действительной после создания переменной y. Другими словами, здесь нет разницы между глубоким и поверхностным копированием, поэтому вызов clone не сделал бы ничего отличного от обычного поверхностного копирования, и мы можем его опустить.
В Rust есть специальная аннотация, называемая трейтом Copy, которую мы можем разместить на типах, которые хранятся в стеке, как целые числа (мы поговорим больше о трейтах в главе 10). Если тип реализует трейт Copy, переменные, которые его используют, не перемещаются, а тривиально копируются, что делает их всё ещё действительными после присваивания другой переменной.
Rust не позволит нам аннотировать тип с помощью Copy, если тип или любая из его частей реализовала трейт Drop. Если типу нужно что-то особенное, чтобы произойти, когда значение выходит из области видимости, и мы добавляем аннотацию Copy к этому типу, мы получим ошибку времени компиляции. Чтобы узнать, как добавить аннотацию Copy к вашему типу для реализации трейта, см. «Выводимые трейты» в Приложении C.
Итак, какие типы реализуют трейт Copy? Вы можете проверить документацию для данного типа, чтобы убедиться, но как общее правило, любая группа простых скалярных значений может реализовать Copy, и ничего, что требует выделения памяти или является какой-либо формой ресурса, не может реализовать Copy. Вот некоторые из типов, которые реализуют Copy:
- Все целочисленные типы, такие как
u32. - Логический тип
boolсо значениямиtrueиfalse. - Все типы с плавающей запятой, такие как
f64. - Символьный тип
char. - Кортежи, если они содержат только типы, которые также реализуют
Copy. Например,(i32, i32)реализуетCopy, а(i32, String)— нет.
Владение и функции
Механика передачи значения в функцию аналогична механике присваивания значения переменной. Передача переменной в функцию будет перемещать или копировать, как и присваивание. В листинге 4-3 приведён пример с некоторыми аннотациями, показывающими, где переменные входят в область видимости и выходят из неё.
fn main() {
    let s = String::from("hello");  // s входит в область видимости

    takes_ownership(s);             // значение s перемещается в функцию...
                                    // ... и поэтому здесь больше не действительно

    let x = 5;                      // x входит в область видимости

    makes_copy(x);                  // Поскольку i32 реализует трейт Copy,
                                    // x НЕ перемещается в функцию,
                                    // поэтому x можно использовать позже.

} // Здесь x выходит из области видимости, затем s. Однако, поскольку значение s было перемещено,
  // ничего особенного не происходит.

fn takes_ownership(some_string: String) { // some_string входит в область видимости
    println!("{some_string}");
} // Здесь some_string выходит из области видимости и вызывается `drop`. Память
  // освобождается.

fn makes_copy(some_integer: i32) { // some_integer входит в область видимости
    println!("{some_integer}");
} // Здесь some_integer выходит из области видимости. Ничего особенного не происходит.Если бы мы попытались использовать s после вызова takes_ownership, Rust выдал бы ошибку времени компиляции. Эти статические проверки защищают нас от ошибок. Попробуйте добавить код в main, который использует s и x, чтобы увидеть, где вы можете их использовать, а где правила владения мешают вам это делать.
Возвращаемые значения и область видимости
Возврат значений также может передавать владение. В листинге 4-4 показан пример функции, которая возвращает некоторое значение, с аннотациями, подобными тем, что в листинге 4-3.
fn main() {
    let s1 = gives_ownership();        // gives_ownership перемещает своё возвращаемое
                                       // значение в s1

    let s2 = String::from("hello");    // s2 входит в область видимости

    let s3 = takes_and_gives_back(s2); // s2 перемещается в
                                       // takes_and_gives_back, которая также
                                       // перемещает своё возвращаемое значение в s3
} // Здесь s3 выходит из области видимости и удаляется. s2 была перемещена, поэтому ничего
  // не происходит. s1 выходит из области видимости и удаляется.

fn gives_ownership() -> String {       // gives_ownership переместит своё
                                       // возвращаемое значение в функцию,
                                       // которая её вызывает

    let some_string = String::from("yours"); // some_string входит в область видимости

    some_string                        // some_string возвращается и
                                       // перемещается в вызывающую
                                       // функцию
}

// Эта функция принимает String и возвращает String.
fn takes_and_gives_back(a_string: String) -> String {
    // a_string входит в
    // область видимости

    a_string  // a_string возвращается и перемещается в вызывающую функцию
}Владение переменной следует одному и тому же шаблону каждый раз: присваивание значения другой переменной перемещает его. Когда переменная, которая включает данные в куче, выходит из области видимости, значение будет очищено с помощью drop, если владение данными не было перемещено в другую переменную.
Хотя это работает, брать на себя владение, а затем возвращать владение с каждой функцией немного утомительно. Что если мы хотим позволить функции использовать значение, но не брать на себя владение? Довольно раздражает, что всё, что мы передаём, также нужно передавать обратно, если мы хотим использовать это снова, в дополнение к любым данным, полученным в результате работы тела функции, которые мы, возможно, также хотим вернуть.
Rust действительно позволяет нам возвращать несколько значений, используя кортеж, как показано в листинге 4-5.
fn main() {
    let s1 = String::from("hello");

    let (s2, len) = calculate_length(s1);

    println!("The length of '{s2}' is {len}.");
}

fn calculate_length(s: String) -> (String, usize) {
    let length = s.len(); // len() возвращает длину String

    (s, length)
}Но это слишком много церемоний и много работы для концепции, которая должна быть обычной. К счастью для нас, в Rust есть функция для использования значения без передачи владения: ссылки.