Тип срез
Срезы позволяют ссылаться на непрерывную последовательность элементов в коллекции. Срез — это разновидность ссылки, поэтому он не владеет данными.
Вот небольшая задача по программированию: написать функцию, которая принимает строку слов, разделённых пробелами, и возвращает первое слово, найденное в этой строке. Если функция не находит пробел в строке, вся строка должна быть одним словом, поэтому вся строка должна быть возвращена.
Примечание: для целей знакомства со срезами предполагается, что в этом разделе используется только ASCII; более подробное обсуждение обработки UTF-8 находится в разделе «Хранение текста в кодировке UTF-8 с помощью строк» главы 8.
Рассмотрим, как написать сигнатуру этой функции без использования срезов, чтобы понять проблему, которую решают срезы:
fn first_word(s: &String) -> ?Функция first_word имеет параметр типа &String. Владение не нужно,
так что это нормально. (В идиоматичном Rust функции не забирают владение
своими аргументами, если в этом нет необходимости, и причины этого станут
ясны по ходу изложения.) Но что следует возвращать? В действительности нет способа
описать часть строки. Однако можно вернуть индекс конца
слова, обозначенный пробелом. Попробуем это, как показано в листинге 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}first_word, возвращающая значение байтового индекса в параметр StringПоскольку требуется пройти по String поэлементно и проверить, является ли
значение пробелом, String преобразуется в массив байтов с помощью метода
as_bytes.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Далее создаётся итератор по массиву байтов с помощью метода iter:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Итераторы подробнее рассматриваются в главе 13.
Пока достаточно знать, что iter — это метод, возвращающий каждый элемент коллекции,
а enumerate обёртывает результат iter и возвращает каждый элемент как
часть кортежа. Первый элемент кортежа, возвращаемого
enumerate, — это индекс, а второй элемент — ссылка на элемент.
Это немного удобнее, чем вычислять индекс самостоятельно.
Поскольку метод enumerate возвращает кортеж, можно использовать шаблоны для
деструктуризации этого кортежа. Шаблоны подробнее рассматриваются в главе
6. В цикле for указан шаблон, в котором i
обозначает индекс в кортеже, а &item — отдельный байт в кортеже.
Поскольку из .iter().enumerate() получена ссылка на элемент, в
шаблоне используется &.
Внутри цикла for выполняется поиск байта, представляющего пробел, с помощью
синтаксиса байтового литерала. Если найден пробел, возвращается позиция.
В противном случае возвращается длина строки с помощью s.len().
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Теперь есть способ найти индекс конца первого слова в
строке, но есть проблема. Возвращается usize сам по себе, но это
осмысленное число только в контексте &String. Другими словами,
поскольку это отдельное значение от String, нет гарантии, что оно
останется действительным в будущем. Рассмотрим программу в листинге 4-8, которая
использует функцию first_word из листинга 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s); // word получит значение 5

    s.clear(); // это очищает String, делая её равной ""

    // здесь word всё ещё имеет значение 5, но s больше не содержит содержимого, которое
    // можно было бы осмысленно использовать со значением 5, поэтому word теперь полностью недействителен!
}first_word с последующим изменением содержимого StringЭта программа компилируется без ошибок, и это было бы так же, если бы word
использовалась после вызова s.clear(). Поскольку word вообще не связана с состоянием
s, word по-прежнему содержит значение 5. Можно было бы использовать это значение 5 с
переменной s, чтобы попытаться извлечь первое слово, но это было бы ошибкой,
потому что содержимое s изменилось с момента сохранения 5 в word.
Необходимость беспокоиться о том, что индекс в word рассинхронизируется с данными в
s, утомительна и подвержена ошибкам! Управление этими индексами становится ещё более хрупким, если
написать функцию second_word. Её сигнатура должна была бы выглядеть так:
fn second_word(s: &String) -> (usize, usize) {Теперь приходится отслеживать начальный и конечный индекс, и появляется ещё больше значений, которые были вычислены из данных в определённом состоянии, но вообще не привязаны к этому состоянию. Вокруг летают три несвязанные переменные, которые нужно поддерживать в синхронизации.
К счастью, в Rust есть решение этой проблемы: строковые срезы.
Строковые срезы
Строковый срез — это ссылка на непрерывную последовательность элементов
String, и он выглядит так:
fn main() {
    let s = String::from("hello world");

    let hello = &s[0..5];
    let world = &s[6..11];
}
Вместо ссылки на всю String, hello — это ссылка на
часть String, указанную в дополнительной части [0..5]. Срезы создаются
с помощью диапазона в квадратных скобках, указывая
[starting_index..ending_index], где starting_index — первая
позиция в срезе, а ending_index — на единицу больше последней позиции
в срезе. Внутри структура данных среза хранит начальную позицию
и длину среза, что соответствует ending_index минус
starting_index. Таким образом, в случае let world = &s[6..11]; переменная world была бы
срезом, содержащим указатель на байт с индексом 6 в s и значение длины
5.
На рисунке 4-7 это показано на диаграмме.
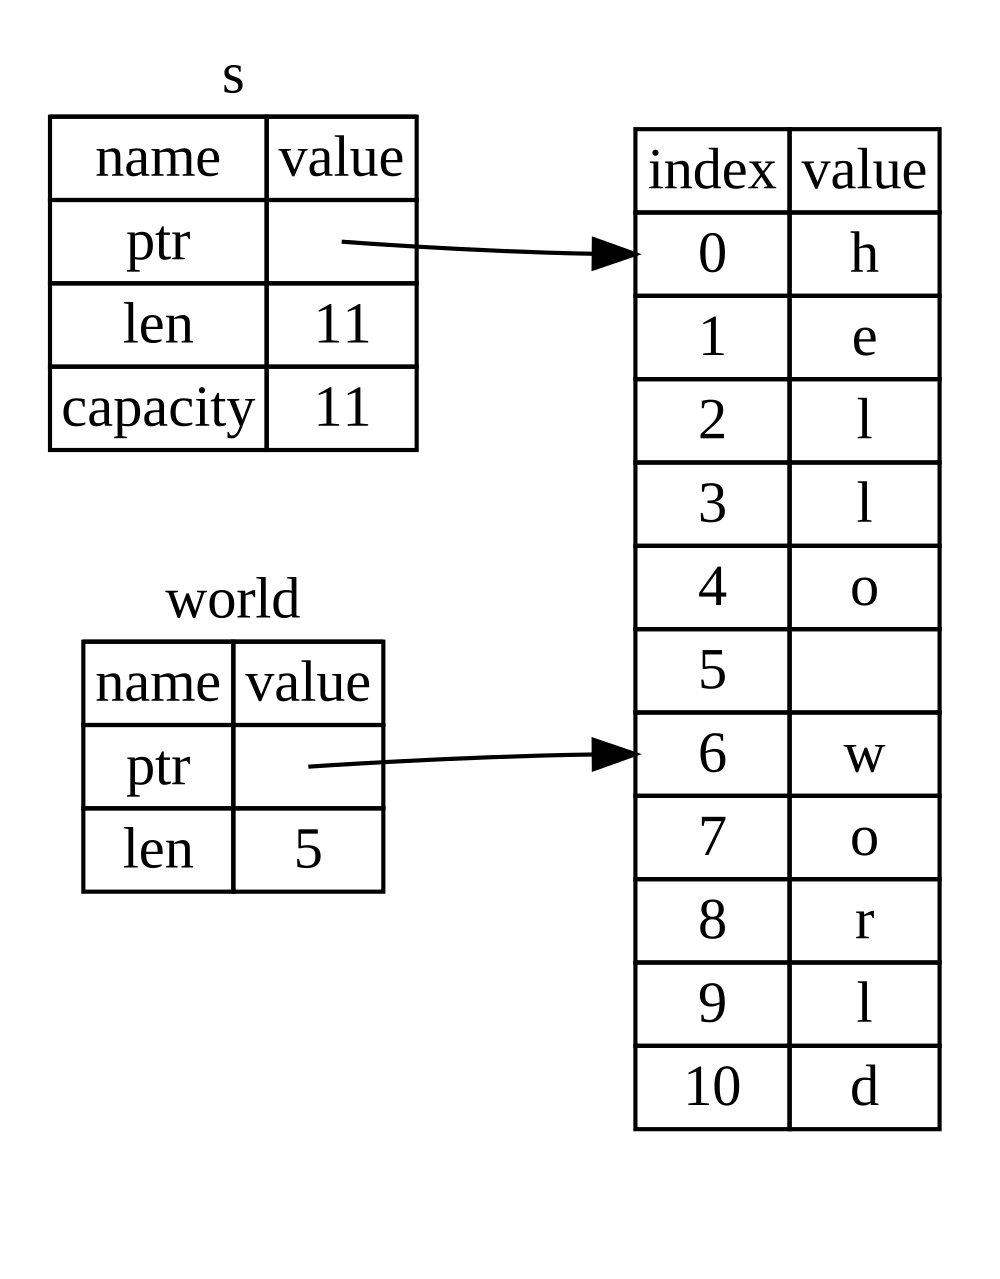
Рисунок 4-7: Строковый срез, ссылающийся на часть
String
С синтаксисом диапазонов .. в Rust, если нужно начать с индекса 0, можно опустить
значение перед двумя точками. Иными словами, эти строки эквивалентны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let slice = &s[0..2];
let slice = &s[..2];
}
Таким же образом, если срез включает последний байт String,
можно опустить завершающее число. Это означает, что эти строки эквивалентны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[3..len];
let slice = &s[3..];
}
Можно также опустить оба значения, чтобы взять срез всей строки. Итак, эти строки эквивалентны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[0..len];
let slice = &s[..];
}
Примечание: индексы диапазона строкового среза должны попадать на границы допустимых символов UTF-8. При попытке создать строковый срез в середине многобайтового символа программа завершится с ошибкой.
Учитывая всю эту информацию, перепишем first_word так, чтобы она возвращала
срез. Тип, обозначающий «строковый срез», записывается как &str:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {}
Индекс конца слова получается так же, как в листинге 4-7, путём поиска первого вхождения пробела. Когда найден пробел, возвращается строковый срез, использующий начало строки и индекс пробела в качестве начального и конечного индексов.
Теперь при вызове first_word возвращается одно значение, привязанное к
базовым данным. Значение состоит из ссылки на начальную точку
среза и количества элементов в срезе.
Возврат среза также сработал бы для функции second_word:
fn second_word(s: &String) -> &str {Теперь есть простой в использовании API, который гораздо сложнее испортить, потому что
компилятор гарантирует, что ссылки на String останутся действительными.
Вспомним ошибку в программе из листинга 4-8, когда был получен индекс
конца первого слова, но затем строка была очищена, и индекс стал недействительным.
Тот код был логически некорректен, но не показывал немедленных ошибок. Проблемы
проявились бы позже, если бы продолжались попытки использовать индекс первого слова с
опустошённой строкой. Срезы делают эту ошибку невозможной и позволяют гораздо раньше узнать,
что в коде есть проблема. Использование версии first_word со срезом
вызовет ошибку времени компиляции:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s);

    s.clear(); // ошибка!

    println!("the first word is: {word}");
}
Вот ошибка компилятора:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
  --> src/main.rs:18:5
   |
16 |     let word = first_word(&s);
   |                           -- immutable borrow occurs here
17 |
18 |     s.clear(); // ошибка!
   |     ^^^^^^^^^ mutable borrow occurs here
19 |
20 |     println!("the first word is: {word}");
   |                                   ---- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Вспомним из правил заимствования, что если есть неизменяемая ссылка на
что-либо, нельзя также взять изменяемую ссылку. Поскольку clear нужно
обрезать String, требуется получить изменяемую ссылку. println!
после вызова clear использует ссылку в word, поэтому неизменяемая
ссылка должна оставаться активной в этой точке. Rust запрещает изменяемой
ссылке в clear и неизменяемой ссылке в word существовать одновременно, и компиляция
не удаётся. Rust не только сделал API проще в использовании,
но и устранил целый класс ошибок на этапе компиляции!
Строковые литералы как срезы
Вспомним, что строковые литералы хранятся внутри бинарного файла. Теперь, когда известно о срезах, можно правильно понять строковые литералы:
#![allow(unused)]
fn main() {
let s = "Hello, world!";
}
Тип s здесь — &str: это срез, указывающий на конкретную точку
бинарного файла. Именно поэтому строковые литералы неизменяемы; &str —
неизменяемая ссылка.
Строковые срезы как параметры
Знание того, что можно брать срезы от литералов и значений String, приводит к
ещё одному улучшению first_word, а именно к её сигнатуре:
fn first_word(s: &String) -> &str {Более опытный Rustacean написал бы сигнатуру, показанную в листинге 4-9,
потому что она позволяет использовать одну и ту же функцию как со значениями &String,
так и со значениями &str.
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` работает со срезами `String`, как частичными, так и целыми.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` также работает со ссылками на `String`, которые эквивалентны
    // целым срезам `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` работает со срезами строковых литералов, как частичными, так и
    // целыми.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Поскольку строковые литералы *являются* строковыми срезами,
    // это тоже работает, без синтаксиса среза!
    let word = first_word(my_string_literal);
}first_word путём использования строкового среза для типа параметра sЕсли есть строковый срез, его можно передать напрямую. Если есть String,
можно передать срез String или ссылку на String. Такая
гибкость использует преимущества разыменовывающего приведения типов — возможности, которая будет рассмотрена
в разделе «Использование разыменовывающего приведения типов в функциях и методах» главы 15.
Определение функции, принимающей строковый срез вместо ссылки на String,
делает API более общим и полезным без потери какой-либо функциональности:
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` работает со срезами `String`, как частичными, так и целыми.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` также работает со ссылками на `String`, которые эквивалентны
    // целым срезам `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` работает со срезами строковых литералов, как частичными, так и
    // целыми.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Поскольку строковые литералы *являются* строковыми срезами,
    // это тоже работает, без синтаксиса среза!
    let word = first_word(my_string_literal);
}
Другие срезы
Строковые срезы, как можно догадаться, специфичны для строк. Но есть и более общий тип среза. Рассмотрим этот массив:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];
}
Точно так же, как может потребоваться ссылаться на часть строки, может потребоваться ссылаться на часть массива. Это делается так:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];

let slice = &a[1..3];

assert_eq!(slice, &[2, 3]);
}
Этот срез имеет тип &[i32]. Он работает так же, как строковые срезы,
сохраняя ссылку на первый элемент и длину. Такой вид
среза используется для всевозможных других коллекций. Эти коллекции
подробно рассматриваются при обсуждении векторов в главе 8.
Итоги
Концепции владения, заимствования и срезов обеспечивают безопасность памяти в программах на Rust на этапе компиляции. Язык Rust даёт контроль над использованием памяти таким же образом, как и другие языки системного программирования. Но наличие автоматической очистки данных владельцем, когда владелец выходит из области видимости, означает, что не нужно писать и отлаживать дополнительный код для получения этого контроля.
Владение влияет на то, как работают многие другие части Rust, поэтому эти концепции
будут обсуждаться и далее на протяжении всей книги. Перейдём к
главе 5 и рассмотрим группировку фрагментов данных вместе в struct.